


Classificazione e transfer learning#
La vittoria di AlexNet a ImageNet, nel 2012, sta fra le architetture storiche, insieme al modo di contarne gli errori. Un dettaglio, lì di passaggio, qui diventa il punto. Due delle sette reti che produssero quel risultato erano state addestrate prima su un archivio di quindici milioni di immagini in ventiduemila categorie, e soltanto dopo rifinite sulle mille della gara; gli autori chiamano quel secondo passaggio fine-tuning, e lo scrivono fra virgolette [KSH12]. Dietro il risultato c’erano comunque 1,2 milioni di immagini etichettate a mano e cinque o sei giorni di calcolo su due GPU. Oggi quasi nessuno deve ripetere quella fatica: possiamo prendere in prestito ciò che quelle reti hanno già imparato. Si chiama transfer learning ed è, oggi, il modo normale di costruire un classificatore di immagini.
Dalla foto all’etichetta: base e testa#
Prima di riusarla, capiamo cosa fa una rete convoluzionale (CNN) quando classifica un’immagine. È fatta di tre pezzi in fila: una base di strati convoluzionali, che trasforma l’immagine in una pila di mappe; un passaggio che riassume quelle mappe in una lista di numeri; e una testa che da quella lista calcola una probabilità per ciascuna classe. Il transfer learning tratta i pezzi in modo diverso, e la differenza comincia da quanto pesano.
L’immagine entra come una griglia di pixel. La rete la fa passare attraverso
una pila di strati convoluzionali, quelli della sezione sulle reti convoluzionali: ognuno passa
sull’immagine una lente piccola, sempre la stessa (il suo nome tecnico è
filtro), e segna dove trova il disegno che quella lente cerca. I primi
riconoscono cose semplici (bordi, angoli, macchie di colore), quelli più
profondi combinano questi pezzetti in
forme via via più complesse: la trama di un pelo, un occhio, un muso. Alla fine
tutte queste «prove raccolte» vengono riassunte in una lista di numeri, e un
ultimo strato le trasforma in probabilità: cane 0.82, gatto 0.11, e così
via. Sono percentuali scritte come frazioni di uno, quindi 0.82 si legge
«82 per cento»; l’elenco continua con tutte le altre categorie, e sommando
tutta la lista si ottiene esattamente \(1\). Vince l’etichetta con il numero più
alto.
Come fa la rete ad avere le lenti giuste? Le si mostrano foto di cui
l’etichetta si conosce già, e di tutta la lista delle probabilità se ne guarda
una voce sola: quella dell’etichetta vera. Un 0.82 lì sopra vale alla rete
una penalità piccola, un 0.11 una grande, e a ogni foto la rete corregge di
pochissimo tutto quello che ha dentro, dalla prima lente all’ultimo strato, per
far salire quella voce. Ripetuto su milioni di foto, questo è l’addestramento.
Quello che la rete ha dentro non è distribuito alla pari, e conta, perché fra poco la testa sarà proprio il pezzo da sostituire. In una rete moderna la testa, cioè gli strati che vengono dopo le lenti, tiene pochi numeri; nelle prime reti di questo genere era il contrario. In AlexNet novantasei numeri su cento stavano nei suoi ultimi tre strati, e rifare quella testa voleva dire rifare quasi tutta la rete: su una rete di allora e su una di oggi, cambiare la testa è un lavoro di due misure diverse.
L’input è un tensore \(\mathbf{X} \in \mathbb{R}^{C\times H\times W}\) (canali, altezza, larghezza: l’ordine channels-first di PyTorch). Una successione di blocchi di convoluzione, batch normalization e non linearità lo trasforma in una feature map sempre più piccola nello spazio ma più ricca in profondità: a rimpicciolirla è il pooling nelle architetture della prima generazione e il passo di convoluzione maggiore di uno in quelle di oggi (in ResNet-18, due soli strati di pooling contro sette convoluzioni a passo due). Alla fine un global average pooling riduce la mappa a un vettore di caratteristiche \(\mathbf{h}\in\mathbb{R}^d\), con \(d = 512\) in ResNet-18, e uno strato fully-connected seguito dalla softmax lo mappa in una distribuzione sulle \(K\) classi; questa coppia di operazioni è la testa di classificazione:
Qui \(\hat{y}_k\) è la probabilità stimata della classe \(k\), \(\mathbf{w}_k\) è la
riga di pesi ad essa associata e \(b_k\) il suo termine costante.
Su un esempio il costo è la cross-entropy
\(\ell = -\sum_k y_k \log \hat{y}_k\), dove \(y_k\) vale 1 sulla classe vera
e 0 sulle altre (resta quindi il solo termine \(-\log \hat{y}_{\text{vera}}\));
l’addestramento minimizza la sua media \(\mathcal{L}\) sull’insieme, ottimizzando
tutti i parametri \(\theta\) della rete. La softmax sta nella formula e non nel
modulo: nn.CrossEntropyLoss vuole i logit e applica la softmax al proprio
interno, quindi la testa che si scrive in codice è una nn.Linear nuda
(Moduli, strati, loss).
Le reti della prima generazione, AlexNet e VGG, appiattivano invece la mappa e la mandavano in tre strati densi: in AlexNet sono il 96% dei \(60\,965\,224\) parametri della versione dell’articolo, ed è il motivo per cui «sostituire la testa» vuol dire due cose molto diverse sulle due famiglie.
Perché partire da zero costa caro#
Una CNN moderna ha da qualche milione a decine di milioni di parametri, i numeri interni che la rete regola mentre impara: la ResNet-18 che useremo fra poco ne ha più di undici milioni. Per regolarne tanti senza andare in overfitting, cioè senza che la rete impari a memoria gli esempi mostrati invece della regola che li spiega, servono moltissimi esempi etichettati e molta potenza di calcolo. Con le poche migliaia di foto di un progetto reale (le lastre di un ambulatorio, i difetti su una linea di produzione, le specie di una guida botanica), una rete addestrata da zero va in overfitting: sulle foto di addestramento l’errore scende quasi a zero, su quelle nuove resta alto. Il collo di bottiglia, quasi sempre, sono i dati e il tempo, non l’algoritmo.
Prendere in prestito: transfer learning#
L’idea del transfer learning è semplice: invece di ripartire da zero, prendiamo una rete già addestrata su un grande dataset (quasi sempre ImageNet) e la adattiamo al nostro compito. Funziona per una ragione precisa.
Un cuoco ha passato anni a imparare le tecniche di base: tagliare, soffriggere, montare, impastare. Se domani deve preparare un piatto che non ha mai fatto, non ricomincia da capo: quelle tecniche gli servono comunque, deve solo imparare la ricetta nuova. Una CNN funziona allo stesso modo. I suoi primi strati imparano le «tecniche di base» della visione (riconoscere bordi, angoli, trame, colori) che valgono per qualunque immagine. Solo gli ultimi strati imparano la «ricetta» specifica di ImageNet, cioè distinguere un pastore tedesco da un labrador. Riusiamo le tecniche di base e riscriviamo soltanto la ricetta.
E non è un modo di dire: qualcuno è andato a guardare. Si possono disegnare i filtri che una rete si è costruita da sola, e nei primi strati escono quasi sempre le stesse cose, bordi orientati in tutte le direzioni e macchie di colore, in reti diverse addestrate su fotografie per compiti diversi. Andando in profondità, invece, quello che ogni strato cerca diventa sempre più legato al problema per cui è stata addestrata, e quindi sempre meno riusabile altrove.
Che i primi strati di una CNN imparino filtri generici non è un’ipotesi, ma un fatto osservato. Visualizzando i pesi degli strati iniziali [ZF14] si trovano rilevatori di bordi orientati e di macchie di colore, molto simili ai filtri di Gabor della corteccia visiva; salendo in profondità le unità rispondono a motivi via via più astratti e specifici del compito. Yosinski e colleghi [YCBL14] hanno quantificato questa trasferibilità: le caratteristiche dei primi strati si trasferiscono quasi senza perdita a compiti diversi, mentre quelle degli ultimi strati sono tanto più specializzate (e meno riusabili) quanto più ci si avvicina all’uscita. A far scendere il rendimento del trasferimento, però, non è solo la specializzazione: pesa anche il taglio in sé, perché separa neuroni che si erano adattati l’uno all’altro, e il costo si paga anche trasferendo un compito su sé stesso. Da qui la strategia: congelare gli strati bassi (generici) e riaddestrare quelli alti (specifici) sul nuovo dominio, sapendo che partire da pesi trasferiti conviene quasi sempre, anche quando poi si rifinisce tutto.
Riusiamo dunque la base, che è la parte generica, e sostituiamo solo la testa.

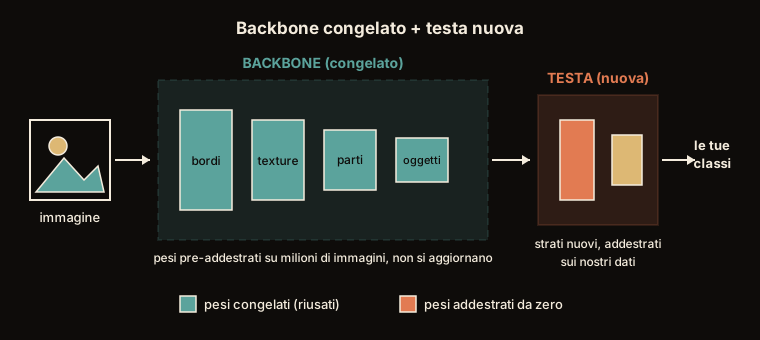
Fig. 11.2 La rete pre-addestrata (in teal, il verde-azzurro) fa da estrattore di caratteristiche: riduce l’immagine alla lista di numeri che la descrivono. Sopra di essa montiamo una testa nuova (in terracotta) per il nostro compito.#
Come mostra Fig. 11.2, teniamo la base convoluzionale addestrata su ImageNet (nei diagrammi in inglese la troverete chiamata backbone, la «spina dorsale») e ci attacchiamo sopra una testa nuova, con tante uscite quante sono le nostre categorie: se le nostre foto vanno divise in cinque gruppi, cinque uscite invece delle mille di ImageNet. Restano due modi di procedere.

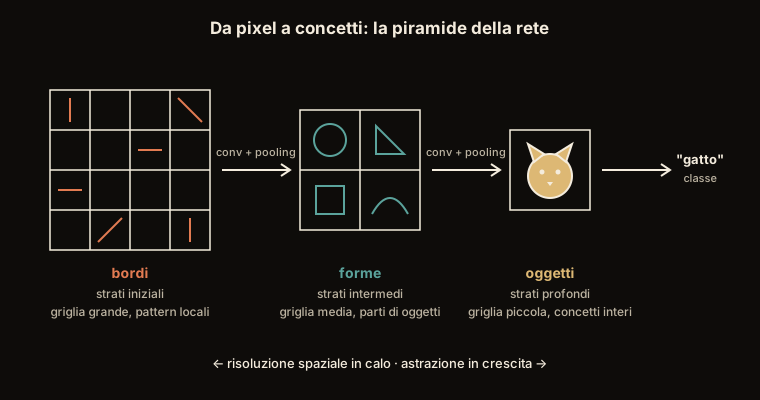
Fig. 11.3 Le griglie si rimpiccioliscono e il significato cresce. A ogni stadio il pooling (il passaggio che riassume ogni quadratino di griglia in un numero solo) dimezza la griglia, e ogni casella finisce per rispondere a una porzione d’immagine più grande: prima un bordo, poi una forma, infine l’oggetto intero.#
In Fig. 11.3 succedono due cose insieme: le griglie si rimpiccioliscono, e quello che gli strati riconoscono cresce, dai bordi alle forme fino all’oggetto. Non si riusano allo stesso modo. Bordi, trame e forme si trovano in qualunque fotografia, e gli strati che li costruiscono servono a qualunque compito di classificazione; distinguere proprio le mille categorie di ImageNet serve solo lì, ed è il lavoro dell’ultimo pezzo. Ecco perché la pila si riusa quasi tutta, e a rifarsi è la testa. Per un compito che chiede la posizione esatta dei pixel, come la segmentazione, buttare via la risoluzione costa invece caro, e la sezione sulla segmentazione mostra come la si recupera.
Congelare o rifinire: feature extraction vs fine-tuning#
Sono due strade. Con la feature extraction blocchi (congeli) tutta la base: la usi solo per trasformare le immagini in liste di numeri, e alleni da zero soltanto la testa. Siccome i numeri da regolare sono pochissimi (quelli della sola testa), bastano poche foto e pochi minuti di calcolo. Con il fine-tuning sblocchi anche gli ultimi strati della base e li riaddestri insieme alla testa, così la rete si adatta meglio al tuo dominio, cioè al tipo di immagini di cui ti occupi tu: le tue lastre, le tue foglie, i tuoi pezzi meccanici. Rende di più, ma vuole più foto e va fatto con cautela.
La cautela serve perché una rete non ha un cassetto dei ricordi separato: tutto quello che sa sta in quegli stessi numeri, e riaddestrarla vuol dire spostarli. Se li si sposta di poco, si aggiusta; se li si sposta di molto, si cancella quello che c’era prima e si ricomincia da capo senza accorgersene. Per questo il fine-tuning si fa con spostamenti cento volte più piccoli di quelli con cui si allena la testa.
E la base congelata riserva una sorpresa: continua a cambiare da sola. Dentro ci sono gli strati di batch normalization, che fanno quello che fa una macchina fotografica in automatico quando regola la luce sulla media di ciò che inquadra: prima di passare i numeri allo strato dopo, li rimettono in scala su quanto sono chiare e variegate le foto che stanno guardando.
Per farlo tengono un appunto, la media delle foto viste finora, e quell’appunto non è uno dei pesi della rete: si aggiorna da sé. A ogni gruppetto di foto che passa (il batch) tiene nove decimi della media vecchia e prende un decimo di quella nuova, anche quando i pesi sono bloccati tutti. Chi blocca i soli pesi e fa passare le sue lastre si ritrova, dopo qualche decina di gruppetti, un appunto tarato sulle lastre invece che sulle foto di ImageNet: i numeri che la base consegna alla testa cambiano da un giro all’altro, e la testa impara inseguendo un bersaglio che si sposta.
Perché la base resti ferma davvero, a quegli strati va detto di smettere di aggiornare l’appunto. Lo si dice anche quando si sbloccano gli ultimi strati con pochi esempi, perché una media presa su un gruppetto di poche foto salta da un gruppetto all’altro.
Il prestito, poi, conviene soprattutto quando le foto sono poche. Con moltissime foto e molto tempo, una rete partita da zero arriva allo stesso punto, solo più tardi; e su immagini molto diverse dalle fotografie di tutti i giorni, come le lastre, le tecniche prese in prestito servono meno di quanto si speri. Per saperlo si addestra la stessa rete nei due modi, sulle stesse foto, e si confronta.
Nella feature extraction congeliamo l’intera base con
requires_grad_(False): autograd smette di calcolarne i gradienti, i
parametri \(\theta_{\text{base}}\) restano fissi e all’ottimizzatore
consegniamo solo la testa \(\theta_{\text{head}}\). Attenzione però ai layer di
Batch Normalization: le loro statistiche correnti (media e varianza) sono
buffer, non parametri, e in modalità train() si aggiornano a ogni
forward, con o senza autograd, come media mobile delle statistiche del batch
(con il momento predefinito di PyTorch,
\(\hat{\mu} \leftarrow 0{,}9\,\hat{\mu} + 0{,}1\,\mu_{\mathcal{B}}\), e lo stesso
per la varianza). Una base «congelata» solo con
requires_grad_(False) deriva quindi comunque verso il nuovo dominio: per
fermarla davvero, i moduli BatchNorm vanno messi in modalità valutazione
(.eval()).
Nel fine-tuning riattiviamo il gradiente sugli strati alti della base e
riprendiamo l’ottimizzazione con un learning rate molto basso (tipicamente
\(10^{-5}\) contro \(10^{-3}\)): passi grandi sovrascriverebbero le
rappresentazioni utili. Il passo non deve essere per forza uno solo: con i
param group dell’ottimizzatore ogni gruppo di strati riceve il suo, più
piccolo quanto più lo strato è basso. ULMFiT ne fa una regola per un modello di
linguaggio, \(\eta_{l-1} = \eta_l / 2{,}6\) [HR18] (il
discriminative fine-tuning), e il fattore è empirico: su una CNN è un punto
di partenza, non una costante. Conta anche l’ordine. Una testa appena
inizializzata a caso produce all’inizio gradienti grandi e privi di senso, che
scendendo nella base ne deformano le feature prima che la testa abbia imparato
a usarle; addestrare prima la sola testa e poi sbloccare protegge la base, e
fuori dalla distribuzione di addestramento è più efficace del fine-tuning diretto
[KRJ+22]. Si scongelano solo gli strati alti, perché i bassi
sono i più generici, e i BatchNorm si lasciano in .eval() quando i batch del
fine-tuning sono piccoli, perché le loro medie salterebbero da un batch
all’altro; con batch grandi e un dominio lontano da ImageNet riaggiornarle sul
nuovo dominio può invece aiutare.
Il vantaggio del pre-addestramento, infine, non è un teorema. È massimo quando i dati del compito sono pochi, e si assottiglia quando abbondano: nel rilevamento su COCO una rete inizializzata a caso, con un addestramento più lungo, raggiunge la stessa accuratezza finale, e il pre-addestramento su ImageNet accelera la convergenza senza migliorare per forza il punto d’arrivo [HGDollar19]. Sulle immagini mediche il guadagno può essere piccolo, e modelli semplici e leggeri si avvicinano alle architetture nate per ImageNet [RZKB19]. La verifica è un confronto a parità di dati, fra la stessa rete pre-addestrata e inizializzata a caso.
In pratica, con PyTorch#
torchvision.models, la libreria di visione che accompagna PyTorch, include
decine di reti già addestrate su ImageNet, pronte da scaricare. Usiamo
ResNet-18 [HZRS16a]: diciotto sono gli strati con pesi che un’immagine
attraversa in fila dall’ingresso all’uscita, diciassette convoluzioni più la
testa (non si contano le tre piccole convoluzioni che servono soltanto ad
adattare le scorciatoie della rete residua quando cambia la taglia delle
mappe). È compatta, collaudata, ed è il modello più leggero della sua famiglia.
Il compito è dividere le foto in cinque categorie. Prima la feature extraction.
import torch
from torch import nn, optim
from torchvision import models

# 1. Rete pre-addestrata su ImageNet, con le sue trasformazioni
pesi = models.ResNet18_Weights.IMAGENET1K_V1
model = models.resnet18(weights=pesi)
preprocess = pesi.transforms()   # resize+crop a 224x224, normalizzazione ImageNet

# 2. Feature extraction: si congela tutta la base...
for p in model.parameters():
    p.requires_grad_(False)

# ...e anche i BatchNorm, che altrimenti continuerebbero a cambiare da soli:
# le statistiche sono buffer, non parametri. Da ripetere dopo model.train().
for m in model.modules():
    if isinstance(m, nn.BatchNorm2d):
        m.eval()

# ...e si sostituisce la testa: dalle 1000 classi ImageNet alle nostre 5
model.fc = nn.Linear(model.fc.in_features, 5)   # nuova, addestrabile

criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.fc.parameters(), lr=1e-3)
L’addestramento è il ciclo di addestramento:
per ogni mini-batch si calcolano la loss e i gradienti, e l’ottimizzatore
sposta i parametri di un passo proporzionale al tasso di apprendimento \(\eta\)
(il learning rate, lr nel codice). Quando la testa ha smesso di migliorare,
si passa al fine-tuning degli ultimi strati con un \(\eta\) cento volte più
piccolo.
# 3. Si scongela solo l'ultimo blocco della base
for p in model.layer4.parameters():
    p.requires_grad_(True)

# I BatchNorm vanno rimessi in valutazione: il training loop ha chiamato
# model.train(), che li ha riportati tutti in modalità di addestramento.
for m in model.modules():
    if isinstance(m, nn.BatchNorm2d):
        m.eval()

optimizer = optim.Adam(
    [p for p in model.parameters() if p.requires_grad],
    lr=1e-5,   # lr basso: cautela
)

addestrabili = sum(p.numel() for p in model.parameters() if p.requires_grad)
totali = sum(p.numel() for p in model.parameters())
print(f"addestrabili {addestrabili} su {totali}")
addestrabili 8396293 su 11179077
Quel «solo l’ultimo blocco» è meno modesto di come suona. La ResNet raggruppa i
suoi strati in quattro stadi, da layer1 a layer4, e sbloccare il solo
layer4 (con la testa) rende addestrabili tre quarti dei pesi. A ogni stadio i
canali raddoppiano, e i pesi di una convoluzione crescono col quadrato dei
canali, quindi ogni stadio pesa circa quattro volte il precedente: la cautela
sul passo non è prudenza di maniera.
Il passo, del resto, non deve essere per forza uno solo. Invece di sbloccare il solo ultimo stadio si possono sbloccare tutti, dando a ciascuno un passo più corto di quello sopra, così che le tecniche di base, vicino all’ingresso, si muovano appena; qui ogni stadio riceve il passo di quello che lo segue diviso per \(2{,}6\), la regola che ULMFiT ha proposto per un modello di linguaggio [HR18].
# 4. Un passo per stadio, sempre più corto verso l'ingresso
stadi = {"fc": model.fc, "layer4": model.layer4, "layer3": model.layer3,
         "layer2": model.layer2, "layer1": model.layer1}
eta, gruppi = 1e-3, []
for nome, stadio in stadi.items():         # dalla testa verso l'ingresso
    for p in stadio.parameters():
        p.requires_grad_(True)
    gruppi.append({"params": list(stadio.parameters()), "lr": eta})
    print(f"{nome:7s} passo {eta:.2e}")
    eta /= 2.6                              # la regola di ULMFiT
optimizer = optim.Adam(gruppi)
fc      passo 1.00e-03
layer4  passo 3.85e-04
layer3  passo 1.48e-04
layer2  passo 5.69e-05
layer1  passo 2.19e-05
Il primo strato convoluzionale, prima di layer1, resta bloccato: è quello
che vede i pixel, e i suoi bordi e le sue macchie di colore valgono per
qualunque fotografia.
Con poche centinaia di immagini per classe questa ricetta arriva dove una rete addestrata da zero sugli stessi dati resta molto indietro: con così pochi esempi quella rete impara a memoria prima di aver imparato a vedere. Quanti dati le servirebbero per rifarsi da sola le tecniche di base non è una domanda con una risposta sola. Dipende da quanto le nostre immagini somigliano a quelle su cui la base è stata addestrata, lo stesso fattore da cui dipende l’efficacia del transfer learning: più il dominio è lontano da ImageNet (le radiografie, le immagini satellitari, il microscopio), meno c’è da riusare e più c’è da riaddestrare.
Sostituendo resnet18 con resnet50 la struttura del codice non cambia.
Cambiando famiglia cambiano i nomi dei pezzi, e vanno guardati prima di
copiare il codice: in efficientnet_b0 [TL19] la testa si
chiama classifier[1] e non fc, e gli strati alti stanno dentro features
e non in un layer4. Una famiglia come i Vision Transformer, che al posto
della batch normalization usa la LayerNorm, di BatchNorm2d non ne ha nessuno:
il ciclo che li rimette in eval() gira a vuoto senza protestare. E va bene
così, perché la LayerNorm calcola le sue medie su ogni immagine presa da sola e
non tiene appunti che possano scivolare verso il nuovo dominio.
Da ricordare
Una rete che classifica lavora a strati: i primi vedono bordi e macchie di colore, gli ultimi forme e oggetti interi. Alla fine tutto si riduce a una lista di numeri, e l’ultimo passaggio la trasforma in percentuali, una per classe: vince la più alta.
Costruire una rete del genere da zero costa troppe foto e troppo tempo. Il transfer learning è la scorciatoia: si prende una rete che qualcun altro ha già addestrato su milioni di immagini e le si cambia solo la testa. Conviene soprattutto quando le foto sono poche.
Il cuoco che sa già tagliare e soffriggere deve imparare solo la ricetta nuova: i primi strati (le tecniche di base) valgono per quasi qualunque fotografia, gli ultimi (la ricetta) no, e sono quelli da rifare.
Due modi di procedere. Bloccare tutta la base e allenare solo la testa: veloce, e basta poco materiale; bloccarla davvero però vuol dire due cose e non una, fermare i pesi e dire anche agli strati di batch normalization di smettere di aggiornare il loro appunto. Oppure sbloccare anche gli ultimi strati della base e ritoccarli a passi piccolissimi: rende di più, ma vuole più foto e più cautela, perché a passi grandi la rete dimentica quello che sapeva.
Da ricordare
Una CNN classifica estraendo caratteristiche via via più astratte e chiudendo con softmax sulle classi.
Addestrare da zero è spesso proibitivo: servono troppi dati e troppo tempo. Il transfer learning riusa una base già addestrata su ImageNet; il vantaggio è massimo con pochi dati, e con molti dati e un addestramento abbastanza lungo una rete inizializzata a caso lo raggiunge.
Feature extraction: base congelata, si allena solo la testa (veloce, pochi dati). Congelarla davvero vuol dire due cose, non una: togliere i gradienti e mettere i BatchNorm in
.eval(), perché le loro statistiche sono buffer e intrain()deriverebbero comunque verso il nuovo dominio. Fine-tuning: si scongelano gli strati alti con learning rate piccolo (più preciso, più dati), BatchNorm in.eval()quando i batch sono piccoli.