


Deep Learning: perché la profondità conta#
Un elettrodo sottile, infilato nella corteccia visiva di un gatto, e davanti ai suoi occhi uno schermo su cui si proiettano forme luminose. Con questo esperimento, nel 1959, due neuroscienziati, David Hubel e Torsten Wiesel [HW59], scoprirono che certi neuroni si accendevano solo quando sullo schermo compariva una linea con una precisa inclinazione: rivelatori di bordi in carne e ossa. Tre anni dopo mostrarono che altri neuroni, più a valle, combinavano quelle risposte in configurazioni più complesse [HW62]. Quel lavoro valse loro il premio Nobel nel 1981, e la gerarchia che avevano descritto, dal semplice al complesso, ispirò le prime reti artificiali a strati per la visione. Il deep learning raccoglie la stessa idea: costruire la percezione a strati.
È anche il primo indizio per la domanda con cui si chiudeva il capitolo sull’efficienza: perché una rete sia fatta di molti strati sottili invece che di uno solo largo. Una metà della risposta è quella del gatto, le caratteristiche costruite una sopra l’altra; l’altra metà è un conto, quanti neuroni servirebbero a uno strato solo per fare lo stesso lavoro.
Le feature si imparano, non si scrivono a mano#
La differenza tra machine learning classico e deep learning non sta in una matematica esoterica: sta in chi decide quali caratteristiche dei dati contano. Quelle caratteristiche, in gergo, si chiamano feature: sono i numeri che descrivono un dato e su cui il modello fa i suoi conti.
Nel machine learning classico un esperto umano deve prima trasformare i dati grezzi in «ingredienti» utili. Per riconoscere un gatto in una foto, qualcuno scrive a mano il codice che conta i bordi, misura quanta parte dell’immagine è arancione o grigia, individua gli angoli: sono le feature ingegnerizzate, le caratteristiche scelte da un umano. Solo dopo il modello impara a distinguere i gatti dai cani.
Il deep learning fa un patto diverso: gli dai i pixel grezzi e lascia che sia la rete, addestrandosi, a inventarsi da sola gli ingredienti giusti.
In cucina la differenza si vede bene. Al primo cuoco le verdure arrivano già tagliate da un fornitore, sempre allo stesso modo, cubetti da un centimetro, perché così si è deciso una volta per tutte. Il cuoco cucina, manda il piatto in sala, e il cliente gli fa sapere quanto ci è andato vicino. Quel giudizio arriva fino ai fornelli e non oltre, perché il fornitore continua a tagliare come sempre anche se il piatto torna indietro dieci sere di fila. E se il coltello ha buttato via la parte buona, la punta degli asparagi finita nello scarto, alla cottura non resta niente da recuperare.
Al secondo cuoco arriva la verdura intera. Il giudizio del cliente risale all’indietro tutta la catena, dalla sala ai fornelli e dai fornelli al tagliere, e la sera dopo cambiano insieme la cottura e il taglio. Nessuno gli ha detto che gli asparagi vanno tagliati in diagonale; ci arriva perché così i piatti tornano indietro meno spesso. Il taglio ha smesso di essere una regola fissa decisa da qualcun altro ed è diventato una parte del mestiere che si impara.
In una pipeline classica di visione artificiale un estrattore fisso e progettato a mano (SIFT, HOG, filtri di Gabor) mappa l’immagine in un vettore di feature \(\phi(\mathbf{X})\), su cui un classificatore \(h\) viene addestrato. L’estrattore \(\phi\) è congelato: non impara nulla dai dati.
Una rete profonda è invece una composizione di trasformazioni parametriche
dove \(L\) è il numero di strati e tipicamente \(f_\ell(\mathbf{Z}) = g(\mathbf{W}_\ell \mathbf{Z} + \mathbf{b}_\ell)\), con la matrice di pesi \(\mathbf{W}_\ell\), il vettore di bias \(\mathbf{b}_\ell\) e la funzione di attivazione \(g\) applicata elemento per elemento (con più esempi insieme \(\mathbf{Z}\) ne ha uno per colonna, e il bias si somma a ogni colonna; ci sono anche strati di altra forma, come il pooling). Tutti i parametri \(\theta\), dal primo strato all’ultimo, vengono ottimizzati insieme (end-to-end) minimizzando la loss \(\mathcal{L}\) con la discesa del gradiente, e il gradiente rispetto a ciascuno di loro lo calcola la retropropagazione. L’estrazione delle feature diventa parte del modello e viene appresa, invece di stare a monte e fissa. È ciò che si chiama representation learning.
Rappresentazioni gerarchiche: dai bordi agli oggetti#
Una rete profonda è una sequenza di strati: il primo riceve i numeri dell’immagine, ognuno dei successivi l’uscita dello strato che lo precede. Ogni neurone calcola una somma pesata dei suoi ingressi e la passa per la funzione di attivazione, la ReLU per esempio. L’uscita di uno strato è la sua rappresentazione dell’ingresso, e poiché ciascuna è costruita sulla precedente le rappresentazioni sono gerarchiche. Che cosa rappresenta davvero uno strato?
Nel 2014 Zeiler e Fergus [ZF14] trovarono il modo di «visualizzarlo» in una rete convoluzionale, il tipo di rete fatto apposta per le immagini di cui parla la sezione sulle reti convoluzionali: per ogni neurone, risalire alla forma che lo fa accendere. Il risultato somigliava in modo sorprendente alla corteccia di Hubel e Wiesel: i primi strati reagiscono a bordi e linee orientate; gli strati intermedi a parti riconoscibili (un occhio, una ruota) e a texture, cioè trame che si ripetono, come la stoffa di un tessuto o il pelo di un animale; gli ultimi strati a interi oggetti. La profondità costruisce astrazione, un livello alla volta (Fig. 10.1).

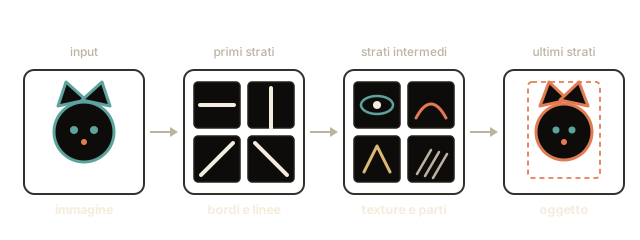
Fig. 10.1 Come una rete profonda «vede» un gatto. Da sinistra a destra: i pixel grezzi, i bordi e le linee dei primi strati, le texture e le parti degli strati intermedi, l’oggetto intero riconosciuto dagli ultimi strati.#
Davanti a una scatola di mattoncini, cominci dai pezzi più piccoli: tratti dritti, curve, angoli. Poi combini quei tratti in parti riconoscibili: due cerchi diventano occhi, due triangoli diventano orecchie. Alla fine le parti si assemblano in un gatto intero.
Man mano che si sale, ogni pezzo copre più tavolo. Un tratto dritto sta in un dito di spazio, l’orecchio che mette insieme due triangoli prende mezzo palmo, il gatto finito occupa tutto il tavolino. Nessuno ha allargato niente apposta, la superficie cresce da sé, perché ogni pezzo raccoglie pezzi che a loro volta ne avevano già raccolti.
La rete fa esattamente questo, ma senza che nessuno gliel’abbia insegnato: nessuno le dice «questo è un occhio». Impara da sola che, per riconoscere i gatti nelle foto, conviene prima trovare i bordi, poi comporli in parti, poi comporre le parti in animali.
I pezzi dei primi assemblaggi, però, non sanno di gatto. Tratti dritti, curve e angoli servono identici a chi vuole costruire un cane, una moto o una casa; sono le orecchie a punta a valere solo per i gatti. Per questo chi ha passato mesi a costruire gatti non ricomincia dalla scatola quando gli chiedono una moto. Tiene i pezzi piccoli così come sono, rifà gli ultimi assemblaggi, e in un pomeriggio ha finito.
La chiave è la composizionalità. Ogni mappa di feature dello strato \(\ell\) è una funzione non lineare delle mappe dello strato precedente, e comporre funzioni non lineari permette forme via via più complesse. Che la complessità delle forme a cui i neuroni rispondono cresca davvero con la profondità, però, è un fatto empirico: è ciò che mostrano le visualizzazioni di Zeiler e Fergus. In una rete convoluzionale cresce anche il campo recettivo (receptive field): un neurone dello strato \(\ell\) «vede» una porzione di immagine tanto più ampia quanto più \(\ell\) è profondo, perché aggrega l’output di neuroni che a loro volta aggregano porzioni più piccole.
Formalmente, la rappresentazione allo strato \(\ell\) è \(\mathbf{Z}^{[\ell]} = f_\ell(\mathbf{Z}^{[\ell-1]})\), con \(\mathbf{Z}^{[0]} = \mathbf{X}\) l’immagine di ingresso. Le \(\mathbf{Z}^{[\ell]}\) superficiali codificano feature locali e generiche (bordi, condivisi tra compiti diversi); le \(\mathbf{Z}^{[\ell]}\) profonde codificano feature astratte e specifiche del compito (categorie di oggetti). È questa gerarchia a rendere così efficace il transfer learning: i primi strati, appresi su un dataset enorme, si riusano quasi invariati su problemi nuovi, mentre gli ultimi vanno riaddestrati [YCBL14].
Dati, calcolo e algoritmi#
C’è un dettaglio che spiazza chi arriva al deep learning da profano: la retropropagazione, l’algoritmo che addestra queste reti, fu resa celebre nel 1986 da Rumelhart, Hinton e Williams [RHW86], ma l’idea è ancora più vecchia[1]. Se l’algoritmo esisteva da decenni, perché il deep learning è esploso solo dopo il 2012? Perché servivano tre ingredienti tutti insieme: dati, potenza di calcolo e algoritmi maturi. Il momento-simbolo è l’autunno del 2012 e la gara ImageNet, già incontrata nel capitolo sulle GPU: più di un milione di fotografie, mille categorie fra cui scegliere che cosa c’è dentro, e ogni anno una classifica dei programmi che ci riescono meglio. Quell’anno la vince, con un margine mai visto prima, una rete profonda: AlexNet, dal nome del primo dei suoi autori, Alex Krizhevsky.
Per accendere un fuoco servono la legna, l’aria e una scintilla: se manca uno solo dei tre, non parte. Il deep learning aveva l’idea da decenni ed è rimasto spento lo stesso.
La legna sono i dati: milioni di fotografie etichettate, cioè con scritto accanto, a mano, che cosa c’è dentro. Ne servono milioni perché AlexNet aveva sessanta milioni di numeri da regolare, e a regolarli sono le foto, una dopo l’altra. Prima di Internet quella catasta non esisteva: descrivere una per una milioni di immagini era un lavoro fuori portata.
L’aria è il calcolo. Le schede grafiche (GPU) sono nate per i videogiochi e si sono rivelate perfette per i conti di una rete: un videogioco chiede la stessa moltiplicazione su un milione di punti dello schermo nello stesso istante, una rete la chiede su milioni di pesi. La scheda non vede la differenza e le sbriga in un colpo solo. AlexNet ha bruciato la sua legna su due schede da videogiocatore.
La scintilla sono gli algoritmi. Una scintilla su legna buona può benissimo spegnersi, ed è quello che succedeva: reti profonde che non imparavano. A farla attaccare sono tre accorgimenti, ciascuno contro un guaio preciso.
Il primo guaio sta nella funzione che ogni neurone applica al numero uscito dai suoi conti. Era la curva a S, la sigmoide: oltre un certo punto, numero grande o numero grandissimo, esce quasi lo stesso valore, e la rete non si accorge della differenza. Il danno peggiore però si vede al ritorno. La correzione risale dall’ultimo strato verso il primo, e a ogni strato viene moltiplicata per la pendenza di quella curva, che sulla parte piatta è quasi zero: a ogni strato risalito si moltiplica per un numero piccolo, e ai primi strati non arrivava quasi niente. Il rimedio è lo sportello del capitolo sulle reti neurali: i numeri positivi passano come sono, i negativi diventano zero. Se entra 5 esce 5, se entra \(-3\) esce 0, e dal lato aperto la pendenza vale sempre 1, quindi la correzione passa intera. Si chiama ReLU.
Il secondo guaio è che la rete si impara a memoria le fotografie dell’addestramento. Sembrerebbe un pregio, ed è il modo più sicuro di fallire: chi ripete a memoria i compiti dell’anno scorso va benissimo su quelli e male sul compito di domani, che è l’unico che conta. Il rimedio è spegnere a caso una parte dei neuroni a ogni passata sulle fotografie: se al giro dopo un neurone può mancare, gli altri non si appoggiano solo a lui, e quello che la rete sa finisce distribuito invece che depositato in un punto (dropout).
Il terzo guaio è che le foto etichettate costano. Allora si ritagliano e si specchiano quelle che già ci sono, e da ognuna ne escono molte senza doverne etichettare altre (data augmentation). Nel 2012, per la prima volta, la legna, l’aria e la scintilla ci sono tutte insieme.
Nel 2009 il gruppo di Fei-Fei Li pubblica ImageNet [DDS+09], un dataset di milioni di immagini etichettate da persone; la sua competizione annuale, la ILSVRC [RDS+15], ne usa un sottoinsieme di circa 1,2 milioni di immagini di addestramento distribuite su 1000 categorie. Nel 2012 AlexNet (Krizhevsky, Sutskever, Hinton) vince proprio la ILSVRC portando l’errore top-5 dal 26,2% del miglior metodo classico al 15,3% [KSH12]. Il confronto va letto per quello che è: il 15,3% è il punteggio della sottomissione, che media le predizioni di sette reti; la singola rete descritta nell’articolo si ferma al 18,2% sull’insieme di validazione (per la rete sola l’articolo non riporta il test), e anche così il salto è senza precedenti.
I tre ingredienti, in numeri:
Dati: un dataset abbastanza grande da addestrare una rete con circa 60 milioni di parametri senza overfittare in modo catastrofico.
Calcolo: un’implementazione della convoluzione su GPU, scritta apposta e molto ottimizzata, su due NVIDIA GTX 580 da 3 GB; la rete è divisa fra le due schede perché in una sola non entra.
Algoritmi: attivazione ReLU \(g(x)=\max(0,x)\) per attenuare il vanishing gradient, dropout come regolarizzazione, data augmentation.
Nessuna di queste idee era nuova in senso stretto; nuova era la loro combinazione, alla scala giusta.
Profondo, non solo largo#
Fin qui abbiamo dato per buono che impilare strati serva a qualcosa. C’è però un risultato matematico che sembra dire il contrario.
Si chiama teorema di approssimazione universale, ed è già comparso nel capitolo sulle reti neurali: basta un solo strato in mezzo, fra l’ingresso e l’uscita. Purché lo si faccia abbastanza largo, cioè con abbastanza neuroni, quella rete con un solo strato nascosto sa imitare con la precisione che si vuole qualunque regola che leghi ingressi e uscite senza salti bruschi.[2]
Una condizione c’è, ed è essenziale. La funzione che ogni neurone applica al proprio risultato, l’attivazione (la ReLU, per esempio, che azzera i numeri negativi e lascia passare i positivi), non deve essere un polinomio, cioè una somma di potenze come \(3x^2-x+5\). Se l’attivazione fosse un quadrato, ogni neurone produrrebbe una parabola, e una somma di parabole, per quante se ne affianchino, resta una parabola: polinomi di grado due sommati danno un polinomio di grado al più due. Allargare la rete aggiunge addendi e non alza il grado. È il muro già misurato nel capitolo sulle reti neurali, dove a un certo punto aggiungere neuroni smetteva di servire. La ReLU non ha questo limite, perché non è una somma di potenze: ha uno spigolo, nel punto in cui smette di azzerare e comincia a lasciar passare, e nessuna potenza, né somma di potenze, fa un angolo.
Se una rete «piatta» e larga sa già imitare tutto, perché impilare tanti strati?
Il teorema dice che in teoria un solo strato basta. Ma «in teoria» nasconde due fregature. Una sta nel prezzo: quel singolo strato potrebbe aver bisogno di un numero enorme, impraticabile, di neuroni. L’altra sta nel verbo che il teorema usa, «esiste». Garantisce che una rete buona ci sia da qualche parte, non che qualcuno la sappia trovare. A cercarla è l’addestramento, che parte da numeri buttati a caso e li corregge un poco alla volta guardando gli esempi: sapere che il traguardo c’è non dice da che parte muoversi per raggiungerlo, né quante foto bisognerà guardare per arrivarci.
Il prezzo alto ha una ragione precisa. Quello che manca alla rete piatta è la possibilità di costruire sopra. In una rete a un solo strato ogni neurone guarda i pixel grezzi e nient’altro: nessuno può prendere una forma che un altro ha già trovato e comporla con una seconda. Un occhio va descritto ogni volta a partire dai pixel, e le combinazioni di pixel che fanno un occhio sono innumerevoli: cambia la luce, cambia l’inclinazione, cambia la taglia, e ogni variante va prevista da capo.
Con più strati il secondo lavora su ciò che ha trovato il primo, il terzo su ciò che ha trovato il secondo. È la differenza tra una ricetta scritta tutta come «prendi la farina, prendi l’uovo, prendi il burro» e una che a un certo punto dice «prepara la besciamella», dando per fatto un pezzo di strada già percorso: la seconda arriva allo stesso piatto con molte parole in meno.
Il teorema garantisce che, se l’attivazione \(g\) è continua e non polinomiale (l’ipotesi è essenziale: la soddisfano la sigmoide e la ReLU [LLPS93], non una \(g\) polinomiale, che produrrebbe solo polinomi), per ogni funzione continua \(f:[0,1]^n\to\mathbb{R}\) e ogni \(\varepsilon>0\) esiste una rete a un solo strato nascosto
dove \(\mathbf{x} \in [0,1]^n\) è il singolo esempio in ingresso (un vettore, non una matrice di dati), \(N\) il numero di neuroni nascosti, \(\mathbf{w}_i \in \mathbb{R}^n\) il vettore dei pesi del neurone \(i\)-esimo, \(b_i\) il suo bias e \(v_i\) il peso con cui contribuisce all’uscita.
Le due avvertenze sul quantificatore sono quelle della panoramica sulle reti neurali, e qui contano più che altrove. Il teorema è di esistenza, cioè di densità: dice che la rete c’è, non che la discesa del gradiente la trovi, né quanti esempi servano per impararla. E non limita \(N\), che dipende dalla classe di funzioni da approssimare: per le classi definite dalla sola regolarità (derivate limitate fino a un certo ordine) cresce esponenzialmente nella dimensione dell’ingresso, ed è la maledizione della dimensionalità, che colpisce ogni metodo i cui parametri dipendano con continuità dalla funzione [DHM89], non le reti in particolare. Per la classe di Barron [Bar93], definita da una condizione sulla trasformata di Fourier, l’errore quadratico scende invece come \(O(C_f^2/N)\): l’esponente di \(N\) non dipende dalla dimensione, ma la costante \(C_f\) sì, e può crescere con essa. La crescita esponenziale è una proprietà della classe di funzioni, non delle reti a uno strato in quanto tali.
Sulla profondità, invece, le separazioni sono nette e dimostrate. Per ogni intero \(k\) esistono reti ReLU con \(\Theta(k^3)\) strati e \(\Theta(1)\) neuroni per strato da cui nessuna rete con \(O(k)\) strati e meno di \(\Omega(2^k)\) neuroni si avvicina più di tanto: l’errore medio sul cubo, \(\int_{[0,1]^n}\lvert f-F\rvert\,d\mathbf{x}\) per la funzione \(f\) della rete profonda e quella \(F\) della rete meno profonda, resta almeno \(1/64\) [Tel16]. È una separazione a errore fissato, non a errore piccolo a piacere, e vale fra due profondità qualunque, una cubica nell’altra, non soltanto fra uno strato e molti; Eldan e Shamir [ES16] esibiscono una funzione che una rete con due strati nascosti rappresenta con un numero di neuroni polinomiale nella dimensione dell’ingresso, e che una rete con uno solo non riesce ad approssimare oltre una certa soglia a meno di renderla esponenzialmente larga. Montúfar e colleghi [MontufarPCB14] mostrano che il numero di regioni lineari che una rete ReLU può generare cresce esponenzialmente con la profondità e solo polinomialmente con la larghezza. Tradotto: la profondità compra efficienza espressiva. È più economico comporre trasformazioni che allargarne una sola.
Quante regioni taglia una rete#
Che la profondità arrivi allo stesso risultato con molti meno neuroni è, fin qui, una frase; sotto c’è un conto, e con la ReLU si può fare a mano. Ogni ReLU è fatta di due pezzi dritti, e una rete di ReLU è fatta di pezzi dritti anche lei: si dice lineare a tratti. Lo spazio degli ingressi si divide in zone, le regioni lineari, e dentro ciascuna la rete è una funzione affine, cioè lineare più una costante: una retta se l’ingresso è uno, un piano se sono due, e il suo analogo in più dimensioni, l’iperpiano, se sono di più. Tutta la sua capacità di curvare sta nel numero e nella disposizione di quelle regioni, quindi contarle è un modo di misurare quanto una rete può essere complicata. Il confronto interessante è a parità di parametri: quante regioni ottiene una rete con un numero dato di parametri, spendendoli in larghezza oppure in profondità.
Una striscia di carta lunga e dritta va fatta a pezzi, e lo strumento è un paio di forbici: ogni taglio attraversa la striscia in un punto solo e la divide lì. Il taglio dev’essere netto, perché è il taglio a fare il pezzo: una lama che si limitasse a curvare la carta, morbida, non ne staccherebbe nessuno. Dieci tagli fanno undici pezzi, cento tagli ne fanno centouno. Ogni pezzo in più costa un taglio in più, e non c’è modo di fare meglio: la striscia è distesa, e ogni taglio la tocca in un posto solo.
Adesso il secondo modo. Prima di tagliare, si piega la striscia a fisarmonica: dieci pieghe, e la carta si accatasta in undici spessori. Un taglio solo attraversa tutti gli undici spessori insieme, e quando si riapre la striscia quel taglio l’ha divisa in undici punti invece che in uno. Dieci tagli su una striscia piegata fanno il lavoro di centodieci tagli su una distesa. Piegando ancora, ogni taglio vale ancora di più.
Nella rete, un taglio è un neurone: lo spigolo della sua ReLU divide in un punto la linea degli ingressi. Uno strato intero, messo sotto un altro, fa da fisarmonica: piega quella linea, e i neuroni dello strato sopra la tagliano tutta piegata. Piegare però non è gratis, e qui sta il confronto vero. Un taglio in più è un neurone in più, che costa pochi numeri da regolare. Uno strato in più costa molto di più, perché ognuno dei suoi dieci neuroni deve avere un peso per ciascuno dei dieci dello strato sotto: dieci per dieci numeri, non dieci. La domanda diventa quindi se convenga spendere i numeri in tagli o in pieghe, e la risposta è che a parità di spesa le pieghe vincono, e vincono di molto.
Il conto, però, promette meno di quanto sembri. Quel numero è quanto le pieghe potrebbero fare piegando alla perfezione: piegate male, due tagli cadono nello stesso posto e i pezzi sono meno. I pezzi che escono da una piega sono copie l’uno dell’altro, perché sono nati dallo stesso taglio passato attraverso più spessori; una striscia distesa, di tagli indipendenti, ne fa pochi ma li mette dove vuole. E soprattutto, avere un milione di pezzi non vuol dire aver ritagliato la forma giusta: se quello che serve è una curva liscia, i pezzi contano solo se cadono dove serve, e il conto dei pezzi su questo non dice niente.
Un’ultima cosa sul tavolo di gioco: qui la carta è una striscia, cioè una cosa lunga e basta. Con un foglio, che è quello che succede appena gli ingressi sono più di uno, contare i pezzi diventa molto più difficile, e il vantaggio delle pieghe cresce ancora.
Con un ingresso e un’uscita il conto è elementare. In una rete a uno strato nascosto di \(D\) unità ReLU, ogni unità ha un punto in cui la sua pre-attivazione cambia segno: uno spigolo sulla retta d’ingresso. Al massimo \(D\) spigoli distinti tagliano la retta in
tratti, e su ciascuno la rete è affine. I parametri sono \(D\) pesi d’ingresso, \(D\) bias, \(D\) pesi d’uscita e un bias finale, cioè \(3D+1\): il numero di regioni cresce linearmente con il numero di parametri.
Con \(K\) strati da \(D\) unità l’argomento si ripete per induzione. Dentro una regione già formata dai primi \(k-1\) strati, ogni pre-attivazione dello strato \(k\) è affine in \(x\), quindi ciascuna delle \(D\) unità vi aggiunge al più uno spigolo: quella regione si divide in al più \(D+1\) sottoregioni. Perciò
con \(P_K\) il numero di parametri (per \(K=1\) la seconda formula restituisce \(3D+1\), come dev’essere). Le due quantità sono conteggi puri, adimensionali, e si confrontano solo a parità di \(P\): a profondità \(K\) fissata, \(D\) cresce come \(\sqrt{P/(K-1)}\) e le regioni come \(P^{K/2}\), cioè polinomialmente nei parametri con grado che cresce con la profondità, contro il grado uno della rete piatta.
Il conto usa quattro ipotesi, e ciascuna limita che cosa se ne può concludere. L’attivazione è ReLU, o comunque lineare a tratti con un solo spigolo: con la sigmoide la rete non è lineare a tratti e le regioni non esistono. L’ingresso ha una sola dimensione: con \(D_i\) ingressi il conto si complica, e Montúfar e colleghi [MontufarPCB14] prendono la cosa dall’altro capo, esibendo reti (di larghezza \(D \ge D_i\)) che di regioni ne fanno almeno \(\Omega\big((D/D_i)^{(K-1)D_i} D^{D_i}\big)\): stesso verso, divario più largo. Il \((D+1)^K\) è invece un limite superiore, che le costruzioni a ripiegamento avvicinano senza toccarlo, e a cui una rete addestrata non si avvicina affatto. E soprattutto: il numero di regioni misura l’espressività, cioè quali funzioni la rete può rappresentare, e non dice niente su quale la discesa del gradiente troverà né su come si comporterà sui dati nuovi. Le regioni di una rete profonda portano dipendenze e simmetrie (sono, letteralmente, copie ripiegate le une delle altre), quindi tante regioni non equivalgono a tanta libertà, e non equivalgono in nessun modo a generalizzare meglio. Quanto poco le due cose siano legate lo dice la doppia discesa della sezione su overfitting e validazione: una rete con più parametri che esempi generalizza meglio proprio dopo aver superato il punto in cui riesce a memorizzarli tutti.
Il confronto si fa in aritmetica, con un ingresso e un’uscita: si contano i parametri di una rete profonda piccola, \(K\) strati nascosti da \(D\) neuroni ciascuno, e poi quanti neuroni servono a una rete con un solo strato per spenderne altrettanti.
# Un ingresso, un'uscita, K strati nascosti da D neuroni ReLU ciascuno.
def parametri(D, K):
    return 3 * D + 1 + (K - 1) * D * (D + 1)

def regioni(D, K):        # quante ne puo' fare al massimo
    return (D + 1) ** K

bilancio = parametri(10, 5)
print(f"profonda: K=5, D=10 -> {bilancio} parametri, {regioni(10, 5)} regioni")

# La rete a uno strato piu' piccola che quel bilancio se lo puo' permettere.
D = next(d for d in range(1, 10_000) if parametri(d, 1) >= bilancio)
print(f"piatta:   K=1, D={D} -> {parametri(D, 1)} parametri, "
      f"{regioni(D, 1)} regioni")
print(f"rapporto: {regioni(10, 5) / regioni(D, 1):.0f} volte")
profonda: K=5, D=10 -> 471 parametri, 161051 regioni
piatta:   K=1, D=157 -> 472 parametri, 158 regioni
rapporto: 1019 volte
Cinque strati da dieci neuroni costano \(471\) parametri e arrivano al più a \(161\,051\) regioni, cioè \(11^5\): ogni strato da dieci neuroni moltiplica i pezzi al più per undici. La rete a uno strato che spende quei parametri, anzi uno in più, ne fa al più \(158\): mille volte meno, con la stessa spesa. I due numeri sono massimi, e uno solo dei due si raggiunge davvero: la rete piatta arriva ai suoi \(158\) pezzi mettendo i suoi \(157\) spigoli in punti diversi, mentre per la profonda nessuno sa costruire pesi che tocchino il massimo. E il conto vale per quello che la rete può rappresentare, non per quello che imparerà.
La pila, in codice#
La gerarchia dai bordi agli oggetti si legge anche nel codice. Una piccola rete convoluzionale scritta in PyTorch è letteralmente una pila di strati, ognuno dei quali guarda una porzione d’immagine più ampia del precedente. Che cosa faccia ciascuno di quegli strati lo spiega la sezione sulle reti convoluzionali; per ora basta la forma della pila.
from torch import nn

# in ingresso: un gruppo di immagini a colori, alte e larghe 128 pixel
model = nn.Sequential(
    nn.Conv2d(3, 32, 3), nn.ReLU(),    # vede 3x3 pixel: bordi, linee
    nn.MaxPool2d(2),
    nn.Conv2d(32, 64, 3), nn.ReLU(),   # vede 8x8 pixel: angoli, trame
    nn.MaxPool2d(2),
    nn.Conv2d(64, 128, 3), nn.ReLU(),  # vede 18x18 pixel: parti, non oggetti
    nn.AdaptiveAvgPool2d(1),           # media di ogni mappa
    nn.Flatten(),
    nn.Linear(128, 10),                # la classe finale (un punteggio per classe)
)
I tre numeri dentro nn.Conv2d(3, 32, 3) sono, nell’ordine, i canali in
ingresso (3: rosso, verde e blu, cioè tre griglie di numeri grandi quanto
l’immagine), il numero di filtri da applicare (32), che sono anche i canali in
uscita, e il lato della finestra che ogni filtro guarda per volta (3, cioè 3
per 3 pixel). Ogni filtro produce una nuova griglia, la feature map, che
segna punto per punto dove nell’immagine il filtro ha trovato ciò che cerca. La
riga nn.AdaptiveAvgPool2d(1) riduce ciascuna di quelle mappe a un numero
solo, la sua media. L’ultima riga produce dieci numeri, uno per classe: si
chiamano logit, sono punteggi grezzi, e vince il più alto.
Ogni nn.Conv2d più avanti nella pila lavora sulle mappe di quello prima e
guarda una porzione d’immagine più larga: un neurone del primo strato vede 3
pixel per 3, uno del secondo 8 per 8, uno del terzo 18 per 18, perché ogni
finestra raccoglie finestre dello strato prima, già larghe a loro volta, e ogni
pooling dimezza la griglia su cui lavora lo strato dopo. È su
questa crescita che l’addestramento costruisce la scala della
Fig. 10.1, dai bordi alle parti. Su un’immagine di 128
pixel, però, diciotto non bastano a vedere un oggetto intero, e i filtri di una
rete appena costruita sono ancora casuali: la pila ha la forma della gerarchia,
non ancora il contenuto.
Da ricordare
Nel machine learning classico è una persona a decidere quali caratteristiche dei dati contano, e a scriverle nel codice. Una rete profonda se le inventa da sola, partendo dai dati grezzi.
Le costruisce a strati, dal semplice al complesso: prima bordi e linee, poi pezzi riconoscibili (un occhio, una ruota), infine l’oggetto intero.
Non è esplosa prima del 2012 perché servivano tre cose insieme, come la legna, l’aria e la scintilla: milioni di fotografie etichettate, schede grafiche veloci e tre accorgimenti (la ReLU al posto della curva a S, lo spegnere neuroni a caso, il moltiplicare le foto con ritagli e specchiature). Nel 2012 c’erano tutte e tre, e la gara di ImageNet la vinse AlexNet.
Uno strato solo, se lo si facesse enorme, in teoria basterebbe: il teorema però dice che una rete così esiste, non che l’addestramento la sappia trovare. E per certe funzioni la profondità arriva allo stesso risultato con molti meno neuroni, perché ogni strato può costruire sopra quello che ha trovato il precedente, invece di descrivere ogni forma a partire dai pixel.
Da ricordare
Il deep learning apprende le feature dai dati grezzi, invece di richiederle ingegnerizzate a mano come il ML classico.
Le rappresentazioni sono gerarchiche: bordi → texture e parti → oggetti, un livello di astrazione per strato.
È esploso dopo il 2012 (ImageNet, AlexNet) grazie alla triade dati + GPU + algoritmi, non a una singola idea nuova.
Una rete larga e piatta è universale in teoria (con un’attivazione non polinomiale), ma esistono famiglie di funzioni che una rete profonda rappresenta con pochi neuroni e una meno profonda approssima, a errore fissato, solo con un numero esponenziale: è una separazione dimostrata su famiglie costruite, non una garanzia per ogni funzione. L’universalità però è un’esistenza, non un’apprendibilità.
Che cosa faccia uno di quegli strati, e perché sulle immagini una convoluzione funzioni meglio dello strato denso delle reti viste finora, è il tema delle reti convoluzionali.