


Q-learning e l’apprendimento per differenze temporali#
Torniamo per un momento al videogioco della panoramica: premi tasti, il personaggio si muove, ogni tanto il punteggio sale, e nessuno ti dice quale delle decine di mosse fatte abbia meritato quei punti. I metodi Monte Carlo hanno affrontato il problema nel modo più diretto che ci sia: giocare la partita intera, guardare quanti punti si sono fatti e usare quel totale per giudicare tutte le mosse. E si sono fermati su una promessa, che adesso si mantiene: si può correggere la stima strada facendo, senza aspettare la fine. Ne usciranno le differenze temporali, e da lì il Q-learning.
Imparare senza aspettare la fine: le differenze temporali#
Un metodo Monte Carlo è corretto in media, ma ha due costi: il ritorno di una partita ha varianza alta, e nessuna stima si aggiorna prima che la partita finisca. L’apprendimento per differenze temporali (temporal-difference, TD) aggiorna invece le stime durante la partita, a ogni singolo passo, usando la ricompensa appena incassata più la stima che già si ha della situazione in cui si è finiti. Il nome e la teoria vengono da Richard Sutton, nel 1988 [Sut88]; l’idea è più vecchia, ed è quella del programma di dama di Samuel con cui si apre il capitolo sul machine learning, che spostava la valutazione di una posizione verso quella della posizione vista più avanti [Sam59].
Stai stimando quanto dura un viaggio in auto. Parti dicendo «due ore». Dopo mezz’ora sei più avanti del previsto, e il navigatore dice che ne manca «un’ora e dieci». Non hai aspettato di arrivare per correggere la tua previsione: hai usato una stima più recente per aggiustare quella vecchia.
Il conto è tutto il metodo, quindi va fatto per bene. La previsione vecchia diceva due ore, cioè centoventi minuti. La stima nuova è fatta di due pezzi, quello che è già successo più quello che ancora manca: trenta minuti percorsi, più settanta che restano, fa cento minuti. La differenza è di venti minuti, e quei venti minuti sono l’errore: il viaggio andrà meglio di come lo avevi previsto, e la previsione va tirata giù. (Attenzione a un dettaglio che inganna: qui si stima un tempo, e una bella notizia lo fa scendere. Nel reinforcement learning, invece, si stima un punteggio, e una bella notizia lo fa salire. Il meccanismo è lo stesso, cambia solo che cosa si conta.) Il TD learning fa esattamente questo, correggendo un pezzetto alla volta. Il primo dei due pezzi, quello che è già successo, è l’unico dato vero della faccenda: è quello che tiene la correzione ancorata alla realtà invece che a un’altra opinione.
L’altro pezzo, i settanta minuti che mancano, resta un’opinione, e se è sbagliata la correzione tira dalla parte sbagliata: col cantiere trenta chilometri più avanti, che il navigatore non conosce, la previsione scende proprio mentre dovrebbe salire. Su una strada mai fatta capita spesso, ed è il prezzo di non aspettare l’arrivo per correggere.
Sia \(V(s)\) la stima del valore di uno stato \(s\) sotto la politica che si sta seguendo, cioè la ricompensa totale futura che ci aspettiamo partendo da lì e continuando a giocare come si sta giocando. Dopo aver osservato la transizione \(s \to s'\) con ricompensa osservata \(r\), l’aggiornamento TD(0) è
Qui \(\alpha \in (0,1]\) è il learning rate, \(\gamma \in [0,1]\) il fattore di sconto e \(\delta\) l’errore TD. Il termine \(r + \gamma V(s')\) è una stima aggiornata di \(V(s)\) costruita usando la stima successiva \(V(s')\): questa dipendenza da una stima per aggiornarne un’altra si chiama bootstrapping, ed è esattamente ciò che i metodi Monte Carlo non fanno. Il bersaglio non è più il ritorno osservato \(G_t\) ma una sua approssimazione a un passo: si guadagna in varianza (un solo termine casuale invece di una somma lunga) e si perde in correttezza, perché \(V(s')\) è a sua volta una stima, e all’inizio è sbagliata. La distorsione però non resta: per una policy fissa e una tabella, TD(0) converge a \(V^\pi\) con probabilità \(1\) se ogni stato è visitato infinite volte e i passi, presi sulle visite di ciascuno stato, soddisfano le condizioni di Robbins-Monro viste sui bandit [Day92]. E a parità di dati le due famiglie non convergono alla stessa cosa. Ripassando all’infinito un insieme finito di episodi (l’aggiornamento batch), Monte Carlo si ferma sui valori che minimizzano l’errore quadratico sui ritorni osservati; TD(0) si ferma invece sul valore esatto dell’MDP di massima verosimiglianza stimato da quegli episodi, la stima di certainty equivalence. Se il processo è davvero markoviano ci si aspetta che la seconda sbagli meno sui dati futuri, ed è una ragione, oltre alla varianza, per cui TD impara spesso più in fretta.
Q-learning: stimare il valore delle azioni#
Conoscere il valore di uno stato non basta per decidere senza il modello, come si è visto con i metodi Monte Carlo: serve sapere quanto vale ogni azione in quello stato. È il salto del Q-learning, formulato da Chris Watkins nella tesi di dottorato del 1989 [Wat89], forse l’algoritmo più celebre del campo.
Una grande tabella: una riga per ogni situazione in cui l’agente può trovarsi, una colonna per ogni mossa possibile, e all’incrocio un voto, che dice quanto conviene fare quella mossa in quella situazione. Quel voto, nelle formule, si chiama \(Q\), e da lì viene il nome dell’algoritmo. La lettera viene dalla tesi di Watkins ed è rimasta; torna comoda da ricordare come l’iniziale di quality, la qualità di una mossa, anche se il nome ufficiale della cosa è «funzione azione-valore». All’inizio i voti sono tutti a zero: l’agente non sa nulla. Giocando e ricevendo ricompense, corregge i voti. Alla fine, per agire bene, gli basta guardare la riga della situazione corrente e scegliere la mossa col voto più alto.
La parte sorprendente: l’agente può muoversi anche a casaccio, sbagliando di proposito per esplorare, e imparare comunque quali sarebbero le mosse migliori. Impara una cosa mentre ne fa un’altra. Per questo si dice off-policy, cioè «fuori dalla propria strategia».
Il trucco sta in una parola sola, il massimo: quando l’agente corregge il voto di una mossa, guarda dove è finito e prende il voto della migliore fra le mosse possibili da lì, non di quella che poi farà davvero. Quindi anche se subito dopo tira un dado e sbaglia apposta, il conto che ha appena scritto parlava di un giocatore che non sbaglia.
Giocando abbastanza a lungo i voti finiscono al posto giusto, e c’è una dimostrazione che lo garantisce. Il motivo, in una riga: ogni correzione è un giro della ricetta della value iteration fatto con una partita sola invece che con la mappa, e mediando tante partite il caso si cancella. In cambio la dimostrazione pone delle condizioni. Una è che ogni mossa venga provata tante volte in ogni situazione, non una o due: un voto corretto due volte vale quanto un sorteggio. Un’altra è che la tabella si possa scrivere per intero, riga per riga. E ce n’è una terza, sulla frazione di sorpresa a cui si dà retta: va calata man mano che si gioca. Il programma del labirinto la terrà ferma, e se lo può permettere perché in quel labirinto niente è lasciato al caso.
Prendere sempre il voto più alto, però, ha un difetto suo. Un voto si costruisce sommando una frazione di ogni sorpresa incassata fin lì. Nei mondi in cui il premio o l’esito di una mossa cambiano da una partita all’altra, le sorprese cambiano con loro: anche in una riga dove tutte e quattro le mosse valgono davvero zero, i voti scritti ballano un po’ attorno allo zero, per esempio \(-0{,}2\), \(+0{,}1\), \(-0{,}3\), \(+0{,}3\). Il più alto è \(+0{,}3\), cioè più di quanto la riga valga davvero. Succede in tutte le righe, e sempre nello stesso verso, verso l’alto: il massimo di quattro numeri sballati è quello che ha sbagliato dalla parte generosa. L’agente si fa così un’idea un po’ troppo rosea delle proprie mosse.
Per rimediare si tengono due tabelle, e a ogni correzione una sceglie e l’altra giudica: la prima dice qual è la mossa migliore dalla situazione d’arrivo, la seconda dice quanto vale quella mossa. Un voto che per fortuna è uscito troppo alto nella prima la fa scegliere, ma il numero che entra nel conto lo legge la seconda, che quella fortuna non l’ha avuta, e la gonfiatura non passa. A ogni correzione si tira a sorte quale delle due tabelle aggiornare, così che imparino tutte e due e nessuna giudichi sempre sé stessa. Si chiama Double Q-learning, il Q-learning a due tabelle.
Definiamo la funzione azione-valore ottima \(Q^*(s,a)\) come la ricompensa scontata attesa se in \(s\) eseguiamo \(a\) e poi seguiamo la politica ottima. Soddisfa l’equazione di ottimalità di Bellman
dove l’attesa è sulla ricompensa e sullo stato d’arrivo, \(S_{t+1} \sim P(\cdot \mid s, a)\).
Il Q-learning è off-policy perché il suo target usa \(\max_{a'} Q(s',a')\) (il valore dell’azione migliore nello stato successivo) indipendentemente da quale azione l’agente abbia poi effettivamente scelto. Impara così la politica ottima anche mentre ne segue una esplorativa.
Watkins e Dayan [WD92] ne dimostrarono la convergenza, e le ipotesi vanno enunciate per intero perché una di esse è la cerniera di tutto il deep reinforcement learning: in un MDP finito, con \(Q\) tabellare e ricompense limitate e sconto \(\gamma < 1\), purché ogni coppia \((s,a)\) sia visitata infinite volte e i passi soddisfino le condizioni di Robbins-Monro già viste sui bandit, \(Q\) converge a \(Q^*\) con probabilità \(1\). Le due somme però vanno prese sui passaggi di ciascuna coppia, non sul tempo globale: detta \(n^i(s,a)\) la \(i\)-esima volta che in \(s\) si prova \(a\), servono \(\sum_i \alpha_{n^i(s,a)} = \infty\) e \(\sum_i \alpha^2_{n^i(s,a)} < \infty\) per ogni \((s,a)\). La differenza non è formale. Con \(\alpha_t = 1/t\) e una coppia visitata ai tempi \(t = 2, 4, 8, \dots\), la somma globale diverge; ma la somma presa sui soli passaggi, che è quella richiesta dal teorema, vale \(\sum_{k \ge 1} 2^{-k} = 1\), e l’ipotesi cade.
Il perché della convergenza sta in una frase: il Q-learning è la value iteration con l’attesa sostituita da un campione. L’operatore di ottimalità
è una contrazione di fattore \(\gamma\) nella norma del massimo, per la stessa disuguaglianza sul massimo della value iteration; il bersaglio \(r + \gamma \max_{a'} Q(S_{t+1},a')\) ne è un campione non distorto; e l’aggiornamento è un passo di Robbins-Monro verso di esso. È l’approssimazione stocastica del punto fisso di una contrazione, la strada delle dimostrazioni di Jaakkola, Jordan e Singh [JJS94] e di Tsitsiklis [Tsi94], accanto a quella di Watkins e Dayan.
La garanzia vale però per il caso tabellare: sostituita la tabella con una funzione approssimata, la dimostrazione non si trasporta. Il deep reinforcement learning nasce proprio per far funzionare in pratica qualcosa che in generale non è garantito convergere.
Il \(\max\) nel target ha poi un costo suo, e la sezione sul DQN introdurrà un algoritmo apposta per correggerlo. Applicato a stime rumorose, il massimo è uno stimatore distorto verso l’alto del massimo dei valori veri: se in uno stato tutte le azioni valgono davvero zero ma le stime oscillano attorno allo zero, \(\max_{a'}Q(s',a')\) è sistematicamente positivo. La regola che lo dà è la disuguaglianza di Jensen applicata al \(\max\), che è convesso: \(\mathbb{E}[\max_a \hat{Q}(s,a)] \ge \max_a \mathbb{E}[\hat{Q}(s,a)]\), con disuguaglianza stretta appena nessuna azione è quasi certamente la migliore. È il bias di massimizzazione, e si attenua tenendo due stime indipendenti \(Q_A\) e \(Q_B\) e usandone una per scegliere l’azione e l’altra per valutarla, con i ruoli sorteggiati a ogni aggiornamento (Double Q-learning, di Hado van Hasselt [vH10]): è l’idea che là diventerà il Double DQN.
La formula di aggiornamento#
L’aggiornamento è una sola riga. Il valore stimato \(Q(s,a)\) della mossa \(a\) nella situazione \(s\), il suo voto, si sposta di una frazione \(\alpha\) verso un bersaglio: la ricompensa \(r\) appena incassata più il valore della mossa migliore dalla situazione \(s'\) in cui si è finiti, scontato di \(\gamma\). La differenza fra bersaglio e stima è l’errore TD, la sorpresa.
Scritta a parole, la riga è questa:
voto nuovo = voto vecchio + tasso × (bersaglio − voto vecchio)
ed è la stessa forma della regola del quaderno delle leve, incontrata in precedenza: una stima vecchia, più una frazione della sorpresa. Dentro ci sono quattro pezzi, e ognuno ha un nome che torna in ogni metodo che impara qualcosa.
Il voto vecchio, quello che c’era scritto nella tabella per quella situazione e quella mossa.
Il bersaglio: quanto quella mossa sembra valere adesso, cioè il premio appena incassato più il miglior voto della riga in cui si è finiti, ridotto dallo sconto. È una stima migliore della precedente perché contiene un pezzo di realtà, il premio appena visto. In inglese si chiama target, ed è la parola che si incontra nel codice.
La sorpresa, cioè bersaglio meno voto vecchio: positiva se è andata meglio del previsto, negativa se peggio.
Quanta parte della sorpresa dare retta: un numero fra zero e uno che si chiama tasso di apprendimento (learning rate) e nelle formule è la lettera greca \(\alpha\) (alfa). Sulle leve lo stesso numero si chiamava il passo. Vicino a zero l’agente corregge poco per volta ed è cauto; vicino a uno butta via il voto vecchio a ogni sorpresa.
E c’è lo sconto, la \(\gamma\) (gamma) della sezione sui processi decisionali di Markov (in sigla MDP, il modo di descrivere un ambiente come stati, mosse e ricompense), che decide quanto pesano le prospettive future rispetto al premio incassato subito.
In simboli:
Leggiamola da destra: \(r + \gamma \max_{a'} Q(s',a')\) è il target TD, la stima aggiornata del valore di \((s,a)\), dove \(r\) è la ricompensa osservata in questa transizione (non la ricompensa attesa \(r(s,a)\) del modello, che qui non conosciamo) e il termine \(\gamma \max_{a'} Q(s',a')\) si pone a zero quando \(s'\) è terminale, perché di là non c’è più niente da incassare; sottraendo la stima corrente \(Q(s,a)\) otteniamo l’errore; il learning rate \(\alpha\) decide quanto fidarci della correzione (piccolo = passi cauti); il fattore di sconto \(\gamma\) pesa il futuro (vicino a \(1\) = lungimirante, vicino a \(0\) = miope).
Il Q-learning tabellare non usa altro: nessuna rete neurale, nessun gradiente, solo la tabella dei valori \(Q\) aggiornata a ogni passo.
Esplorare o sfruttare: la strategia \(\varepsilon\)-greedy#
Se l’agente scegliesse sempre la mossa di valore \(Q\) più alto, potrebbe fermarsi su una strategia peggiore dell’ottima senza mai provare le mosse che la migliorerebbero. Serve un modo di esplorare, e il più semplice è quello delle leve, \(\varepsilon\)-greedy.
È di nuovo il dilemma del ristorante, e la ricetta è quella delle leve: quasi sempre la mossa che il quaderno dà per migliore, e con una piccola probabilità \(\varepsilon\) una a caso. All’inizio si esplora molto, e \(\varepsilon\) si riduce man mano che si impara.
Quanto in fretta lo riduci cambia tutto, e si vede con un conto. Trenta cene al mese, e parti con una novità su dieci: tre ristoranti nuovi il primo mese. Se poi dimezzi la quota ogni mese passi a una e mezza, poi a tre quarti, e sommando tutti i mesi da qui all’eternità arrivi a sei. Sei ristoranti nuovi in tutta la vita: quello che non hai provato entro allora non lo proverai mai, e se era il migliore della città non lo saprai. Se invece dividi la quota per il numero dei mesi passati (metà il secondo mese, un terzo il terzo, un decimo il decimo), la somma diventa tre più uno e mezzo più uno più tre quarti e così via, cioè sedici novità in dieci anni e ventitré in un secolo. Sembrano poche anche queste, ma la differenza sta altrove: con la prima ricetta il conto si ferma a sei, con la seconda non si ferma mai, e qualunque numero si fissi prima o poi lo si supera. Rallenti senza mai fermarti, e aspettando abbastanza ogni ristorante prima o poi ti capita. È la seconda ricetta a tenere in piedi la promessa dei voti che si assestano al posto giusto, perché quella promessa chiede che ogni mossa venga provata tante volte. Qui la situazione è una sola, la città, e i mesi sono anche le volte in cui ci si è trovati lì; con più situazioni il conto si tiene per ciascuna, dividendo per le volte in cui si è stati in quella. La prima ricetta si usa lo stesso, perché porta prima a risultati decenti, sapendo che cosa si lascia indietro.
Data la tabella corrente, la politica \(\varepsilon\)-greedy sceglie
Un \(\varepsilon\) costante garantisce esplorazione perpetua; in pratica si usa un decay, spesso esponenziale, per convergere gradualmente allo sfruttamento puro. Un decadimento esponenziale, però, sacrifica la garanzia teorica: la convergenza appena citata vuole ogni coppia \((s,a)\) visitata infinite volte, e per assicurarlo serve che la somma degli \(\varepsilon\) diverga su ogni stato, cosa che si ottiene con \(\varepsilon \propto 1/n(s)\), dove \(n(s)\) conta le visite a quello stato (con il tempo globale al denominatore non basta: uno stato visitato ai tempi \(t = 2^k\) raccoglie una somma finita). Questa condizione, unita al fatto che la policy diventi greedy nel limite, è ciò che si chiama GLIE (greedy in the limit with infinite exploration): con quella, e con le stesse condizioni sul passo che il teorema di Watkins e Dayan chiede, converge alla policy ottima anche il SARSA [SJLSzepesvari00]. GLIE è la coppia di requisiti, non la ricetta \(\varepsilon_t = 1/t\), che ne è soltanto un modo comodo di soddisfarli. Con un \(\varepsilon\) che si spegne esponenzialmente le mosse esplorative sono invece quasi certamente in numero finito, perché una serie geometrica di ragione minore di uno ha somma finita. In pratica lo scambio si accetta. La scelta di \(\varepsilon\) regola il compromesso exploration-exploitation, uno dei nodi teorici centrali del reinforcement learning.
SARSA: la variante on-policy#
SARSA differisce dal Q-learning per un solo termine dell’aggiornamento: al posto del valore della mossa migliore dalla situazione d’arrivo, \(\max_{a'} Q(s',a')\), usa il valore \(Q(s',a')\) della mossa \(a'\) che l’agente sceglie davvero. Il nome viene dalle iniziali dei cinque ingredienti del suo aggiornamento, stato, azione, ricompensa, nuovo stato, nuova azione, che in inglese sono state, action, reward, state, action e in italiano danno le stesse cinque lettere. E si dice on-policy, che è il contrario di off-policy: invece di imparare quanto varrebbero le mosse di un giocatore perfetto, impara quanto valgono le proprie, esplorazione compresa. L’algoritmo è di Rummery e Niranjan [RN94], che lo chiamavano modified connectionist Q-learning; il nome con cui lo conosciamo glielo diede Sutton nel 1996.
Il Q-learning è un ottimista spericolato: valuta ogni mossa immaginando di comportarsi perfettamente subito dopo. SARSA è più prudente: valuta le mosse tenendo conto che, di tanto in tanto, esplorerà davvero e potrebbe sbagliare. Impara il valore della politica che effettivamente segue, esplorazione compresa.
Il cambio è di un pezzo solo. Quando corregge il voto di una mossa, SARSA guarda dove è finito e prende il voto della mossa che farà davvero, dado compreso, al posto del voto della migliore di quella riga. C’è anche una via di mezzo: invece di aspettare il dado, fare la media dei voti della riga, ciascuno pesato per quanto spesso la strategia lo sceglierebbe. Toglie dal conto il caso del dado, e se la strategia sceglie sempre la mossa migliore ridà esattamente il Q-learning.
Il risultato tipico si vede su un esperimento classico, che si chiama cammino sul precipizio: una griglia di quattro righe per dodici colonne, in cui la partenza e l’arrivo occupano le due caselle agli estremi della riga in basso e tutte le dieci caselle in mezzo a loro sono un burrone. La strada più corta passa nella riga subito sopra, cioè proprio sull’orlo, e un passo storto fa cadere di sotto: chi cade paga cento punti e si ritrova alla partenza, con la partita che continua e la strada tutta da rifare. SARSA impara a salire fin sopra, lontano dal bordo, e ci arriva in qualche passo in più senza quasi mai finire di sotto; il Q-learning impara a camminare sull’orlo, perché «in teoria» non sbaglierebbe mai un passo, e ogni tanto ci casca davvero.
I conti della scena dicono perché la prudenza paga. Ogni passo costa un punto e la caduta ne costa cento: la strada alta aggiunge quattro passi a partita, e quei quattro punti si ripagano da soli se si finisce di sotto anche una volta sola ogni venticinque partite. Il dado si tira una volta ogni dieci mosse (è la quota di esplorazione, qui tenuta ferma a un decimo) e sceglie fra quattro direzioni, di cui una sola porta di sotto: ogni casella sul bordo fa cadere due volte e mezza su cento, e di caselle affacciate sul vuoto ce n’è una decina da attraversare. La probabilità di scamparle tutte e dieci è \(0{,}975\) moltiplicato per sé stesso dieci volte, cioè poco più di tre quarti: di sotto ci si finisce quasi in una partita su quattro.
Se il dado sparisce, sparisce anche la differenza. Un agente che non esplora più non ha modo di fare il passo storto, l’orlo torna a essere la strada migliore per davvero, e i due finiscono per imparare la stessa cosa: la prudenza di SARSA diventa allora qualche passo buttato via.
SARSA è on-policy: nel target non compare il massimo, ma il valore dell’azione \(a'\) realmente scelta nello stato \(s'\) dalla stessa politica (ad esempio \(\varepsilon\)-greedy):
Valuta dunque la politica di comportamento anziché quella greedy. Nel classico esempio del cliff walking (Sutton e Barto), che è un compito episodico non scontato (\(\gamma = 1\), con \(-1\) su ogni transizione e una caduta che costa \(-100\) e rispedisce alla partenza senza chiudere l’episodio), SARSA converge a un cammino più sicuro e lontano dal precipizio, il Q-learning al cammino ottimo ma rischioso lungo il bordo: differenza che sparisce solo quando \(\varepsilon \to 0\).
Fra i due sta una terza regola, che al posto del campione \(a'\) usa l’attesa sotto la policy, ed è Expected SARSA:
Ha la stessa media di SARSA e varianza minore, perché toglie il caso della scelta di \(a'\); e se \(\pi\) è la policy greedy diventa esattamente il Q-learning. On-policy e off-policy, qui, sono due scelte della policy rispetto a cui si prende l’attesa del bersaglio [SB18].
Le due strade, disegnate sulla stessa griglia, si confrontano a colpo d’occhio (Fig. 13.4): quella corta cammina sull’orlo per dieci caselle, quella alta se ne tiene lontana e paga quattro passi.
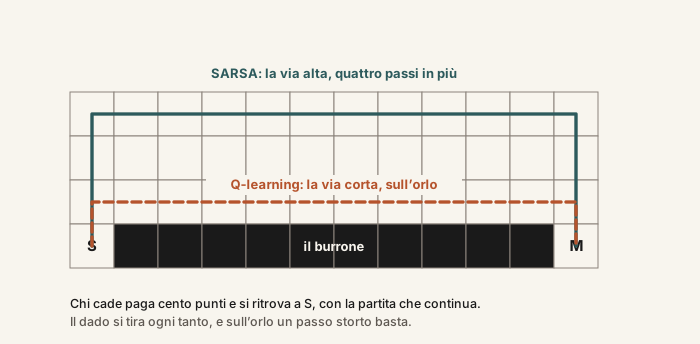
Fig. 13.4 Il cammino sul precipizio. La via corta corre sull’orlo del burrone, la via alta lo evita salendo fino in cima alla griglia. Il Q-learning impara la prima perché valuta un giocatore che non sbaglia mai; SARSA impara la seconda perché mette in conto i passi storti che farà davvero.#
Un labirinto concreto#
Rendiamo tutto tangibile con una griglia di tre righe per quattro colonne. La partenza (S) è in basso a sinistra; la meta, che paga \(+1\), è in alto a destra; la trappola, che fa perdere un punto e chiude comunque la partita, è subito sotto la meta; e c’è un muro nella seconda casella della riga di mezzo, contro cui si sbatte restando fermi. A ogni passo si sceglie fra su, giù, sinistra, destra.
Attenzione alle regole, perché non sono quelle del robot della sezione sugli MDP, dove ogni passo faceva perdere un punto. Qui i passi non costano nulla: girovagare non fa perdere punti. A spingere l’agente verso l’uscita c’è soltanto lo sconto, che rende il premio meno appetitoso quanto più lo si fa aspettare, ed è quindi lui, da solo, a rendere conveniente la strada corta. Sono invece le stesse della griglia su cui là si guarda l’iterazione dei valori (premio \(+1\), passi gratis, sconto \(0{,}9\)), con in più la trappola.

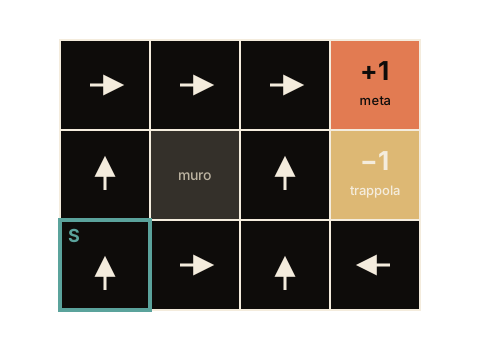
Fig. 13.5 La strategia imparata dal Q-learning sulla griglia: in ogni cella la freccia indica la mossa che, finite tutte le partite di allenamento, ha il voto più alto. È il risultato che stampa il programma del labirinto. Il disegno mostra il punto d’arrivo, non la strada per arrivarci: quella, cioè il valore della meta che retrocede una casella per volta, la mostra la Fig. 13.7.#
All’inizio la tabella dei voti è tutta a zero. Fissiamo un tasso di apprendimento di \(0{,}5\) (si dà retta a metà della sorpresa) e uno sconto di \(0{,}9\).
La prima volta che l’agente calpesta la meta incassa \(1\) e la partita finisce lì, quindi dalla casella d’arrivo non c’è più niente da aspettarsi. La sorpresa è tutta lì: si aspettava \(0\), ha incassato \(1\). Dandole retta a metà, il voto dell’ultima mossa passa da \(0\) a \(0{,}5\).
Alla casella che veniva prima tocca più tardi, e non alla partita dopo: alla prima partita in cui l’agente ci ripassa. Quando ci era passato, i voti della casella in cui era finito erano ancora tutti zero, e correggere verso zero non muove niente. Adesso invece il \(0{,}5\) c’è, e servirà a chi ripasserà di lì. Da quella casella la mossa non paga niente, ma porta nella casella accanto alla meta, che nella sua riga di tabella ha ormai una mossa da \(0{,}5\) (i voti stanno sulle mosse, e quello che conta qui è il migliore della riga): scontato, vale \(0{,}9 \times 0{,}5 = 0{,}45\). La sorpresa è di nuovo positiva (si aspettava \(0\), la prospettiva vale \(0{,}45\)) e dandole retta a metà il voto diventa \(0{,}225\).
Tutti e due i conti funzionano perché qui muoversi non costa nulla: nel labirinto del robot, dove ogni passo faceva perdere un punto, la seconda mossa avrebbe reso \(-1 + 0{,}45 = -0{,}55\), e il voto sarebbe diventato \(-0{,}275\) invece di \(0{,}225\).
Poniamo \(\alpha=0{,}5\) e \(\gamma=0{,}9\). La prima volta che l’agente calpesta la meta (\(r=+1\), stato successivo terminale con valore \(0\)), la casella dell’ultima mossa diventa
Al primo episodio successivo che ripassa da lì, la cella precedente \(s^-\), da cui si arriva a \(s\), «vede» \(\max_{a'} Q(s,a')=0{,}5\) e si aggiorna:
Entrambi i conti usano \(r\) come ricompensa osservata e sfruttano il fatto che in questo mondo la transizione non paga alcun costo di passo: in un mondo che penalizzasse ogni mossa con \(-1\), il secondo aggiornamento darebbe \(0{,}5\,[-1 + 0{,}45] = -0{,}275\).
Ecco il meccanismo TD in azione: la ricompensa non salta dappertutto in una volta, ma retrocede verso la partenza di al più un passo per episodio, come una macchia che si allarga all’indietro dalla meta. In codice sta tutto in una pagina, ambiente compreso:
import numpy as np

# Griglia 3x4: 12 stati, 4 azioni (0=su 1=giù 2=sinistra 3=destra)
RIGHE, COLONNE = 3, 4
MURO, META, TRAPPOLA = (1, 1), (0, 3), (1, 3)
MOSSE = [(-1, 0), (1, 0), (0, -1), (0, 1)]
LIBERE = [(i, j) for i in range(RIGHE) for j in range(COLONNE)
          if (i, j) not in (MURO, META, TRAPPOLA)]

n_stati, n_azioni = RIGHE * COLONNE, 4
Q = np.zeros((n_stati, n_azioni))       # tabella dei voti, tutta a zero
alpha, gamma, epsilon = 0.5, 0.9, 0.1
rng = np.random.default_rng(20260807)

def indice(cella):
    return cella[0] * COLONNE + cella[1]

def ambiente(cella, a):
    """Dove si finisce, quanto si incassa, se la partita è finita."""
    i, j = cella[0] + MOSSE[a][0], cella[1] + MOSSE[a][1]
    if not (0 <= i < RIGHE and 0 <= j < COLONNE) or (i, j) == MURO:
        i, j = cella                          # contro un muro si resta fermi
    if (i, j) == META:     return (i, j), 1.0, True
    if (i, j) == TRAPPOLA: return (i, j), -1.0, True
    return (i, j), 0.0, False

def epsilon_greedy(s):
    if rng.random() < epsilon:
        return int(rng.integers(n_azioni))    # esplora: mossa a caso
    return int(np.argmax(Q[s]))               # sfrutta: mossa col voto più alto

def aggiorna(s, a, r, s_next, fine):
    # target TD: usa la stima migliore dello stato successivo (off-policy)
    td_target = r if fine else r + gamma * np.max(Q[s_next])
    Q[s, a] += alpha * (td_target - Q[s, a])  # correggi verso il target

# Inizi esplorativi: ogni episodio comincia da una casella sorteggiata.
for _ in range(5000):
    cella = LIBERE[rng.integers(len(LIBERE))]
    for _ in range(100):
        s = indice(cella)
        a = epsilon_greedy(s)
        cella_dopo, r, fine = ambiente(cella, a)
        aggiorna(s, a, r, indice(cella_dopo), fine)
        if fine:
            break
        cella = cella_dopo

FRECCE = "^v<>"
def voto(cella):
    if cella == MURO:     return "  muro"
    if cella == META:     return "    +1"
    if cella == TRAPPOLA: return "    -1"
    s = indice(cella)
    return f"{FRECCE[int(np.argmax(Q[s]))]}{Q[s].max():5.2f}"

for i in range(RIGHE):
    print(" | ".join(voto((i, j)) for j in range(COLONNE)))
> 0.81 | > 0.90 | > 1.00 |     +1
^ 0.73 |   muro | ^ 0.90 |     -1
^ 0.66 | > 0.73 | ^ 0.81 | < 0.73
Le stesse tre righe, con le frecce al posto di ^v<> e i due traguardi
chiamati per nome:
colonna 1 |
colonna 2 |
colonna 3 |
colonna 4 |
|---|---|---|---|
→ \(0{,}81\) |
→ \(0{,}90\) |
→ \(1{,}00\) |
meta, \(+1\) |
↑ \(0{,}73\) |
muro |
↑ \(0{,}90\) |
trappola, \(-1\) |
↑ \(0{,}66\) |
→ \(0{,}73\) |
↑ \(0{,}81\) |
← \(0{,}73\) |
Le frecce sono, una per una, quelle della Fig. 13.5, e i numeri accanto si controllano a mano. La casella da cui basta una mossa per arrivare vale il premio pieno, \(1{,}00\); ogni passo indietro lo moltiplica per lo sconto, e viene \(0{,}90\), poi \(0{,}81\), poi \(0{,}729\) e poi \(0{,}6561\), che il programma stampa arrotondati a \(0{,}73\) e \(0{,}66\). Ci sono tutti: l’angolo in basso a sinistra, che dalla meta dista cinque passi ed è la casella più lontana, porta appunto il \(0{,}66\).
Di ogni casella, però, la griglia stampa un numero solo, il migliore dei quattro; la tabella per intero è quella della Fig. 13.6, dove ogni quadretto del labirinto è una riga e ogni mossa una colonna.
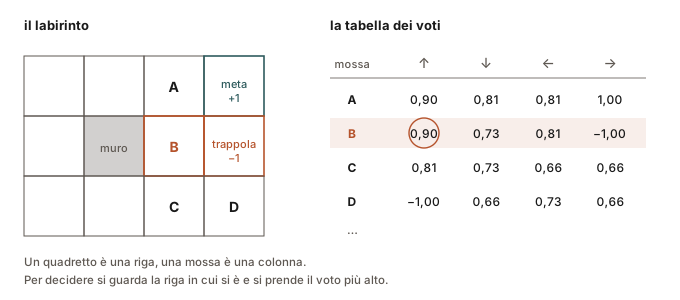
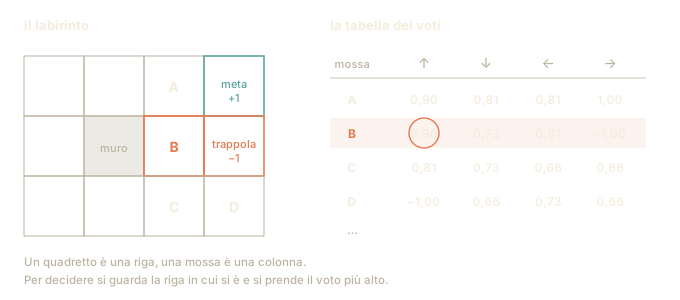
Fig. 13.6 Quattro quadretti del labirinto e le loro righe di tabella, con i voti che il programma ha davvero scritto dopo cinquemila partite. Il quadretto B ha la trappola a destra, e infatti quella mossa vale \(-1\); la freccia che si legge nella griglia è il voto cerchiato, il più alto della riga. Il quadretto D, che sta sotto la trappola, ha lo stesso \(-1\) sulla mossa in su.#
Un momento, però: la casella da cui basta una mossa per arrivare, quella che qui vale \(1{,}00\), poco fa valeva \(0{,}5\). Sono due istantanee della stessa storia, e non una contraddizione. Il \(0{,}5\) era il voto dopo il primo passaggio, quando alla sorpresa si dava retta a metà partendo da zero. Per quella mossa il bersaglio resta sempre \(1\), perché incassa il premio e la partita finisce lì: a ogni passaggio successivo, quindi, il voto recupera metà della distanza che lo separa da \(1\), e diventa \(0{,}75\), poi \(0{,}875\), poi \(0{,}9375\), e così via. Dopo cinquemila partite ci è arrivato così vicino che, alla seconda cifra, si legge \(1{,}00\).
Per le altre caselle succede la stessa cosa, con una complicazione in più, che ha già un nome, bootstrapping: il loro bersaglio contiene la stima della casella successiva, e quindi non sta fermo. La casella accanto era partita rincorrendo \(0{,}45\), cioè lo sconto per il \(0{,}5\) che c’era allora; ma mentre lei ci correva dietro, quel \(0{,}5\) è salito verso \(1\), e quindi il bersaglio è salito verso \(0{,}90\). Ogni casella insegue un numero che a sua volta sta salendo, e la fila si assesta dall’ultima all’indietro. I conti a mano dicono da dove parte ciascun voto, la griglia stampata dice dove arriva, e la Fig. 13.7 mostra il tragitto.
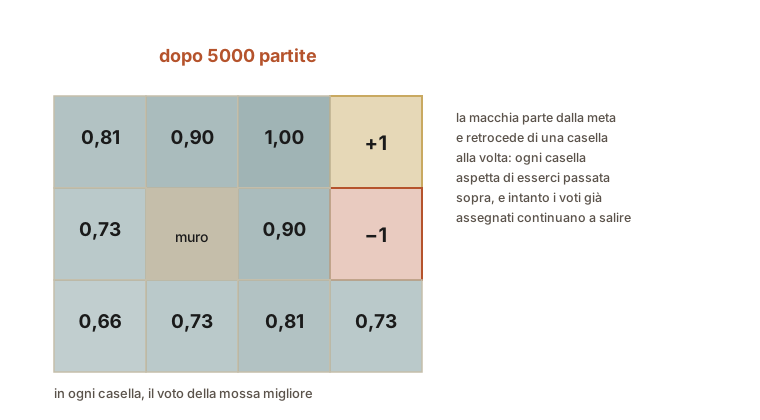
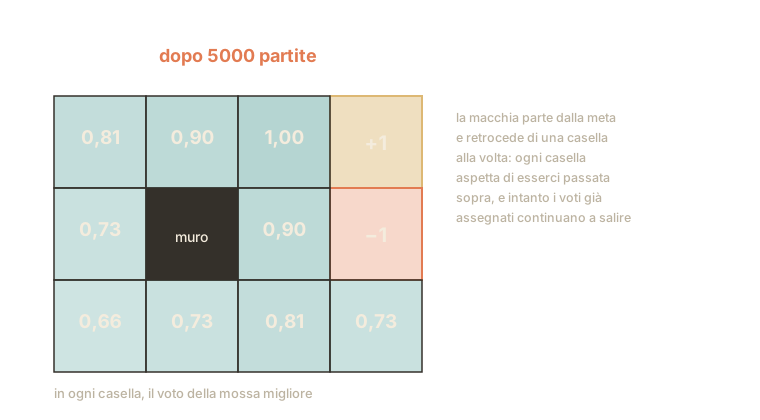
Fig. 13.7 Sette istantanee della stessa esecuzione, quella del programma del labirinto con il suo seme. Per sette partite le nove caselle restano bianche, e non perché la tabella sia vuota: alla quarta l’agente finisce nella trappola e quella mossa incassa il suo \(-0{,}50\). Ma qui si legge il voto della mossa migliore, e finché nessuna partita ha toccato la meta la mossa migliore di ogni casella vale ancora zero. All’ottava la casella accanto alla meta prende \(0{,}50\), che è il numero del primo conto a mano; all’undicesima quella è già a \(0{,}75\) e la casella prima prende \(0{,}23\), che è il secondo. Da lì la macchia arretra una casella alla volta, e non a ogni partita: perché una casella riceva il suo primo voto bisogna che l’agente ci passi sopra quando la casella dopo un voto ce l’ha già. Per questo l’ultima a illuminarsi non è quella più lontana dalla meta, che ce l’ha alla ventunesima partita, ma l’angolo in basso a destra, sotto la trappola: a decidere è il passaggio, non la distanza. L’ultima istantanea è la griglia che il programma stampa.#
Nel programma, la funzione aggiorna è il Q-learning per intero. Per ottenere
invece SARSA basterebbe passarle l’azione che l’agente sceglierà davvero al
passo successivo, e usare il voto di quella al posto del voto della mossa
migliore.
Il tasso di apprendimento (alpha) resta fermo a metà per tutte e cinquemila
le partite. Un tasso che non si accorcia mai continua per sempre a rincorrere
le ultime sorprese, e in un mondo che sorteggia i premi non si posa su un
numero; nel labirinto non se ne accorge nessuno, perché è tutto fisso e la
sorpresa, alla fine, è zero. Fra le condizioni della dimostrazione che i voti
si assestano al posto giusto c’è proprio un tasso che si accorci come il passo
del quaderno delle leve: abbastanza da posarsi, non tanto da fermarsi prima di
arrivare. Qui ci si rinuncia, in cambio di un algoritmo che reagisce in fretta,
che nella pratica conviene quasi sempre. Anche la quota di esplorazione resta
ferma a un decimo invece di calare, e qui è lecito: al Q-learning, che impara
la mossa migliore mentre ne fa un’altra, basta che ogni coppia continui a
essere provata. Che l’esplorazione alla lunga si spenga lo chiede invece SARSA,
che valuta le mosse che fa davvero e, con un decimo di mosse a caso, impara il
valore di chi sbaglia un decimo delle volte.
Ogni partita, poi, comincia da una casella sorteggiata invece che dalla partenza. Sono gli inizi esplorativi dei metodi Monte Carlo in versione più debole: là si sorteggiava la coppia casella-mossa, qui solo la casella, e a provare tutte le mosse ci pensa l’\(\varepsilon\)-greedy. Dentro un simulatore, che possiamo far ripartire dove vogliamo, costano una riga. Senza, le caselle lontane dal cammino migliore verrebbero visitate di rado, la loro riga resterebbe quasi vuota e la loro freccia sarebbe poco più di un sorteggio. Lo si vede rifacendo l’addestramento con tutte le partite che cominciano dalla partenza, in basso a sinistra, e contando quante volte l’agente passa dall’angolo in basso a destra, che sul cammino migliore non sta:
def addestra(dalla_partenza, seme=20260807):
    """Rifà le 5000 partite; dà visite e voto dell'angolo in basso a destra."""
    global Q, rng
    Q, rng = np.zeros((n_stati, n_azioni)), np.random.default_rng(seme)
    visite = np.zeros(n_stati, dtype=int)
    for _ in range(5000):
        cella = (2, 0) if dalla_partenza else LIBERE[rng.integers(len(LIBERE))]
        for _ in range(100):
            s = indice(cella)
            visite[s] += 1
            a = epsilon_greedy(s)
            cella_dopo, r, fine = ambiente(cella, a)
            aggiorna(s, a, r, indice(cella_dopo), fine)
            if fine:
                break
            cella = cella_dopo
    angolo = indice((2, 3))
    return visite[angolo], Q[angolo].max()

for nome, dalla_partenza in (("partenze sorteggiate", False),
                             ("sempre dalla partenza", True)):
    visite, voto_angolo = addestra(dalla_partenza)
    print(f"{nome:22} visite all'angolo: {visite:4d}   voto: {voto_angolo:.2f}")
altri = [addestra(True, seme)[0] for seme in (1, 2, 3, 4, 5)]
print("sempre dalla partenza, altri cinque semi, visite:", *altri)
partenze sorteggiate   visite all'angolo:  750   voto: 0.73
sempre dalla partenza  visite all'angolo:   22   voto: 0.55
sempre dalla partenza, altri cinque semi, visite: 0 0 0 1 0
Con i sorteggi del primo programma (il numerone accanto a default_rng è il
seme: fissa la sequenza dei numeri a caso, così che rilanciando il programma
esca la stessa identica storia) l’agente passa dall’angolo settecentocinquanta
volte con le partenze sorteggiate e ventidue partendo sempre dal basso a
sinistra, e il voto dell’angolo si ferma a \(0{,}55\) invece che a \(0{,}73\). Con
altri semi può non passarci mai, o passarci una volta sola, e una volta non
basta: con la riga tutta a zero la prima mossa che si prova è quella in su, che
porta nella trappola, e il \(-0{,}50\) che ne esce il massimo della riga non lo
tocca. La freccia, allora, è quella che viene.
Fra un passo e la fine: quanti passi guardare avanti#
Torniamo un momento alla macchia che si allarga all’indietro dalla meta. Il Q-learning la fa retrocedere di al più una casella per partita, perché il suo bersaglio guarda avanti di un passo solo. I metodi Monte Carlo, all’estremo opposto, usano il totale della partita, e in una partita sola portano la notizia a tutte le caselle attraversate: una notizia sola, però, e rumorosa. Fra i due estremi c’è una famiglia intera: il bersaglio può guardare avanti \(n\) passi, da \(n = 1\), le differenze temporali, fino alla fine della partita, Monte Carlo.
La domanda è: quanti passi guardare prima di fidarsi della propria stima? Uno solo, e allora è il TD; tutti quelli che restano fino alla fine, e allora è Monte Carlo; oppure tre, o dieci.
Guardare pochi passi dà una correzione stabile ma quasi sempre un po’ sbagliata, perché si appoggia a una stima che, quando si è appena cominciato a giocare, non vale niente. Guardare fino in fondo dà una correzione sempre onesta ma ballerina. Guardarne una manciata, in pratica, batte quasi sempre entrambi gli estremi.
C’è anche un modo elegante di non scegliere: fare la media di tutte le lunghezze, dando più peso a quelle corte e via via meno a quelle lunghe. Il peso cala di una frazione fissa a ogni passo in più, come un’eco che si spegne, e la manopola che decide quanto in fretta si spenga si chiama \(\lambda\) (lambda), un numero fra zero e uno.
I due estremi si capiscono guardando come si spartisce il peso. La lunghezza più corta, un passo, si prende quanto manca a \(\lambda\) per arrivare a uno; quel che avanza se lo spartiscono le lunghezze successive, con la stessa regola. Con \(\lambda = 0\) la prima si prende tutto, e siamo tornati alle differenze temporali. Con \(\lambda = 0{,}5\) il passo singolo prende metà del peso, quello doppio un quarto, quello triplo un ottavo, e così via dimezzando. Più \(\lambda\) si avvicina a uno, più il peso scivola verso le lunghezze lunghe: con \(\lambda = 0{,}9\) alle prime dieci lunghezze messe insieme ne toccano circa due terzi (uno meno \(0{,}9\) moltiplicato per sé stesso dieci volte, cioè \(1 - 0{,}35\)), e il resto va più in là. Ma nelle partite che finiscono, questo «più in là» ha un fondo: oltre la fine, guardare avanti dieci passi o cento è la stessa cosa, cioè guardare fino in fondo, e tutto il peso che avanza va al totale della partita. A \(\lambda = 1\) ci va tutto, e siamo tornati a Monte Carlo. In mezzo c’è tutto il resto.
Detta così sembra impossibile da fare mentre si gioca, perché quella media guarda avanti, e il futuro non lo si conosce. Il trucco è guardare dall’altra parte: invece di chiedersi «che cosa succederà dopo questa casella», si tiene un elenco delle caselle appena attraversate, ciascuna con un ricordo che sfuma a ogni passo. A farlo sfumare sono due cose insieme: \(\lambda\), e lo sconto che pesa meno ciò che sta lontano nel tempo. Quel ricordo si chiama traccia, e quando arriva una sorpresa la si distribuisce a tutta la scia, tanto più forte quanto più recente è il passaggio. Che venga davvero lo stesso risultato non è ovvio ed è un conto da fare; l’idea è che dare a ogni casella un pezzetto di correzione alla volta, per tutta la partita, alla fine somma quanto le si sarebbe dato in un colpo solo guardando avanti. Il totale coincide esattamente se si aspetta la fine della partita per applicare le correzioni; coincide quasi esattamente se le si applicano strada facendo, che è il modo in cui il metodo si usa. Il guadagno è che non si aspetta mai la fine: la correzione si scrive a ogni passo, e una manopola sola le copre tutte le lunghezze insieme. Di memoria non se ne risparmia, semmai il contrario: il ricordo che sfuma va tenuto per ogni casella della griglia, non solo per le ultime dieci attraversate.
Il calcolo si definisce prima sul valore di uno stato, \(V(s)\), che è la forma in cui le equazioni si leggono meglio; per il controllo si trasporta poi tale e quale sui valori delle azioni, diventando SARSA a \(n\) passi e SARSA(\(\lambda\)).
Il ritorno a \(n\) passi tronca la somma dopo \(n\) ricompense vere e chiude con la stima corrente:
e l’aggiornamento è il solito \(V(S_t) \leftarrow V(S_t) + \alpha\,[\,G_{t:t+n} - V(S_t)\,]\). Per \(n=1\) si ritrova TD(0); per \(n\) pari o superiore ai passi che restano fino alla fine dell’episodio il termine con \(V\) sparisce e resta il ritorno Monte Carlo. Il compromesso è quello classico fra distorsione e varianza: \(n\) piccolo poca varianza e molta distorsione, \(n\) grande il contrario. Nei banchi di prova di Sutton e Barto si impara più in fretta a valori intermedi che agli estremi [SB18].
Il \(\lambda\)-return evita di dover scegliere \(n\): è la media pesata di tutti i ritorni a \(n\) passi, con pesi che decadono geometricamente,
con \(\lambda = 0\) che restituisce TD(0). E \(\lambda = 1\)? In un episodio che termina al passo \(T\) tutti i ritorni con \(n \ge T-t\) coincidono con il ritorno intero \(G_t\); raccogliendone i pesi, la coda della somma si compatta in un termine \(\lambda^{\,T-t-1}\, G_t\), che a \(\lambda = 1\) è l’unico a sopravvivere: si ritrova Monte Carlo.
Scritta così la formula è impraticabile, perché richiede di conoscere il futuro: è la vista in avanti. Le tracce di eleggibilità danno la stessa cosa dalla vista all’indietro, calcolabile passo per passo mentre si gioca: si tiene un vettore \(\mathbf{z}\) che segna quali stati sono «in attesa di credito»,
cioè la traccia di uno stato sale di \(1\) quando lo si visita e sfuma di \(\gamma\lambda\) a ogni passo successivo. A ogni istante si calcola un solo errore TD \(\delta_t\) e lo si distribuisce a tutti gli stati in proporzione alla loro traccia: \(V(s) \leftarrow V(s) + \alpha\,\delta_t\, z_t(s)\). Una ricompensa inattesa corregge così in un colpo tutta la scia di stati che l’hanno preceduta, i più recenti di più. L’occupazione di memoria è una traccia per stato, ed è quindi dello stesso ordine delle stime di valore che si tengono già. Pesa \(O(|\mathcal{S}|)\) nel caso tabellare, \(O(|\mathcal{S}||\mathcal{A}|)\) quando le tracce stanno sulle coppie, e \(O(d)\) con l’approssimazione lineare, dove \(d\) è il numero di caratteristiche dell’approssimatore. Soprattutto, non cresce né con la lunghezza dell’episodio né con \(\lambda\). Con una tabella il guadagno non è la memoria: una traccia per stato costa più dei soli \(n\) stati che il ritorno a \(n\) passi tiene da parte, e il risparmio arriva con l’approssimazione, dove un vettore di tracce sta al posto degli ultimi \(n\) vettori di caratteristiche. Il guadagno vero è che la correzione si scrive a ogni passo invece di arrivare con \(n\) passi di ritardo, e che una manopola sola sostituisce la scelta di \(n\). Le due viste danno lo stesso risultato: esattamente se i pesi restano fermi per tutto l’episodio, mentre online l’uguaglianza esatta chiede la dutch trace del true online TD(\(\lambda\)), e la traccia accumulante di qui la approssima [SB18].
Per il controllo off-policy la traccia così com’è non basta. Il Q-learning valuta la policy greedy, e una scia che continua dopo un’azione esplorativa darebbe credito a un cammino che quella policy scarta. Il Q(\(\lambda\)) di Watkins azzera allora tutte le tracce alla prima azione non greedy, e a decidere il taglio è l’azione scelta, non l’estrazione dell’\(\varepsilon\): un’esplorazione che pesca comunque l’azione greedy non interrompe niente [SB18].
Sul labirinto la differenza è quella della Fig. 13.8: lo stesso episodio, e a un passo alla volta si muove la sola mossa che incassa il premio, mentre con le tracce si muovono tutte, in dissolvenza all’indietro. È il motivo per cui i metodi che guardano più passi avanti imparano più in fretta quando le ricompense sono rare.
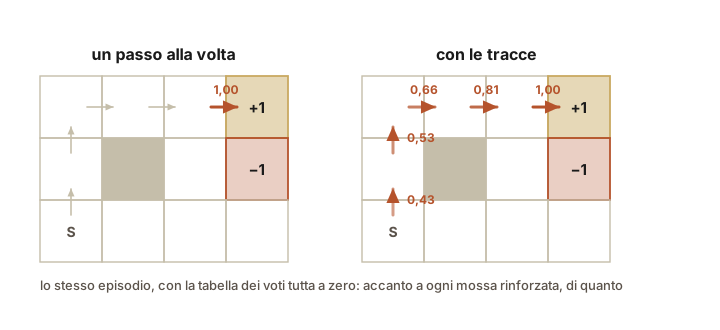
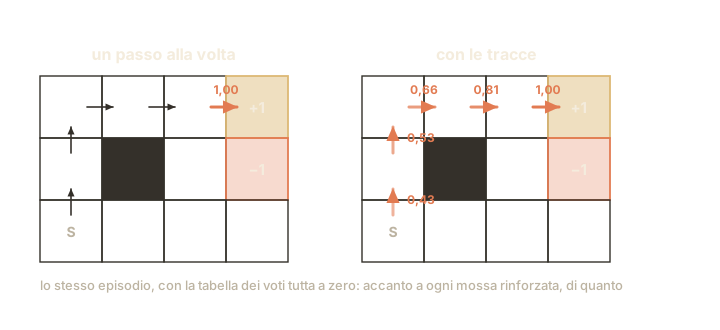
Fig. 13.8 Lo stesso episodio, il cammino più corto dalla partenza alla meta, con la tabella dei voti tutta a zero. A un passo alla volta il bersaglio è zero ovunque tranne sull’ultima mossa, che incassa il premio: si rinforza quella e basta. Con le tracce si rinforzano tutte, ciascuna per quanto vale la sua traccia nell’istante della sorpresa: lo sconto per \(\lambda\), cioè \(\gamma\lambda\), moltiplicato per sé stesso tante volte quanti sono i passi che la separano dalla fine. Con lo sconto di \(0{,}9\) e \(\lambda = 0{,}9\) quel prodotto vale \(0{,}81\), e alla mossa più vecchia, quattro passi prima della fine, arriva ancora \(0{,}81^4 \approx 0{,}43\), il \(43\%\) della correzione.#
La scia intera del disegno vale quando si giudica la strategia che si sta seguendo, come fa SARSA. Il Q-learning giudica invece un giocatore che non sbaglia mai, e allora la scia va tagliata alla prima mossa esplorativa che quel giocatore non avrebbe fatto: è la mossa storta dell’archivio dei metodi Monte Carlo, dopo la quale la partita non è più la sua. La variante del Q-learning che taglia così si chiama Q(\(\lambda\)) di Watkins.
Lo stesso \(\lambda\) ritorna nella sezione sul gradiente di policy. Là il segnale che guida l’apprendimento si chiama vantaggio di una mossa, ed è quanto quella mossa è migliore della media delle mosse possibili in quella situazione; e la sorpresa di un passo, l’errore TD, ne è già una stima, la più semplice. Il modo standard di calcolarlo, la generalized advantage estimation [SML+16], somma gli errori TD dei passi successivi con pesi che calano di \(\gamma\lambda\) a ogni passo, come le tracce, e la scelta è di nuovo la stessa: quanto accettare che il bersaglio sia storto, in cambio di quanto farlo ballare di meno.
Quando la tabella non basta più#
Tutto quello che si è visto poggia su un’ipotesi che finora è comparsa solo fra le condizioni della dimostrazione di Watkins e Dayan, e che negli esempi era così ovvia da non pesare: che le situazioni si possano elencare, una riga di tabella ciascuna. Nel labirinto sono dodici. In un gioco da tavolo sono più delle molecole d’aria di questa stanza. Sullo schermo di un videogioco, dove ogni fotogramma diverso è una situazione diversa, la tabella non si può scrivere in nessun universo, come dicono i conti della sezione sugli MDP.
E si rompe due volte, non una. Si rompe per memoria, perché servirebbe un voto per ogni coppia situazione-mossa. E si rompe per dati, che è il guasto peggiore: anche avendo la tabella, quasi ogni situazione che l’agente incontra non l’ha mai vista prima, quindi la sua riga è ancora vuota, e riempire per esperienza diretta ogni riga di una tabella così grande richiederebbe più partite di quante se ne possano giocare.
La via d’uscita non è un algoritmo diverso: le idee viste finora (la sorpresa che corregge, il bersaglio a un passo, l’esplorazione dosata) restano tutte. È una rappresentazione diversa. Al posto della tabella serve qualcosa che, vista una situazione mai incontrata, sappia indovinarne i voti somigliandola a quelle che ha già visto, e quel qualcosa sono le reti neurali dei capitoli precedenti. È la ragione per cui esiste il Deep Reinforcement Learning.
Con un’avvertenza. Che il Q-learning arrivi prima o poi ai voti giusti non è una speranza, è un teorema, dimostrato nel 1992 da Watkins insieme a Peter Dayan; ma quel teorema parla di una tabella, e di una tabella soltanto. Buttata via la tabella, la promessa non c’è più, e non perché manchi ancora una dimostrazione: si sa che in quel caso i voti possono scappare via, e ci sono esempi costruiti apposta per farlo vedere. La causa ha un nome, la triade fatale: l’approssimazione di funzione (valori stimati da una formula invece che scritti uno per uno), il bootstrapping e l’apprendimento off-policy messi insieme. È esattamente ciò che accade in un Q-learning con una rete al posto della tabella. Il deep reinforcement learning è in buona parte il mestiere di tenerli fermi lo stesso.
Da ricordare
Le differenze temporali correggono la stima durante il viaggio, non all’arrivo: come il navigatore che dopo mezz’ora rivede il tempo che manca, si usa la stima più recente per aggiustare quella vecchia, un pezzetto alla volta.
Il Q-learning tiene una tabella di voti (una riga per situazione, una colonna per mossa) e la corregge giocando: nuovo voto uguale vecchio voto più un po’ della sorpresa. Impara quali sarebbero le mosse migliori anche mentre si muove a casaccio per esplorare, cioè impara una cosa mentre ne fa un’altra.
Nella correzione ci sono due manopole: una decide quanto dare retta alla sorpresa dell’ultimo passo (piccola vuol dire passi cauti), l’altra quanto pesa il futuro rispetto al premio immediato. E c’è la ricetta \(\varepsilon\)-greedy per il dilemma del ristorante: quasi sempre la mossa col voto più alto, ogni tanto una a caso per scoprire di meglio. Quanto in fretta si riduce quell”«ogni tanto» decide il resto: se cala troppo, le novità finiscono, e con loro la promessa che i voti si assestino al posto giusto.
Prendere sempre il voto più alto gonfia le stime, perché fra quattro numeri che ballano il massimo è quello che ha sbagliato dalla parte generosa. La contromisura sono due tabelle, una che sceglie la mossa e una che le dà il voto.
SARSA valuta le mosse mettendo in conto che ogni tanto esplorerà davvero e sbaglierà: sul bordo del burrone si tiene a distanza di sicurezza, mentre il Q-learning cammina sull’orlo perché in teoria non cadrebbe mai. Tolto il dado, la differenza sparisce, e la prudenza di SARSA diventa strada in più.
Guardare avanti un passo solo o fino alla fine della partita sono i due estremi di una famiglia: una manciata di passi in genere batte entrambi, e si può anche fare la media di tutte le lunghezze, con più peso alle corte. Quella media si tiene aggiornata mentre si gioca ricordando le situazioni appena attraversate, con un ricordo che sfuma a ogni passo: così una ricompensa a sorpresa corregge in un colpo tutta la scia alle spalle, le più recenti di più.
Tutto questo funziona finché le situazioni si possono elencare una per una. Per dodici caselle la tabella si scrive; per un videogioco in cui quasi ogni schermata è nuova, no, e nemmeno basterebbero le partite per riempirla. Al suo posto serve qualcosa che sappia indovinare il voto di una situazione mai vista somigliandola a quelle già viste: sono le reti neurali del Deep Reinforcement Learning.
Da ricordare
Il temporal-difference aggiorna le stime a ogni passo usando la stima successiva (bootstrapping), senza attendere la fine dell’episodio.
Il Q-learning impara una tabella \(Q(s,a)\) ed è off-policy: il suo target usa \(\max_{a'} Q(s',a')\), quindi apprende la politica ottima anche mentre esplora. È la value iteration con l’attesa sostituita da un campione, e la convergenza di Watkins e Dayan vale per MDP finiti, \(Q\) tabellare, ricompense limitate, sconto \(\gamma < 1\), visite infinite e passi che soddisfano Robbins-Monro sui passaggi di ciascuna coppia.
Nella formula, \(\alpha\) dosa la correzione e \(\gamma\) pesa il futuro; la strategia \(\varepsilon\)-greedy bilancia esplorazione e sfruttamento. Delle due metà di GLIE (visite infinite, e policy greedy nel limite) al Q-learning, che è off-policy, serve solo la prima; al SARSA servono tutte e due, perché con \(\varepsilon\) fisso si posa sul valore della politica \(\varepsilon\)-greedy invece che su quello ottimo.
SARSA è la variante on-policy (\(\gamma\,Q(s',a')\) al posto del massimo): più prudente, valuta la politica che segue davvero; Expected SARSA ne prende l’attesa sotto \(\pi\), e con \(\pi\) greedy ridà il Q-learning. Il \(\max\) del Q-learning porta invece con sé il bias di massimizzazione, che il Double Q-learning attenua.
TD e Monte Carlo sono i due estremi di un continuo: il ritorno a \(n\) passi sta in mezzo, e il \(\lambda\)-return li media tutti (vista in avanti). Le tracce di eleggibilità sono la vista all’indietro, che distribuisce un solo errore TD su tutta la scia degli stati appena visitati: equivalente esatta a pesi fermi per l’episodio, approssimazione quando i pesi si muovono a ogni passo.
Tutto l’impianto presuppone \(\mathcal{S}\) finito, e abbastanza piccolo da stare in memoria. Cade due volte, per memoria (una casella per coppia stato-azione) e per dati (quasi ogni stato incontrato è nuovo, e la sua riga è vuota): la via d’uscita non è un algoritmo diverso ma una rappresentazione diversa, e con essa se ne va la garanzia di convergenza.
Di tutto l’impianto, a rompersi appena il mondo diventa grande è la tabella. Tutto il resto regge: correggere una stima con la stima successiva, dosare quella correzione, decidere quanto pesa il futuro, tentare ogni tanto una strada nuova per non affezionarsi alla prima trovata. In Deep Reinforcement Learning la tabella lascia il posto a una rete, che le situazioni non le elenca ma le riconosce; e insieme alla tabella se ne va la certezza che i voti finiscano al posto giusto.