


Imparare dal suono senza etichette#
Chi trascrive migliaia di ore di audio? Qualcuno deve farlo: per insegnare a una macchina a riconoscere il parlato servono coppie (audio, testo), e quel testo lo scrive una persona, ascoltando e battendo a tastiera. È lento, costa, e per molte lingue del mondo semplicemente non esiste. Di audio non etichettato, invece, ce n’è moltissimo: podcast, audiolibri, video, archivi radiofonici, registrazioni di ogni tipo; montagne di suono che nessuno ha mai trascritto.
C’è uno spreco evidente in tutto questo, e una domanda che se ne ricava: e se la macchina imparasse la struttura del suono da sola, ascoltando quelle montagne di audio grezzo, e usassimo poi ciò che ha imparato per i compiti veri (riconoscere il parlato, classificare suoni, generare musica) con poche etichette? È l’idea dell’apprendimento auto-supervisionato (self-supervised).
Una parola regge tutto quello che segue: rappresentazione. È il vettore \(\mathbf{c}_t\) con cui un modello si tiene in mente un pezzetto di suono, un gruppetto di qualche centinaio di numeri ogni venti millesimi di secondo, cioè cinquanta vettori per ogni secondo di audio. Quei numeri li produce l’addestramento: nessuno li ha scritti a mano, e nessuno saprebbe leggerli uno per uno.
Quando è che una rappresentazione è migliore di un’altra? Ogni vettore è un punto in uno spazio da qualche centinaio di dimensioni (una per numero), e una buona rappresentazione mette vicini i frammenti che si somigliano davvero e lontani quelli diversi: le «s» in una regione, le «a» in un’altra, i colpi di tamburo altrove. Il criterio pratico è il sondaggio lineare di Imparare a vedere senza etichette, trasportato sul suono. La rappresentazione si congela, cioè non la si ritocca più, e sopra le si addestra un classificatore lineare, che separa le classi con un taglio dritto: se le classi che interessano («che vocale è?», «che strumento sta suonando?») si separano così, la rappresentazione le contiene già in forma pronta. Anche lo spettrogramma (e con lui la scala mel e gli MFCC) della sezione Dal suono alle feature era una rappresentazione, ma l’avevamo disegnata noi; qui il modello se la costruisce da sé.
Nel testo scritto lo stesso passaggio è già avvenuto, ed è il precedente da cui questa storia nasce. Prima ogni parola aveva il suo vettore fisso, identico in qualunque frase (sono i word embedding, word2vec e simili, visti in Rappresentare il testo); poi si è passati a numeri che cambiano con la frase intorno, così che la «pesca» del contadino e la «pesca» del pescatore smettano di essere la stessa cosa, ed è il salto dei grandi modelli pre-addestrati come BERT. Nell’audio lo stesso passaggio è arrivato fra il 2018 e il 2020: la Contrastive Predictive Coding [vdOLV18] ha dato la perdita, wav2vec [SBCA19] l’ha applicata al parlato, e wav2vec 2.0 ha aggiunto il mascheramento e le unità discrete. È la storia che segue.
Il problema delle etichette#
Il problema è di conti, e si fa in fretta. Un’ora di parlato richiede a un trascrittore diverse ore di lavoro; le ore di parlato che servirebbero sono migliaia; e per una lingua parlata da poche persone quel lavoro non lo ha fatto mai nessuno e non lo farà. Le etichette, cioè le risposte giuste scritte da un umano accanto a ogni esempio, sono il fattore che limita tutto il resto.
La via d’uscita è spezzare l’apprendimento in due tempi. Prima il pre-addestramento, una lunga fase su una massa enorme di audio senza risposte, con un obiettivo costruito dai dati stessi; poi il fine-tuning, una breve rifinitura sul compito vero con le poche etichette che si hanno. È la stessa procedura dei modelli linguistici del capitolo sui Transformer, e del transfer learning della visione artificiale. La prima fase è quella costosa (la versione grande di wav2vec 2.0, il modello che segue, ha occupato 128 GPU per più di due giorni, e per più di cinque sull’archivio di audio più grande [BZMA20]), e il suo risultato si riusa per un compito dopo l’altro.
Un bambino impara i suoni della sua lingua molto prima che qualcuno gli insegni a scrivere. A furia di ascoltare, si accorge da solo che certi suoni tornano, che alcune combinazioni sono possibili e altre no, che «pa» e «ba» sono cose diverse, e tutto questo senza che nessuno gli abbia mai mostrato come si scrivono. Quando poi va a scuola e impara l’alfabeto, parte avvantaggiato: l’orecchio ha già fatto metà del lavoro.
L’auto-supervisione fa esattamente questo con una macchina. Prima le facciamo ascoltare montagne di audio senza dirle mai «qui c’è scritto così»: impara da sola la struttura del suono. Solo dopo le mostriamo poche ore di audio trascritto, per collegare quella struttura alle parole. Il guadagno è concreto: le etichette costose servono in quantità molto minore, perché il grosso (com’è fatto il parlato) è già stato imparato gratis.
Formalmente disponiamo di un grande insieme di audio non etichettato \(\mathcal{D}_U\) (decine di migliaia di ore) e di un piccolo insieme etichettato \(\mathcal{D}_L = \{(\mathbf{x}^{(i)}, \mathbf{y}^{(i)})\}\), con \(|\mathcal{D}_L| \ll |\mathcal{D}_U|\) (il simbolo \(\mathcal{L}\) resta riservato alle funzioni di perdita). Il pretraining ottimizza su \(\mathcal{D}_U\) un obiettivo che non richiede \(\mathbf{y}\), un pretesto (pretext task) costruito dai dati stessi, per apprendere un encoder \(F_\theta\) che mappa la forma d’onda in rappresentazioni contestuali (maiuscolo perché più avanti \(f\) sarà il solo stadio convoluzionale, e qui si intende tutta la catena). Il fine-tuning aggiunge sopra \(F_\theta\) una testa leggera (per il riconoscimento vocale, tipicamente uno strato con perdita CTC, che la sezione sui modelli di riconoscimento costruisce da capo) e la addestra su \(\mathcal{D}_L\): in wav2vec 2.0 e in HuBERT, i due modelli che seguono, lo stadio convoluzionale resta congelato e il Transformer si sblocca dopo un certo numero di passi.
Il punto empirico che rende il tutto interessante è la curva di efficienza dei dati: partendo da un encoder pre-addestrato, l’errore di trascrizione a valle crolla con pochissime etichette, là dove un modello addestrato da zero avrebbe bisogno di ordini di grandezza in più. È la stessa promessa del transfer learning nella visione, trasferita al dominio del suono.
Il sondaggio lineare ha però un’ipotesi taciuta: quale strato si sonda. \(F_\theta\) è una pila di strati, e ciascuno dà una rappresentazione diversa. In wav2vec 2.0 gli ultimi strati tornano a somigliare all’ingresso, perché l’obiettivo di pre-addestramento chiede di riconoscere il segnale coperto, mentre l’informazione fonetica e lessicale si concentra negli strati intermedi [PCL21]. Per questo la valutazione standard, SUPERB [YCC+21], tiene congelato l’encoder e addestra, insieme alla testa del compito, una somma pesata delle uscite di tutti gli strati: la rappresentazione «giusta» la sceglie il compito.
wav2vec 2.0: mascherare il suono#
Il modello che rende questa idea pienamente convincente per il parlato è wav2vec 2.0, di Alexei Baevski e colleghi a Facebook AI (il laboratorio che oggi si chiama Meta AI) nel 2020 [BZMA20]. La ricetta ricalca il «gioco della parola coperta» che nel testo ha reso grande BERT (il cloze test, riempire il buco in una frase) ma applicato a pezzetti di suono invece che a parole (Fig. 23.5).
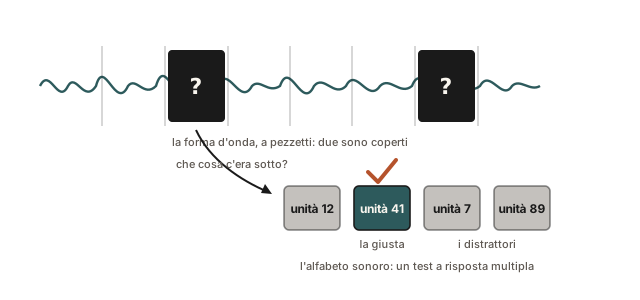
Fig. 23.5 Il gioco della parte coperta: sotto la mascherina c’è una delle unità dell’alfabeto sonoro, e il modello deve riconoscere quale, fra la giusta e i distrattori.#
Torna il gioco della frase da completare. Se copro una parola in «Il gatto nero salta sul ___», tu indovini «muro» perché conosci come funziona la lingua. wav2vec 2.0 gioca lo stesso gioco con il suono: prende un pezzo di audio, ne copre dei pezzetti, e chiede al modello di indovinare che cosa c’era sotto.
Ma con un aiuto, perché inventare il suono esatto da zero sarebbe un’impresa disperata. Il modello ha davanti un elenco di pezzetti-tipo, una specie di alfabeto sonoro: ognuno si chiama unità. Le lettere di questo alfabeto sono molto più fini di quelle di una lingua: ognuna copre due centesimi di secondo, meno di quanto duri una vocale pronunciata per intero, quindi per dire una «a» ce ne vogliono parecchie di fila. L’elenco se lo costruisce lui stesso, ed è la parte che stona: come fa a scriverlo, se non sa ancora niente del suono? Lo scrive male, all’inizio, e lo riscrive man mano che impara, come chi ascolta una lingua straniera e all’inizio non sa quali suoni facciano differenza: lo scopre ascoltando, e intanto continua ad ascoltare con l’orecchio che ha. Sotto la parte coperta c’è una di quelle unità, e il gioco è indovinare quale: gli si mette davanti quella giusta insieme a un centinaio di unità sbagliate (i «distrattori») e deve solo riconoscerla. È un test a risposta multipla, e per rispondere bene l’orecchio è costretto a capire come è fatto il parlato.
Una regola tiene in piedi il gioco: le lettere di quell’alfabeto vanno usate tutte. Se il modello se la cavasse con tre lettere, appiccicate a qualunque suono, la risposta giusta e le risposte sbagliate del test sarebbero quasi sempre la stessa lettera, e da un test con le risposte tutte uguali non si impara niente.
Dopo aver ascoltato in questo modo decine di migliaia di ore di audio senza etichette, a wav2vec 2.0 bastano appena dieci minuti di parlato trascritto per imparare a riconoscere la voce con una qualità che, solo pochi anni prima, richiedeva centinaia di ore.
Quel numero però viene raccontato a metà. Il modello che ha imparato ad ascoltare non ci arriva da solo: accanto a lui lavora un secondo modello, che non ascolta niente, sa soltanto com’è fatta la lingua e scarta le parole improbabili. Il risultato è della coppia. Ascoltare montagne di audio risolve il problema di quante trascrizioni servono; non insegna l’italiano.
L’architettura ha tre stadi. Un encoder convoluzionale \(f\) trasforma la forma d’onda grezza \(\mathbf{x}\) in una sequenza di vettori latenti \(\mathbf{Z} = (\mathbf{z}_1, \dots, \mathbf{z}_T)\), uno ogni ~20 ms. Un Transformer \(g\) legge \(\mathbf{Z}\) (con alcuni tratti mascherati) e produce rappresentazioni contestuali \(\mathbf{C} = (\mathbf{c}_1, \dots, \mathbf{c}_T)\), in cui ogni \(\mathbf{c}_t\) tiene conto dell’intera frase. In parallelo, un modulo di quantizzazione sostituisce ogni \(\mathbf{z}_t\) con una voce di un dizionario appreso (in gergo, product quantization: due codebook da 320 voci ciascuno, e le due voci scelte si concatenano). Piccoli sono i due codebook, non l’alfabeto che ne esce: le combinazioni possibili sono \(320^2 = 102\,400\). La concatenazione passa poi per una trasformazione lineare, che è il passaggio che la porta nello stesso spazio di \(\mathbf{c}_t\) e senza il quale il confronto fra i due non si potrebbe nemmeno fare; il risultato è il bersaglio discreto \(\mathbf{q}_t\), cioè il modo di darsi un «alfabeto» finito di unità di suono senza definirlo a mano. Le sue voci sono più corte dei fonemi: ce n’è una ogni 20 ms.
Attenzione a come avviene la scelta, perché non è quella dei codec neurali, dove si cerca la voce più vicina in distanza. \(\mathbf{z}_t\) viene proiettato su una griglia di \(G \times V\) logit (con \(G = 2\) gruppi e \(V = 320\) voci per gruppo) e l’indice è l’\(\arg\max\) della Gumbel-softmax di quei logit, cioè della softmax dei logit perturbati con rumore di Gumbel e temperatura \(\tau\). A rendere stocastica la scelta è il rumore, non la temperatura: dividere per \(\tau > 0\) è una riscalatura monotòna e l’\(\arg\max\) non se ne accorge. \(\tau\) agisce all’indietro, sul gradiente, ed è per questo che il paper la fa scendere lungo l’addestramento: da 2 a 0,5 nella versione base, e fino a 0,1 in quella grande, a cui si riferiscono i risultati discussi in seguito. Il termine di diversità, che spinge il modello a usare tutte le voci dei codebook, invece non la vede: gli autori lo scrivono sulla softmax nuda dei logit, dichiarando che lì dentro non c’è né il rumore di Gumbel né la temperatura. In formula, con \(l_{g,v}\) i logit del gruppo \(g\) e \(n_v = -\log(-\log u_v)\), \(u_v \sim \mathcal{U}(0,1)\), la probabilità morbida è
In avanti si usa la voce \(\arg\max_v p_{g,v}\), cioè un vettore one-hot; all’indietro si propaga il gradiente delle \(p_{g,v}\) morbide, come se il one-hot fosse la \(p_{g,v}\) stessa. È lo straight-through, che rende derivabile una scelta discreta, ed è qui che \(\tau\) conta: più è bassa, più le \(p_{g,v}\) morbide somigliano al one-hot che sostituiscono.
L’obiettivo è contrastivo. Per ogni passo mascherato \(t\), dato il vettore contestuale \(\mathbf{c}_t\), il modello deve riconoscere la vera unità quantizzata \(\mathbf{q}_t\) in mezzo a un insieme \(\mathcal{Q}_t\) formato da \(\mathbf{q}_t\) e da \(K\) distrattori (nel paper, \(K = 100\); è la \(K\) del contrastivo, e non ha niente a che vedere con le \(K\) voci del codebook della sezione sui codec) pescati da altri passi mascherati:
È la perdita InfoNCE [vdOLV18], la stessa dell’apprendimento contrastivo sulle immagini in Imparare a vedere senza etichette e della coppia immagine-testo in Un solo spazio per le immagini e le parole, con l’audio al posto delle une e dell’altra. Qui \(\mathrm{sim}(\mathbf{a},\mathbf{b})\) è la similarità del coseno (già usata per gli embedding) e \(\mathcal{Q}_t\) l’insieme dei candidati; \(\kappa\) è la temperatura del contrastivo, e il nome è quello del paper, che aveva già riservato \(\tau\) per la Gumbel-softmax. Altrove la stessa temperatura si indica spesso con \(\tau\), creando possibile confusione. La perdita è il meno logaritmo di una softmax, e scende quando il modello assegna a \(\mathbf{q}_t\) la probabilità più alta. Il nome viene dall’informazione mutua: con \(N = K + 1\) candidati vale \(I(\mathbf{c}_t; \mathbf{q}_t) \ge \log N - \mathcal{L}_m\) [vdOLV18], quindi minimizzare \(\mathcal{L}_m\) alza un limite inferiore dell’informazione che il contesto porta sull’unità coperta. Il limite però non supera \(\log N\), cioè \(\log 101 \approx 4{,}6\) nat con \(K = 100\): più distrattori lo alzano, al prezzo di più calcolo. Accanto le sta il termine di diversità, e la ragione la dà il paper: se il dizionario collassa su poche voci, il bersaglio e i distrattori diventano la stessa cosa e il compito degenera. La perdita completa è
dove \(\bar{\mathbf{p}}_g\) è la softmax dei logit del gruppo \(g\) mediata sui frame del batch, \(H\) l’entropia e \(\alpha = 0{,}1\): minimizzare \(\mathcal{L}_d\) vuol dire massimizzare l’entropia dell’uso medio, che tocca il massimo \(\log V\) quando le \(V\) voci sono scelte con la stessa frequenza. La misura è di batch: al singolo frame si chiede una scelta netta, al batch di spenderle tutte. Il mascheramento ha due numeri soli: si estrae come inizio di un tratto il \(6{,}5\%\) dei passi, e da ciascuno si coprono i dieci successivi, con sovrapposizioni ammesse, sicché resta coperto circa il \(49\%\) dei passi, in tratti lunghi in media \(299\) ms. A valle, con una testa CTC su pochissime etichette, la versione grande di wav2vec 2.0 raggiunge un tasso di errore sulle parole (in sigla WER, word error rate: la quota di parole da correggere, metrica che il capitolo sullo Speech Recognition spiegherà da capo) di \(4{,}8/8{,}2\) usando 10 minuti di parlato trascritto e 53.000 ore non etichettate, che vengono da un corpus di audiolibri più grande di quello di prova [BZMA20]. I due numeri sono le due prove d’esame di Librispeech, test-clean e test-other: la seconda è quella difficile, con registrazioni e accenti più ostici, e infatti l’errore è quasi sempre più alto.
Quel numero però va letto per intero, ed è la cifra più citata del paper: lo stesso abstract la dà senza dire che è ottenuta decodificando con un modello di lingua Transformer. Il solo modello acustico, nella stessa configurazione, sta a \(40{,}2/38{,}7\) (la tabella in appendice del paper isola il contributo della decodifica: a questo livello di errore le due misure si scambiano, segno dell’inadeguatezza del modello acustico preso da solo); con un modello di lingua a 4-grammi si passa a \(6{,}6/10{,}3\), e solo con quello Transformer si arriva a \(4{,}8/8{,}2\). Fra il primo e l’ultimo l’errore si divide per otto sul test pulito e per quasi cinque su quello difficile. Il pre-addestramento risolve il problema delle etichette acustiche, non sostituisce il modello di lingua: è una distinzione che il capitolo sullo Speech Recognition riprenderà pari pari, quando metterà in fila i pezzi di una pipeline di riconoscimento.
Il cuore del compito si vede in poche righe di NumPy, e la domanda a cui risponde è semplice: il modello punta sull’unità giusta o su uno dei distrattori? Ogni candidato è un vettore. Per misurare quanto somiglia a ciò che il modello si è fatto in mente del pezzetto coperto, il vettore contestuale \(\mathbf{c}\), si usa la similarità del coseno di Rappresentare il testo, la stessa che là confrontava due parole: 1 quando i due vettori puntano nella stessa direzione, 0 quando sono perpendicolari, \(-1\) quando puntano in versi opposti. I cinque punteggi, divisi per la temperatura \(\kappa\), passano poi per una softmax, che li riscala in modo che sommino a uno: si leggono come la fiducia che il modello mette su ciascun candidato, e il meno logaritmo di quella del candidato giusto è la perdita \(\mathcal{L}_m\), calcolata per un passo solo.
import numpy as np

rng = np.random.default_rng(0)
d = 8  # quante componenti ha ogni vettore (nei modelli veri sono centinaia)

# c: quello che il modello si e' fatto in mente del pezzetto COPERTO.
# In un modello ben addestrato e' vicino all'unita' giusta e lontano dai
# distrattori.
c = rng.standard_normal(d)

# q_true: l'unita' corretta (qui una versione "vicina" a c); i distrattori
# sono unita' pescate da altri pezzetti coperti della stessa frase.
q_true = c + 0.3 * rng.standard_normal(d)
q_dist = rng.standard_normal((4, d))
candidati = np.vstack([q_true, q_dist])      # (5, d): il vero piu' 4 distrattori

def coseno(a, B):                            # coseno tra a e ogni riga di B
    a = a / np.linalg.norm(a)
    B = B / np.linalg.norm(B, axis=1, keepdims=True)
    return B @ a

kappa = 0.1                                  # "temperatura": piu' e' bassa,
                                             # piu' la scelta esce netta
punteggi = coseno(c, candidati) / kappa
prob = np.exp(punteggi - punteggi.max())
prob /= prob.sum()                           # softmax: i punteggi riscalati
                                             # cosi' che sommino a uno
L_m = -np.log(prob[0])                       # la perdita contrastiva

print("prob. per candidato:", prob.round(3))
print("scelto:", int(prob.argmax()), "(0 = unita' giusta)")
print("perdita L_m:", round(float(L_m), 3))
prob. per candidato: [0.672 0.    0.    0.271 0.056]
scelto: 0 (0 = unita' giusta)
perdita L_m: 0.398
L’unità giusta vince, ma il margine merita uno sguardo: si prende due terzi della probabilità, e un distrattore pescato a caso se ne prende un quarto. La perdita vale \(0{,}398\), contro il \(\log 5 \approx 1{,}609\) di un modello che puntasse a caso su cinque candidati. Il margine stretto ha una causa precisa: i vettori, qui, hanno soltanto otto componenti.
Portati due vettori a lunghezza uno, il loro coseno è la somma dei prodotti fra componenti corrispondenti. Se i vettori sono pescati a caso, quei prodotti sono positivi e negativi a caso e si compensano, tanto meglio quanti più sono: con \(d\) componenti il coseno di due vettori indipendenti ha media zero e uno scarto tipico di \(1/\sqrt{d}\). Lo si vede pescandone diecimila coppie:
# continua dal blocco precedente: quanto si somigliano due vettori a caso
for dim in (8, 500):
    A = rng.standard_normal((10_000, dim))
    B = rng.standard_normal((10_000, dim))
    cos = (A * B).sum(axis=1) / (np.linalg.norm(A, axis=1)
                                 * np.linalg.norm(B, axis=1))
    print(f"d = {dim:>3}: coseno medio {cos.mean():+.3f}, "
          f"scarto tipico {cos.std():.3f}, 1/sqrt(d) {1 / np.sqrt(dim):.3f}")
d =   8: coseno medio -0.002, scarto tipico 0.354, 1/sqrt(d) 0.354
d = 500: coseno medio +0.001, scarto tipico 0.045, 1/sqrt(d) 0.045
Con otto componenti il coseno di due vettori a caso si allontana da zero di circa \(0{,}35\), in più o in meno, ed è il motivo per cui un distrattore preso a caso può finire quasi addosso al bersaglio; con cinquecento lo scarto scende a \(0{,}045\), e un distrattore qualunque si scarterebbe senza fatica. Il compito vero resta difficile per un’altra ragione: i distrattori sono unità pescate da altri punti coperti della stessa frase, quindi suoni imparentati con quello da indovinare, e sono cento, non quattro.
HuBERT: darsi le etichette da soli#
Il gioco di wav2vec 2.0 funziona, ma poggia su una cosa delicata: l’elenco di pezzetti-tipo fra cui il modello deve riconoscere quello giusto lo produce un quantizzatore che si addestra insieme al resto. Se quell’elenco, il codebook, si riduce a poche voci, bersaglio e distrattori coincidono e il compito diventa banale; una penalità apposta, il termine di diversità, lo impedisce, ma è un equilibrio da tenere mentre l’elenco si muove. Nel 2021 Wei-Ning Hsu e colleghi, sempre a Facebook AI, propongono con HuBERT (Hidden-Unit BERT) [HBT+21] di fissare i bersagli prima dell’addestramento, come aveva già fatto DiscreteBERT con le unità di un quantizzatore pre-addestrato [BM20], e di cambiarne la fonte: il modello si dà da sé delle pseudo-etichette, raggruppando le feature dell’audio, e impara a predirle sui tratti coperti, come BERT predice la parola mascherata. Il giro completo, con i numeri delle due passate, è in Fig. 23.6.
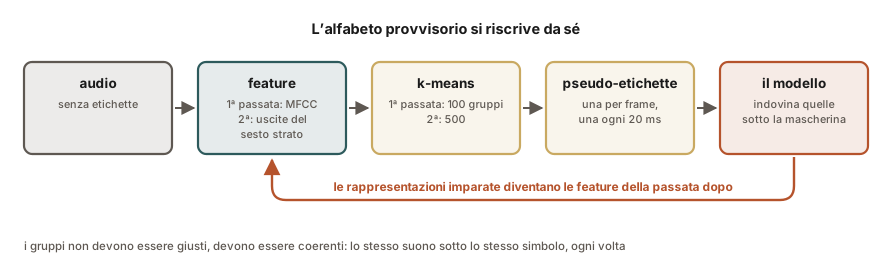
Fig. 23.6 L’anello che si morde la coda, e che proprio per questo funziona. La prima volta i gruppi si fanno su misure grezze del suono e vengono come vengono; addestrato su quelle etichette, il modello si costruisce rappresentazioni migliori, e su quelle i gruppi si rifanno più fini. Il cerchio si percorre due volte.#
Come si scrive una lingua che non ha alfabeto? Te ne inventi uno provvisorio: raggruppi i suoni che ti sembrano simili e dai a ogni gruppo un simbolo («suono numero 1», «suono numero 2»), etichette rozze, inventate da te. Poi giochi al solito gioco della parola coperta: nascondi dei tratti di audio e ti alleni a indovinare quale simbolo c’era sotto. Il bello arriva dopo: quando ti sei fatto l’orecchio, i tuoi raggruppamenti diventano più sensati di quelli di partenza, e allora rifai l’alfabeto con quelli e ricominci. Un ciclo che si affina da solo, come uno schizzo ripassato più volte a matita finché il disegno emerge.
Non serve che l’alfabeto sia giusto: serve che sia coerente, cioè che dia lo stesso simbolo a suoni davvero simili. Se la stessa «sss» finisse ora sotto un simbolo ora sotto un altro, a caso, ti alleneresti a indovinare l’imprevedibile e non ne verrebbe fuori niente. Quando invece i gruppi tengono, azzeccare il simbolo coperto costringe a capire come è fatto il suono, anche se quei nomi te li sei inventati tu.
HuBERT alterna due passi. Passo di clustering (offline): si estraggono feature dall’audio e le si raggruppa con un semplice k-means, ottenendo per ogni frame (una posizione della finestra che scorre sul segnale) un’etichetta discreta \(u_t \in \{1, \dots, C\}\), l’«unità nascosta», dove \(C\) è il numero di cluster ed è l’intero inventario discreto. Questa lettera viene dal paper e tiene distinto il conto dalla \(V\) di wav2vec 2.0, che indica le voci di uno solo dei codebook (lì l’inventario totale è il prodotto dei due, con oltre centomila combinazioni, mentre qui corrisponde al solo \(C\)). Inoltre \(u_t\) è un indice intero di gruppo, a differenza del vettore reale \(\mathbf{z}_t\) di wav2vec 2.0 che rappresenta l’uscita dell’encoder, cioè l’ingresso della quantizzazione e non il bersaglio. Il bersaglio di wav2vec 2.0 è \(\mathbf{q}_t\), anch’esso discreto: la differenza fra i due metodi sta in chi lo fissa e quando, un quantizzatore addestrato insieme al modello là, un k-means rifatto fuori linea qui. Nella prima iterazione le feature sono 39 coefficienti per frame, i 13 MFCC con le loro derivate prime e seconde, raggruppati in cento cluster; nella seconda, le uscite del sesto strato del Transformer della prima iterazione, raggruppate in cinquecento. Le versioni LARGE e X-LARGE non ripartono da zero: si raggruppano le uscite del nono strato del BASE di seconda iterazione, e sono quindi, a tutti gli effetti, una terza iterazione. Passo di predizione mascherata: si sceglie come inizio di un tratto l’8 % dei frame e se ne coprono i dieci successivi (la stessa ricetta di wav2vec 2.0, con un’altra proporzione); sull’insieme \(M\) dei frame mascherati si addestra il modello, alla BERT, a predire le pseudo-etichette:
dove \(\tilde{\mathbf{X}}\) è la sequenza di frame con i tratti mascherati, \(u_t\) l’unità nascosta assegnata dal k-means al frame \(t\) e \(p_\theta\) la distribuzione, prodotta dal modello, sulle \(C\) unità del dizionario. La somma sui soli frame mascherati è la mossa principale del lavoro, non una semplificazione di comodo: la forma generale pesa anche i frame scoperti, e gli autori misurano che prendere solo i mascherati è ciò che fa funzionare il metodo. Come obiettivo è una normale cross-entropia su un problema di classificazione, senza distrattori né contrastivo; il coseno e la temperatura, però, ci sono anche qui, perché \(p_\theta\) confronta l’uscita del modello con vettori appresi, uno per unità.
Perché funziona pur partendo da etichette rozze? Perché ciò che conta non è la correttezza del clustering ma la sua coerenza: se il k-means assegna lo stesso simbolo a frame acusticamente simili, predire quel simbolo forza il modello a modellare la struttura del segnale. E l’iterazione chiude il cerchio: rappresentazioni migliori \(\to\) cluster migliori \(\to\) bersagli migliori. A parità di condizioni HuBERT sta appaiato a wav2vec 2.0 nei regimi a basse risorse su Librispeech: a dieci minuti di etichette fa \(4{,}7/7{,}6\) contro \(4{,}8/8{,}2\), cioè un decimo di punto sul pulito e sei decimi sul difficile, e a cento ore gli autori dichiarano da sé due casi in cui resta indietro di un decimo. I miglioramenti decisivi emergono con il modello da un miliardo di parametri, grazie alla scala molto maggiore [HBT+21].
I due si somigliano più di quanto sembri. Dentro sono fatti allo stesso modo, e il motore è identico: coprire dei pezzi di audio e costringere il modello a tirare fuori quello che c’era sotto. Cambia il bersaglio, cioè che cosa esattamente gli si chiede di indovinare. Uno gli fa riconoscere l’unità giusta in mezzo a dei distrattori, come in un test a crocette; l’altro gli chiede di dire il nome del gruppo, e i nomi possibili sono quelli dell’alfabeto provvisorio.
E cambia anche quando il bersaglio viene deciso. wav2vec 2.0 se lo costruisce mentre impara, con lo stesso addestramento che poi lo deve indovinare: l’elenco si muove sotto i piedi del gioco. HuBERT invece se lo prepara a parte, prima di cominciare, e lo rifà solo ogni tanto: mentre si gioca, l’elenco sta fermo.
A cosa servono#
Queste rappresentazioni sono il punto di partenza di molti sistemi di riconoscimento vocale, in sigla ASR, dall’inglese automatic speech recognition, il mestiere a cui il capitolo sullo Speech Recognition è dedicato per intero. Servono soprattutto dove le trascrizioni scarseggiano: una lingua parlata da poche persone, un dialetto, un ambito specialistico di cui nessuno ha mai raccolto registrazioni annotate. Si parte da un encoder che ha ascoltato decine di migliaia di ore senza etichette e gli si mostrano le poche ore trascritte che esistono: con un’ora sola di trascrizioni wav2vec 2.0 supera il miglior risultato ottenuto fino ad allora con cento ore, e con dieci minuti, più un modello di lingua, arriva al \(4{,}8\%\) di parole sbagliate sul test pulito [BZMA20]. La parte che nel capitolo sullo Speech Recognition trasformerà le rappresentazioni in parole non fa che rifinire ciò che il pre-addestramento ha già preparato.
Gli stessi encoder, con una testa leggera sopra, servono anche a identificare chi parla, a riconoscere un’emozione o l’intenzione di una richiesta: sono alcuni dei compiti su cui li mette alla prova SUPERB [YCC+21]. Per i suoni del mondo, però, non bastano. wav2vec 2.0 e HuBERT hanno ascoltato audiolibri, e il loro alfabeto è fatto per il parlato: gli autori di BEATs scrivono che un tokenizzatore pensato per estrarre fonemi dalla voce non si applica così com’è all’audio generale, pieno di eventi e di suoni d’ambiente [CWW+23].
Due seguiti di HuBERT mostrano dove la ricetta si allarga. WavLM [CWC+22] tiene lo stesso tipo di bersaglio, ma all’ingresso sovrappone all’enunciato un rumore o un secondo enunciato e chiede di predire le unità di quello principale, così che il modello impari a distinguere chi parla da ciò che gli sta intorno; addestrato su 94.000 ore, alla sua pubblicazione ha dato i risultati migliori su SUPERB. BEATs porta lo schema all’audio generale. Copre tre tessere dello spettrogramma su quattro, e il bersaglio non viene da un k-means sugli MFCC ma da un tokenizzatore acustico che si addestra a sua volta, per distillazione dal modello dell’iterazione precedente. Su AudioSet arriva a una mAP di \(0{,}486\) con un modello solo (2023), sopra lo \(0{,}459\) dell’AST di Riconoscere i suoni; quel numero però usa, nell’ultima iterazione, un tokenizzatore distillato da un modello già rifinito con le etichette di AudioSet, e senza etichette in nessun punto della catena BEATs si ferma a \(0{,}480\).
Le unità discrete imparate così fanno da punto di partenza anche per la generazione: AudioLM, nella sezione Generare suono e musica, ne usa una variante per tenere la struttura di una frase o di un brano. Sono però unità fatte per capire: da una di esse non si risale al suono, e l’alfabeto con cui il suono si rifà è un altro, quello dei codec neurali.
Queste rappresentazioni codificano soprattutto il contenuto acustico e fonetico del segnale: quali suoni ci sono, in che ordine, con che timbro. È ciò che il gioco della parte coperta premia, perché indovinare un’unità coperta non chiede di capire che cosa la frase voglia dire. Il significato non ne resta escluso del tutto: con una testa addestrata sopra, gli stessi encoder riconoscono l’intenzione di una richiesta o i dati da estrarne (sono compiti semantici di SUPERB), e le analisi strato per strato trovano informazione sulle parole negli strati intermedi [PCL21]. Ma è un significato che va estratto con delle etichette, o affidato a un modello di lingua; quello che il pre-addestramento garantisce è l’orecchio. L’ironia di una frase, che dipende dal contesto e da come la si dice, non è detto che stia in una rappresentazione addestrata a indovinare suoni. Il pre-addestramento audio risolve il problema delle etichette, non quello della comprensione, e distinguere le due cose è il primo passo per usarlo bene.
Da ricordare
Trascrivere l’audio costa; di audio non trascritto ce n’è moltissimo. Un modello può imparare da solo com’è fatto il suono (come il bambino che sente la lingua prima di saperla scrivere) e solo dopo imparare il compito vero con poche ore di esempi corretti.
Quello che impara si chiama rappresentazione: il gruppetto di numeri con cui si tiene in mente un pezzetto di suono, fatto in modo che pezzetti simili finiscano vicini.
wav2vec 2.0 gioca al gioco della parola coperta: nasconde dei tratti di audio e chiede di riconoscere quello giusto in mezzo a un centinaio di distrattori, come un test a crocette. Con dieci minuti di parlato trascritto arriva dove prima servivano cento ore, purché ad aiutarlo ci sia anche un modello che sa com’è fatta la lingua.
HuBERT cambia gioco: si inventa un alfabeto provvisorio raggruppando i suoni che si somigliano, poi si allena a indovinare quale simbolo stava sotto la parte coperta, e ogni tanto rifà l’alfabeto meglio di prima. Non serve che sia giusto, serve che sia coerente.
Questi modelli hanno ascoltato voci, e il loro alfabeto è fatto per il parlato: per un cane che abbaia o un vetro che si rompe servono modelli addestrati su ogni genere di suono.
Il gioco della parte coperta premia l’orecchio, non il senso: per capire che cosa vuole dire una frase, o se è ironica, servono altre etichette, o un modello che conosca la lingua.
Da ricordare
Etichettare l’audio è costoso, ma di audio non etichettato ce n’è moltissimo: l’apprendimento auto-supervisionato impara la struttura del suono da solo (pretraining), poi rifinisce sul compito vero con poche etichette (fine-tuning); è lo stesso salto che nel testo va da word2vec a BERT.
wav2vec 2.0 [BZMA20]: encoder convoluzionale + Transformer, i latenti sono quantizzati in unità discrete, e mascherando parti del segnale il modello impara con un obiettivo contrastivo a riconoscere l’unità giusta tra distrattori (il cloze test del suono). La scelta dell’unità passa per una Gumbel-softmax sui logit, non per la distanza dal prototipo più vicino. Con 10 minuti di etichette raggiunge un WER di \(4{,}8/8{,}2\) su Librispeech, ma con un modello di lingua Transformer in decodifica: il solo modello acustico sta intorno al 40 %.
HuBERT [HBT+21]: niente contrastivo, ma pseudo-etichette fissate fuori linea da un k-means (unità nascoste, come in DiscreteBERT) predette sui frame mascherati, con iterazione che raffina i cluster. Conta la coerenza dei bersagli, non la loro correttezza.
Le due condividono l’ossatura e differiscono nel bersaglio: riconoscere (contrastivo) contro predire una classe (masked prediction).
Sono il punto di partenza dell’ASR a basse risorse e, con una testa leggera, dei compiti sul parlante, sull’emozione e sull’intenzione (SUPERB). Per l’audio generale servono modelli addestrati su audio generale: BEATs, con un tokenizzatore acustico appreso, arriva a \(0{,}486\) di mAP su AudioSet (2023), \(0{,}480\) senza etichette in nessun punto della catena.
Codificano soprattutto contenuto acustico e fonetico: il sondaggio lineare dipende dallo strato (SUPERB ne addestra una somma pesata), e i compiti semantici chiedono una testa addestrata o un modello di lingua.
Le unità di wav2vec 2.0 e di HuBERT servono a capire il suono: da un’unità non si risale all’onda, e un alfabeto fatto così non basta a rifarla. La sezione sui codec neurali costruisce un alfabeto pensato per l’opposto, per ricostruire il suono a partire da pochi simboli, ed è con quello che si potrà generarne di nuovo.