


Il kernel trick: separare l’inseparabile#
La SVM del massimo margine traccia frontiere diritte. Se le classi formano un bersaglio, una al centro e l’altra tutt’intorno ad anello, nessuna retta le separa. Si può allora trasformare ogni esempio con una funzione \(\phi\) in uno spazio di dimensione maggiore, dove la frontiera torna dritta; il kernel trick permette di farlo senza mai calcolare \(\phi\), ed è l’idea che ha reso celebri le SVM.
Solleva in aria i punti del bersaglio, e dai a ciascuno un’altezza pari alla sua distanza dal centro moltiplicata per sé stessa: chi dista un passo sale di un gradino, chi ne dista tre sale di nove. I punti del cerchio interno, vicini al centro, restano in basso; quelli dell’anello, lontani, si ritrovano molto più su. Ora le due classi stanno a quote diverse, e una lastra di vetro orizzontale infilata a mezz’aria le divide nettamente. I punti non sono cambiati: li abbiamo guardati in uno spazio con una dimensione in più, e lì il confine torna dritto.
Il guaio è che sollevare i punti costa. Nei casi utili le dimensioni da aggiungere, cioè le coordinate nuove di ogni punto, non sono una ma migliaia, a volte infinite, e nessun calcolatore le regge. Qui sta il trucco. La strada più larga si calcola usando soltanto le ombre a due a due, un numero per ogni coppia di punti, e le coordinate non compaiono in nessun altro posto. Se sappiamo produrre direttamente quei numeri come sarebbero dopo il sollevamento, il sollevamento non serve più farlo.
La regola che li produce si chiama kernel. Si sceglie il kernel, e lo spazio sollevato resta un’idea: non lo si costruisce mai.
Non ogni regola inventata a tavolino, però, è un kernel, e il motivo si vede guardando quei numeri a due a due. Il primo requisito è ovvio: quanto A vede B e quanto B vede A devono essere lo stesso numero. Il secondo lo è meno, e riguarda le terne. Scrivi che A e B si vedono quasi come sé stessi, e così B e C, ma che A e C non si vedono per niente: hai chiesto qualcosa che nessuna disposizione di punti, in nessuno spazio, può realizzare, come pretendere che il bar sia a due passi da casa, casa a due passi dalla scuola, e la scuola a dieci chilometri dal bar. Il fastidio è che nessuno protesta: il calcolatore macina lo stesso e restituisce un confine, che però non è il più largo di niente. Per questo i kernel non si inventano a piacere, e chi ne prova uno nuovo controlla prima che una disposizione capace di produrre quei numeri esista davvero.
L’idea è mappare ogni esempio in uno spazio di dimensione maggiore con una funzione \(\phi\), e cercare l’iperpiano lì. Per il bersaglio basta aggiungere la feature \(r^2 = x_1^2 + x_2^2\):
Nello spazio a tre dimensioni la classe interna (piccolo \(r^2\)) e quella esterna (grande \(r^2\)) sono separate da un piano orizzontale a un’altezza-soglia. Il problema, così com’è, sembra però costoso: se \(\phi\) manda in uno spazio a migliaia di dimensioni, calcolare e conservare tutti quei \(\phi(\mathbf{x}_i)\) diventa proibitivo.
Il kernel trick è l’osservazione che salva tutto, ed è la ragione vera per cui la strada più larga ha percorso il duale passo per passo: là dentro, e nella regola di decisione, gli esempi compaiono solo attraverso prodotti scalari \(\phi(\mathbf{x})^\top\phi(\mathbf{z})\). Se esiste una funzione \(k\) che calcola quel prodotto scalare direttamente dalle coordinate originali,
allora non serve mai costruire \(\phi\): si lavora nello spazio ad alta dimensione senza mai visitarlo. La funzione \(k\) è il kernel [ScholkopfS02]. I più usati:
dove \(d\) è il grado del polinomio, \(c \ge 0\) un termine costante e \(\gamma > 0\) l’iperparametro di ampiezza del kernel gaussiano, che stringe la campana al crescere. La larghezza è la deviazione standard equivalente \(\sigma\), e vale \(\sigma = 1/\sqrt{2\gamma}\), cioè \(\gamma = 1/(2\sigma^2)\): \(\gamma\) va quindi come l’inverso del quadrato della larghezza, e per dimezzare la campana va quadruplicato, non raddoppiato. \(\gamma\) grande, campana stretta. Il kernel RBF corrisponde a uno spazio \(\phi\) di dimensione infinita: sarebbe impossibile da costruire, eppure \(k\) si calcola in una riga.
Un’ultima clausola, quella che fa del trucco un teorema invece che una speranza. La frase «se esiste una funzione \(k\) che calcola quel prodotto scalare» rovescia l’ordine dei fatti: in pratica non si parte da \(\phi\) per cercare \(k\), si sceglie \(k\) e si spera che un \(\phi\) esista. Esiste se e solo se \(k\) è simmetrica e semidefinita positiva, cioè se ogni matrice di Gram \(\mathbf{K}\), quella di elementi \(K_{ij} = k(\mathbf{x}_i, \mathbf{x}_j)\), ha autovalori non negativi. È questa condizione la ragione per cui i kernel non si inventano a piacere: se \(k\) non la rispetta, il duale smette di essere concavo e il solutore risolve un problema diverso da quello che si crede. Non ogni «misura di somiglianza» è un kernel, ed è l’errore più comune di chi prova a scriversene uno. Che la condizione basti lo dice il teorema di Moore e Aronszajn: ogni \(k\) del genere definisce uno spazio di Hilbert di funzioni, lo spazio a nucleo riproducente \(\mathcal{H}_k\), in cui \(\langle k(\cdot,\mathbf{x}),\, k(\cdot,\mathbf{z})\rangle_{\mathcal{H}_k} = k(\mathbf{x},\mathbf{z})\), e basta prendere \(\phi(\mathbf{x}) = k(\cdot,\mathbf{x})\). Il teorema di Mercer, con cui la condizione viene spesso confusa, è il caso di un \(k\) continuo su un dominio compatto, dove \(\phi\) si scrive con autovalori e autofunzioni dell’operatore integrale [ScholkopfS02]. Dallo stesso spazio viene il teorema del rappresentante, di Kimeldorf e Wahba (1971) per la perdita quadratica, esteso poi a perdite qualsiasi (nella forma generale da Schölkopf, Herbrich e Smola [ScholkopfHS01]): il problema \(\min_{f \in \mathcal{H}_k} \sum_{i=1}^{m} \ell\bigl(y_i, f(\mathbf{x}_i)\bigr) + \lambda\lVert f\rVert^2_{\mathcal{H}_k}\) ha un minimo della forma \(f = \sum_i \alpha_i\, k(\cdot, \mathbf{x}_i)\), che estende a ogni perdita il \(\mathbf{w} = \sum_i \alpha_i y_i \mathbf{x}_i\) della strada più larga.
I kernel validi si costruiscono da altri kernel validi: se \(k_1\) e \(k_2\) sono semidefiniti positivi, lo sono anche \(c\,k_1\) con \(c > 0\), \(k_1 + k_2\), \(k_1 k_2\), \(g(\mathbf{x})\,k_1(\mathbf{x},\mathbf{z})\,g(\mathbf{z})\) per qualunque funzione reale \(g\), ed \(\exp(k_1)\) [ScholkopfS02]. Il gaussiano ne è un esempio: \(e^{-\gamma\lVert\mathbf{x}-\mathbf{z}\rVert^2} = e^{-\gamma\lVert\mathbf{x}\rVert^2}\, e^{2\gamma\,\mathbf{x}^\top\mathbf{z}}\, e^{-\gamma\lVert\mathbf{z}\rVert^2}\), l’esponenziale di un kernel lineare fra due fattori \(g\). Quanto risparmi il trucco lo dice il kernel polinomiale: con \(n\) caratteristiche (qui \(n\), perché \(d\) è già il grado), \((\mathbf{x}^\top\mathbf{z} + c)^d\) con \(c > 0\) corrisponde a uno spazio con una coordinata per ogni monomio di grado al più \(d\), cioè \(\binom{n+d}{d}\) coordinate, \(308\,505\) per i \(784\) pixel di un’immagine \(28 \times 28\) con \(d = 2\); e si calcola con \(O(n)\) operazioni.

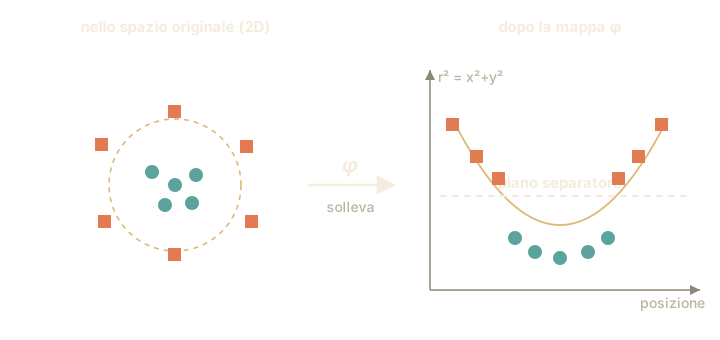
Fig. 4.31 Il kernel trick. A sinistra due classi che nessuna retta separa: un disco al centro e un anello intorno. A destra gli stessi punti dopo il sollevamento, con l’altezza pari alla distanza dal centro elevata al quadrato: i punti del disco restano in basso, quelli dell’anello salgono, e una retta orizzontale basta a dividerli.#
Come illustra Fig. 4.31, ciò che era un anello inseparabile diventa, dopo il sollevamento, un problema lineare banale.
Il nome kernel ha parecchi omonimi, e uno solo è parente: la campana della regressione a nucleo. Anche lì il kernel è una regola che dice quanto due punti si somigliano, e il kernel gaussiano che arriva fra poco è la stessa campana; cambia il mestiere, perché là pesava una media e qui fa da prodotto scalare. Non ha invece niente a che fare con il nucleo di una matrice, con il kernel che tiene lo stato di un notebook, né con i kernel di calcolo che una libreria sceglie per il processore o per la scheda grafica.
Fra i kernel il più usato è il gaussiano, detto RBF (sono le iniziali di radial basis function, «funzione a base radiale»: radiale perché guarda solo la distanza fra due punti, in qualunque direzione). Ha una manopola sola, che nelle formule si chiama \(\gamma\), «gamma», e conviene capire che cosa fa, perché è lei a fissare il raggio d’influenza di ogni punto.
Ogni punto è un lampione acceso di notte: illumina bene chi gli sta accanto, sempre meno chi si allontana, per niente chi è lontano, e il numero che il kernel restituisce per due punti è quanta luce dell’uno arriva all’altro. Sta fra \(0\) e \(1\), e vale \(1\) solo per il lampione stesso.
Chiamiamo portata del lampione la distanza alla quale la luce è scesa a poco più di un terzo, cioè a \(0{,}37\): mettiamo un metro e mezzo. Chi sta a un metro e mezzo si vede ancora. E chi sta al doppio, a tre metri? Non riceve la metà della luce, e nemmeno un terzo. A decidere è il quadrato della distanza, e raddoppiando la distanza il quadrato si moltiplica per quattro: la luce si attenua come se avesse attraversato quattro portate una dopo l’altra, e ognuna la riduce a \(0{,}37\). La luce che gli arriva è quindi \(0{,}37\) elevato alla quarta, cioè circa \(0{,}018\): meno di due centesimi, praticamente buio. Ecco perché il raggio d’influenza di un punto finisce così bruscamente.
La manopola \(\gamma\) regola quanto lontano arriva la luce, e lo fa al rovescio: più è alta, più la luce è corta. Il legame passa per il quadrato della portata, quindi moltiplicare la manopola per quattro dimezza la portata, mentre raddoppiarla la accorcia di meno di un terzo. \(\gamma\) grande, luce corta, e la frontiera viene frastagliata perché ogni punto comanda solo nel suo cortile (rischio di imparare il rumore); \(\gamma\) piccolo, luce lunga, e la frontiera esce morbida. Ancora più lunga e i lampioni si sovrappongono tutti: la piazza resta illuminata in modo uniforme, e la luce che arriva non dice più in che punto della piazza ci si trova.
Vediamolo con i numeri, scegliendo \(\gamma = 0{,}5\):
due punti vicini, \(\mathbf{x}=(2,2)\) e \(\mathbf{z}=(3,3)\), distano \(\lVert \mathbf{x}-\mathbf{z}\rVert^2 = 1^2 + 1^2 = 2\), quindi \(k(\mathbf{x},\mathbf{z}) = e^{-0{,}5\cdot 2} = e^{-1} \approx 0{,}37\): si «vedono» bene;
due punti lontani, \(\mathbf{x}=(2,2)\) e \(\mathbf{z}=(0,0)\), distano \(\lVert \mathbf{x}-\mathbf{z}\rVert^2 = 2^2 + 2^2 = 8\), quindi \(k(\mathbf{x},\mathbf{z}) = e^{-0{,}5\cdot 8} = e^{-4} \approx 0{,}018\): quasi si ignorano.
La funzione di decisione è una somma di campane centrate sui vettori di supporto, \(f(\mathbf{u}) = \sum_i \alpha_i y_i\, e^{-\gamma\lVert\mathbf{x}_i - \mathbf{u}\rVert^2} + b\), e i due estremi si leggono nella matrice di Gram. Per \(\gamma \to \infty\), \(\mathbf{K} \to \mathbf{I}\): ogni punto somiglia solo a sé stesso, diventano tutti vettori di supporto, l’addestramento è perfetto e lontano dai dati \(f\) vale \(b\); è la memoria pura, con varianza massima. Per \(\gamma \to 0\), \(\mathbf{K} \to \mathbf{1}\mathbf{1}^\top\) e i punti diventano indistinguibili; se però intanto \(C\) cresce come \(\tilde C/(2\gamma)\), la SVM gaussiana tende alla SVM lineare con parametro \(\tilde C\) [KL03], e una ricerca su \((C,\gamma)\) abbastanza larga contiene già il kernel lineare. Il gaussiano è il più usato perché è universale [Ste01]: le funzioni del suo spazio approssimano qualunque funzione continua su un compatto, e con abbastanza dati la SVM che lo usa è consistente.
Insieme a \(C\), \(\gamma\) è l’altro iperparametro da tarare per validazione.
Non solo classificare: la regressione con le SVM#
Lo stesso principio si adatta alla regressione (SVR, Support Vector Regression). Nella classificazione la SVM cerca il corridoio più largo tra le classi; nella regressione la larghezza \(\epsilon\) del tubo è fissata, e la SVR cerca la funzione più piatta che lascia i punti dentro il tubo, pagando quelli che sporgono.
La previsione diceva ventuno gradi e mezzo, il termometro segna ventuno e quattro: nessuno chiama sbaglio quel decimo. La SVR ragiona così. Invece di penalizzare ogni piccolo scarto tra previsione e valore vero (come fa la regressione lineare classica) disegna attorno alla linea un «tubo» di tolleranza, come un tratto di pennarello grosso al posto di una riga di matita: finché un punto sta dentro il tratto, l’errore conta zero. Pagano solo i punti che sporgono, e solo per quanto sporgono. Con un pennarello largo due decimi per parte, una previsione di \(21{,}5\) non paga niente se il valore vero sta fra \(21{,}3\) e \(21{,}7\); se il vero è \(21{,}9\) paga \(0{,}2\), cioè non i quattro decimi di scarto ma soltanto i due che escono dal tratto.
Le manopole nuove sono due, e fanno mestieri diversi. La prima è la grossezza del pennarello, cioè quanto scarto si accetta di chiamare zero. La seconda è quanto si tiene ai punti rimasti fuori: girata verso il severo, la linea si torce pur di raccogliere anche quelli; girata verso l’indulgente, resta semplice e li lascia sporgere. E il tratto non deve restare dritto: con lo stesso sollevamento del bersaglio può curvare quanto serve, e resta il medesimo tubo.
Il pennarello troppo grosso è il modo in cui la faccenda si guasta. Se il tratto copre già tutti i punti, qualunque linea passi di lì va bene, e la più comoda è quella piatta, che risponde lo stesso numero a qualunque domanda.
Si fissa una tolleranza \(\epsilon > 0\) e si usa la loss \(\epsilon\)-insensitive, nulla dentro il tubo e lineare fuori:
Gli errori entro \(\pm\epsilon\) non vengono penalizzati; oltre, la penalità cresce linearmente. Con due variabili slack per ogni esempio, una per chi sporge sopra il tubo e una per chi sporge sotto, il problema è
e i vettori di supporto sono i punti sul bordo del tubo o fuori. Da qui anche il guasto: se \(\epsilon \ge \tfrac12(\max_i y_i - \min_i y_i)\), la costante \(f = \tfrac12(\max_i y_i + \min_i y_i)\) con \(\mathbf{w} = \mathbf{0}\) sta tutta nel tubo, ha obiettivo nullo ed è quindi una soluzione (per \(\epsilon\) maggiore della semiampiezza ce ne sono infinite: qualunque costante \(b\) con \(\max_i y_i - \epsilon \le b \le \min_i y_i + \epsilon\)): il modello risponde lo stesso numero a ogni domanda. Il parametro \(\epsilon\) fissa l’ampiezza del tubo, mentre \(C\) regola come sempre il compromesso tra piattezza del modello e violazioni. Anche qui vale il kernel trick, così la SVR può adattare curve non lineari esattamente come la SVM classifica frontiere non lineari.
Una classe sola: novelty e anomaly detection#
C’è un’ultima variante, e risponde a una domanda diversa: e se avessimo esempi di una sola classe? Vogliamo imparare com’è fatto il «normale» (transazioni regolari, macchinari sani, traffico di rete legittimo) per poi accorgerci di ciò che se ne discosta. È il problema della novelty detection, quando i dati di addestramento sono tutti normali e si vuole riconoscere ciò che è nuovo, e dell’anomaly detection (o outlier detection), quando le anomalie sono già mescolate ai dati di addestramento e vanno trovate lì. Si lega al tema dei dati fuori distribuzione di cui si occupa la sezione sui dati che cambiano: individuare gli input troppo lontani da ciò che il modello ha visto, invece di predire con finta sicurezza.
Migliaia di transazioni oneste con la carta di credito, e nemmeno una frode: un classificatore «onesto contro frode» non si può neanche cominciare, perché la seconda classe non c’è. La one-class SVM cambia domanda. Sulla mappa disegnata dal kernel, dove le transazioni che si somigliano finiscono vicine, quelle oneste formano un paese, e tutt’intorno c’è campagna vuota: il posto in cui non si somiglia a niente e a nessuno. Il metodo tira una staccionata fra il paese e la campagna, e la spinge il più lontano possibile dalla campagna, finché appoggia contro le case di frontiera. Ecco perché il recinto viene stretto: è premuto contro il paese dalla parte del vuoto.
Una manopola, \(\nu\), dice quante case si accetta di lasciare fuori: al massimo quella frazione. È un permesso che conviene dare, perché una sola casa isolata in mezzo ai campi costringerebbe la staccionata ad allargarsi per chilometri. E la stessa frazione dice quante case, come minimo, finiranno appoggiate alla staccionata o fuori: sono quelle che la reggono, e togliere dalla mappa tutte le altre non la sposterebbe di un metro.
Da lì in avanti ogni transazione nuova che cade fuori dal recinto è sospetta: non perché somigli a una frode nota, ma perché non somiglia a nulla di normale. Serve dove le cose da riconoscere sono rare, o non sono ancora capitate. C’è un modo in cui sbaglia: se il paese cresce e si costruiscono case nuove più in là, tutte legittime, la vecchia staccionata le segnala una per una. Non sa che cosa sia una frode; sa soltanto dov’era il paese il giorno in cui l’ha guardato.
La one-class SVM di Schölkopf e colleghi [ScholkopfPST+01] adatta l’idea del margine al caso non supervisionato: mappati i dati nello spazio delle feature con un kernel (di solito RBF), cerca l’iperpiano che separa i punti dall’origine con il massimo margine. Il problema è
e la regola è \(\operatorname{sign}\bigl(\mathbf{w}^\top\phi(\mathbf{x}) - \rho\bigr)\), con l’iperpiano a distanza \(\rho/\lVert\mathbf{w}\rVert\) dall’origine. Ricondotto allo spazio originale, questo equivale a racchiudere i dati normali in una regione compatta; ciò che cade fuori è novità o anomalia. Il parametro \(\nu \in (0,1]\), che pesa le violazioni con \(1/(\nu m)\), ha un doppio significato preciso: è un limite superiore alla frazione di esempi di addestramento classificati come anomali (i margin error) e un limite inferiore alla frazione di vettori di supporto. La distingue dalla classificazione binaria un’assenza, quella della classe «anomalo» in addestramento: si impara solo la forma del normale. Un parente stretto è la Support Vector Data Description (SVDD) di Tax e Duin, che invece della separazione dall’origine cerca la ipersfera minima che racchiude i dati; con un kernel a diagonale costante, come il gaussiano (\(k(\mathbf{x},\mathbf{x}) = 1\)), le immagini dei punti stanno tutte su una sfera, e i due metodi danno lo stesso confine. Tra le alternative non-kernel ci sono l’Isolation Forest (che isola le anomalie con partizioni casuali, ereditando la scalabilità degli alberi della sezione sugli ensemble) e il Local Outlier Factor basato sulla densità locale.
I limiti sono due. Senza esempi anomali non c’è un errore da validare, e \(\gamma\) e \(\nu\) si fissano con euristiche (\(\nu\) dalla quota di anomalie che ci si aspetta). Il modello descrive i dati del giorno in cui è stato addestrato: se la loro distribuzione si sposta, il nuovo normale esce come anomalo.
In pratica, con scikit-learn#
In scikit-learn la famiglia SVM vive nel modulo sklearn.svm: SVC per la
classificazione con kernel, LinearSVC per la versione lineare veloce, SVR
per la regressione, OneClassSVM per la novelty detection. Due avvertenze
valgono per tutte, e non sono opzionali.
Standardizzare le feature: a ogni colonna si sottrae la media e la si divide per
la deviazione standard, così che i metri quadri (che valgono decine) e il numero
di stanze (che vale unità) contino allo stesso modo. Il kernel gaussiano dipende
dalle distanze, e senza questa operazione la colonna con i numeri più grandi
domina il conto, come in ogni metodo basato sulle distanze, a cominciare dal
k-NN. In una Pipeline si mette uno StandardScaler davanti al modello; fa
eccezione il testo in forma sparsa, dove si normalizza ogni riga, perché
centrare le colonne distruggerebbe la sparsità.
Attenzione ai numeri grandi: l’addestramento di una SVM con un kernel costa fra
\(O(m^2)\) e \(O(m^3)\) nel numero \(m\) di esempi (raddoppiando gli esempi il lavoro
si moltiplica per quattro o per otto), e la matrice di Gram ha \(m^2\) elementi.
Va bene da poche centinaia a qualche decina di migliaia di punti, e diventa
proibitiva su milioni. Per i dataset molto grandi si ripiega su modelli lineari
(LinearSVC, SGDClassifier, che scalano circa come \(O(m)\)) o sugli alberi in
boosting della sezione sugli ensemble
[Geron22].
Le tre varianti si provano sugli stessi duecento punti, due mezzelune
intrecciate (make_moons), il caso di scuola delle frontiere curve. Il \(\gamma\)
lo sceglie il default di scikit-learn, gamma="scale", che vale \(1/(n\,
\mathrm{Var}(\mathbf{X}))\) con \(n\) colonne: dopo lo StandardScaler, \(1/n\).
import numpy as np
from sklearn.datasets import make_moons
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC, LinearSVC, SVR, OneClassSVM

X, y = make_moons(n_samples=200, noise=0.20, random_state=0)

# Classificazione con kernel RBF: standardizzare SEMPRE (la SVM e' sensibile alla scala)
clf = make_pipeline(StandardScaler(),
                    SVC(kernel="rbf", C=1.0, gamma="scale"))
clf.fit(X, y)

# Variante lineare, veloce su molti esempi: niente kernel trick, costo ~O(m)
lin = make_pipeline(StandardScaler(), LinearSVC(C=1.0))
lin.fit(X, y)

# Regressione: qui serve un target CONTINUO, non le classi 0/1 di sopra.
# Fabbrichiamone uno: una sinusoide della prima coordinata, con un po’ di rumore.
rng = np.random.default_rng(0)
y_reg = np.sin(3 * X[:, 0]) + rng.normal(0, 0.1, size=len(X))

# il tubo epsilon-insensitive ignora gli scarti piccoli
reg = make_pipeline(StandardScaler(),
                    SVR(kernel="rbf", C=10.0, epsilon=0.1))
reg.fit(X, y_reg)

# One-class SVM: impara la regione dei dati "normali". nu dice che al
# piu' quella frazione dei dati visti sta oltre il bordo e che almeno quella
# frazione lo regge; il solutore si ferma a una tolleranza (tol=1e-3), quindi
# qualche punto quasi sul bordo esce -1, e predict ne segnala qualcuno in piu'
normali = X[y == 0]                      # fingiamo di avere solo la classe "normale"
det = make_pipeline(StandardScaler(),
                    OneClassSVM(kernel="rbf", nu=0.05, gamma="scale"))
det.fit(normali)
esito = det.predict(X)                   # +1 = normale, -1 = anomalia
mai_visti = esito[y == 1]                # i 100 punti dell'altra luna
print("dei 100 mai visti, segnalati:", int(np.sum(mai_visti == -1)))
print("dei 100 visti, segnalati:", int(np.sum(det.predict(normali) == -1)))
dei 100 mai visti, segnalati: 95
dei 100 visti, segnalati: 9
Il rilevatore ha imparato la forma di una luna sola e non ha mai visto l’altra: dei cento punti di quell’altra ne riconosce estranei novantacinque.
La solita grammatica fit/predict regge anche qui. Per la SVM con kernel la
coppia di iperparametri da tarare per validazione è \((C, \gamma)\): una ricerca
su griglia con la cross-validation della sezione sull’overfitting è la prassi.
Da ricordare
Il kernel trick rende curva la frontiera: gli stessi punti si guardano in uno spazio con una dimensione in più, e lì tornano separabili da un taglio dritto. È il bersaglio sollevato in aria, ogni punto tanto più in alto quanto più è lontano dal centro, finché una lastra di vetro orizzontale divide il centro dall’anello: i punti non sono cambiati, è cambiato il posto da cui li guardiamo. Il modo più usato di misurare quanto due punti si somigliano è quello «a lampione», dove ogni punto illumina i vicini: luce corta, frontiera frastagliata; luce lunga, frontiera morbida.
La stessa idea serve anche a prevedere numeri (un tubo di tolleranza attorno alla curva: finché il punto ci sta dentro, l’errore conta zero) e a riconoscere le anomalie (un recinto attorno ai dati normali, e chi cade fuori è sospetto, senza aver mai visto una frode).
In pratica: portare tutte le caratteristiche alla stessa scala, perché la SVM con il kernel gaussiano ragiona per distanze; e ricordare che il conto cresce assai più in fretta del numero di esempi, tanto che oltre le decine di migliaia la SVM con kernel diventa impraticabile.
Da ricordare
Il kernel trick rende non lineare la SVM: mappa i dati in uno spazio più ampio dove diventano separabili, calcolando i prodotti scalari con un kernel \(k(\mathbf{x},\mathbf{z})=\phi(\mathbf{x})^\top\phi(\mathbf{z})\) senza costruirlo: funziona perché nel duale gli esempi compaiono solo dentro prodotti scalari, e vale se e solo se \(k\) è simmetrica e semidefinita positiva (Moore e Aronszajn; Mercer ne dà la forma spettrale per \(k\) continuo su un compatto). I kernel validi si compongono: somme, prodotti ed esponenziali di kernel validi lo sono ancora. Kernel principali: lineare, polinomiale, RBF, dove \(\gamma\) stringe la campana al crescere (\(\gamma = 1/(2\sigma^2)\)).
La SVR regredisce con un tubo \(\epsilon\)-insensitive; la one-class SVM impara la regione dei dati normali per la novelty/anomaly detection, senza vedere esempi anomali, e il suo \(\nu\) è un limite superiore alla frazione di anomalie e inferiore a quella dei vettori di supporto.
In pratica: standardizzare le feature (sul testo sparso, normalizzare le righe); il costo \(O(m^2)\)–\(O(m^3)\) sconsiglia la SVM con kernel oltre le decine di migliaia di esempi.
Le SVM hanno imparato a tracciare un confine, dritto o piegato dal kernel, guardando soltanto dove le classi si toccano. C’è un’altra strada, che il confine non lo cerca: impara com’è fatta ciascuna classe per intero, e il confine viene dopo, per conseguenza. È la strada dei modelli generativi, e il Bayes ingenuo del confronto fra ensemble ne era già un esempio.