


Capire è accorciare#
Ireneo Funes, il ragazzo che Borges immagina caduto da cavallo in un paese dell’Uruguay, si sveglia da quella caduta con una memoria che non perde niente. Ricorda ogni foglia di ogni albero di ogni bosco che ha visto, e non solo la foglia: anche ciascuna delle volte in cui l’ha guardata. Ricorda la forma delle nuvole all’alba del 30 aprile 1882, e la sa confrontare con le venature di un libro rilegato in pelle spagnola che aveva sfogliato una volta sola. Dove noi vediamo tre bicchieri su un tavolo, lui vede tutti i tralci e i grappoli e gli acini di una vite. Borges avrebbe potuto farne un genio, e ne fa il contrario: quel ragazzo, sospetta chi racconta, non era molto capace di pensare, perché «pensare è dimenticare differenze, è generalizzare, astrarre»[1].
Il difetto di Funes, detto in una parola, è che non sa accorciare. Per lui il cane visto di profilo alle tre e quattordici e lo stesso cane visto di fronte tre minuti dopo sono due cose distinte, e due cose distinte vogliono due nomi: il suo mondo non sta in nessuna descrizione più breve del mondo stesso. Un modello che impara a memoria il proprio insieme di addestramento è un Funes, e Overfitting e validazione lo ha già mostrato in azione con altri nomi.
La definizione, le famiglie di pretesti e il collasso lasciano aperta la domanda più scomoda, quella che uno studente fa al secondo minuto: perché ottimizzare un compito (indovinare la parola coperta) dovrebbe migliorarne un altro, diverso, a cui nessuno ha addestrato il modello (rispondere, poniamo, a una domanda di biologia)? Una parte del campo dà a quella domanda una risposta sola, ed è la stessa di Borges: per prevedere bene bisogna accorciare, e per accorciare bisogna aver colto la struttura dei dati.
Predire e comprimere sono la stessa operazione#
Il primo fatto è già acquisito, ed è che predire e comprimere sono la stessa operazione. La regola che le tiene insieme è una sola: più una cosa è attesa, meno costa scriverla. La ricava dal teorema di Shannon la sezione Teoria dell’informazione: il numero di bit che serve per scrivere un messaggio con il codice migliore possibile è \(-\log_2 p\), dove \(p\) è la probabilità che il modello assegna a quel messaggio. La formula si legge con due conti a mente: se il modello dava a quello che è arrivato una probabilità su due, il prezzo è un bit; una su otto, tre bit; una su mille, circa dieci. Se lo dava per quasi certo, al 99%, il prezzo scende a un centesimo e mezzo di bit. L’ha resa operativa A che serve saperlo, e dove sbaglia: un modello che sa dire \(p(\mathbf{x})\), cioè quanto è probabile un dato, è un compressore, non per analogia, e infatti quella famiglia di modelli si misura in bit per dimensione, cioè in quanti bit costa in media ogni singolo numero del dato.
Il secondo è che la perdita che il pre-addestramento di un modello generativo minimizza, la cross-entropia, è quel prezzo lì sommato su tutto il testo: ogni parola che il modello dava per improbabile, e che invece arriva, si paga cara. Minimizzare la cross-entropia su un corpus e minimizzare la lunghezza del file compresso sono la stessa istruzione scritta in due gerghi. Vale per i modelli che danno una probabilità alla sequenza intera, cioè quelli autoregressivi, che prevedono la parola successiva. Il modello a maschera dà la probabilità di ogni parola coperta conoscendo tutte le altre, che non è la probabilità della frase e non definisce un codice; e le perdite contrastive, a distillazione e a ridondanza delle quattro famiglie non ne definiscono nessuno. Quello che segue riguarda quindi il pre-addestramento generativo, non l’intera auto-supervisione.
Quello che di nuovo c’è qui è il passo successivo, e non è piccolo: se addestrare è comprimere, allora una teoria della compressione è una teoria dell’apprendimento, e qualcuno ha provato a leggerla come una teoria dell’intelligenza.
Un fondo esiste, e non tutti lo toccano#
Prima della teoria, un esperimento che sta in una pagina e si può rilanciare. Costruiamo una lingua con una regola sola: quattro lettere, due «vocali» e due «consonanti», e dopo una consonante arriva quasi sempre una vocale. La tabella delle transizioni è fatta in modo che le quattro lettere escano ugualmente frequenti, e questo è il punto: chi si limita a contarle non troverà niente da dire, perché tutta la struttura sta nel passaggio da una all’altra.
Poi proviamo a scrivere duecentomila lettere di quella lingua nel modo più corto possibile, con quattro modelli diversi e con due compressori veri. La domanda è una sola, e conviene tenerla in mano mentre scorre il codice: chi arriva al fondo, e chi no.
import lzma
import zlib
from collections import defaultdict
from math import log2
from random import Random

# Una lingua con una regola sola: dopo una consonante arriva quasi sempre una
# vocale, e viceversa. La tabella ha somma 1 anche per COLONNE, quindi le
# quattro lettere escono ugualmente frequenti: contarle non serve a niente, e
# tutto quello che c'e' da capire sta nel passaggio da una all'altra.
REGOLA = {
    "a": {"a": 0.05, "e": 0.05, "r": 0.35, "t": 0.55},
    "e": {"a": 0.05, "e": 0.05, "r": 0.55, "t": 0.35},
    "r": {"a": 0.35, "e": 0.55, "r": 0.05, "t": 0.05},
    "t": {"a": 0.55, "e": 0.35, "r": 0.05, "t": 0.05},
}
LETTERE = sorted(REGOLA)
N = 200_000


def genera(n, seme=0):
    """Estrae n lettere dalla sorgente. Il seme e' fissato: il testo non cambia."""
    r, seq = Random(seme), ["a"]
    for _ in range(n - 1):
        p, soglia, cumulata = REGOLA[seq[-1]], r.random(), 0.0
        for lettera in LETTERE:
            cumulata += p[lettera]
            if soglia < cumulata:
                seq.append(lettera)
                break
    return "".join(seq)


def entropia(p):
    return -sum(q * log2(q) for q in p if q > 0)


def bit_per_lettera(testo, ordine):
    """Quanto costa scrivere il testo con un modello che impara leggendolo.

    Non c'e' nessun modello da spedire a parte: chi legge rifa' gli stessi
    conteggi sulle lettere gia' viste, quindi il prezzo di imparare sta DENTRO
    questo numero e non accanto.
    """
    conte = defaultdict(lambda: dict.fromkeys(LETTERE, 1))   # Laplace
    totale = defaultdict(lambda: len(LETTERE))
    bit = 0.0
    for i, lettera in enumerate(testo):
        contesto = testo[max(0, i - ordine):i]
        bit -= log2(conte[contesto][lettera] / totale[contesto])
        conte[contesto][lettera] += 1
        totale[contesto] += 1
    return bit / len(testo)


testo = genera(N)
grezzo = testo.encode("ascii")

# Il fondo: la sorpresa media di una lettera SAPENDO la precedente. Le quattro
# lettere sono equiprobabili, quindi la media sulle righe pesa 1/4 ciascuna.
fondo = sum(entropia(list(REGOLA[s].values())) for s in LETTERE) / len(LETTERE)

# L'oracolo: conosce la tabella dall'inizio e non impara niente. Serve a
# separare due cose che altrimenti si confondono, cioe' quanto costa IMPARARE
# la regola e quanto costa il fatto che proprio QUESTO testo, sorteggiato,
# sia un po' piu' sorprendente della media.
bit = -log2(1 / len(LETTERE))
for prima, dopo in zip(testo, testo[1:]):
    bit -= log2(REGOLA[prima][dopo])
oracolo = bit / len(testo)

print(f"il fondo della sorgente     {fondo:.4f} bit per lettera")
print(f"chi la regola la sapeva     {oracolo:.4f}")
print(f"nessun modello              {log2(len(LETTERE)):.4f}")
for ordine in (0, 1, 2):
    print(f"modello di ordine {ordine}         {bit_per_lettera(testo, ordine):.4f}")
print(f"zlib                        {len(zlib.compress(grezzo, 9)) * 8 / N:.4f}")
print(f"lzma                        {len(lzma.compress(grezzo)) * 8 / N:.4f}")
il fondo della sorgente     1.4367 bit per lettera
chi la regola la sapeva     1.4398
nessun modello              2.0000
modello di ordine 0         2.0001
modello di ordine 1         1.4402
modello di ordine 2         1.4411
zlib                        1.8010
lzma                        1.6885
Tre numeri in più servono a leggere bene quelle righe: di quanto oscilla, da un testo sorteggiato all’altro, il costo di chi la regola la conosce; dopo quante lettere i due modelli che imparano arrivano vicino al fondo; e quanto un conto classico prevede che costi imparare.
# Di quanto oscilla il costo medio dell'oracolo da un testo sorteggiato
# all'altro: la deviazione standard del costo per lettera divisa per la
# radice di N (le lettere vicine sono quasi indipendenti, e qui basta).
costi = [-log2(REGOLA[prima][dopo]) for prima, dopo in zip(testo, testo[1:])]
media = sum(costi) / len(costi)
varianza = sum((c - media) ** 2 for c in costi) / (len(costi) - 1)
print(f"scarto tipico dell'oracolo      {(varianza / len(costi)) ** 0.5:.4f}")


def lettere_per_avvicinarsi(testo, ordine, margine=0.05):
    """Dopo quante lettere il costo medio accumulato scende entro `margine`
    bit dal fondo. Stesso modello di bit_per_lettera, fermato a meta' strada."""
    conte = defaultdict(lambda: dict.fromkeys(LETTERE, 1))
    totale = defaultdict(lambda: len(LETTERE))
    bit = 0.0
    for i, lettera in enumerate(testo, 1):
        contesto = testo[max(0, i - 1 - ordine):i - 1]
        bit -= log2(conte[contesto][lettera] / totale[contesto])
        conte[contesto][lettera] += 1
        totale[contesto] += 1
        if bit / i <= fondo + margine:
            return i


for ordine, liberi in ((1, 12), (2, 48)):
    # il conto classico: (parametri liberi / 2) * log2(N) / N bit per lettera
    print(f"ordine {ordine}: entro 0.05 dal fondo dopo "
          f"{lettere_per_avvicinarsi(testo, ordine)} lettere, "
          f"prezzo previsto {liberi / 2 * log2(N) / N:.4f}")
scarto tipico dell'oracolo      0.0023
ordine 1: entro 0.05 dal fondo dopo 1821 lettere, prezzo previsto 0.0005
ordine 2: entro 0.05 dal fondo dopo 3535 lettere, prezzo previsto 0.0021
Il fondo è la sorpresa media di una lettera sapendo quale l’ha preceduta, e non è un risultato sperimentale: si calcola dalla tabella. Nessun codice, per quanto ingegnoso, spende in media meno di \(1{,}4367\) bit per lettera su testi sorteggiati da questa lingua.
Il paragrafo sul programma più corto tornerà su questo fatto: è un limite in media sulla sorgente, non un limite su questa stringa. Chi avesse in mano proprio queste duecentomila lettere le scriverebbe in un programma di poche righe (il seme, la tabella, il ciclo), cioè in pochissimi bit per lettera; ma quel programma sa una cosa che nessun compressore, guardando il testo, può indovinare.
Ogni riga della tabella è un modo di scrivere lo stesso testo, e il numero è quanto costa in media ogni lettera, in bit: quante domande da sì o no servono per indovinarla.
Chi non sa niente spende due bit per lettera: quattro lettere possibili, due domande. Chi si limita a contare quante volte esce ogni lettera non guadagna niente, perché le quattro lettere escono tutte lo stesso numero di volte: ha guardato nel posto sbagliato, e guardare non è gratis, tanto che spende un decimillesimo in più.
Chi guarda la lettera precedente ha trovato il posto giusto: dopo una consonante, quasi sempre una vocale. Arriva a un soffio da chi la regola la sapeva dall’inizio, e quel soffio, quattro decimillesimi di bit, è il prezzo di averla imparata leggendo: nelle prime righe non sapeva ancora niente, e ha speso di più.
Chi guarda le due lettere precedenti ha una memoria più grande del necessario, e la paga. Ha sedici casi da imparare invece di quattro, e niente in più da trovarci, perché nella lingua non c’è niente oltre la lettera prima: spende più di chi ne guarda una sola.
E chi la regola la sapeva? Nemmeno lui tocca il fondo esatto: queste duecentomila lettere, uscite a sorte, sono un poco più sorprendenti della media, e quei tre millesimi di troppo sono fortuna del sorteggio: un altro testo estratto dalla stessa lingua ne darebbe qualcuno in più o in meno.
I due compressori veri, zlib e lzma, sono programmi seri, scritti da persone
serie, e non sanno niente di questa lingua. Cercano pezzi di testo già visti,
ne trovano pochi e corti, e guadagnano qualcosa senza avvicinarsi al fondo. La
regola la trova solo chi ha la forma giusta per ospitarla.
L’oracolo conosce la catena di Markov e non impara niente, eppure spende \(1{,}4398\), tre millesimi sopra il fondo. È la fluttuazione del sorteggio: lo scarto tipico del costo medio su \(N = 2 \cdot 10^5\) lettere è \(0{,}0023\) bit (deviazione standard del costo per lettera divisa per \(\sqrt{N}\); la correlazione fra costi vicini, che qui è piccola, la si trascura), e tre millesimi stanno dentro poco più di uno scarto. Chi confronta un modello direttamente con il fondo teorico si mette in conto quello scarto senza accorgersene: il prezzo di imparare si misura contro l’oracolo, sullo stesso testo.
Il modello di ordine 0 spende \(2{,}0001\). La tabella delle transizioni ha somma uno anche per colonne, quindi la distribuzione stazionaria è uniforme e le frequenze marginali non portano informazione; lo stimatore di Laplace paga per stimarle senza trovarvi niente.
Il modello di ordine 1 ha la forma della sorgente, una catena del primo ordine, e arriva a \(1{,}4402\), quattro decimillesimi sopra l’oracolo: è il prezzo di apprendimento, pagato dentro il numero perché il codice stima i parametri mentre legge. Il conto classico di Rissanen [Ris78] lo prevede: un codice che stima \(k\) parametri liberi paga per simbolo circa \(\tfrac{k}{2}\log_2 N / N\) più dell’oracolo. Qui \(k = 12\) (quattro contesti per tre probabilità ciascuno, perché la quarta è quello che avanza per arrivare a uno), e la previsione è \(0{,}0005\) contro i \(0{,}0004\) osservati: è un’asintotica e sovrastima un poco, ma l’ordine di grandezza è quello.
Il modello di ordine 2 ha \(k = 48\) parametri liberi in sedici contesti, e nessuna struttura in più da catturare. Spende \(1{,}4411\), cioè \(0{,}0013\) sopra l’oracolo, più del triplo dell’ordine 1, in cambio di nulla; la formula ne prevede \(0{,}0021\) e sovrastima di più, perché presuppone che ogni parametro abbia a disposizione tutti i dati, mentre ciascun contesto vede solo la propria fetta. È il rasoio di Occam, la regola per cui a parità di risultato vince la spiegazione più semplice, misurato in bit: un modello più ricco del necessario si paga e non rende. Il paragrafo sul prezzo del modello ci torna sopra, perché è il punto in cui la tesi rischia di rompersi.
zlib e lzma codificano ripetizioni letterali del testo già visto. In
duecentomila lettere su quattro simboli le ripetizioni brevi ci sono, e valgono
\(0{,}2\) e \(0{,}3\) bit per lettera (\(1{,}8010\) e \(1{,}6885\) contro \(2\)); ma la
regola della sorgente è probabilistica, sulla lettera successiva, e non ha la
forma di una ripetizione.
La media finale però nasconde quando ognuno paga. La Fig. 30.1 mostra le tre curve mentre scorrono: tutte partono da due bit, cioè da «non so niente», e da lì in poi le strade si dividono. Quello di ordine 1 si porta a cinque centesimi di bit dal fondo dopo \(1821\) lettere; quello di ordine 2 ne ha bisogno di \(3535\), quasi il doppio, per arrivare un po’ più in su. Quel ritardo è la forma visibile del suo costo: sedici contesti si riempiono di dati più lentamente di quattro.

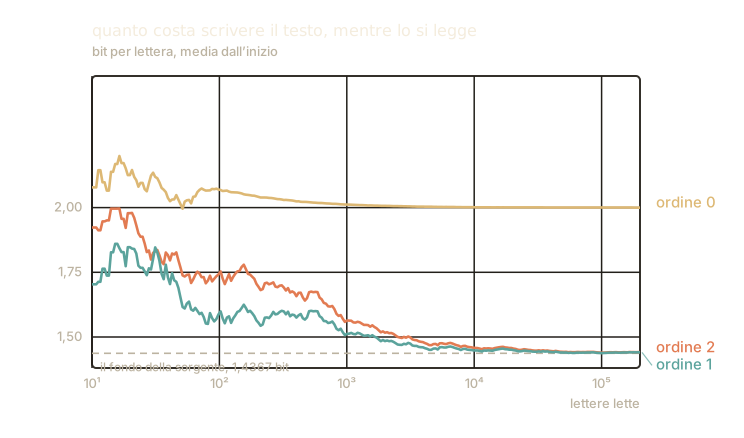
Fig. 30.1 Il prezzo di imparare, pagato mentre si legge. Le tre curve sono il costo medio per lettera accumulato dall’inizio del testo: chi non ha la forma giusta resta in alto per sempre, chi ce l’ha scende verso il fondo, e chi ne ha troppa ci mette più tempo e arriva un po’ più in su.#
Il gesto da portarsi via
Il fondo lo tocca il modello che ha la forma della regola, non il più grosso e non il più generico. È una descrizione di tutto il machine learning, misurata qui in bit invece che in accuratezza.
Il programma più corto#
Quel «fondo» esiste perché la sorgente l’abbiamo scritta noi e ne conosciamo la regola. Nel mondo vero la regola non si conosce, e la domanda diventa: esiste un fondo anche quando non sappiamo che cosa stiamo guardando?
La risposta è sì, e ci sono arrivate tre persone in tre modi diversi nel giro di due anni: Ray Solomonoff, che cercava una teoria dell’induzione [Sol64], Andrej Kolmogorov, che cercava una definizione di informazione che non passasse dalla probabilità [Kol65], e Gregory Chaitin, che allora era uno studente [Cha66]. Il nome che è rimasto è quello di mezzo, ed è lo stesso Kolmogorov che nel 1933 aveva dato alla probabilità i suoi tre assiomi: trent’anni dopo averla fondata su basi solide, stava cercando un modo di misurare l’informazione che ne facesse a meno.
Prendi due fogli, tutti e due pieni di un milione di cifre.
Sul primo ci sono le cifre di \(\pi\), una dopo l’altra. Sul secondo ci sono un milione di cifre uscite da un’urna, una a caso ogni volta. I due fogli si somigliano: stessa lunghezza, stessa aria di disordine, e in tutti e due le dieci cifre compaiono all’incirca lo stesso numero di volte. Se li giudichi guardandoli, sono la stessa cosa.
Adesso però prova a dettarli al telefono a qualcuno che ha un calcolatore. Per il primo foglio bastano poche parole: «stampa il primo milione di cifre di pi greco», e c’è una ricetta di qualche riga che le produce tutte. Per il secondo non c’è niente di meglio che leggergliele una per una: nessuna ricetta corta le produce, perché non c’è nessuna ragione per cui la cifra dopo debba essere proprio quella.
La lunghezza della dettatura più corta possibile è la misura che serve, e ha il nome del matematico russo che è uno dei tre ad averci pensato: complessità di Kolmogorov. Dice quanto quel foglio è complicato davvero, non quanto sembra: il primo è semplicissimo e sembra caotico, il secondo è caotico e basta. Con una conseguenza scomoda: un foglio di cifre a caso è la cosa più complessa che esista, perché per descriverlo non si può fare di meglio che ricopiarlo. Complesso non vuol dire interessante.
E la misura sta sul foglio, non sull’urna. Se per combinazione dall’urna esce un milione di zeri, quel foglio si detta in tre parole pur essendo uscito a caso. Quanto un’urna sorprende in media, che è il fondo della lingua a quattro lettere, e quanto costa dettare i fogli che ne escono sono due conti diversi: in media danno quasi lo stesso numero, quando l’urna è semplice da descrivere, ma su un foglio preciso possono essere lontanissimi.
La dettatura corta si può anche leggere come una scommessa. Se una scimmia battesse ricette a caso sulla tastiera del calcolatore, il foglio di \(\pi\) uscirebbe molto più spesso di quello dell’urna, perché basta azzeccare una ricetta corta; e quanto è probabile che un foglio esca così corrisponde, a meno di poco, a quanto è corta la sua dettatura. Indovinare e accorciare sono di nuovo la stessa cosa.
Due obiezioni, con la loro risposta corta.
Il calcolatore dell’amico: la misura dipenderà da quello. Sì, ma di pochissimo: se il suo parla un’altra lingua, gli detti prima le istruzioni per capire la mia, e quelle sono sempre le stesse, comunque sia lungo il foglio.
Il programma di compressione: vale anche lui come dettatura, però bisogna dettare due cose, il file compresso e il programma che lo apre, se no dall’altra parte nessuno ricostruisce niente. Ecco perché nessun compressore può battere la dettatura più corta: è già lui una dettatura, solo con il conto fatto per intero.
C’è però una fregatura, ed è un teorema: quella lunghezza non si può calcolare. Non serve un calcolatore più grosso: un programma che, preso un foglio qualsiasi, dica qual è la ricetta più corta che lo produce non esiste e non può esistere. Per esserne sicuri bisognerebbe provarle tutte, e certe ricette non finiscono mai. Quindi il fondo c’è, ma è un metro contro cui misurarsi sapendo che non lo si raggiungerà mai, e non una procedura.
Fissata una macchina universale \(U\), la complessità di Kolmogorov di una stringa \(x\) è la lunghezza del programma più corto che, dato a \(U\), stampa \(x\) e si ferma:
(Questo \(K\) è la complessità, e da qui in avanti è l’unico: nelle sezioni precedenti \(K\) contava le possibilità di una scelta, le classi di un’etichetta o i candidati della perdita contrastiva.)
Da qui in avanti si intende la variante prefix, cioè si chiede in più che nessun programma sia prefisso di un altro (che è come dire che \(U\) sa da sola dove il programma finisce). Serve alla disuguaglianza di Kraft, \(\sum_x 2^{-K(x)} \le 1\), e quindi a due dei fatti che seguono, il legame con l’entropia di Shannon e la regola della catena con un errore costante; il limite per i compressori e la non computabilità valgono anche per la complessità senza quella richiesta.
La dipendenza da \(U\) è innocua, ed è il teorema di invarianza: per due macchine universali \(U\) e \(V\) esiste una costante \(c_{U,V}\), che dipende dalle due macchine e non da \(x\), tale che \(|K_U(x) - K_V(x)| \le c_{U,V}\). La costante è la lunghezza dell’interprete dell’una scritta per l’altra. Si scrive quindi \(K(x)\), sottintendendo «a meno di una costante additiva».
Tre fatti servono qui.
Il primo lega \(K\) a qualsiasi compressore reale. Se \(C\) è un algoritmo di compressione senza perdita, allora per ogni \(x\)
perché un programma che stampa \(x\) si può sempre scrivere come «ecco il decompressore \(C^{-1}\), ecco i dati \(C(x)\), eseguilo». (Con la variante prefix serve che anche l’uscita di \(C\) sia un codice prefisso, o che il programma ne dichiari la lunghezza, il che aggiunge un termine \(O(\log |C(x)|)\).) La complessità di Kolmogorov è quindi il limite inferiore di ogni compressore possibile, codice del compressore incluso: nessuno può fare meglio, e chiunque si avvicini lo fa perché ha trovato struttura vera.
Il secondo lega \(K\) all’entropia di Shannon, cioè al fondo della lingua a quattro lettere. Per una sorgente \(P\) computabile vale
cioè il valore atteso di \(K\) sta sempre sopra l’entropia e la supera al più della complessità della sorgente stessa [GrunwaldVitanyi04]. La costante misura quanto costa descrivere \(P\), e non è universale. Sono due nozioni diverse di informazione, una per singolo oggetto e l’altra per distribuzione, e su una sorgente semplice come la lingua a quattro lettere si toccano; è la ragione per cui lì il fondo di Shannon e il fondo algoritmico raccontano la stessa storia, e insieme la ragione per cui su una stringa sorteggiata possono divergere di molto.
Il legame con la previsione ha un enunciato preciso, il teorema di codifica di Levin. La probabilità a priori universale di \(x\), \(m(x) = \sum_{p \,:\, U(p) = x} 2^{-|p|}\), cioè la probabilità che un programma scritto a caso, bit dopo bit, stampi \(x\), soddisfa \(-\log_2 m(x) = K(x) + O(1)\) [LVitanyi19]: prevedere con \(m\) e comprimere con il programma più corto sono la stessa cosa a meno di una costante, ed è il fondamento dell’induzione di Solomonoff. L’equivalenza però vale per un ideale: \(m\) non si sa calcolare, si sa solo approssimare dal basso (e non è nemmeno una distribuzione in senso stretto, perché la somma dei suoi valori sta sotto uno), quindi nessun modello che si possa eseguire è quel predittore.
Il terzo è che \(K\) è non computabile: nessun algoritmo, dato \(x\), ne restituisce \(K(x)\). Segue dall’indecidibilità della fermata ed è già in Kolmogorov e Solomonoff; di Chaitin, dieci anni dopo, è la conseguenza più famosa, la versione algoritmica dell’incompletezza [Cha74]. Per ogni sistema formale \(F\) coerente e capace di dimostrare gli enunciati veri della forma «esiste un programma più corto di \(c\) che stampa \(x\)» (l’aritmetica di Peano e ZFC lo sono) esiste una costante \(c_F\), dell’ordine della complessità di \(F\) stesso, tale che \(F\) non dimostra \(K(x) > c_F\) per nessuna stringa.
Il paradosso che ne esce va enunciato in due pezzi, perché sono due fatti diversi. Che quasi tutte le stringhe siano incomprimibili è un conteggio da una riga: i programmi più corti di \(n\) bit sono meno delle stringhe lunghe \(n\), e quindi la maggior parte delle stringhe non ne ha uno. Che di nessuna, oltre la soglia \(c_F\), lo si possa dimostrare è il risultato di Chaitin.
Sono da tenere distinti, infine, \(K(x)\) e la quantità di struttura di \(x\): una stringa casuale ha \(K\) massimo e struttura nulla. \(K(x)\) da sola non dice dove passa il confine fra la regola e il rumore; a separarli è la lunghezza minima in due parti, ed è il mestiere della funzione di struttura di Kolmogorov. Non è un’osservazione oziosa: MDL, il criterio pratico che ne discende, nasce nei primi lavori di Rissanen come codice in due parti, ed è per quello che serve a scegliere un modello mentre \(K\) da sola non servirebbe. Le formulazioni successive sostituiscono i due pezzi con un codice unico per tutta la famiglia di modelli (una mistura bayesiana, la massima verosimiglianza normalizzata, il codice prequenziale che si incontra più avanti), e Peter Grünwald le raccoglie sotto il nome di MDL raffinato [Grunwald04].
La dettatura più corta è il rasoio di Occam in una forma che si può mettere in un programma: fra due spiegazioni degli stessi dati vince quella che si detta in meno parole. La sezione sull’overfitting aveva enunciato il rasoio come massima («a parità di spiegazione, vince la più semplice») e poi l’aveva reso operativo con la regolarizzazione, che penalizza i pesi grandi. La complessità di Kolmogorov dice qual è la penalità giusta: la lunghezza della descrizione.
Da lì nascono due criteri che si usano davvero, perché al posto della macchina universale mettono una famiglia di modelli concreta. La lunghezza minima di descrizione, o MDL, sceglie il modello, cioè i parametri \(\theta\), che minimizza la somma di due lunghezze in bit, quella del modello e quella dei dati \(x\) scritti con quel modello, \(\hat{\theta} = \arg\min_\theta \big[L(\theta) + L(x \mid \theta)\big]\) [Ris78]; il messaggio di lunghezza minima, o MML, era arrivato dieci anni prima allo stesso posto partendo dalle probabilità che si assegnano ai modelli prima di vedere i dati, cioè per una via bayesiana [WB68]. È la stessa contabilità dell’esperimento della lingua a quattro lettere, dove il modello di ordine 2 perdeva perché il suo costo non era ripagato dai dati.
Mezzo milione di euro per un file più piccolo#
Se comprimere è capire, allora un concorso di compressione è un esame di intelligenza. Qualcuno l’ha preso alla lettera.
Matt Mahoney lo propose come test in un intervento del 1999 il cui titolo è già l’argomento: la compressione di testo come prova per l’intelligenza artificiale [Mah99]. Il ragionamento è che per predire la parola successiva in un testo scritto da persone bisogna sapere di che cosa parla, quindi un compressore che batte tutti gli altri su testo naturale deve avere dentro qualcosa che somigli a una conoscenza del mondo.
Nel 2006 Marcus Hutter ci ha messo i soldi. Il premio che porta il suo nome
paga chi comprime un ritaglio di Wikipedia meglio di chi l’ha preceduto:
all’inizio cento megabyte, dal 2020 un miliardo di byte, in un file che si
chiama enwik9. Il montepremi è passato da cinquantamila a cinquecentomila
euro, nominali: chi accorcia il record dell’\(x\%\) ne riceve l’\(x\%\), cioè
cinquemila euro per ogni punto percentuale, e sotto l’uno per cento non si
incassa niente. La taglia non è casuale, e il premio rimanda per quella scelta
a una stima di Mahoney: un gigabyte è all’incirca la lingua che una persona
elabora in una vita, fra letta, scritta, detta e ascoltata. La motivazione
dichiarata è esattamente quella tesi: se comprimi il testo meglio dei tuoi
predecessori, il tuo programma con ogni probabilità è più intelligente dei
loro.
Hutter non si è fermato al premio. Insieme a Shane Legg ha proposto una definizione formale di intelligenza, l’intelligenza universale, costruita esattamente su questi ingredienti [LH07]: la capacità di un agente di raggiungere obiettivi in una gamma molto ampia di ambienti, con gli ambienti pesati in base alla loro semplicità.
Un esame fatto di tutti i mondi possibili. In ciascuno l’agente deve cavarsela, guadagnando punti, e alla fine si fa la somma. Ma i mondi non contano tutti uguale: quelli che si descrivono in poche righe pesano molto, quelli che chiedono un trattato quasi niente, e ogni domanda da sì o no che serve in più per descriverli dimezza il peso. Intelligente, per questo esame, è chi va bene soprattutto nei mondi semplici.
Il voto però dipende dalla lingua in cui si scrivono le descrizioni: cambiandola cambia quali mondi sembrano semplici, e due agenti possono scambiarsi di posto in classifica. E l’esame non lo si può correggere davvero: i mondi sono infiniti, e la descrizione più corta di ciascuno, come per i fogli di cifre, non si sa calcolare.
L’intelligenza universale di un agente \(\pi\) è
dove \(E\) è l’insieme degli ambienti computabili con ricompensa totale limitata, \(V^{\pi}_{\mu} = \mathbb{E}\big[\sum_i r_i\big] \le 1\) è la ricompensa totale attesa che \(\pi\) accumula nell’ambiente \(\mu\), e \(2^{-K(\mu)}\) il peso, con \(K\) la complessità di Kolmogorov rispetto a una macchina di riferimento \(U\). Due condizioni pesano sul risultato. \(\Upsilon\) non è computabile, perché non lo è \(K\). E dipende da \(U\): la costante additiva del teorema di invarianza diventa un fattore moltiplicativo sui pesi, e gli autori riconoscono che cambiando la macchina di riferimento l’ordine fra due agenti può cambiare, un problema che lasciano aperto.
È il rasoio di Occam messo dentro la definizione di intelligenza, e con esso il presupposto che il mondo sia fatto in modo da premiare le ipotesi corte.
Comprimere insieme: l’argomento di Sutskever#
Fin qui la compressione è stata un metro: dice quanto un modello ha capito, e non dice perché un modello che impara a indovinare parole coperte finisca col saperne di biologia. La mossa che colma quel salto viene da un intervento di Ilya Sutskever, An Observation on Generalization, tenuto al Simons Institute di Berkeley il 14 agosto 2023 [Sut23], di cui non esiste una versione scritta. Per seguirla bastano gli strumenti già messi in fila: la previsione come compressione, la dettatura più corta, il rasoio di Occam in bit.
Il problema è questo. L’apprendimento supervisionato ha una teoria della generalizzazione: se l’errore sull’insieme di addestramento è basso e gli esempi sono molti rispetto alla capacità della famiglia di modelli (misurata, per esempio, dalla dimensione VC o dalla complessità di Rademacher), l’errore su dati nuovi è basso anche lui, con alta probabilità. Ne dà le garanzie la teoria dell’apprendimento, e c’è una condizione che si dimentica sempre di dire e che regge tutto: gli esempi di prova e quelli di addestramento devono essere estratti, indipendentemente, dalla stessa distribuzione. Rispettata quella, il teorema si applica, e raccogliere più dati è una strada sicura.
L’auto-supervisione no. Lì si ottimizza un obiettivo (indovinare la parola coperta) e ci si aspetta che ne migliori un altro del tutto diverso (rispondere a domande di biologia), senza che nessuna ragione ovvia dica perché debba succedere. Ottimizzi una cosa, te ne interessa un’altra, e la seconda migliora: detta così ha l’aria di un trucco di prestigio. La teoria non era debole: proprio non c’era.
Prima mossa: un caso in cui la garanzia c’è. Esiste un modo di imparare senza etichette che, come il supervisionato, deve funzionare, e il suo esempio più antico è il cifrario a sostituzione, quello in cui a ogni lettera se ne mette un’altra. Nessuno ti dà la chiave. Eppure su un messaggio abbastanza lungo la chiave si trova lo stesso, perché la lingua in chiaro ha le sue abitudini (certe lettere frequenti, certe coppie che ricorrono, certe altre che non compaiono mai) e c’è un solo modo di rimettere le lettere a posto che le rispetti tutte quante. Non hai avuto nemmeno un esempio risolto da cui imparare: ti è bastato pretendere che il risultato somigliasse a della lingua vera.
Quel gesto si generalizza, e si chiama far combaciare le distribuzioni. Prendi due mucchi di dati che non si corrispondono, per esempio frasi inglesi da una parte e frasi francesi dall’altra, che non sono le traduzioni le une delle altre; poi cerca la trasformazione che, applicata al primo mucchio, produce qualcosa che statisticamente somiglia al secondo. Detta così sembra una pretesa debole, e invece con frasi lunghe è durissima: le condizioni da rispettare sono tantissime, e possono bastare a determinare quasi del tutto la trasformazione. Sutskever racconta di esserci arrivato per conto suo nel 2015 e di essersene entusiasmato proprio per questo: era la prima volta che di apprendimento non supervisionato si poteva dire qualcosa di matematicamente serio.
Il difetto è che è un caso artificiale. Nessuno addestra così, e serve un’ipotesi forte, cioè che una trasformazione semplice esista. La seconda mossa toglie l’artificio, e la parte notevole è che contiene la prima.
Si parte domani, e le valigie da fare sono due. Nella prima ci va un mucchio di roba qualsiasi, tantissima, che in sé non ti interessa; nella seconda la cosa che ti serve davvero, ed è poca.
Se le fai insieme, in un bagaglio solo, quello che serviva a tutte e due (il caricabatterie, il dentifricio, l’adattatore della spina) lo porti una volta invece che due, e il bagaglio unico pesa meno della somma dei due. Se le due valigie non avevano niente in comune, pesa esattamente quanto i due separati, e non hai perso niente a provare.
Lo stesso peso si può contare anche in un altro ordine: prima la valigia grande da sola, poi quel che resta da aggiungere per la piccola, a grande già chiusa. Se la piccola non aggiunge niente, viaggia gratis. I due conti danno lo stesso risultato, a parte i pochi grammi che costa ricontrollare che cosa c’è già dentro, e quei grammi non raddoppiano se raddoppia la roba.
Il secondo modo di contare, però, nessuno lo sa fare direttamente: «quel che resta da aggiungere» dipende da che cosa ti chiederanno all’arrivo, e quando chiudi il bagaglio non lo sai ancora. Sai fare l’altro, mettere dentro tutto e farlo pesare il meno possibile; e siccome i due conti danno lo stesso peso, chi fa bene il bagaglio unico ha fatto bene, senza saperlo, anche la parte che riguarda la valigia piccola. Nel conto entrano anche le istruzioni per fare la valigia, che pesano sempre uguale, comunque sia grande il carico.
Ecco: la roba tanta e in sé inutile è il testo di internet, la cosa poca che serve davvero è il compito a cui tieni, e fare un bagaglio solo è il pre-addestramento. Il peso è la lunghezza della descrizione compressa: un bagaglio leggero è un file corto, e un file corto lo scrive solo chi sa prevedere che cosa c’è dentro. Con una valigia fatta alla perfezione sarebbe una scommessa che nel peggiore dei casi va in pari; chi la fa davvero, però, perfetto non è, e può capitare che riempia male. Quanto ci guadagni è quanto la prima valigia conteneva già della seconda, e non lo decidi tu: lo decide il mondo, cioè se davvero il testo scritto dalle persone contiene qualcosa della biologia.
E c’è un secondo pezzo. Chi fa la valigia, qui, è la discesa del gradiente e non una persona che ragiona: è il metodo con cui una rete aggiusta a piccoli passi i propri pesi. La stessa rete, con pesi diversi, esegue procedimenti diversi: i pesi sono il suo programma, e lei la macchina che lo esegue. Addestrarla è come cercare, fra i tanti modi possibili di fare quella valigia, quello che occupa meno spazio. È una ricerca cieca e limitata, ma è una ricerca fra programmi, e tutto quello che si è detto sulle ricette corte torna a valere.
E qui c’è, secondo Sutskever, una ragione per cui le reti grandi funzionano meglio, e non ha niente a che vedere con l’avere più memoria: una rete più grande prova più modi di fare la valigia, quindi si avvicina di più a quello ideale, che nessuno può battere.
Il caso facile, in forma. Dati due corpora non appaiati, si cerca \(F\) tale che \(\operatorname{distr}(F(X)) \approx \operatorname{distr}(Y)\). Il vincolo stringe tanto più quanto più le realizzazioni sono ad alta dimensione: il numero di condizioni che \(F\) deve soddisfare cresce con la dimensione, i suoi gradi di libertà no, e quando le prime superano i secondi la soluzione tende a essere unica. È il conto che rende risolvibili i cifrari a sostituzione, ed è un argomento di plausibilità e non un teorema: più vincoli che incognite danno sovradeterminazione, non unicità, e restano comunque le simmetrie della distribuzione bersaglio. L’ipotesi forte, e il motivo per cui il caso resta artificiale, è che una \(F\) semplice esista.
Sia ora \(X\) il corpus non etichettato e \(Y\) i dati del compito a valle. L’ideale teorico dell’apprendimento non supervisionato, nella lettura di Sutskever, è la complessità di Kolmogorov condizionata \(K(Y \mid X)\): il programma più corto che stampa \(Y\) avendo \(X\) a disposizione come ingresso ausiliario. Per ogni compressore \(C\) che possa usare \(X\) vale, come sopra,
quindi \(K(Y \mid X)\) è la soluzione a rimpianto minimo: nessuna procedura può estrarre da \(X\) più di così per aiutare \(Y\).
Il passaggio operativo è la regola della catena per la complessità algoritmica,
dove il termine d’errore va inteso nei due sensi (nella forma con errore costante il condizionale si prende rispetto al programma più corto di \(X\) e non a \(X\) nudo, cioè \(K(X,Y) = K(X) + K(Y \mid X^*) + O(1)\)). Si legge così: comprimere \(X\) e \(Y\) insieme non è sostanzialmente diverso dal comprimere prima \(X\) e poi \(Y\) sfruttando \(X\). Da qui la mossa pratica: un condizionale non lo si sa addestrare, un congiunto sì, ed è esattamente ciò che fa la massima verosimiglianza su un corpus grande. Scritta in bit, e con la fattorizzazione autoregressiva che un transformer usa davvero,
che una codifica aritmetica trasforma in un file lungo altrettanto, a meno di un paio di bit di arrotondamento: la perdita che si minimizza addestrando e la lunghezza di descrizione sono lo stesso numero, ed è la ragione per cui qui si scrivono con la stessa lettera. Il teorema di codifica di sorgente da solo non basterebbe, perché parla della lunghezza attesa e dà una disuguaglianza, non un’uguaglianza su una stringa particolare. (Qui \(L(\cdot)\) è una lunghezza in bit, non la dimensione di un latente; e \(X\) e \(Y\) sono stringhe, non matrici: restano tonde.)
Il passaggio che chiude l’argomento va scritto per esteso, perché dalla regola della catena non segue da solo: minimizzare \(K(X,Y)\) non dice come il totale si ripartisca fra i due addendi. Sia \(C\) un compressore con rimpianto \(\varepsilon\) sul congiunto, cioè \(|C(X,Y)| \le K(X,Y) + \varepsilon\). Per la regola della catena il secondo membro vale \(K(X) + K(Y \mid X) + \varepsilon\), a meno del termine logaritmico; e siccome la disuguaglianza di prima dà \(|C(X)| \ge K(X) - K(C) - O(1)\), il costo incrementale di aggiungere \(Y\) a un \(X\) già compresso soddisfa
Qui \(C\) va inteso come il programma che addestra il modello e comprime con il codice prequenziale del paragrafo sul prezzo del modello: la sua descrizione (architettura, algoritmo di addestramento, seme) non cresce con i dati. Se invece i pesi addestrati facessero parte di \(C\), \(K(C)\) li conterrebbe e potrebbe arrivare alla dimensione dei dati, che è esattamente il caso del codice in due parti discusso là. Con quella lettura, dei due termini che si aggiungono a \(\varepsilon\) uno è una costante vera, la descrizione del compressore; l’altro, quello della regola della catena, cresce come il logaritmo dei dati. Nessuno dei due cresce quanto i dati stessi, ed è quello che serve: diviso per la lunghezza di \(Y\), il sovrapprezzo tende a zero, purché \(|Y|\) cresca più in fretta di \(\log K(X, Y)\). È qui che il rimpianto sul congiunto, che si sa minimizzare addestrando, diventa rimpianto sul condizionale, che è quello che interessa; e qui il rimpianto prende la sua forma, \(|C(Y \mid X)| - K(Y \mid X)\), cioè quanti bit in più del necessario si sono spesi per \(Y\) avendo \(X\) in mano.
Il secondo pilastro dell’argomento è che la rete è una macchina e la discesa del gradiente è una ricerca nello spazio dei programmi che quella macchina può eseguire: una ricerca debolissima rispetto all’enumerazione universale, ma sufficiente a rendere non vuoto il richiamo alla teoria algoritmica. Da qui la lettura di Sutskever del perché le reti grandi funzionino: più sono grandi, più si avvicinano al compressore di Kolmogorov, e quindi meno rimpianto hanno.
Il rimpianto, che è la parte che regge tutto#
La parola tecnica dell’argomento è rimpianto, ed è la stessa che Quando i dati cambiano usa per chi impara un esempio alla volta: là misurava quanto un algoritmo che impara strada facendo sbaglia in più della migliore scelta fissa, vista col senno di poi. Qui misura quanti bit un compressore spende in più del migliore possibile: \(|C(Y \mid X)| - K(Y \mid X)\) per scrivere i dati \(Y\) del compito avendo in mano i dati non etichettati \(X\). È la quantità che mette l’auto-supervisione alla pari col supervisionato, ed è anche la più fraintesa.
Il rimpianto non misura quanto sei bravo: misura quanta parte del valore contenuto nei dati non etichettati ti sei lasciato sfuggire. Avere rimpianto basso vuol dire che nessun altro, con un compressore migliore del tuo, avrebbe potuto cavare da quei dati più aiuto di quanto ne hai cavato tu.
La forza sta in quello che questa garanzia non richiede. Non richiede che i dati non etichettati siano utili. Possono contenere la risposta, oppure essere inservibili, oppure non contenere niente del tutto (al limite, simboli estratti a caso con probabilità uguali): tu non lo sai, e non c’è modo di saperlo in anticipo. Ma con un algoritmo a rimpianto basso, dice Sutskever, in tutti i casi puoi dormire tranquillo, perché sai di aver fatto il meglio che si poteva fare con quello che avevi. È un tipo di garanzia diverso da quello del supervisionato, e altrettanto solido: là si garantisce un risultato, qui si garantisce di non aver sprecato niente.
Questa garanzia, però, non porta con sé tutto. Il «peggio che va, si va in pari» è una proprietà del compressore ideale, che per definizione non fa mai peggio del meglio possibile. Una rete vera, cercata con la discesa del gradiente, quella garanzia non ce l’ha: capita che un pre-addestramento su dati estranei lasci il modello peggiore di come sarebbe partito. Rimpianto basso è la proprietà che si vorrebbe; che una rete ce l’abbia nessuno l’ha dimostrato, ed è un’ipotesi, non un risultato.
Ed è anche la risposta all’obiezione che si fa da sempre, e che suona così: e se in quei dati non ci fosse proprio niente? Se le lettere uscissero da un’urna, a caso, ogni algoritmo auto-supervisionato fallirebbe, e non sarebbe un difetto dell’algoritmo: non c’è niente da imparare. Il rimpianto è la quantità che distingue le due cose, cioè «non ho trovato niente perché non sono capace» da «non ho trovato niente perché non c’era niente».
E il rimpianto ha un fratello, cioè la quantità di cui misura lo spreco. Il divario fra il comprimere insieme e il comprimere separatamente ha un nome proprio, informazione mutua algoritmica, ed è alla lettera quanto i dati non etichettati contengono già del compito a cui si tiene. Quel divario è il massimo che il pre-addestramento possa fruttare: un compressore migliore ne estrae di più, nessun compressore può inventarne dove non ce n’è, e il rimpianto è quanto se ne è lasciato sul piatto.
Un corollario inatteso, sulle architetture
Se una rete è una macchina che ne può simulare un’altra pagandone la descrizione, allora inventare un’architettura migliore deve essere difficile, e per una ragione precisa: quasi ogni architettura nuova la vecchia la sa già imitare, quindi il guadagno è nullo. I salti veri capitano solo quando la simulazione è preclusa da un collo di bottiglia strutturale. L’esempio che Sutskever porta è il passaggio dalle reti ricorrenti al transformer: una ricorrente fatica a implementare un transformer perché tutto il passato le deve passare attraverso uno stato nascosto di dimensione fissa. E aggiunge la conseguenza più interessante: con uno stato nascosto abbastanza grande, forse una ricorrente tornerebbe competitiva. Sono, alla lettera, i due capitoli sull’attenzione lineare e sugli state space model, che quella strada la percorrono davvero.
Perché la prova va cercata nelle immagini#
L’obiezione più seria a questa tesi è anche quella che se ne cita di meno, e gliela muove per primo chi l’ha proposta. Sui modelli di linguaggio la teoria della compressione non si può mettere alla prova, perché il loro comportamento si spiega anche senza di essa: sono la distribuzione condizionata del testo che sta in rete, e l’apprendimento da pochi esempi si racconta dicendo che un documento con uno schema ripetuto tende a continuare con quello schema. Nessuna compressione, e la spiegazione regge lo stesso. Peggio: nel testo qualunque compito si riscrive come previsione della parola successiva, quindi lì supervisionato e auto-supervisionato si somigliano in modo superficiale.
Serviva un dominio in cui quella scorciatoia non fosse disponibile, e il dominio sono le immagini. Da lì nasce iGPT [CRC+20]: si prende un’immagine, la si stende in una sequenza di pixel, si riduce ogni pixel a uno di cinquecentododici colori e si addestra un transformer a indovinare il pixel successivo. Nient’altro, esattamente il compito dei modelli di linguaggio con i pixel al posto delle parole. Poi si blocca la rete perché non impari più, si sceglie lo strato che dà i risultati migliori, ci si appoggia sopra un classificatore lineare e si guarda quanto va. Su CIFAR-10, una raccolta di sessantamila immagini da 32 pixel per lato divise in dieci categorie, quel sondaggio lineare arriva al \(96{,}3\%\), meglio di una rete convoluzionale addestrata con le etichette; e le due curve, quella della bravura a indovinare il pixel dopo e quella del classificatore lineare, salgono insieme. È il punto: migliora il predittore e migliora la rappresentazione, senza che nessuno abbia mai detto alla rete che cosa sia un gatto. (Scongelando la rete e rifinendola per intero si arriva al \(99{,}0\%\), ma quello diventa addestramento con le etichette invece che un sondaggio, e non dimostra la stessa cosa.)
Sutskever lo presenta per quello che è, una prova di principio costosa e non un metodo pratico. Il modello che dà quel \(96{,}3\%\) ha un miliardo e quattrocento milioni di parametri e lavora sui 32 pixel per lato che CIFAR-10 ha di suo. Su ImageNet, dove le immagini vanno rimpicciolite per entrare nel contesto, lo stesso modello arriva al \(69{,}0\%\) di sondaggio lineare solo comprimendo l’ingresso e concatenando le uscite di più strati: vicino ai metodi contrastivi dell’epoca, ma sotto i migliori.
Resta un pezzo che la teoria non spiega, e Sutskever lo dice in chiaro: la compressione non richiede affatto che le rappresentazioni interne diventino linearmente separabili, cioè che basti un classificatore lineare per leggerle. Quella arriva in più, non è una conseguenza; quello che la teoria predice è che il modello si lasci rifinire bene, perché comprimere insieme è già una rifinitura approssimativa fatta con un cercatore mediocre. Eppure la separabilità lineare si presenta sempre, ed è la proprietà su cui poggia tutta la pratica del sondaggio lineare, quella di Il collasso e la misura.
C’è persino un fatto in più, misurato e non spiegato: i modelli che indovinano il pixel successivo producono rappresentazioni lineari migliori di quelli addestrati a mascherare alla maniera di BERT. La spiegazione che Sutskever azzarda è che coprirne una frazione, il quindici per cento nell’esperimento, lasci quasi tutte le previsioni risolvibili guardando un po’ prima e un po’ dopo, mentre indovinare il pixel successivo obbliga a tenere insieme la struttura lontana: cambia la difficoltà della previsione più difficile. E, rispondendo a una domanda, aggiunge che lo stesso sospetto dovrebbe valere per i modelli di diffusione, il che, se vero, rende il mistero più grande invece che più piccolo.
Una nota sulla fonte, che è di un tipo raro. Quello di Berkeley è un intervento parlato, seguito dalle domande del pubblico, non un articolo sottoposto a revisione: le sue formule stanno in diapositive commentate a voce, e alcune affermazioni sui limiti della teoria (il costo di calcolo, i modelli di diffusione, l’ordine dei dati) vengono dalle risposte alle domande, non dalla relazione. Le disuguaglianze però non dipendono da lì: sono di Kolmogorov e Solomonoff, e stanno nei testi di riferimento del settore [LVitanyi19]. Quello che l’intervento aggiunge, ed è la ragione per cui se ne parla, è il gesto di puntarle sul pre-addestramento.
Le prove, e quanto valgono#
Fin qui la tesi. Dal 2023 esistono due misure che la mettono alla prova, e dicono cose diverse. La prima chiede quanto sia bravo un modello di linguaggio usato come compressore, anche fuori dal proprio mestiere [DeletangRD+24]; la seconda chiede l’inverso, se fra modelli diversi chi comprime meglio sia anche più bravo [HZSH24].
Un gruppo di DeepMind ha preso un modello di linguaggio grande, addestrato
quasi soltanto su testo, e gli ha fatto fare il compressore: il modello dice
quanto si aspetta ogni pezzo, e un congegno trasforma le sue attese in bit,
come nel conto delle sorprese (pezzo atteso, pochi bit; pezzo inatteso, tanti).
Sul gigabyte di Wikipedia il file scende a meno di un decimo, dove gzip, il
compressore che c’è su ogni calcolatore, si ferma a quasi la metà: è testo, ed
è il suo mestiere, anche se un po” di quella Wikipedia l’aveva già letta
durante l’addestramento.
La sorpresa è che batte i formati fatti apposta anche su pezzetti di fotografie e di registrazioni di voce, che fra le sue letture quasi certamente non c’erano. Ma i pezzetti sono corti, e su pezzetti così corti il formato per le immagini rende meno di quanto potrebbe; e nel conto non c’è il peso del modello, che è la questione più seria di tutte. C’è anche una prova di controllo: su dati scritti a caso il file cresce, perché dove non c’è struttura nessuno comprime niente.
La seconda misura ha preso trentuno modelli di linguaggio pubblici, ha guardato quanto ciascuno comprime testi scritti dopo il suo addestramento, che quindi non poteva aver letto, e ha messo quel numero accanto ai voti dello stesso modello in dodici prove d’esame. Chi comprime meglio prende voti migliori, quasi in linea retta.
Delétang e colleghi mettono Chinchilla, settanta miliardi di parametri
addestrati essenzialmente su testo, a fare il predittore dentro un codificatore
aritmetico. Tutti i conti sono fatti su blocchi da 2048 byte, quanto il
modello guarda in una volta: per ImageNet sono rettangoli di 32 per 64 pixel in
scala di grigio, per LibriSpeech circa 64 millisecondi di parlato. Su enwik9
il modello scende all’\(8{,}3\%\) della dimensione originale, contro il
\(48{,}1\%\) di gzip sugli stessi blocchi. Con una riserva: l’addestramento di
Chinchilla comprende Wikipedia, e enwik9 è un’istantanea di Wikipedia, quindi
quell’\(8{,}3\%\) non è la compressione di un testo certamente mai visto.
Su ImageNet il modello scende al \(48{,}0\%\) dove PNG si ferma al \(61{,}7\%\), e su LibriSpeech al \(21{,}0\%\) dove FLAC si ferma al \(30{,}3\%\), sempre a blocchi. Che immagini e suoni ci fossero nei dati di addestramento, codificati in caratteri da qualche pagina, gli autori lo ritengono possibile ma improbabile. Sui blocchi corti PNG rende meno di quanto potrebbe (sull’immagine intera scende al \(58{,}5\%\)), FLAC no (sul file intero sale al \(30{,}9\%\)), e il confronto vale per quelle condizioni. Su dati casuali lo stesso modello dà \(100{,}8\%\), cioè il file cresce: dove non c’è struttura non c’è compressione, per nessuno.
Una discrepanza dentro l’articolo, dichiarata
L’abstract e l’introduzione di quell’articolo riportano per il modello \(43{,}4\%\) su ImageNet e \(16{,}4\%\) su LibriSpeech, contro \(58{,}5\%\) di PNG e \(30{,}3\%\) di FLAC; la tabella 1 dello stesso articolo dà invece \(48{,}0\%\) e \(21{,}0\%\), e i due numeri dell’abstract non ricompaiono in nessuna cella. Il ritaglio non li spiega: nella tabella il modello compare solo a blocchi da 2048 byte. E i due termini di confronto dell’abstract vengono da condizioni diverse: \(58{,}5\%\) è PNG sull’immagine intera (a blocchi vale \(61{,}7\%\)), \(30{,}3\%\) è FLAC a blocchi (sul file intero vale \(30{,}9\%\)). Qui si usano i numeri della tabella a blocchi, i soli confrontabili riga per riga alle stesse condizioni: il modello batte PNG di \(13{,}7\) punti e FLAC di \(9{,}3\). Il verso della conclusione non cambia con nessuna delle coppie di numeri; la sua misura sì, e chi rifà il conto ha diritto di sapere quale ha in mano.
Huang e colleghi, quattro ricercatori fra la HKUST e Tencent, prendono trentuno modelli pubblici di organizzazioni diverse e confrontano due cose: quanto comprimono un corpus esterno (pagine web recenti per la conoscenza, codice Python per la programmazione, articoli di matematica per la matematica) e quanto vanno bene su dodici prove nelle stesse tre aree. I corpora sono scelti più recenti dei dati di addestramento dei modelli, per evitare che la compressione premi la memoria, e la misura è in bit per carattere, perché i bit per token non si confrontano fra tokenizzatori diversi. Il coefficiente di correlazione di Pearson fra bit per carattere e punteggio medio vale \(-0{,}931\) complessivamente, e area per area \(-0{,}935\) per la conoscenza, \(-0{,}937\) per il codice e \(-0{,}953\) per la matematica. Quel coefficiente vive fra \(-1\) e \(+1\) e tocca gli estremi solo quando i punti stanno esattamente su una retta, quindi \(-0{,}93\) è un legame forte; forte non vuol dire esatto, perché il suo quadrato dice che resta fuori circa un settimo della variabilità dei punteggi. Il segno è negativo perché meno bit vuol dire modello migliore.
Il secondo risultato è bello, e va letto per quello che è. Dice che, dentro la famiglia dei modelli linguistici di oggi, la compressione è un ottimo termometro: un numero che si ottiene da testo grezzo, senza etichette e senza costruire una prova d’esame, e che ordina i modelli come li ordinerebbero dodici prove d’esame. Non dice che comprimere sia essere intelligenti, per la stessa ragione per cui il fatto che le persone alte pesino di più non rende l’altezza una definizione di peso.
Il prezzo del modello#
L’obiezione più seria, che è anche il punto in cui l’argomento si separa dalle sue versioni entusiaste, è che un compressore va spedito insieme al file, altrimenti chi riceve non sa decomprimere. Nei conti di Delétang e colleghi e di Huang e colleghi il modello resta fuori, e i loro sono «bit per carattere» a modello dato. Nella lingua a quattro lettere, invece, lo era, perché il modello imparava leggendo e chi riceve poteva rifare gli stessi conteggi. Se lo si conta anche negli altri, la scena cambia in modo drammatico.
Io e te concordiamo un dizionario di abbreviazioni: «AS» sta per «apprendimento auto-supervisionato», e via così. I miei messaggi diventano molto più corti. Ma il dizionario qualcuno te lo deve dare, e se è più grosso di tutti i messaggi che ci scriveremo in vita nostra, nel complesso ho fatto crescere le cose invece di accorciarle.
È esattamente la posizione del modello da settanta miliardi di parametri. Ogni parametro è un numero, e per scriverlo servono almeno due byte: settanta miliardi di numeri fanno centoquaranta miliardi di byte, cioè centoquaranta gigabyte. Per scrivere il gigabyte di Wikipedia in ottantatré megabyte, meno di un decimo, devi prima consegnare quel dizionario lì. Contando tutto, quel modello non ha compresso Wikipedia: l’ha fatta diventare centoquaranta volte più grossa. Perché un dizionario così si ripaghi, il messaggio dovrebbe essere almeno mille volte più lungo.
C’è però un secondo modo di fare i conti, onesto con chi impara: invece di consegnare il dizionario, lo si costruisce strada facendo. Si chiama codice prequenziale, e funziona così. Io ti mando il primo pezzo di messaggio senza abbreviazioni, tu lo leggi, e a quel punto tutti e due abbiamo visto le stesse parole e possiamo ricavarne le stesse abbreviazioni, ciascuno per conto suo. Poi io mando il pezzo dopo, già abbreviato. Nessun dizionario viaggia mai, eppure alla fine ce l’abbiamo tutti e due uguale, e il prezzo di averlo costruito sta dentro i primi pezzi, che erano più lunghi.
Un’abbreviazione paga solo se indovina parole che nel messaggio devono ancora arrivare: quelle ritagliate sulle righe già lette non accorciano niente. Per questo all’inizio si va anche in perdita, e più il dizionario è capiente più si perde: dopo tre righe uno se lo riempie di sigle che non torneranno mai più, e quei primi pezzi costano più che scrivere tutto per esteso. Il debito si ripaga dopo, se il messaggio è abbastanza lungo.
È lo stesso conto della lingua a quattro lettere, dove il modello che guardava la lettera precedente spendeva quattro decimillesimi di bit in più di chi la regola la sapeva già. Quei quattro decimillesimi erano il dizionario, e nessuno l’ha spedito: se lo sono fabbricato tutti e due leggendo.
Il conto a modello dato è \(-\log_2 p_\theta(x)\) con \(\theta\) regalato, e non
una lunghezza di descrizione. La lunghezza di descrizione vera è
quella in due parti di MDL, \(L(\theta) + L(x \mid \theta)\), e su una rete grande
il primo termine domina tutto. Lo stesso articolo di DeepMind riporta la
colonna corretta per il codice in due parti: contando i parametri a due byte
l’uno, in mezza precisione, la resa di Chinchilla 70B su enwik9 passa da
\(8{,}3\%\) a \(14\,008{,}3\%\), cioè \((|C(x)| + 2P)/|x|\) con
\(P = 7 \cdot 10^{10}\) parametri [DeletangRD+24]. Gli autori
notano che con modelli così un rapporto corretto non banale si ottiene solo su
insiemi di dati dell’ordine dei terabyte, e che il codice prequenziale darebbe
risultati migliori per le reti con molti parametri; non lo misurano, perché
richiede di addestrare il modello in linea anche in decodifica, ed è troppo
costoso per quelle dimensioni.
La via d’uscita sta nel cambiare codice, più che nell’aggiustare il conto. Il codice prequenziale, o in linea, non trasmette mai i parametri. Fissati istanti di riaddestramento \(1 = t_0 < t_1 < \dots < t_S = n\), la lunghezza è
dove \(\hat\theta_{t_s}\) è il parametro appreso sui soli dati fino a \(t_s\) e \(|\mathcal{Y}|\) è il numero di etichette possibili, con cui si codifica alla cieca il primo blocco, quando ancora non si è addestrato niente [BO18]. Chi decodifica riesegue lo stesso addestramento sui dati che ha già ricevuto e ottiene gli stessi parametri: nulla va trasmesso, e il costo dell’apprendimento è pagato dai primi blocchi, quando il modello è ancora ignorante. (Nell’articolo quel numero di etichette si scrive \(K\): qui no, perché \(K\) è già la complessità di Kolmogorov.)
I numeri di quell’articolo sono la smentita più netta dell’idea che una rete con troppi parametri non possa comprimere. Su CIFAR-10, codificando le etichette dei cinquantamila esempi:
codice |
lunghezza |
rapporto |
accuratezza |
|---|---|---|---|
uniforme (\(50\,000 \log_2 10\)) |
166 kbit |
1 |
10% |
pesi in |
> 428 Mbit |
> 2500 |
92,9% |
variazionale |
89,0 kbit |
0,54 |
66,5% |
prequenziale |
45,3 kbit |
0,27 |
93,3% |
Due note sulla tabella, perché chi apre l’articolo le trova. La riga in due parti è un limite inferiore che conta i soli pesi e non i dati, ed è ripresa da un altro lavoro: non è la stessa rete della riga prequenziale, che è invece quella degli autori. E l’accuratezza della riga variazionale è quella della loro tabella; il corpo dello stesso articolo, in due punti, ne dà \(61{,}6\%\).
Resta che sono due reti convoluzionali che arrivano quasi allo stesso posto, \(92{,}9\%\) e \(93{,}3\%\), e che a parità di risultato una viene contata duemilacinquecento volte peggio del non fare niente e l’altra quasi quattro volte meglio. È la differenza fra «il deep learning contraddice il rasoio di Occam» e «il deep learning lo rispetta», e a deciderla è la scelta del codice, non il modello.
La ragione profonda è che il codice prequenziale misura la generalizzazione: è corto se e solo se il modello, a ogni dimensione dell’insieme visto, prevede bene i dati che ancora non ha visto. E ha un difetto noto, il fenomeno del ritardo: un’architettura grande all’inizio va in sovradattamento sui pochi dati disponibili, quindi i primi blocchi costano più del codice uniforme, e il debito si recupera solo dopo.
Che non sia una finezza da teorici lo dice il fatto che ci si arriva anche dalla parte opposta, e senza chiamarla per nome: se si addestra facendo una sola passata sui dati, basta sommare le log-probabilità man mano che l’addestramento procede, e quella somma è già la compressione dei dati fatta dal modello. È il codice prequenziale detto in una riga, ed è la stessa osservazione che Sutskever fa a Berkeley. Una sola passata vuol dire che ogni esempio viene predetto da un modello che non l’ha ancora visto, ed è esattamente la condizione che rende quel conto onesto.
Questa è la parte più istruttiva, e non riguarda solo la compressione. Due gruppi seri possono guardare la stessa rete addestrata e concludere che comprime magnificamente o che è un disastro, senza che nessuno dei due sbagli un conto: cambia che cosa si mette nel prezzo. Ogni volta che si legge «il modello X comprime al tot per cento», la domanda da fare è chi paga il modello, più che quanto.
Dove la tesi si ferma#
Un’idea affascinante va chiusa dicendo dove si rompe. Qui i punti sono sette, e i primi tre non vengono dai critici: li mette in conto Sutskever stesso, nelle risposte alle domande che seguono il suo intervento (uno, l’ordine dei dati, glielo pone una persona del pubblico, e lui lo accoglie).
La teoria ignora il costo di calcolo, ed è lui a chiamarla una debolezza pratica enorme: il conto è tutto in informazione e niente in tempo di macchina. La conseguenza è che dal punto di vista di questa teoria un modello autoregressivo, uno di diffusione e uno a energia sono la stessa cosa, a meno di un fattore dieci o quindici di calcolo; e siccome nessuno ha un fattore quindici da buttare, la scelta la fanno considerazioni di cui la teoria non sa niente. L’esempio che porta è il universal transformer, che riusa gli stessi pesi a ogni strato: ottima idea a guardare i bit, e nessuno la usa, perché quei parametri si pagano in calcolo.
L’analogia con la ricerca fra programmi è la parte più fragile. Per il compressore ideale l’ordine dei dati non conta: enumera tutti i programmi da capo ogni volta. Per una rete conta eccome, perché le scorciatoie imparate presto restano, e questo è un fatto sperimentale. L’obiezione è accolta senza attenuarla, e il punto di rottura è dichiarato: la procedura di ricerca, che nel caso ideale è infinitamente costosa e nel caso vero è la discesa del gradiente. Un’analogia da maneggiare con cautela, perché non vale universalmente.
E la teoria parla di un insieme di dati fisso. In teoria si comprime un file statico; nell’uso vero, dopo l’addestramento, arrivano dati nuovi che di fatto non finiscono mai, e Sutskever tratta l’insieme di prova come infinito. Se quello che si vuole comprimere non finisce mai, la dimensione del compressore smette di contare, perché la si divide per una quantità che cresce senza limite. Ecco perché il prezzo del modello è un’obiezione che vale su un file e non una che chiude la partita: e la sua forza dipende da una domanda che va posta ogni volta, cioè se il dato sia una cosa finita o un rubinetto aperto. Anche questa resta dichiarata come una discrepanza da chiarire, non come una cosa risolta.
Gli altri quattro sono quelli soliti, e uno lo abbiamo appena finito di guardare.
La contabilità, che è tutto il paragrafo sul prezzo del modello: senza specificare chi paga il modello, «comprime meglio» non è un’affermazione con un valore di verità.
Il fondo non è calcolabile. La complessità di Kolmogorov non è una procedura, quindi non esiste modo di sapere quanto si è lontani dall’ottimo: si sa solo confrontare due compressori fra loro. La teoria dà un metro e non dà mai una misura, e chi la usa come se desse una misura sta dicendo più di quel che ha.
L’intelligenza, in gran parte, è compressione con perdita, e tutto ciò di cui si è parlato qui è senza perdita. Un modello utile butta via il colore esatto del pixel in alto a sinistra e tiene «c’è un gatto»; un compressore senza perdita deve tenere anche il pixel. Ed è la stessa cosa che diceva Borges: pensare è dimenticare differenze. La lettura in termini di compressione senza perdita, presa alla lettera, chiede a un modello di ricordarne di più, cioè di essere un po’ più Funes. Che poi il pre-addestramento funzioni lo stesso è un fatto, e resta parzialmente non spiegato.
E c’è chi misura con un altro metro. È l’obiezione più profonda, e viene da chi ha proposto una definizione alternativa. Nella lettura di François Chollet, l’intelligenza non è un’abilità ma l’efficienza con cui si acquistano abilità nuove, misurata tenendo conto dell’esperienza e delle conoscenze pregresse che sono servite [Cho19]. Con quel metro, un sistema che ha letto tutto internet e comprime benissimo può avere un’intelligenza bassa, perché ha pagato carissima ogni abilità che ha; e la prova che Chollet ha costruito su questa definizione chiede proprio di risolvere problemi mai visti con pochissimi esempi. Le due letture non si contraddicono su nessun fatto: contraddicono l’una il vocabolario dell’altra, e conviene tenere presente che quando due persone discutono se un modello sia intelligente, spesso stanno usando due metri diversi senza dirlo.
Conviene aggiungere una cosa che nessuna delle due letture nega, ed è forse la conclusione più solida della pagina. Quanto ci si avvicini al fondo di una sorgente dipende da chi comprime, e l’esperimento d’apertura lo ha misurato quattro volte sulla stessa lingua. Ma che un fondo ci sia, e che stia sotto la dimensione dei dati grezzi, non dipende da nessuno: lo dice la riga dei dati casuali, quel \(100{,}8\%\), dove il fondo coincide con il grezzo e non c’è niente da guadagnare per nessuno. Se l’universo che ci circonda non fosse pieno di regolarità, saremmo tutti in quella riga lì, e nessuna intelligenza di nessun tipo sarebbe possibile. La comprimibilità, prima che una proprietà della mente che comprime, è una proprietà del mondo: che comprimere funzioni è, prima di tutto, un’informazione su dove abitiamo.
Da ricordare
Il personaggio di Borges che ricorda tutto non riesce a pensare, perché pensare vuol dire dimenticare le differenze che non contano. Un modello che impara a memoria gli esempi ha lo stesso problema.
Prevedere bene e comprimere bene sono la stessa cosa: chi sa che cosa aspettarsi può scrivere le sorprese invece delle parole, e le sorprese sono poche. Era già stabilito nei richiami di matematica, e il conto si fa così per i modelli che indovinano la parola dopo, non per tutti gli esercizi dell’auto-supervisione.
Per ogni sorgente esiste un fondo: nessun compressore, in media, può spendere meno di così, e ci arriva solo chi ha la forma giusta per ospitarne la regola. Nella lingua a quattro lettere ci arriva il modello che guarda la lettera precedente; quello che ne ricorda due paga e non rende, e
zlibelzma, che cercano ripetizioni, restano a metà strada. È il rasoio di Occam, misurato in bit.Da qui la tesi: comprimere bene è capire. C’è chi ci ha messo cinquecentomila euro di premio per chi comprime Wikipedia meglio dei predecessori, e chi l’ha usata per spiegare perché il pre-addestramento funziona.
La garanzia non è «funzionerà», è «non ho sprecato niente»: nessuno, con un compressore migliore del mio, avrebbe cavato da quei dati più aiuto di quanto ne ho cavato io. Vale anche quando i dati non contengono niente di utile, ed è per questo che è seria; vale però per la valigia fatta alla perfezione, e che una rete la faccia così si spera, non si è dimostrato.
Le prove ci sono: un modello di linguaggio addestrato su testo comprime, a pezzetti corti, immagini e suoni meglio dei formati fatti apposta (gli autori ritengono improbabile che ne avesse visti), e fra trentun modelli chi comprime meglio va meglio anche a scuola. La prova cercata apposta è del 2020: una rete addestrata solo a indovinare il pixel dopo impara da sola a riconoscere quello che c’è nelle figure, e più ci diventa brava, meglio le riconosce.
Ma bisogna guardare chi paga il dizionario. Contando anche il modello che serve a leggerlo, quello da settanta miliardi di parametri non ha rimpicciolito Wikipedia: l’ha fatta crescere di centoquaranta volte. Il conto torna solo se il modello si costruisce mentre si legge, senza spedirlo mai.
E resta un punto scomodo: pensare è dimenticare, mentre qui si è parlato sempre di compressione che non perde niente. Su questo la tesi non ha ancora una risposta.
Da ricordare
La cross-entropia è una lunghezza di codice solo per i modelli che danno una probabilità alla sequenza intera, cioè gli autoregressivi: il linguaggio mascherato dà una pseudo-verosimiglianza, e le perdite contrastive, a distillazione e a ridondanza non definiscono nessun codice. La lettura in termini di compressione riguarda il pre-addestramento generativo.
La complessità di Kolmogorov \(K(x)\) (nella variante prefix) è la lunghezza del programma più corto che stampa \(x\); è definita a meno di una costante additiva (teorema di invarianza), limita dal basso ogni compressore reale (\(K(x) \le |C(x)| + K(C) + O(1)\)), sta in media sopra l’entropia di Shannon e la supera al più di \(K(P)\) per sorgenti computabili, e non è computabile; la variante prefix serve alla disuguaglianza di Kraft, al legame con l’entropia e alla regola della catena con errore costante. Il teorema di codifica di Levin, \(-\log_2 m(x) = K(x) + O(1)\) per la probabilità a priori universale \(m\), dice che prevedere con \(m\) e comprimere coincidono a meno di una costante. Tre proposte indipendenti: [Sol64], [Kol65], [Cha66].
MDL [Ris78] e MML [WB68] sono la forma praticabile dello stesso criterio: si minimizza \(L(\theta) + L(x \mid \theta)\) su una famiglia di modelli invece che su una macchina universale, nella forma in due parti dei primi lavori; l’MDL raffinato usa un codice unico per tutta la famiglia (mistura bayesiana, massima verosimiglianza normalizzata, prequenziale) [Grunwald04]. È il rasoio di Occam reso operativo, e la lingua a quattro lettere lo mostra: il modello di ordine 2 spende \(1{,}4411\) contro \(1{,}4402\) dell’ordine 1, perché ha sedici contesti da stimare e nessuna struttura in più da catturare.
L’argomento di Sutskever [Sut23] in due mosse. La prima è il far combaciare le distribuzioni: cercare \(F\) con \(\operatorname{distr}(F(X)) \approx \operatorname{distr}(Y)\) su due corpora non appaiati è un compito non supervisionato che, come il supervisionato, deve riuscire, se la dimensionalità è alta abbastanza da rendere il vincolo quasi determinante (i cifrari a sostituzione cadono così). La seconda, che contiene la prima, è la compressione congiunta: l’ideale è \(K(Y \mid X)\), ma per la regola della catena \(K(X,Y) = K(X) + K(Y \mid X) \pm O(\log K(X,Y))\), quindi basta comprimere tutto insieme, che è ciò che fa la massima verosimiglianza su un corpus grande; il passaggio da fare per esteso è che il costo incrementale \(|C(X,Y)| - |C(X)|\) è al più \(K(Y \mid X)\) più il rimpianto, più \(K(C)\) e un termine logaritmico, e il sovrapprezzo per simbolo tende a zero se \(C\) è il programma che addestra e comprime in linea (la cui descrizione non cresce con i dati) e se \(|Y|\) cresce più in fretta di \(\log K(X,Y)\). Il divario fra congiunto e separato è l’informazione mutua algoritmica.
La quantità garantita è il rimpianto, non la prestazione: rimpianto basso vuol dire che nessun compressore avrebbe estratto da \(X\) più aiuto per \(Y\). La garanzia vale anche quando \(X\) è inutile (il caso limite dichiarato è la distribuzione uniforme), ed è ciò che la mette alla pari col supervisionato. È però una proprietà del compressore ideale: che una rete cercata con la discesa del gradiente abbia rimpianto basso è un’ipotesi, non un risultato, e un pre-addestramento su dati estranei può lasciare il modello peggiore del punto di partenza.
Convalida cercata apposta: sui modelli di linguaggio la tesi non è falsificabile, perché il loro comportamento si spiega anche come semplice distribuzione condizionata del testo. Di qui iGPT [CRC+20]: previsione del pixel successivo su immagini a bassa risoluzione, e sondaggio lineare che sale insieme alla bravura del predittore (\(96{,}3\%\) su CIFAR-10 con l’encoder congelato; il \(99{,}0\%\) che si legge in giro è la rete rifinita per intero, cioè un’altra prova). La separabilità lineare resta non spiegata, e non è una conseguenza della compressione; quello che la teoria predice è la buona rifinitura.
Prove empiriche: un modello di testo, su blocchi da 2048 byte, comprime immagini e audio meglio di PNG e FLAC (\(48{,}0\%\) contro \(61{,}7\%\), \(21{,}0\%\) contro \(30{,}3\%\), numeri della tabella e non dell’abstract), e su dati casuali non comprime affatto; su
enwik9scende all’\(8{,}3\%\), ma l’addestramento comprendeva Wikipedia [DeletangRD+24]. Su 31 modelli e 12 prove, con corpora più recenti dei dati di addestramento, correlazione di Pearson fra bit per carattere e punteggio medio pari a \(-0{,}931\) complessiva, e \(-0{,}935\), \(-0{,}937\) e \(-0{,}953\) per conoscenza, codice e matematica [HZSH24].La contabilità decide il verdetto. Il conto a modello dato non è una lunghezza di descrizione: contando i parametri a due byte l’uno nel codice in due parti, lo stesso Chinchilla 70B passa da \(8{,}3\%\) a \(14\,008{,}3\%\), e per un rapporto corretto non banale servirebbero dati dell’ordine dei terabyte. Il codice prequenziale non trasmette i parametri e li fa ricostruire al decodificatore riaddestrando sui dati già inviati: su CIFAR-10 due reti che arrivano quasi alla stessa accuratezza danno rapporto \(>2500\) codificando i pesi in
float32(limite inferiore ripreso da un altro lavoro, sui soli pesi) e \(0{,}27\) in prequenziale [BO18]. Difetto noto: il fenomeno del ritardo sui primi blocchi.Limiti dichiarati dall’autore stesso, nelle risposte alle domande del pubblico, e sono i tre più utili: la teoria ignora il costo di calcolo (una debolezza pratica enorme, a detta sua), quindi rende indistinguibili autoregressivo, diffusione ed energia a meno di un fattore dieci-quindici di macchina; l’analogia fra discesa del gradiente e ricerca fra programmi si rompe sulla procedura di ricerca, tant’è che per il compressore ideale l’ordine dei dati è irrilevante mentre per una rete non lo è; e la teoria parla di un insieme di dati fisso, mentre l’insieme di prova si suppone infinito, e su dati che non finiscono la dimensione del compressore smette di contare (che è il contrappeso al punto precedente).
Limiti esterni. \(K\) non è computabile, quindi si confrontano compressori e non si misura mai la distanza dall’ottimo; l’intelligenza è in larga parte compressione con perdita, e qui tutto è senza perdita; e con la definizione alternativa di Chollet [Cho19], che misura l’efficienza nell’acquisire abilità nuove, un buon compressore addestrato su tutto internet può risultare poco intelligente. La riga dei dati casuali ricorda infine che l’esistenza di qualcosa da comprimere è una proprietà della sorgente; quanto ci si avvicini al suo fondo è una proprietà del compressore.
L’auto-supervisione ha così la sua giustificazione più ambiziosa: non un espediente per quando le etichette finiscono, ma il modo in cui si costruisce una descrizione corta del mondo, con una teoria alle spalle che ha sessant’anni. Resta però una cosa fuori dal quadro, e non è piccola: comprimere un corpus è un’operazione su dati che ci sono già. Non dice niente su che cosa fare quando i dati bisogna andarseli a prendere agendo, e sbagliando, e ricevendo in cambio un premio o un castigo. Nell’immagine di Yann LeCun quella è la ciliegina sulla torta, e una ciliegina è per definizione la parte piccola: quanto sia piccola davvero è la discussione che chiude il capitolo.