


Curve al posto di rette: spline e modelli additivi#
«A spline is a simple mechanical device for drawing smooth curves»: un attrezzo meccanico, di quelli che stanno su un tavolo. La frase apre il paragrafo che inaugura il terzo capitolo di un lavoro di approssimazione numerica, e l’attrezzo che descrive è un listello di legno lungo e flessibile, che si posa sul foglio e si tiene fermo in qualche punto con dei pesi, chiamati nel testo dogs o rats, finché non prende la forma che si vuole tracciare. A scriverlo, nel 1946, è il matematico Isaac Jacob Schoenberg [Sch46]; chi disegnava scafi di navi, fusoliere e carrozzerie ha lavorato davvero così, fino agli anni Sessanta.
Fra un peso e l’altro quel listello non si piega a caso: prende da sé la curva che costa meno fatica di piegatura, perché il legno si oppone alla piega e cede il meno che può. Il lavoro di Schoenberg parte da qui, ed è la ragione per cui l’attrezzo viene prima della formula: finché le pendenze restano piccole (l’approssimazione che lui stesso dichiara), la curva che il legno disegna e la curva che la statistica calcola sono la stessa curva.
La domanda di partenza, però, è più semplice. Fin qui ai dati si sono adattate delle rette: una retta che li segue, nella regressione, e una retta che li divide, nella classificazione. Quando i dati su una retta non stanno, si può spezzare la linea a gradini, come fanno gli alberi decisionali, o tracciare la retta in uno spazio di caratteristiche trasformate, come fanno le macchine a vettori di supporto con il kernel. La strada più diretta, quella che verrebbe in mente a chiunque abbia disegnato un grafico su un foglio, è tenere la retta e piegarla.
Perché non basta alzare il grado#
Il modo più immediato di piegare una retta è la regressione polinomiale: si
aggiungono alla matrice dei dati le colonne \(x^2, x^3, \dots, x^p\) e si risolve
lo stesso problema ai minimi quadrati della retta (in scikit-learn,
PolynomialFeatures davanti a LinearRegression). La potenza più alta, \(p\), è
il grado: \(2\) dà una parabola, \(3\) una cubica. Finché il grado resta basso
funziona. Al crescere del grado l’errore esplode vicino agli estremi
dell’intervallo, anche quando al centro la curva è perfetta: è il fenomeno di
Runge, descritto da Carl Runge nel 1901 [Run01].
Un palazzo di ventun appartamenti, una caldaia sola in cantina, e l’acqua calda che parte da lì e passa per tutti i termosifoni. Ogni inquilino ha la sua idea di temperatura giusta, e le idee sono ventuno. Chi regola l’impianto ha pochi comandi, e ognuno agisce sul palazzo intero. Apre per il quinto piano e bolle anche il terzo; allora strozza la colonna per rimediare, e si raffredda il secondo; ogni rimedio ne chiede un altro. Ai piani di mezzo i rimedi si accavallano e finiscono per compensarsi, e lì la temperatura viene giusta al grado. Ai due capi della colonna, in cima e a pianterreno, non c’è più niente che compensi. Uno gela e l’altro bolle, e non di un grado o due. In cima si sta col cappotto. Più si pretende di azzeccare la temperatura di ognuno, peggio stanno quei due, e basta che un inquilino cambi un radiatore perché tutta la regolazione vada rifatta da capo.
Con i polinomi succede esattamente questo: gli inquilini sono i punti, i comandi sono i numeri del polinomio, e ogni numero cambia la curva dappertutto, come ogni comando cambia l’acqua di tutto il palazzo. È il fenomeno di Runge. Prendi una curva a campana molto stretta, piazza dei punti a distanze uguali lungo l’asse, e chiedi a un polinomio di passare esattamente per tutti. Al centro il polinomio è impeccabile. Ai bordi impazzisce, e più punti gli dai peggio va: con cinque punti sbaglia al massimo di \(0{,}4\), con ventuno sbaglia di quasi \(60\), su una curva che non supera mai \(1\).
Spostare i punti aiuta, e per questa campana basta. Infittendoli verso i bordi invece di tenerli a distanze uguali, la curva torna a venire bene. Solo che nei dati veri dove cadono i punti non lo decidiamo noi, e il guaio grosso è un altro: una formula sola vale per tutto il campo, e ogni pezzo che le si aggiunge piega la curva dappertutto, anche dove andava bene com’era. Il conto lo si paga ai bordi, dove i punti stanno tutti da una parte sola e niente tiene ferma la curva dall’altra.
La regressione polinomiale \(y = \theta_0 + \theta_1 x + \theta_2 x^2 + \dots\) è ancora un modello lineare, perché lineare lo è nei parametri \(\theta_j\) e non in \(x\): resta un problema ai minimi quadrati con una matrice di disegno più larga. Le difficoltà sono due e distinte: la base dei monomi è mal condizionata (il numero di condizione della matrice di disegno cresce esponenzialmente col grado, e si cura cambiando base, per esempio con i polinomi di Čebyšëv), e i polinomi hanno supporto globale, qualunque sia la base.
L’interpolazione polinomiale su nodi equispaziati non converge uniformemente per ogni funzione continua. L’esempio canonico di Runge è \(f(x) = 1/(1+25x^2)\) su \([-1,1]\): detto \(p_{n}\) il polinomio di grado \(n-1\) che interpola \(f\) su \(n\) nodi equispaziati,
con la divergenza concentrata vicino a \(x = \pm 1\). Il conto, con accanto l’errore della spline cubica naturale sugli stessi nodi (la costruisce la sezione seguente):
import numpy as np
from scipy.interpolate import CubicSpline

def runge(x):
    return 1.0 / (1.0 + 25.0 * x**2)

xf = np.linspace(-1, 1, 2001)
for nodi in (5, 9, 15, 21):
    xn = np.linspace(-1, 1, nodi)                       # nodi equispaziati
    c = np.polyfit(xn, runge(xn), nodi - 1)             # interpolazione esatta
    err = np.abs(np.polyval(c, xf) - runge(xf))
    spline = CubicSpline(xn, runge(xn), bc_type="natural")
    err_s = np.abs(spline(xf) - runge(xf))
    print(f"nodi={nodi:3d}  errore max: polinomio = {err.max():8.3f}  "
          f"spline cubica naturale = {err_s.max():.4f}")
nodi=  5  errore max: polinomio =    0.438  spline cubica naturale = 0.2793
nodi=  9  errore max: polinomio =    1.045  spline cubica naturale = 0.0561
nodi= 15  errore max: polinomio =    7.195  spline cubica naturale = 0.0025
nodi= 21  errore max: polinomio =   59.822  spline cubica naturale = 0.0032
Il problema di interpolazione su nodi equispaziati è mal condizionato: la costante di Lebesgue \(\Lambda_n\), cioè il fattore massimo con cui l’interpolazione amplifica un errore sui valori, cresce esponenzialmente, \(\Lambda_n \sim 2^{n+1}/(e\,n\log n)\), mentre per i nodi di Čebyšëv \(\cos(k\pi/n)\), che si addensano ai bordi, cresce come \(\tfrac{2}{\pi}\log n\). Che per la funzione di Runge l’errore diverga, e non soltanto si amplifichi, dipende anche dalla sua analiticità: i poli in \(\pm i/5\) cadono fuori dalla regione del piano complesso in cui l’interpolazione equispaziata converge, e il polinomio diverge per \(|x| \gtrsim 0{,}726\) [Tre13].
Cambiare la posizione dei nodi cura questo esempio, e cambiare base cura il condizionamento, ma nessuno dei due cura il problema di fondo: un polinomio ha supporto globale, quindi ogni coefficiente influenza la curva su tutto il dominio, e la stima ai minimi quadrati non ha modo di localizzare la flessibilità.
Su dati rumorosi, che è il caso realistico, la stessa misura si fa così. L’errore stampato è quello commesso su punti che il modello non ha visto in addestramento, al centro dell’intervallo, nel quinto esterno (cioè ai bordi) e su tutti i punti insieme. Accanto ai polinomi ci sono già le spline con il numero dei loro nodi, il rimedio che la sezione seguente costruisce: qui fanno da termine di paragone, e più nodi vuol dire una curva più flessibile.
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import KFold
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, SplineTransformer

rng = np.random.default_rng(0)
x = np.sort(rng.uniform(-1, 1, 120))
y = 1.0 / (1.0 + 25.0 * x**2) + rng.normal(0, 0.05, x.size)   # la curva di Runge
X = x.reshape(-1, 1)

bordo = np.abs(x) > 0.8          # il quinto esterno del campo
pieghe = KFold(n_splits=5, shuffle=True, random_state=0)

def errori(modello):
    """MSE fuori campione: al centro, ai due bordi, e su tutti i punti."""
    res = np.empty_like(y)
    for tr, te in pieghe.split(X):
        res[te] = modello.fit(X[tr], y[tr]).predict(X[te])
    e = (res - y) ** 2
    return e[~bordo].mean(), e[bordo].mean(), e.mean()

print(f"{'modello':<26}{'centro':>10}{'bordi':>10}{'tutti':>10}")
for g in (9, 15, 21):
    c, b, t = errori(make_pipeline(PolynomialFeatures(g), LinearRegression()))
    print(f"polinomio grado {g:<10d}{c:10.4f}{b:10.4f}{t:10.4f}")
for n in (8, 12, 20):
    c, b, t = errori(make_pipeline(SplineTransformer(n_knots=n, degree=3),
                                   LinearRegression()))
    print(f"spline cubica {n:2d} nodi{'':<6}{c:10.4f}{b:10.4f}{t:10.4f}")
print(f"\npunti al bordo: {bordo.sum()} su {len(x)}; rumore vero: {0.05**2:.4f}")
modello                       centro     bordi     tutti
polinomio grado 9             0.0088    0.0054    0.0078
polinomio grado 15            0.0034    0.0049    0.0038
polinomio grado 21            0.0034    0.0280    0.0104
spline cubica  8 nodi          0.0096    0.0029    0.0077
spline cubica 12 nodi          0.0036    0.0029    0.0034
spline cubica 20 nodi          0.0033    0.0031    0.0032

punti al bordo: 34 su 120; rumore vero: 0.0025
Il numero da guardare è lo \(0{,}0280\) della terza riga. Passando dal grado 15 al grado 21 il polinomio non peggiora affatto al centro (\(0{,}0034\) tutte e due le volte) e peggiora di quasi sei volte ai bordi, arrivando a undici volte il rumore che c’è davvero nei dati. La spline, alla stessa mossa (da 12 a 20 nodi, cioè più flessibilità), non si muove né di qua né di là. Al grado 15 il polinomio va benissimo; ha però una finestra stretta, e uscirne costa caro in un posto solo. Nella media su tutti i punti il peggioramento si vede, da \(0{,}0038\) a \(0{,}0104\); è la separazione a dire dove sta: al centro il polinomio non cambia affatto.
Tanti listelli corti invece di uno lungo#
Il rimedio è rinunciare a una formula sola: si divide l’asse con dei punti di giunzione, i nodi, si usa un polinomio di grado basso fra un nodo e l’altro, e si raccordano i pezzi nei nodi. La curva che ne esce è una spline, nome che viene dal listello del tavolo da disegno, che fa la stessa cosa con tanti pezzi corti giuntati.
Sul tavolo da disegno i listelli corti si appoggiano uno di seguito all’altro, e dove finisce il primo e comincia il secondo un peso li tiene fermi, piantato come un paletto. Quel paletto fra un tratto e il successivo è il nodo. Ogni listello si piega come una cubica, la curva più semplice capace di avere un massimo, un minimo e un punto di flesso, quanto basta per fare una gobba e cambiare idea. Appoggiati e basta, però, i pezzi restano indipendenti, e sotto ogni peso si vedrebbe lo scalino.
La giuntura si collauda col dito. Lo passi sopra il peso e non deve sentire niente: nessun gradino, cioè i due pezzi si toccano; nessuno spigolo, cioè arrivano con la stessa pendenza; nessuno scatto, cioè piegano dalla stessa parte e con la stessa forza. Tre pretese su ogni peso, e la giuntura sparisce anche alla vista: l’occhio non sa dire dove finisce un listello e comincia l’altro. Quello che resta sul foglio è una spline cubica. Adesso una gobba in fondo a destra si ottiene mettendo un peso in più a destra, e il listello di sinistra resta dov’era; con una formula sola per tutto il campo si muoveva tutto.
Quanta libertà resti alla curva si conta con le dita. Tre pesi fanno quattro tratti; ogni tratto è una cubica, e una cubica per stare ferma vuole quattro numeri, quindi sedici numeri in tutto. Ogni peso ne blocca tre, uno per pretesa, e i pesi sono tre: nove bloccati, sette liberi. Restano sette gradi di libertà, e ne viene uno in più per ogni peso che si aggiunge.
Le tre pretese, e il grado tre, il legno le rispetta da solo. Schoenberg le ricava dalla teoria elementare della trave elastica, nella pagina stessa in cui descrive l’attrezzo: un’asta appoggiata su dei pesi si dispone in archi cubici, che si raccordano con la stessa pendenza e la stessa curvatura, e i raccordi cadono esattamente sotto i pesi. I paletti sul foglio sono i suoi pesi.
Resta il pezzo di listello che sporge oltre l’ultimo peso. Là il foglio è vuoto, di dati non ce n’è, e niente lo trattiene: un listello libero in quel tratto non ha nulla che lo pieghi, e prosegue dritto come una retta oltre gli estremi. Un listello montato così si dice naturale, ed è la scelta di riferimento perché rende noiosi i bordi, che sono il posto dove i modelli fanno i danni. Sul foglio di un modello non c’è il legno a raddrizzare la punta, e la rettilineità va scritta come condizione: due condizioni a ogni capo, e dei sette gradi di libertà ne restano tre, uno per paletto.
Fissati i nodi interni \(\xi_1 < \dots < \xi_K\) nel dominio, una spline di grado \(q\) è una funzione che su ogni intervallo fra due nodi consecutivi è un polinomio di grado \(\le q\), e che in ogni nodo è continua insieme alle derivate fino alla \((q-1)\)-esima. Per \(q = 3\) (il caso quasi universale) le condizioni di raccordo sono continuità di \(f\), \(f'\) e \(f''\).
Il caso \(q=3\) viene direttamente dal listello. Schoenberg deriva la definizione dalla meccanica dell’asta appoggiata, con una linearizzazione dichiarata (se la curva è quasi parallela all’asse \(x\) si può trascurare \(y'\), e la curvatura \(1/R = y''/(1+y'^2)^{3/2}\) si riduce a \(y''\)), e conclude che la forma assunta «is a polygonal line composed of cubic arcs which join continuously, with a continuous first and second derivative», con i raccordi proprio dove poggiano i pesi. La definizione formale che segue nel suo articolo è la generalizzazione di quel fatto meccanico a un grado qualunque.
Il conto dei gradi di libertà rende la costruzione trasparente. Con \(K\) nodi interni ci sono \(K+1\) intervalli, ciascuno con una cubica a 4 coefficienti: \(4(K+1)\) parametri liberi. Ogni nodo impone 3 vincoli, e i nodi sono \(K\): restano
gradi di libertà. Ecco perché una spline cubica con \(K\) nodi si scrive come combinazione di \(K+4\) funzioni di base. La spline cubica naturale aggiunge il vincolo \(f'' = f''' = 0\) oltre i due nodi estremi, cioè 2 vincoli per estremo, e scende a \(K\) gradi di libertà [HTF09].
La base che si usa in pratica non è quella dei polinomi troncati \((x -
\xi_k)_+^3\), numericamente pessima, ma quella delle B-spline, le funzioni di
base a supporto locale costruite da Schoenberg: ogni \(B_{k,3}\) è diversa da
zero solo su quattro intervalli consecutivi. È da qui che viene tutto il
vantaggio sul polinomio globale, dove ogni base è diversa da zero ovunque: la
matrice di disegno è a banda, la base resta ben condizionata al crescere di \(K\)
(il suo numero di condizione dipende dal grado e non dal numero di nodi), e un
coefficiente sposta la curva solo nel suo pezzo di dominio. La matrice di
disegno dipende però anche dai dati, e ha rango pieno solo se ogni funzione di
base ha dei dati nel proprio supporto (la condizione di Schoenberg e Whitney):
con nodi in zone senza dati, o più nodi che dati, il problema ai minimi quadrati
torna singolare. In scikit-learn è ciò che fa SplineTransformer, che trasforma
una colonna in \(K + q + 1\) colonne di B-spline valutate sui dati, cioè
esattamente i \(K+4\) gradi di libertà contati sopra (attenzione: il suo n_knots
conta anche i due nodi di bordo, quindi con n_knots=8 e grado 3 le colonne
sono dieci). Quelle colonne sommano a \(1\) in ogni punto, perché le B-spline sono
una partizione dell’unità, quindi la costante c’è già e l’intercetta del modello
lineare che gli si mette dopo è ridondante; a parte questo resta un ordinario
problema ai minimi quadrati.
Con le spline la scelta del grado diventa la scelta dei nodi: quanti e dove. Sul
«dove», l’uso è metterli ai quantili della variabile, cioè più fitti dove ci
sono più dati (SplineTransformer(knots="quantile"); il default li mette
equispaziati); sul «quanti», è un iperparametro come gli altri, che si sceglie
con la cross-validation di Overfitting e validazione. C’è anche una terza via, che la scelta la evita.
La manopola che irrigidisce il legno#
Invece di decidere quanti nodi, se ne mette uno per dato e si penalizza la curvatura. È l’idea della smoothing spline. Il listello dei cantieri ne è il caso limite: tenuto fermo dai pesi passa per tutti i punti, e la sua rigidità non cambia la forma; il compromesso fra fedeltà ai dati e curvatura è quello di un listello agganciato ai punti con delle molle, e il rapporto fra la rigidità del legno e quella delle molle è il \(\lambda\) della formula. Che il minimo di quel compromesso sia esattamente una spline lo dimostra ancora Schoenberg, nel 1964 [Sch64]; a renderla un algoritmo che gira è Christian Reinsch, tre anni dopo [Rei67].
Adesso si tolgono i pesi che inchiodano il listello ai punti, e in ogni punto lo si aggancia con un elastico. Il listello fa allora due cose in contrasto fra loro. Da un lato deve passare vicino ai punti, e ogni elastico lo tira dalla sua parte, tanto più forte quanto più è teso. Dall’altro il legno si oppone alla piega: piegarlo costa fatica, e più lo pieghi stretto più fatica costa. La curva che il listello disegna è il compromesso fra questi due tiri, cioè quella che spende meno fatica in totale. Con i pesi la rigidità non conterebbe niente: il listello passerebbe per tutti i punti comunque, duro o morbido che sia.
E nessuno gli ha dovuto dire che forma prendere. Il legno non sa che cosa siano i tratti e i paletti, eppure quello che viene fuori è proprio una curva a tratti raccordati, con i raccordi in corrispondenza dei punti. E ne viene fuori una sola, perché fra tutte le forme possibili quella che costa meno fatica è una.
La smoothing spline scrive quel compromesso in una formula sola, con una manopola in mezzo: quanto è rigido il legno rispetto agli elastici.
Gira la manopola verso il morbido e ottieni uno spago: passa per tutti i punti, uno per uno, e fra un punto e l’altro fa quello che vuole. Ha imparato anche il rumore.
Gira la manopola verso il rigido e ottieni un righello di acciaio: non si piega affatto, e dei punti si limita a stare in mezzo. È tornato a essere la retta di partenza.
La posizione della manopola si traduce in un numero, lo stesso conto dei paletti, cioè quanti gradi di libertà restano alla curva. Verso il morbido quel numero resta alto. Verso il rigido scende a \(2\), che è la libertà di una retta: uno per dire quanto è alta, uno per dire quanto pende. Il righello di acciaio, allora, va preso alla lettera.
Fra tutte le funzioni \(f\) due volte derivabili, la smoothing spline è quella che minimizza
dove il primo termine è la fedeltà ai dati e il secondo la penalità di curvatura, pesata da \(\lambda \ge 0\). Il risultato notevole, e non ovvio, è che il minimo di questo problema su uno spazio di funzioni di dimensione infinita esiste, è unico, ed è una spline cubica naturale con un nodo in ogni \(x_i\) distinto: non bisogna imporre la forma, la si ottiene.
I due estremi si leggono nella formula. Per \(\lambda \to 0\) la penalità sparisce e resta l’interpolazione; per \(\lambda \to \infty\) l’unico modo di tenere finito il costo è \(f'' \equiv 0\), cioè \(f\) affine, e il primo termine sceglie fra le rette quella dei minimi quadrati.
Poiché i nodi sono fissati ai dati, la complessità non si governa contandoli ma misurandola. La stima è lineare nei dati, \(\hat{\mathbf{y}} = \mathbf{S}_{\lambda}\, \mathbf{y}\) con \(\mathbf{S}_{\lambda}\) la matrice di lisciamento, e si definiscono gradi di libertà effettivi
che interpolano con continuità fra \(m\) (interpolazione) e \(2\) (retta). Sono la generalizzazione naturale del «numero di parametri»: per un modello lineare ordinario con \(d\) colonne la matrice di proiezione ha traccia esattamente \(d\), quindi la definizione non è una convenzione nuova ma la stessa di sempre, letta in un caso in cui i parametri non si contano.
La stessa linearità rende quasi gratuita la scelta di \(\lambda\). L’errore leave-one-out non richiede \(m\) adattamenti, perché vale l’identità
dove \(S_{\lambda,ii}\) è l’\(i\)-esimo elemento diagonale di \(\mathbf{S}_\lambda\)
[HTF09]; la validazione incrociata generalizzata (GCV)
sostituisce ogni \(S_{\lambda,ii}\) con la media \(\mathrm{df}(\lambda)/m\), ed è
il criterio con cui make_smoothing_spline di SciPy sceglie \(\lambda\) quando
non glielo si passa. E il sistema da risolvere, scritto nella base B-spline, è
a banda, quindi il costo è lineare in \(m\): è ciò che rende praticabile un nodo
per dato.
Il codice adatta la smoothing spline per sei valori di \(\lambda\) e stampa, per
ciascuno, i gradi di libertà effettivi \(\mathrm{df}(\lambda) =
\operatorname{tr}(\mathbf{S}_\lambda)\) e l’errore quadratico medio rispetto alla
curva vera, che su dati simulati si conosce. La traccia si calcola un dato per
volta: la spline adattata a un vettore che vale \(1\) nel solo dato \(j\) e \(0\)
altrove, letta in \(x_j\), è l’elemento \(S_{\lambda,jj}\), cioè di quanto si sposta
la curva in \(x_j\) se si sposta di uno solo quel dato. (\(10^{-8}\), un
centomilionesimo, si stampa 1e-08.)
import numpy as np
from scipy.interpolate import make_smoothing_spline

rng = np.random.default_rng(0)
x = np.sort(rng.uniform(-1, 1, 120))
vera = 1.0 / (1.0 + 25.0 * x**2)
y = vera + rng.normal(0, 0.05, x.size)

def gdl(lam):
    """Gradi di libertà effettivi: la traccia della matrice che manda y in ŷ."""
    tr = 0.0
    for j in range(len(x)):
        e = np.zeros(len(x)); e[j] = 1.0
        tr += make_smoothing_spline(x, e, lam=lam)(x[j])
    return tr

print(f"{'lambda':>10}{'gdl effettivi':>16}{'errore vs curva vera':>24}")
for lam in (1e-8, 1e-6, 1e-4, 1e-2, 1e0, 1e3):
    s = make_smoothing_spline(x, y, lam=lam)
    print(f"{lam:10.0e}{gdl(lam):16.1f}{np.mean((s(x) - vera)**2):24.5f}")

# l'ultima riga da vicino: quella curva quanto e' davvero una retta?
retta = np.polyval(np.polyfit(x, y, 1), x)
scarto = np.abs(make_smoothing_spline(x, y, lam=1e3)(x) - retta).max()
print(f"\na lambda=1e3 i gdl valgono {gdl(1e3):.4f}, e la curva si scosta dalla")
print(f"retta dei minimi quadrati al massimo di {scarto/np.ptp(y):.5f} "
      f"dell'ampiezza dei dati")
    lambda   gdl effettivi    errore vs curva vera
     1e-08            97.0                 0.00217
     1e-06            53.7                 0.00102
     1e-04            20.2                 0.00031
     1e-02             7.2                 0.00312
     1e+00             3.0                 0.03214
     1e+03             2.0                 0.07755

a lambda=1e3 i gdl valgono 2.0026, e la curva si scosta dalla
retta dei minimi quadrati al massimo di 0.00076 dell'ampiezza dei dati
La prima colonna è la manopola, che nella formula si chiama \(\lambda\): piccola a sinistra (legno morbido), grande in fondo (legno rigido). La seconda è il numero che dice quanto è flessibile la curva che ne esce, e ha un nome, gradi di libertà effettivi. Ci sono tre cose da leggere.
La prima è l’ultima riga. Con la manopola tutta sul rigido i gradi di libertà arrivano a \(2{,}0\), che è il conto di una retta: uno per l’altezza, uno per la pendenza. Le due righe in fondo dicono quanto quella retta vada presa alla lettera. Il valore non è esattamente \(2\) ma \(2{,}0026\): la retta si raggiunge solo con una manopola infinita, e a ogni valore finito resta un filo di flessibilità; e la curva che ne esce si scosta dalla retta di best fit (la retta dei minimi quadrati), nel punto peggiore, di otto decimillesimi dell’ampiezza dei dati, cioè meno del tratto di matita con cui la si disegnerebbe.
La seconda è che l’errore rispetto alla curva vera non scende sempre: tocca il minimo a \(\lambda = 10^{-4}\) e risale da tutte e due le parti. È la U del compromesso bias-varianza, la stessa vista in Overfitting e validazione, disegnata qui da una manopola che gira con continuità invece che da un numero intero di nodi.
La terza è la più utile: fra \(\lambda = 10^{-8}\) e \(\lambda = 10^{-4}\) i gradi di libertà passano da \(97\) a \(20\), cioè la manopola ha ridotto di tre quarti la flessibilità, e l’errore migliora di sette volte. Quei \(77\) gradi di libertà stavano descrivendo il rumore.
La Fig. 4.20 mette in fila le tre cose viste finora.

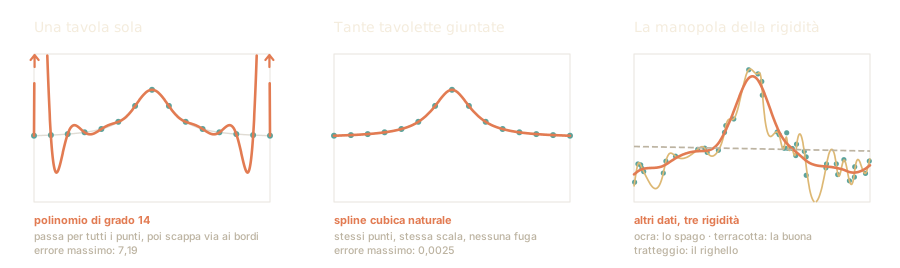
Fig. 4.20 A sinistra e al centro, lo stesso compito e la stessa scala: far passare una curva per quindici punti presi su una campana (in grigio tenue). Il polinomio ci riesce, e nel farlo scappa fuori dal riquadro alle due estremità (errore massimo \(7{,}19\)); la spline cubica naturale resta aderente per tutta la lunghezza (errore massimo \(0{,}0025\), quasi tremila volte meno). A destra servono dati rumorosi, perché è lì che la manopola della rigidità ha senso: dallo spago che insegue ogni punto al righello che non si piega.#
Il pannello di destra di Fig. 4.20 mostra una regolarizzazione parente stretta della Ridge di Overfitting e validazione. Scritta nella base B-spline, \(f = \sum_j \theta_j B_j\) (i \(\theta_j\) sono i pesi delle funzioni di base), la penalità di curvatura diventa una forma quadratica nei pesi, \(\int f''^2 = \boldsymbol{\theta}^\top\boldsymbol{\Omega}\,\boldsymbol{\theta}\) con \(\Omega_{jk} = \int B_j''\,B_k''\): è una Ridge generalizzata [HTF09], che al posto di \(\lVert\boldsymbol{\theta}\rVert^2\) penalizza \(\boldsymbol{\theta}^\top\boldsymbol{\Omega}\,\boldsymbol{\theta}\). La Ridge tira tutti i pesi verso lo zero; la penalità di curvatura lascia liberi quelli che descrivono una retta, su cui vale zero, e frena solo le combinazioni che piegano la curva.
Una media che scivola: la regressione a nucleo#
La smoothing spline si ottiene con un’unica ottimizzazione su tutti i dati. Si può anche stimare la funzione punto per punto: per stimarla in \(x_0\) si fa la media pesata delle \(y_i\), con pesi che decrescono con la distanza \(\lvert x_i - x_0\rvert\) secondo una funzione a campana centrata in \(x_0\), così che i vicini contino molto e i lontani quasi niente. È la regressione a nucleo, proposta indipendentemente da Èlizbar Nadaraya e da Geoffrey Watson nel 1964 [Nad64, Wat64], e la campana si chiama nucleo, in inglese kernel: è parente stretta del kernel che tornerà nella sezione sul kernel trick. La larghezza della campana, \(h\), si chiama larghezza di banda (bandwidth), e fa il mestiere che nella smoothing spline faceva \(\lambda\).
Per stimare quanto vale una casa di 80 metri quadri si guardano le case vendute. Quelle di 79 o di 81 metri contano quasi come se fossero la casa da stimare; quelle di 70 un po’ meno; quelle di 150 non dicono niente. La stima è la media dei prezzi, dove ogni prezzo pesa tanto quanto la sua casa somiglia per superficie a quella da stimare: ogni prezzo si moltiplica per il suo peso, e il totale si divide per la somma dei pesi invece che per il numero delle case. Con due case da 79 e 81 metri vendute a 200 e 210 mila euro, che contano per intero (arrotondando il loro «quasi»), e una da 70 metri venduta a 180 mila, che conta per metà, il conto è \((200 + 210 + 0{,}5 \times 180) / (1 + 1 + 0{,}5) = 500 / 2{,}5 = 200\) mila euro. Poi si fa lo stesso per 81 metri, per 82, e così via: la finestra dei «simili» scivola lungo i metri quadri, e la stima disegna una curva (Fig. 4.21). È una finestra dai bordi sfumati, e nella figura il peso che cala ha la forma di una campana.
Tutta la questione è quanto fare larga quella finestra. Se si considerano simili solo le case identiche, ogni stima si appoggia su una o due vendite e salta qua e là a ogni affare fortunato. Se si considerano simili tutte le case fino a cento metri di differenza, la stima diventa la media di tutto il quartiere, la stessa dappertutto, e perde la forma che si cercava. In mezzo c’è una larghezza che sbaglia meno delle altre, ed è lo stesso compromesso fra una risposta nervosa e una troppo piatta che nel listello regolava la manopola della rigidità. Per trovarla non serve conoscere il prezzo giusto: si nasconde a turno ogni casa venduta, la si stima con le altre, e si tiene la larghezza con cui quelle stime cadono più vicino ai prezzi veri. Con più vendite la finestra si può stringere, perché anche stretta ne trova abbastanza, e la stima migliora; ma più piano che se si sapesse già che il prezzo sale in linea retta con i metri quadri.
C’è un punto in cui la media inganna: il bordo. Per la casa più piccola del quartiere tutte le vicine sono più grandi, e di solito più care; la finestra le prende solo da una parte, e la media tira la stima verso l’alto, tanto più quanto più è larga la finestra e ripida la discesa dei prezzi verso le case piccole. Il rimedio è tracciare, dentro la finestra, un piccolo pezzo di retta che passi il più vicino possibile ai prezzi, contando di più le case più simili, e leggere la stima sulla retta, all’altezza della casa da stimare. La retta si accorge che i prezzi vanno giù, e lo tiene in conto anche dove i vicini stanno tutti da un lato. Vale però solo se la finestra non è troppo stretta: una retta tirata su due o tre case sole punta dove vuole, e al bordo sbaglia più della media che doveva correggere.
E c’è un punto in cui la finestra non basta più: quando le caratteristiche sono tante. Case simili per superficie ce ne sono sempre; case simili per superficie, piano, anno, quartiere, esposizione e dieci altre cose insieme non ce ne sono quasi mai, e la finestra resta vuota.
Lo stimatore di Nadaraya-Watson, con un nucleo \(K\) (qui la gaussiana, \(K(u) = e^{-u^2/2}/\sqrt{2\pi}\)) e larghezza di banda \(h\), è
cioè la soluzione di \(\min_{c}\sum_i K_h(x_0 - x_i)(y_i - c)^2\): un modello costante adattato con pesi locali. Sostituendo la costante con una retta, \(\min_{a,b}\sum_i K_h(x_0 - x_i)\,\big(y_i - a - b(x_i - x_0)\big)^2\) e \(\hat f(x_0) = \hat a\), si ottiene la regressione lineare locale (la base del LOWESS di Cleveland [Cle79]). All’interno la distorsione di entrambe è \(O(h^2)\) e la varianza \(O\big(1/(mh)\big)\), quindi la banda ottima va come \(m^{-1/5}\) e l’errore quadratico come \(m^{-4/5}\), più lento del \(m^{-1}\) di un modello parametrico corretto. Sono conti asintotici, per \(h \to 0\) e \(mh \to \infty\), con \(f\) due volte derivabile con continuità, densità degli \(x_i\) positiva attorno a \(x_0\) e rumore di varianza finita; il termine della distorsione proporzionale a \(h\,f'(x_0)\) all’interno sparisce perché il nucleo è simmetrico. Più in dettaglio, con \(p\) la densità degli \(x_i\), \(\mu_2 = \int u^2K(u)\,du\) e \(R(K) = \int K^2\), all’interno valgono
dove LL è la retta locale e \(\sigma^2\) la varianza del rumore, la stessa per i due stimatori. Il termine \(f'p'/p\), la distorsione di progetto, c’è anche all’interno quando i dati non sono distribuiti in modo uniforme: la media pesata la paga, la retta locale no, e per questo la regressione lineare locale è preferibile anche lontano dai bordi [Fan92]. Al bordo i dati stanno da una parte sola, il termine in \(h\,f'(x_0)\) non si cancella più, e la distorsione di Nadaraya-Watson sale a \(O(h)\) (nel punto estremo, con nucleo gaussiano e dati uniformi, circa \(0{,}8\,h\,\lvert f'(x_0)\rvert\)), mentre quella lineare locale resta \(O(h^2)\): la retta corregge al primo ordine l’asimmetria del vicinato [HTF09]. Il prezzo è la varianza, che nel punto estremo, con le stesse ipotesi, è circa tripla di quella della media pesata: con una banda stretta la retta poggia su pochi punti tutti da un lato, e al bordo sbaglia più della media che doveva correggere. La stessa idea, massimizzare una verosimiglianza pesata attorno a \(x_0\), dà la verosimiglianza locale, che porta la regressione logistica o di Poisson in versione locale.
Come la smoothing spline, lo stimatore è lineare nelle risposte, \(\hat{\mathbf{y}} = \mathbf{S}_h\mathbf{y}\) con \(S_{h,ij} = K_h(x_i - x_j)/\sum_l K_h(x_i - x_l)\), quindi la banda si sceglie con la stessa scorciatoia leave-one-out, che qui è esatta, e \(\operatorname{tr}(\mathbf{S}_h)\) ne misura i gradi di libertà effettivi. A differenza della spline, però, lo stimatore tiene con sé tutti gli esempi, e ogni stima costa \(O(m)\) nella forma diretta.
In \(d\) dimensioni la varianza diventa \(O\big(1/(m h^d)\big)\) e la velocità \(m^{-4/(4+d)}\), che per funzioni due volte derivabili nessuno stimatore può battere [Sto82]. È la maledizione della dimensionalità del k-NN, che è a sua volta una media locale con un nucleo uniforme e una banda che si adatta per contenere \(k\) punti.
Il nucleo gaussiano è anche il ponte con un meccanismo che arriva molto più avanti. Se le chiavi \(\mathbf{k}_i\) hanno tutte la stessa norma, \(\exp\big(-\lVert\mathbf{q}-\mathbf{k}_i\rVert^2/(2h^2)\big) \propto \exp(\mathbf{q}^\top\mathbf{k}_i/h^2)\) (la norma di \(\mathbf{q}\) non conta: il fattore \(e^{-\lVert\mathbf{q}\rVert^2/(2h^2)}\) è comune a tutti i pesi e la normalizzazione lo cancella), e la media pesata \(\sum_i \mathrm{softmax}_i(\mathbf{q}^\top\mathbf{k}_i/h^2)\,\mathbf{v}_i\) è lo stimatore di Nadaraya-Watson con il punto \(\mathbf{q}\), gli esempi \(\mathbf{k}_i\) e le risposte \(\mathbf{v}_i\). Con \(h^2 = \sqrt{d_k}\), dove \(d_k\) è la dimensione di query e chiavi (il numero delle loro componenti), è l’attenzione dei Transformer: il suo fattore \(1/\sqrt{d_k}\) fa la parte della larghezza della campana, e la similarità, a differenza della campana, si impara, attraverso le proiezioni che producono \(\mathbf{q}\) e \(\mathbf{k}_i\).
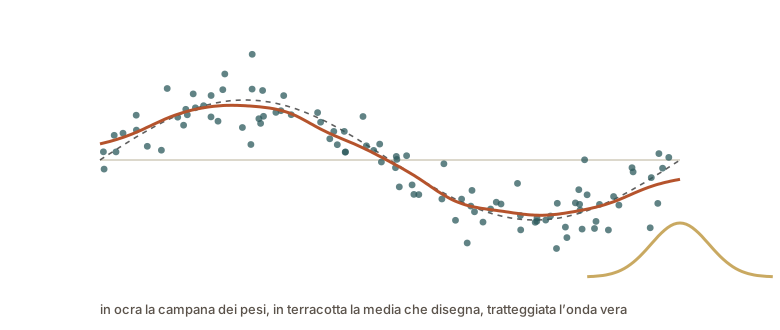
Fig. 4.21 La campana ocra decide quanto pesa ogni punto nella media, e mentre scorre la media disegna la curva terracotta. All’interno la curva segue l’onda vera (tratteggiata); ai due estremi la campana ha punti da una parte sola, e la curva se ne stacca: a sinistra i vicini stanno tutti più in alto e la tirano su, a destra stanno tutti più in basso e la tirano giù.#
Il codice misura il compromesso sulla larghezza e il difetto del bordo ripetendo la prova duecento volte, ogni volta con cento esempi rumorosi nuovi presi dalla stessa onda (la funzione \(\sin 2\pi x\), che fra \(0\) e \(1\) sale una volta e scende una volta, con un rumore di deviazione standard \(0{,}3\)), perché su una prova sola il rumore dei pochi punti ai bordi basta a far vincere, per caso, il metodo che in media sbaglia di più. Stampa la radice dell’errore quadratico medio, cioè di quanto, tipicamente, la stima si scosta dall’onda vera, sui duecentouno punti in cui la si calcola: in tutto, all’interno e nel 10% vicino agli estremi. I numeri da confrontare sono, riga per riga, quello dell’interno e quello dei bordi.
import numpy as np

rng = np.random.default_rng(0)
vera = lambda x: np.sin(2 * np.pi * x)            # la funzione da ritrovare
griglia = np.linspace(0, 1, 201)                   # dove si stima
bordo = (griglia < 0.05) | (griglia > 0.95)        # il 10% vicino agli estremi

def pesi(x, h):
    """Una campana larga h attorno a ogni punto della griglia."""
    return np.exp(-0.5 * ((griglia[:, None] - x[None, :]) / h) ** 2)

def nadaraya_watson(x, y, h):
    w = pesi(x, h)
    return (w * y).sum(axis=1) / w.sum(axis=1)     # media pesata delle y

def retta_locale(x, y, h):
    """Minimi quadrati pesati di una retta attorno a ogni punto, valutata lì."""
    w, d = pesi(x, h), x[None, :] - griglia[:, None]
    s0, s1, s2 = w.sum(1), (w * d).sum(1), (w * d * d).sum(1)
    t0, t1 = (w * y).sum(1), (w * d * y).sum(1)
    return (s2 * t0 - s1 * t1) / (s0 * s2 - s1 ** 2)

errori = {}
for _ in range(200):                               # duecento campioni
    x = np.sort(rng.random(100))
    y = vera(x) + rng.normal(0, 0.3, size=100)
    stime = [(f"media pesata, h = {h}", nadaraya_watson(x, y, h))
             for h in (0.005, 0.02, 0.05, 0.1, 0.3)]
    stime += [(f"retta locale, h = {h}", retta_locale(x, y, h))
              for h in (0.02, 0.05)]
    for nome, stima in stime:
        errori.setdefault(nome, []).append((stima - vera(griglia)) ** 2)
for nome, e in errori.items():
    e = np.array(e)
    print(f"{nome:<23}: errore {np.sqrt(e.mean()):.3f}  (dentro"
          f" {np.sqrt(e[:, ~bordo].mean()):.3f}, ai bordi {np.sqrt(e[:, bordo].mean()):.3f})")
media pesata, h = 0.005: errore 0.229  (dentro 0.228, ai bordi 0.239)
media pesata, h = 0.02 : errore 0.125  (dentro 0.120, ai bordi 0.159)
media pesata, h = 0.05 : errore 0.107  (dentro 0.089, ai bordi 0.202)
media pesata, h = 0.1  : errore 0.181  (dentro 0.147, ai bordi 0.357)
media pesata, h = 0.3  : errore 0.459  (dentro 0.466, ai bordi 0.392)
retta locale, h = 0.02 : errore 0.138  (dentro 0.123, ai bordi 0.231)
retta locale, h = 0.05 : errore 0.091  (dentro 0.082, ai bordi 0.146)
L’errore scende e poi risale al crescere della larghezza: \(0{,}229\) con la finestra strettissima, che insegue il rumore, \(0{,}107\) con \(h = 0{,}05\), \(0{,}459\) con una campana larga \(0{,}3\), quasi un terzo dell’intervallo, che appiattisce l’onda (e che ai bordi sbaglia meno che all’interno solo perché lì l’onda vale zero, come la curva appiattita). Alla migliore delle cinque larghezze la media pesata sbaglia ai bordi più del doppio che all’interno (\(0{,}202\) contro \(0{,}089\)), e la retta locale porta il bordo a \(0{,}146\) migliorando un poco anche l’interno. Con la finestra stretta di \(h = 0{,}02\), invece, al bordo la retta sbaglia più della media (\(0{,}231\) contro \(0{,}159\)): pochi punti tutti da un lato non bastano a fissarne la pendenza.
Da una curva a molte: i modelli additivi#
Spline e regressione a nucleo danno il meglio con una variabile sola. Con dieci colonne una funzione flessibile di tutte e dieci insieme chiederebbe una quantità di dati che nessuno ha: è la maledizione della dimensionalità incontrata a proposito del k-NN e appena ritrovata, come velocità, nella regressione a nucleo. In numeri: una griglia a \(10\) caselle per lato ne ha \(10\) in una dimensione, \(100\) in due, \(1000\) in tre e \(10^{10}\) in dieci, e per un esempio per casella ne servirebbero dieci miliardi.
La via d’uscita è rinunciare alle interazioni. Il modello additivo generalizzato (Generalized Additive Model, GAM), proposto da Trevor Hastie e Robert Tibshirani nel 1986 [HT86], scrive la risposta come una somma di funzioni di una colonna ciascuna, \(\theta_0 + f_1(x_1) + \dots + f_d(x_d)\), e stima ogni \(f_j\) con una spline («generalizzato» perché la somma può passare per una funzione di collegamento, come nella regressione logistica).
L’idea è di rinunciare a una cosa sola, e sapere a quale. Invece di chiedere «come varia il risultato al variare di tutte le colonne insieme», si chiede «come varia al variare di ciascuna colonna presa da sola», e poi si sommano le risposte. Con dieci colonne le curve da disegnare sono dieci, e dieci curve si disegnano anche con i pochi dati che uno ha.
Il prezzo dell’affitto, per dire. Una curva dice come cambia il prezzo al crescere dei metri quadri (sale, ma sempre meno: i primi cinquanta metri quadri valgono più dei cinquanta successivi). Un’altra dice come cambia con la distanza dal centro (scende in fretta nei primi chilometri e poi si appiattisce). Una terza mostra l’effetto dell’anno di costruzione, e non è affatto monotona: le case degli anni Sessanta valgono meno sia delle nuove sia di quelle d’epoca. Ogni curva la disegna una spline, e il prezzo stimato è la somma delle tre.
Le tre curve dicono uno scostamento, cioè di quanto si sale o si scende rispetto a un prezzo di partenza, che è scritto una volta sola per tutte e tre. Quell’accordo serve a poterle leggere. Senza, si potrebbe alzare di cento euro la curva dei metri quadri e abbassare di cento quella della distanza, ottenendo gli stessi identici prezzi con curve diverse, e nessuna delle tre vorrebbe più dire niente.
Come si trovano, quelle tre curve? Una per volta, a giri. Si prende il prezzo di ogni casa, gli si toglie quello che le altre due curve spiegano già, e quel che resta lo si affida alla curva dei metri quadri, che si adatta a seguirlo. Poi tocca alla distanza, tenendo ferme le altre due, poi all’anno di costruzione. Si ricomincia il giro, e a ogni giro le curve si muovono meno, finché smettono di muoversi.
Il guadagno che si vede subito è che quelle curve si possono guardare. Un modello che restituisce un numero solo non dice da dove viene quel numero; qui si disegnano tre grafici e si legge la forma di ciascun effetto, gobbe comprese, senza aver dovuto decidere in anticipo che forma avesse.
E la rinuncia qual è? Che gli effetti non si parlano fra loro. Il modello non può dire «i metri quadri contano di più se sei in centro»: quello è un effetto delle due colonne insieme, e in una somma di curve separate non c’è posto per scriverlo. Se nei dati veri quel legame c’è, il GAM lo manca, e lo manca in modo grosso, non per un pelo.
Un GAM sostituisce la parte lineare di un modello lineare generalizzato con una somma di funzioni univariate lisce:
dove \(d\) è il numero di colonne, \(g\) è la funzione di collegamento (identità per la regressione, logit per la classificazione, e in quest’ultimo caso il modello è la regressione logistica con le \(\theta_j x_j\) promosse a \(f_j(x_j)\)), e ogni \(f_j\) è una funzione liscia stimata dai dati, tipicamente una spline. Per identificabilità si impone \(\sum_{i} f_j(x_{ij}) = 0\) per ogni \(j\), dove \(i\) scorre sugli esempi e \(x_{ij}\) è la \(j\)-esima colonna dell’\(i\)-esimo: si scarica così il livello medio su \(\theta_0\).
La stima classica è il backfitting: si aggiorna ciclicamente
cioè si liscia il residuo parziale rispetto alla sola \(x_j\), e si ripete fino a convergenza. È lo schema «alterna, tenendo fermo tutto il resto» di \(k\)-means e di EM, nella sezione su riduzione e clustering. Se ogni \(\mathcal{S}_j\) è una proiezione, il procedimento converge alla soluzione dei minimi quadrati vincolati allo spazio additivo [BHT89].
Costruire un GAM con B-spline non richiede altro che quanto già visto: si espande ogni colonna nella sua base e si risolve un unico problema lineare regolarizzato. La complessità sale linearmente con il numero \(d\) di colonne, non esponenzialmente: è esattamente la maledizione della dimensionalità evitata per decreto, al prezzo di escludere dallo spazio delle ipotesi tutti i termini di interazione \(f_{jk}(x_j, x_k)\).
La garanzia che giustifica la rinuncia è di Stone [Sto85]: se il modello additivo è vero e ogni \(f_j\) è due volte derivabile, l’errore quadratico di stima converge come \(m^{-4/5}\), la velocità di una variabile sola, qualunque sia \(d\), contro l’\(m^{-4/(4+d)}\) della regressione a nucleo su tutte le colonne insieme. Se il modello non è additivo, il GAM converge alla proiezione della funzione vera sullo spazio delle somme additive, e paga per intero la varianza della parte che resta fuori. Nell’esperimento con l’interazione, con \(x_1, x_2\) indipendenti e uniformi su \([-2, 2]\), il prodotto \(1{,}5\,x_1x_2\) resta fuori tutto (\(\mathbb{E}[x_1x_2 \mid x_1] = 0\)), e la sua varianza vale \(1{,}5^2\cdot(4/3)^2 = 4\).
Il codice costruisce un GAM con gli attrezzi già in casa (una spline per colonna, sommate da una regressione lineare) e lo mette alla prova due volte: su dati che sono davvero una somma di effetti separati, e poi sugli stessi dati con dentro un’interazione. Il confronto è con un modello lineare da una parte e un gradient boosting dall’altra (gli alberi messi in fila, che la sezione seguente costruisce), cioè con il più rigido e il più libero dei vicini di casa.
import numpy as np
from sklearn.compose import ColumnTransformer
from sklearn.ensemble import HistGradientBoostingRegressor
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.model_selection import KFold, cross_val_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import SplineTransformer

rng = np.random.default_rng(0)
X = rng.uniform(-2, 2, (800, 3))
def forma(X):
    return np.sin(3*X[:, 0]) + 0.5*X[:, 1]**2 - 0.8*X[:, 2]
y = forma(X) + rng.normal(0, 0.2, 800)

def gam(nodi=8):
    """Un GAM: una spline per colonna, sommate da una regressione lineare."""
    per_colonna = ColumnTransformer(
        [(f"s{j}", SplineTransformer(n_knots=nodi, degree=3), [j])
         for j in range(X.shape[1])])
    return make_pipeline(per_colonna, Ridge(alpha=1e-3))

pieghe = KFold(5, shuffle=True, random_state=0)
def mse(m, bersaglio):
    return -cross_val_score(m, X, bersaglio, cv=pieghe,
                            scoring="neg_mean_squared_error").mean()

print(f"lineare            MSE = {mse(LinearRegression(), y):.4f}")
print(f"GAM (spline)       MSE = {mse(gam(), y):.4f}")
print(f"boosting           MSE = {mse(HistGradientBoostingRegressor(random_state=0), y):.4f}")
print(f"rumore vero              {0.2**2:.4f}")

# ora con un'interazione, che un GAM per costruzione non può vedere
y2 = forma(X) + 1.5*X[:, 0]*X[:, 1] + rng.normal(0, 0.2, 800)
print()
print("con interazione x1*x2:")
print(f"GAM (spline)       MSE = {mse(gam(), y2):.4f}")
print(f"boosting           MSE = {mse(HistGradientBoostingRegressor(random_state=0), y2):.4f}")
lineare            MSE = 0.7841
GAM (spline)       MSE = 0.0427
boosting           MSE = 0.0866
rumore vero              0.0400

con interazione x1*x2:
GAM (spline)       MSE = 4.4078
boosting           MSE = 0.2904
I quattro numeri in alto dicono una cosa che sorprende chi si aspetta una classifica di potenza. Il GAM arriva a \(0{,}0427\) contro un rumore vero di \(0{,}0400\): ha spremuto quasi tutto quello che c’era da spremere, e il resto è irriducibile. Il gradient boosting, che è un modello più flessibile, si ferma a \(0{,}0866\), il doppio. Non ha sbagliato niente: sta stimando da zero, a forza di gradini, una struttura additiva che il GAM aveva già scritto nella propria forma. Quando l’ipotesi è vera, dichiararla vale più che essere potenti.
I due numeri in basso pagano il conto della stessa scommessa. Aggiunta l’interazione, il GAM passa da \(0{,}0427\) a \(4{,}4078\), cioè cento volte peggio, mentre il boosting passa da \(0{,}0866\) a \(0{,}2904\). Il GAM perde esattamente la parte dell’interazione che non si scrive come somma di curve, e questa interazione è costruita per non avere nient’altro: con \(x_1\) e \(x_2\) indipendenti e simmetrici attorno allo zero, il prodotto \(x_1x_2\) non ha nessuna componente additiva, e il GAM non ne cattura niente. È il modo di sbagliare di un modello con un’ipotesi forte: perde tutto ciò che sta fuori dall’ipotesi, poco o tanto che sia, e prima di usarne uno bisogna sapere quale ipotesi si sta firmando.
Dove stanno, in pratica#
Le spline e i GAM occupano una posizione precisa fra la retta e i modelli del tutto liberi, e conviene fissarla, perché non è «un modello in più».
Sono la risposta giusta quando servono tre cose insieme: che l’effetto di una variabile sia curvo e non se ne conosca la forma; che quell’effetto vada mostrato a qualcuno, in un grafico che si legge senza sapere di statistica; e che i dati non siano tantissimi. La medicina e l’epidemiologia le usano da decenni per questa ragione, ed è anche il motivo per cui la sezione sui modelli trasparenti ci torna sopra: un GAM si guarda direttamente, senza bisogno che qualcuno venga dopo a spiegarlo.
Sono la risposta sbagliata quando le interazioni sono il cuore del problema, e quando i dati sono immagini, suono o testo: là non ci sono colonne con un significato proprio di cui abbia senso disegnare l’effetto, e il mestiere è di altri modelli.
Da ricordare
Un polinomio unico piegato troppo ondeggia, e i danni li fa ai bordi, dove niente lo tiene fermo dall’altra parte: è il fenomeno di Runge, e al grado 21 il polinomio sbaglia ai bordi undici volte il rumore che c’è nei dati, restando impeccabile al centro.
Una spline è la curva che prende il listello di legno dei cantieri navali quando le pendenze sono piccole: tante cubiche corte, giuntate in modo che sui paletti (i nodi) non si vedano né gradini né spigoli né scatti di curvatura.
Aggiungere flessibilità a una spline la aggiunge dove serve, un tratto per volta; aggiungerla a un polinomio la aggiunge ovunque.
La versione naturale obbliga la curva a proseguire dritta oltre gli estremi, cioè rende noiosi i bordi, che sono il posto dove i modelli fanno i danni.
La smoothing spline aggancia il listello ai punti con degli elastici e mette una manopola sulla rigidità del legno: da spago che passa per ogni punto a righello che non si piega. Girata tutta verso il rigido dà una retta, e il conto lo mostra: la flessibilità che resta è \(2{,}0026\) contro il \(2\) tondo di una retta vera.
La regressione a nucleo (la media che scivola) stima il valore in un punto con la media dei vicini, pesati da una campana. La larghezza della campana è la manopola (stretta insegue il rumore, larga appiattisce), e ai bordi, dove i vicini stanno da una parte sola, la media si storce: una retta locale al posto della media ne toglie gran parte, purché la finestra prenda abbastanza case.
Un GAM somma una curva per colonna: si vede la forma di ogni effetto, uno per uno. La rinuncia dichiarata è che gli effetti non si parlano fra loro: se nei dati due colonne contano insieme, il GAM non se ne accorge.
Da ricordare
L’interpolazione polinomiale su nodi equispaziati può divergere (Runge): la costante di Lebesgue cresce esponenzialmente e i polinomi hanno supporto globale, quindi ogni coefficiente agisce ovunque. Cambiare base cura il condizionamento, non la globalità.
Una spline cubica con \(K\) nodi è cubica a tratti con continuità di \(f\), \(f'\), \(f''\) nei nodi: \(4(K+1) - 3K = K+4\) gradi di libertà, che diventano \(K\) imponendo la naturalità (\(f'' = f''' = 0\) fuori dai nodi estremi).
La base operativa sono le B-spline, a supporto locale (quattro intervalli): matrice di disegno a banda e ben condizionata, finché ogni intervallo fra nodi contiene dati (condizione di Schoenberg e Whitney).
La smoothing spline minimizza \(\sum_i (y_i - f(x_i))^2 + \lambda \int f''^2\); il minimo su uno spazio di dimensione infinita è una spline cubica naturale con nodi nei dati. La complessità si misura con i gradi di libertà effettivi \(\operatorname{tr}(\mathbf{S}_\lambda)\), che vanno da \(m\) a \(2\). Nella base B-spline è una Ridge generalizzata, che non frena le rette.
La regressione a nucleo di Nadaraya-Watson è una media pesata, con pesi dati da una campana di larghezza \(h\) centrata in \(x_0\): distorsione \(O(h^2)\) e varianza \(O\big(1/(mh)\big)\) danno \(h \propto m^{-1/5}\) ed errore quadratico \(m^{-4/5}\). Al bordo la distorsione sale a \(O(h)\); la regressione lineare locale la riporta a \(O(h^2)\), pagandola in varianza (circa il triplo nel punto estremo), e all’interno toglie la distorsione di progetto \(f'p'/p\). Con nucleo gaussiano, chiavi di norma comune e \(h^2 = \sqrt{d_k}\) è l’attenzione dei Transformer, che in più impara le proiezioni da cui escono query e chiavi.
Un GAM pone \(g(\mathbb{E}[y \mid \mathbf{x}]) = \theta_0 + \sum_j f_j(x_j)\): costo lineare nel numero di colonne invece che esponenziale, al prezzo di escludere le interazioni. Si stima con il backfitting, cioè lisciando i residui parziali una variabile per volta; se il modello è vero l’errore va come \(m^{-4/5}\) qualunque sia \(d\) (Stone).
Il compromesso è misurabile in tutte e due le direzioni: su dati additivi il GAM batte un gradient boosting (MSE \(0{,}0427\) contro \(0{,}0866\), con rumore irriducibile \(0{,}0400\)); aggiunta un’interazione senza componente additiva, sale a \(4{,}4078\) perché ne perde tutta la varianza, mentre il boosting passa da \(0{,}0866\) a \(0{,}2904\).
C’è un filo che tiene insieme spline e GAM con gli alberi e le macchine a vettori di supporto: la domanda su quanta struttura mettere nel modello prima di guardare i dati. La retta ne mette troppa e non si piega; il polinomio ne toglie troppa e si piega dove non deve; la spline la rimette al posto giusto, dicendo che la curva deve essere dolce ma non che forma abbia, e la regressione a nucleo chiede la stessa dolcezza per un’altra strada, pesando i vicini invece di penalizzare le pieghe. Il GAM fa lo stesso un gradino più su, sulle colonne. Gli alberi decisionali fanno lo stesso mestiere con l’attrezzo opposto, spezzando la linea a gradini invece di piegarla.