


Pensare prima di agire: la ricerca ad albero Monte Carlo#
Finora la policy ha sempre risposto d’istinto: una funzione dallo stato all’azione, che la rete calcola in un solo passaggio, senza guardare avanti. Un giocatore forte, invece, prima di muovere prova qualche continuazione e ne valuta l’esito.
Quel calcolo ha un algoritmo, la ricerca ad albero Monte Carlo (Monte Carlo tree search, MCTS). Torna in AlphaGo e nei suoi successori, AlphaZero e MuZero, e in alcuni esperimenti sui modelli linguistici (i programmi che scrivono testo, come quelli dietro agli assistenti conversazionali) che esplorano più ragionamenti prima di rispondere. E sotto c’è un vecchio amico: a ogni bivio dell’albero si ripresenta il dilemma della sezione sui bandit, provare ciò che promette o ciò che si conosce poco.
La sezione sulle tre cose che la ricerca dava per scontate aveva lasciato la faccenda esattamente qui: la ricerca classica, per fermarsi a metà albero, ha bisogno di una formula che dia un voto alla posizione, e nel Go nessuno è mai riuscito a scriverla a mano. La via d’uscita era smettere di giudicare e mettersi a contare, cioè giocare da lì un mucchio di partite a caso e guardare come finiscono: un’idea semplice, che però va organizzata, perché le partite possibili sono troppe per giocarle tutte.
Una fila di leve, e dietro ognuna una stanza con un’altra fila di leve. Si tira, si passa di là, si tira ancora, e si va avanti finché una porta dà sull’uscita, dove si scopre di aver vinto o perso. Le strade sono troppe: agli scacchi, dopo tre mosse a testa, i seguiti sono milioni, e nel Go molti di più. Conviene andare a fondo solo dove rende, ma per sapere dove rende bisognerebbe esserci già stati. È il dilemma delle slot machine, i «bandit a più braccia» (una slot machine è un bandito con una leva sola, e qui di leve ce ne sono tante), che si ripresenta in ogni stanza.
Chi esplora si porta un blocchetto di foglietti. Ne appende uno accanto a ogni leva che prova, e ci tiene due cose: una tacca per ogni volta che l’ha tirata, e come è andata in media da lì in avanti. Poi torna all’ingresso e ricomincia, migliaia di volte.
Ogni giro sono quattro gesti. Finché trova foglietti, sceglie la leva che mette d’accordo il buon rendimento e le poche tacche, ed è la selezione; quanto pesi la curiosità rispetto al rendimento è una manopola, e si regola prima di cominciare. Alla prima leva senza foglietto gliene appende uno bianco, ed è l’espansione. Da lì tira a casaccio e in fretta fino all’uscita, solo per vedere come va a finire, ed è la simulazione. Poi rifà la strada al contrario e segna l’esito su ogni foglietto incontrato, ed è la risalita. Le stanze sono a turno, una sua e una di chi gioca contro, e per l’altro una vincita è una perdita: sui suoi foglietti lo stesso esito si segna al rovescio.
Dopo qualche migliaio di giri le stanze non risultano battute allo stesso modo, e di proposito: certi corridoi hanno foglietti fitti per venti stanze di fila, altri una tacca sola sulla prima leva.
Alla fine si tira per davvero la leva con più tacche, e non quella con la media migliore. Una media alta può venire da due colpi fortunati; una leva tirata mille volte ha resistito a mille occasioni di essere abbandonata.
Con un consiglio si arriva prima. All’ingresso c’è chi conosce il posto e segna, a occhio, le due o tre leve da provare per prime; i primi giri seguono quei segni invece di trattare tutte le leve alla pari. Poi il consiglio si diluisce da sé man mano che le tacche si accumulano: dopo mille tiri su una leva, quello che ha reso davvero pesa più di qualunque impressione a prima vista.
C’è un caso in cui tutto si impianta: la leva che porta al premio grosso ma le prime tre volte, per sfortuna, non dà niente. Il foglietto dice tre tacche e tre volte male, quindi la leva scivola in fondo alla lista, e per riportarla su servono moltissimi altri giri. Continuando all’infinito salta fuori davvero, ma «all’infinito» può voler dire un numero di giri che nessuno ha il tempo di fare. La leva più tirata è la più solida fra quelle guardate, e delle stanze in cui non si è mai entrati non si sa niente.
La formulazione standard è UCT (Upper Confidence bounds applied to Trees), di Kocsis e Szepesvári [KSzepesvari06], che porta UCB1 [ACBF02] dentro la pianificazione per simulazioni. Nello stesso anno, e indipendentemente, Coulom aveva proposto la ricerca in cui l’albero cresce insieme alle simulazioni, e le aveva dato il nome di Monte Carlo tree search [Cou06]. L’idea di UCT è di trattare ogni nodo come un bandit indipendente sulle sue mosse, e in fase di selezione scegliere
dove \(N(s)\) è il numero di visite al nodo, \(N(s,a)\) quelle al figlio, \(Q(s,a) = W(s,a)/N(s,a)\) la media dei ritorni osservati passando di lì e \(c>0\) la costante che decide quanto pesa il secondo termine. È letteralmente UCB1, la formula della sezione sui bandit, applicata a ogni bivio: stesso ottimismo di fronte all’incertezza, stesso decadimento logaritmico. Il contributo di UCT è mostrare che, applicandola ricorsivamente, la stima alla radice converge al valore ottimo: lo scarto della stima va come \(O(\log n / n)\) e la probabilità di scegliere alla radice un’azione non ottima tende a zero con velocità polinomiale nel numero \(n\) di simulazioni. Sono garanzie asintotiche, e va preso alla lettera: valgono nel limite, non nel caso peggiore. Coquelin e Munos [CM07] mostrarono l’anno dopo che l’ottimismo di UCT può costare, in alberi profondi e ostili, un numero di simulazioni proibitivo prima che la ricerca trovi il ramo buono, e proposero una variante con intervallo di confidenza che cresce esponenzialmente con la profondità: il prezzo di una garanzia vera. In pratica funziona; in teoria funziona alla lunga.
La risalita aggiorna \(N\) e \(W\) lungo il cammino; nei giochi a due giocatori il ritorno si alterna di segno a ogni livello, perché ciò che è buono per me è cattivo per l’avversario. A ricerca finita, alla radice si gioca l’azione più visitata e non quella con \(Q(s,a)\) massimo: un conteggio è meno sensibile di una media alla manciata di ritorni fortunati che l’ha gonfiata.
AlphaGo e i suoi successori cambiano due dei quattro passi, ed è lì che entrano le reti. Il termine di esplorazione diventa PUCT, pesato da una probabilità a priori fornita dalla rete di policy,
così che la ricerca guardi per prime le mosse che la rete considera plausibili invece di trattarle tutte alla pari; \(c_{\text{puct}}\) ha qui il ruolo che \(c\) aveva in UCT. La probabilità a priori pesa soprattutto all’inizio: il denominatore \(1 + N(s,a)\) ne diluisce il contributo man mano che le visite vere si accumulano, e da lì in poi a decidere è \(Q(s,a)\). (MuZero moltiplica il termine per un fattore che cresce, lentamente, col logaritmo delle visite al nodo.)
Il secondo cambiamento riguarda la valutazione della foglia, e avviene in due tappe da non confondere. AlphaGo (2016) non butta via la simulazione casuale: le affianca la rete di valore e media i due giudizi in parti uguali,
dove \(z_L\) è l’esito della simulazione, giocata fino in fondo con una policy veloce, e \(\lambda = 0{,}5\) (è il simbolo del paper, e non ha niente a che vedere con il \(\lambda\) della generalized advantage estimation incontrata col gradiente di policy: qui è soltanto il peso con cui si mescolano due giudizi). In gergo quella partita tirata via si chiama rollout, e la parola viene dal backgammon, dove per valutare una posizione la si giocava fino alla fine molte volte con i dadi tirati a caso [SB18]; la strategia svelta che la guida è la rollout policy. Rete di valore e partita tirata via pesano quindi identico. La simulazione casuale sparisce del tutto solo con AlphaGo Zero (2017), dove la rete di valore basta da sola: è la stessa tappa in cui spariscono le partite umane, e non è una coincidenza, perché entrambe le cose diventano superflue quando la rete è abbastanza buona da giudicare da sé.
Con AlphaGo Zero [SSS+17] la ricerca fa anche da maestro alla rete di policy. La distribuzione delle visite alla radice, normalizzata (così com’è nelle prime trenta mosse della partita, poi concentrata sulla più visitata), è una policy \(\boldsymbol{\pi}\) migliorata rispetto a \(P(s,\cdot)\), e diventa il bersaglio della rete \((\mathbf{p}, v) = f_\theta(s)\), addestrata su
dove \(z \in \{-1, +1\}\) è l’esito della partita di self-play e \(c\) il peso della regolarizzazione. Alla radice il prior riceve del rumore di Dirichlet, senza il quale la ricerca tornerebbe sempre sulle mosse che la rete preferisce già. Il termine PUCT di AlphaGo Zero, a differenza di UCB1, non ha il logaritmo e non eredita la garanzia di UCT: è un’euristica tarata sui dati, e sullo stesso albero profondo e ostile di Coquelin e Munos anche le varianti di AlphaGo e AlphaZero possono richiedere un numero di simulazioni doppiamente esponenziale nella profondità prima di raggiungere la foglia migliore [OM24]. MCTS, in questa lettura, è un operatore di miglioramento della policy: lo stesso ruolo che nella programmazione dinamica ha il passo di policy improvement, ottenuto con la ricerca invece che con un massimo esatto.
L’idea è più generale del gioco da tavolo, ed è il motivo per cui conviene averla in tasca: quando si può simulare, si può pensare. Il programma MuZero [SAH+20], per esempio, la usa senza nemmeno conoscere le regole del gioco: se le costruisce da solo, guardando le partite. E il modello che si costruisce non ridisegna la scacchiera pezzo per pezzo, ne tiene solo un riassunto interno, il minimo che serve per pianificarci dentro. La sezione sul RL basato su modello ci torna sopra. Ai modelli linguistici l’idea è stata applicata anche alla lettera: una ricerca ad albero fra i passi possibili di un ragionamento, con una rete addestrata a giudicare quali promettono. I modelli che ragionano a lungo e di cui si conosce la ricetta, però, si addestrano per lo più con il gradiente di policy, su ragionamenti scritti un passo dopo l’altro, senza albero.
In pratica: le visite si concentrano#
Che la ricerca concentri le visite dove il gioco promette, e che l’albero cresca quindi storto, profondo da una parte e appena accennato dall’altra, si verifica facilmente. Prendiamo un albero giocattolo: due strade a ogni bivio e quattro bivi in fila, cioè \(2\times2\times2\times2 = 16\) finali possibili, ognuno con il suo valore. Un valore alto lo piantiamo noi, nascosto in mezzo agli altri, e qual è il migliore dei sedici lo sappiamo comunque: l’algoritmo no, e il gioco è vedere se ci arriva. A giocare è uno solo, quindi nella risalita lo stesso ritorno si somma a tutti i nodi del cammino, senza il cambio di segno dei giochi a due. Due parole di gergo, che tornano nel codice e nei risultati: la radice è il punto di partenza dell’albero, le foglie sono le sue punte, cioè i sedici finali.
Una precauzione, prima di leggere i numeri. Se lancio un dado una volta e fa sei, non posso dire che quel dado fa sempre sei: ho misurato quel lancio, non il dado. Lo stesso vale per un algoritmo che a ogni passo tira a sorte. Quindi l’esperimento sull’albero giocattolo si lancia sessanta volte, cambiando ogni volta il seme, cioè il numero da cui parte il sorteggio. Dentro un computer il caso è una sequenza calcolata e non vero caso, che dipende tutta da quel numero iniziale: cambiarlo è il modo di rifare l’esperimento daccapo. Di ciò che ne esce non si guarda un singolo risultato: si guardano il valore di mezzo (la mediana: la metà delle sessanta prove sta sotto, l’altra metà sopra) e gli estremi.
import math
import numpy as np

# Un albero giocattolo: profondità 4, due mosse per nodo, 16 foglie.
# I valori delle foglie li conosciamo, così sappiamo qual è la risposta giusta.
PROFONDITA, RAMI = 4, 2
PRIME = (RAMI ** PROFONDITA - 1) // (RAMI - 1)   # indice della prima foglia

def figli(nodo):
    return [nodo * RAMI + 1 + k for k in range(RAMI)]

def foglia(nodo):
    return nodo >= PRIME

def cerca(seme, giri=2000):
    """Una partita di MCTS completa, con il proprio seme casuale."""
    rng = np.random.default_rng(seme)
    valori_foglie = rng.uniform(0, 1, RAMI ** PROFONDITA)
    valori_foglie[6] = 0.98                  # la foglia buona, nascosta in mezzo
    migliore = int(valori_foglie.argmax())
    N, W = {0: 0}, {0: 0}                    # visite e somma dei ritorni

    def uct(nodo, c=1.4):
        """UCB1 su un bivio dell'albero: è la formula della sezione bandit."""
        padre = N[nodo]
        def punteggio(f):
            if N.get(f, 0) == 0:
                return float("inf")          # mai provato: massimamente urgente
            return W[f] / N[f] + c * math.sqrt(math.log(padre) / N[f])
        return max(figli(nodo), key=punteggio)

    def simula(nodo):
        """Discesa a caso fino a una foglia: la stima grezza di questo nodo."""
        while not foglia(nodo):
            nodo = int(rng.choice(figli(nodo)))
        return valori_foglie[nodo - PRIME]

    for _ in range(giri):
        nodo, cammino = 0, [0]
        while not foglia(nodo) and all(N.get(f, 0) > 0 for f in figli(nodo)):
            nodo = uct(nodo)                                      # 1. SELEZIONE
            cammino.append(nodo)
        if not foglia(nodo):
            nodo = next(f for f in figli(nodo) if N.get(f, 0) == 0)  # 2. ESPANSIONE
            cammino.append(nodo)
            N[nodo] = W[nodo] = 0
        ritorno = simula(nodo)                                    # 3. SIMULAZIONE
        for n in cammino:                                         # 4. RISALITA
            N[n] += 1
            W[n] += ritorno

    visite = np.array([N.get(PRIME + i, 0) for i in range(RAMI ** PROFONDITA)])

    def ramo(i):                             # da quale ramo della radice pende
        f = PRIME + i
        while (f - 1) // RAMI != 0:
            f = (f - 1) // RAMI
        return f

    n = ramo(migliore)                       # il ramo che porta alla foglia buona
    altro = next(f for f in figli(0) if f != n)
    return {
        "rami": [N[f] for f in figli(0)],
        "quota": visite[migliore] / visite.sum(),
        "ramo_buono": N[n],
        "azzecca": N[n] == max(N[f] for f in figli(0)),   # la mossa più visitata
        # di quanto la foglia migliore batte la migliore dell'altro ramo:
        # dice se una scelta sbagliata e' un errore o un pareggio
        "scarto": valori_foglie[migliore] - max(
            valori_foglie[i] for i in range(RAMI ** PROFONDITA) if ramo(i) == altro),
    }

e = cerca(seme=7)
print(f"seme 7 | visite ai due rami dalla radice: {e['rami']}")
print(f"seme 7 | quota delle visite sulla foglia migliore: {e['quota']:.1%}")
print(f"         tirando a caso sarebbe stata: {1 / RAMI ** PROFONDITA:.1%}")

# Lo stesso esperimento su sessanta semi: quanto è rappresentativo quel numero?
prove = [cerca(s) for s in range(60)]
quote = np.array([p["quota"] for p in prove])
buoni = np.array([p["ramo_buono"] for p in prove])
print(f"\n60 semi | quota sulla foglia migliore: mediana {np.median(quote):.1%}, "
      f"da {quote.min():.1%} a {quote.max():.1%}")
print(f"          metà centrale fra {np.percentile(quote, 25):.1%} "
      f"e {np.percentile(quote, 75):.1%}")
print(f"          visite al ramo giusto: mediana {np.median(buoni):.0f}, "
      f"da {buoni.min()} a {buoni.max()}")
sbagliati = np.array([not p["azzecca"] for p in prove])
scarti = np.array([p["scarto"] for p in prove])
print(f"          la mossa più visitata è il ramo sbagliato in "
      f"{sbagliati.sum()} semi su 60")
print(f"          in quei semi la foglia migliore batte l'altro ramo di "
      f"{np.median(scarti[sbagliati]):.3f}, contro {np.median(scarti):.3f} su 60")
Sul seme \(7\), quello dell’esempio, il ramo che porta alla foglia buona riceve 1922 visite su 2000 e l’altro \(78\). La ricerca ha concentrato le visite, ma non ha mai smesso di guardare di là: il termine di esplorazione di UCB1 cresce col logaritmo delle visite al padre, e un ramo trascurato abbastanza a lungo torna prima o poi in cima alla lista. In fondo all’albero, il \(58\%\) di tutte le visite finisce sulla foglia migliore, contro il \(6{,}2\%\) che le toccherebbe tirando a caso, cioè una foglia su sedici.
Su sessanta semi, però, quella quota ha mediana \(50{,}5\%\) e oscilla fra il \(16\%\) e l’\(89\%\); scartando le quindici prove più basse e le quindici più alte, le trenta di mezzo stanno fra il \(33\%\) e il \(60\%\). Le visite al ramo giusto hanno mediana \(1582\) e vanno da \(593\) a \(1965\), cioè il \(1922\) del seme \(7\) è vicino al massimo osservato. In nove semi su sessanta il ramo più visitato alla radice non è quello che contiene la foglia migliore. Guardati da vicino, però, quei nove sono pareggi e non errori. Là dove la regola «si gioca la mossa più visitata» sceglie l’altro ramo, la foglia migliore lo batte di \(0{,}004\), contro lo \(0{,}032\) mediano su tutte e sessanta le prove: la ricerca sta scegliendo fra due rami che valgono quasi lo stesso. Che «si gioca la mossa più visitata» resti una regola pratica, e non una certezza, non lo dicono questi nove semi: lo dice il fatto che la garanzia di UCT vale soltanto alla lunga, con un numero di simulazioni che cresce senza limite.
La quota oscilla, la forma no: l’albero cresce storto su tutti e sessanta i semi, e mai una volta le visite si distribuiscono uniformemente. Ma se avessimo tenuto il solo numero del seme \(7\), con la sua bella cifra decimale, l’algoritmo sarebbe sembrato più preciso di quanto sia, e la regola della mossa più visitata più sicura di quanto sia. È il motivo per cui in questo campo i risultati si riportano su molte ripetizioni, e non su una.
Da AlphaGo ad AlphaZero#
Torniamo alla mossa 37. AlphaGo [SHM+16] non era un solo algoritmo, ma una sintesi: una rete di policy che proponeva mosse promettenti, una rete di valore che stimava chi fosse in vantaggio, e la ricerca ad albero Monte Carlo appena vista, che usava entrambe per esplorare in profondità solo le linee più sensate.
Per giudicare una posizione raggiunta in fondo alla ricerca, AlphaGo (2016) non si affidava soltanto alla rete di valore: ne faceva la media, a parti uguali, con l’esito di una partita tirata avanti alla svelta fino alla fine. Con AlphaGo Zero, l’anno dopo, basterà la rete da sola.

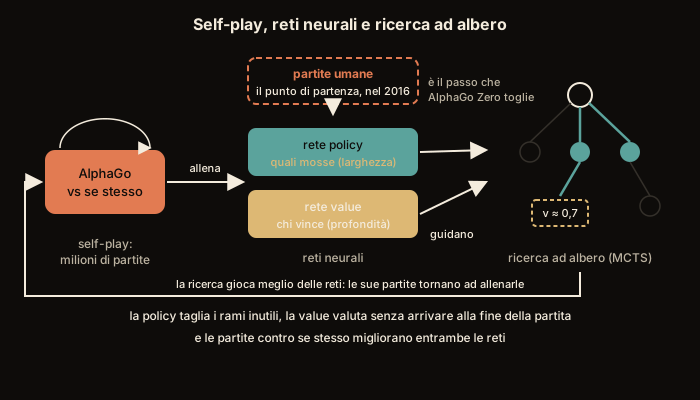
Fig. 14.7 Il giro che si alimenta da solo, e il gradino da cui il giro parte. Nel 2016 quel gradino sono ancora le partite umane; è il pezzo tratteggiato, ed è il primo che i successori toglieranno.#
Il ciclo di Fig. 14.7 è il motivo per cui i successori di AlphaGo poterono fare a meno delle partite umane, e poggia su un fatto da enunciare da solo: la ricerca gioca meglio delle due reti che la guidano. La rete propone guardando la sola posizione; la ricerca, prima di decidere, prova davvero migliaia di continuazioni (AlphaGo Zero ne fa \(1600\) per mossa, circa quattro decimi di secondo di calcolo). Con abbastanza simulazioni la mossa che esce dalla ricerca è migliore di quella che la rete avrebbe scelto da sola, ed è un esempio su cui la rete può allenarsi.
Ecco la fonte di supervisione interna: non serve un maestro, basta giocare contro sé stessi e imparare da dove la ricerca ha portato. Nel 2016 AlphaGo questo giro lo faceva solo a metà: la rete di policy aveva imparato prima a imitare le partite umane e poi si era affinata giocando contro sé stessa; la rete di valore invece si era allenata soltanto su posizioni prese da quelle partite contro sé stessa, perché sulle partite umane, dove posizioni consecutive quasi identiche condividono lo stesso esito, imparava a memoria i risultati invece di stimarli.
Un anno dopo, AlphaGo Zero [SSS+17] elimina persino le partite umane: parte dalle sole regole del Go e impara tabula rasa, dal nulla, soltanto affrontando copie di sé, fino a battere nettamente la versione che aveva sconfitto Lee Sedol. Nel 2018 AlphaZero [SHS+18] generalizza la ricetta: lo stesso programma, senza ritocchi per gioco, padroneggia Go, scacchi e shogi (gli scacchi giapponesi), e in tutti e tre batte il programma più forte del momento; nel Go, quel programma è il suo stesso predecessore. È la dimostrazione più limpida di cosa nasce dall’unione di apprendimento per rinforzo, ricerca ad albero e reti profonde.
Un ultimo salto: allineare i modelli linguistici#
Lo stesso meccanismo (aumentare la probabilità di ciò che riceve un giudizio positivo) è oggi al cuore della fase di allineamento dei modelli linguistici, quella che segue il loro addestramento sui testi.
Allineare un modello vuol dire portarlo a fare ciò che chi lo interroga intende davvero. Non è scontato, perché un modello linguistico nasce sapendo fare una cosa sola: indovinare come prosegue un testo. A «spiegami perché il cielo è azzurro» un continuatore di testi può rispondere benissimo con un’altra domanda, o con l’indice di un libro di fisica: sono continuazioni plausibili, e non sono la risposta che si voleva. L’allineamento serve a chiudere quella distanza.

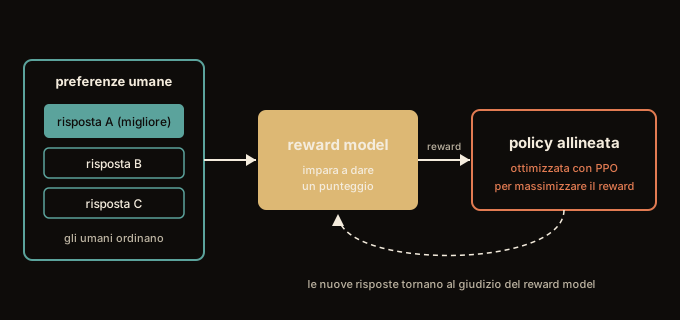
Fig. 14.8 Il giudizio umano che diventa un numero. Le persone non danno voti: mettono in fila delle risposte, ed è il reward model (il modello di ricompensa) a tradurre quell’ordine in un punteggio che l’ottimizzazione sa usare.#
Il dettaglio di Fig. 14.8 da notare è il primo riquadro: alle persone si chiede di ordinare, non di valutare. Confrontare due risposte è un giudizio che gli esseri umani danno con buona coerenza fra loro; assegnare un voto da uno a dieci molto meno, e su scale diverse. Nell’RLHF (Reinforcement Learning from Human Feedback, cioè apprendimento per rinforzo dal giudizio umano; [CLB+17], [OWJ+22]) le risposte del modello sono l’»azione», i valutatori umani indicano quali preferiscono, e le loro preferenze addestrano un modello di ricompensa, che da lì in poi assegna il premio a ogni risposta. Con PPO si ritocca poi la policy del modello (la sua tendenza a produrre certe risposte), verso ciò che gli umani apprezzano, e una penalità tiene la policy vicina al modello di partenza; la misura di quella distanza (la divergenza di Kullback-Leibler) e il resto dei dettagli li scrive per intero la sezione sul post-addestramento. La stessa idea che ha portato una macchina a giocare la mossa 37 aiuta oggi un assistente a rispondere in modo utile e onesto.
Il disegno comincia dagli ordinamenti, ma prima c’è un passo che non si vede: il modello viene addestrato a imitare risposte scritte da persone, cioè a copiare quello che avrebbe fatto qualcuno di bravo. Si chiama clonazione comportamentale, ed è la scorciatoia più ovvia di tutte: la sezione sull’imitazione ci torna sopra per esteso, e spiega perché da sola non basta.
Da ricordare
La ricerca ad albero Monte Carlo è il «pensare prima di muovere»: migliaia di volte si scende nell’albero delle possibilità scegliendo dove conviene, si prova un ramo nuovo, si tira fino alla fine e si riporta indietro il risultato. L’albero cresce storto di proposito, profondo dove promette e appena accennato altrove, e la mossa scelta è la più visitata, non quella con la media più alta. È però una regola pratica e non un teorema, e a garantirla è soltanto il comportamento alla lunga: su sessanta ripetizioni l’albero cresce storto sempre, ma quanto storto cambia parecchio, e nei nove casi in cui la mossa più visitata non porta alla foglia migliore i due rami valgono quasi lo stesso. È il motivo per cui i risultati si contano su molte prove e non su una.
AlphaGo e AlphaZero uniscono la strategia, la stima di chi sta vincendo e quella esplorazione ad albero. Nel 2016 la ricerca si fidava a metà della rete e a metà delle partite tirate a caso; solo con AlphaGo Zero, l’anno dopo, la rete basta da sola. Con l’RLHF la stessa coppia di strategia e giudice, con il giudice addestrato sulle preferenze delle persone, allinea i modelli linguistici.
Da ricordare
MCTS/UCT applica UCB1 a ogni nodo dell’albero, \(Q(s,a) + c\sqrt{\ln N(s)/N(s,a)}\), e alterna selezione, espansione, simulazione e risalita; le garanzie sono asintotiche, non sul caso peggiore. AlphaGo sostituisce il termine di esplorazione con PUCT, pesato dalla policy a priori, e media rete di valore e rollout (\(\lambda=0{,}5\)); la simulazione casuale sparisce solo con AlphaGo Zero. La distribuzione delle visite alla radice è una policy migliorata: è l’operatore che rende possibile il self-play.
AlphaGo/AlphaZero uniscono policy, valore e ricerca ad albero; RLHF applica PPO all’allineamento degli LLM.