


Scene che si addestrano: NeRF e splatting#
Nel 1999, per la scena in cui Neo schiva i proiettili piegandosi all’indietro mentre la telecamera gli gira attorno, le sorelle Wachowski avevano un anello di macchine fotografiche vere, montate su una struttura, che scattavano in sequenza. Il computer c’entrava eccome (fra uno scatto e l’altro i fotogrammi mancanti venivano ricavati al calcolatore da quelli vicini, e sfondi e raccordi erano ricostruiti in digitale), ma il vincolo che conta era fisico: se la telecamera doveva passare per un punto, in quel punto ci doveva essere una macchina fotografica. Il bullet time costò una sala di posa e un impianto costruito apposta, ed è la risposta di forza bruta a una domanda che la visione artificiale si pone da sempre: come si ottiene l’immagine da un punto di vista in cui nessuno è mai stato?
La domanda si chiama sintesi di nuove viste, ed è il rovescio esatto di quella della sezione precedente. Là partivamo dalle immagini per ricavare la geometria; qui vogliamo tornare alle immagini, da posizioni nuove. Per decenni le strade sono state due. La prima è ricostruire un modello tridimensionale (una superficie fatta di triangoli, con le fotografie incollate sopra come si incolla la carta da parati) e poi renderizzarlo, cioè calcolare che aspetto avrebbe visto da una certa posizione, con la grafica tradizionale. La seconda è saltare la geometria e interpolare direttamente fra le fotografie, come fanno i campi di luce e il rendering basato su immagini, a patto di avere viste molto fitte [Sze22]. La prima funziona, e fallisce esattamente dove il mondo non è fatto di superfici nette: capelli, foglie, fumo, vetro, riflessi.
Nel 2020 un articolo di sei autori di Berkeley, San Diego e Google propose di smettere di ricostruire l’oggetto e di addestrare una funzione \(F_\theta\) che a ogni punto dello spazio, guardato da una direzione, associa un colore e una densità [MST+20]. Nessuno la scrive: la si addestra, ed è una rete, un piccolo percettrone multistrato. Il metodo si chiama NeRF, dall’inglese neural radiance field, cioè «campo di radianza neurale»: radianza è il termine tecnico per la luce che parte da un punto in una certa direzione, e campo vuol dire che quel valore è definito in ogni punto dello spazio, come la temperatura dentro una stanza. L’idea è semplice, e in un paio d’anni ha cambiato il modo in cui si fa la sintesi di nuove viste.
Una scena che risponde a domande#
Il modello a triangoli di cui si diceva è, a guardarlo bene, un elenco di cose: questo triangolo sta qui, quest’altro là, sopra ci va questa immagine. È un archivio, e come tutti gli archivi ha una risoluzione: più triangoli, più dettaglio, più memoria.
Un campo di radianza risponde invece a una domanda. La domanda è: «in questo punto dello spazio, visto da questa direzione, di che colore è la materia che c’è, e quanto è solida?». La scena diventa un oggetto che sa rispondere a quella domanda in ogni punto e per ogni direzione, e la risposta la dà una piccola rete neurale. Il colore del pixel si ottiene dopo, mettendo insieme le risposte di tutti i punti che il raggio attraversa.
Due conseguenze, che all’inizio suonano strane. La prima: la scena non ha una griglia. Puoi chiedere il colore in un punto qualsiasi, anche fra due punti che nessuna foto ha guardato da vicino. L’immagine che ne ricavi, sì: quella la disegni tu, con tutti i pixel che vuoi, e se ne vuoi il doppio fai il doppio di domande. È la differenza fra una fotografia, che ha i pixel che ha, e una formula, a cui puoi chiedere quanti valori ti pare. Quanto fine sia il dettaglio, però, non lo decidono le domande: lo decide quanto la rete ha saputo imparare, e oltre quel limite più domande danno soltanto più sfocatura. La seconda: la rete non è addestrata su altre scene e non «sa» cosa siano gli alberi o le sedie. Viene addestrata su questa scena e su nient’altro, a partire dalle foto che le hai dato, e quando hai finito quella rete è quella scena. È quella stanza lì, scritta in forma di pesi, e non un modello di come sono fatte le stanze.
Il colore dipende anche dalla direzione, ed è così che un riflesso si sposta mentre giri attorno a un tavolo lucido, cosa che un colore incollato su un triangolo non sa fare. Quanto un punto è solido, invece, non cambia con la direzione: il riflesso si sposta, il tavolo sta dov’è. La rete quella regola non l’ha scoperta, gliela si impone da fuori, e serve a una cosa precisa: se anche la solidità potesse cambiare da un punto di vista all’altro, ogni fotografia potrebbe avere la sua sagoma privata, e nessuna dovrebbe rendere conto alle altre.
Un campo di radianza neurale è una funzione
realizzata da un percettrone multistrato: in ingresso una posizione nello spazio e una direzione di vista, in uscita un colore RGB \(\mathbf{c}\) e una densità volumetrica \(\sigma \geq 0\), che si interpreta come probabilità differenziale che un raggio venga fermato in quel punto.
Due scelte architetturali del lavoro originale sono cariche di significato. La prima è che \(\sigma\) dipende solo da \(\mathbf{x}\), mentre \(\mathbf{c}\) dipende da entrambi: è un vincolo imposto a mano che impedisce alla rete di inventare una geometria diversa per ogni punto di vista, ma da solo non garantisce che la geometria sia quella giusta (lo si vede con il rendering volumetrico, poco più avanti). La seconda è che la direzione entra tardi, negli ultimi strati, così che il grosso della capacità sia speso sulla struttura e non sull’aspetto.
La rappresentazione è implicita e continua: non esiste una griglia, e la scala più fine rappresentabile non la fissa una risoluzione ma la capacità della rete e la frequenza più alta della codifica d’ingresso (quella che si incontra più avanti, con la codifica posizionale); la memoria occupata è quella dei pesi (nel lavoro originale una manciata di megabyte per scena, contro i gigabyte di una griglia voxel di pari qualità). In cambio, \(F_\theta\) è ottimizzata per una singola scena: è una compressione con perdita di quel particolare insieme di fotografie, più che un modello che generalizza, in una forma che si può interrogare da punti di vista nuovi.
Il rendering volumetrico, e perché è differenziabile#
Avere una funzione che risponde punto per punto non basta: bisogna trasformare quelle risposte in un’immagine. Il passaggio è la parte più importante di tutto il meccanismo, ed è fisica ottocentesca invece che una rete: per la precisione la legge con cui la luce si spegne attraversando qualcosa di torbido, che porta i nomi di Beer e Lambert e ha quasi due secoli.
Che il rendering sia differenziabile vuol dire che autograd attraversa l’intera catena, dal pixel reso fino ai pesi della rete: lungo quella strada nessun passo fa un salto brusco o prende una decisione secca del tipo «qui mi fermo», che interromperebbe il gradiente.

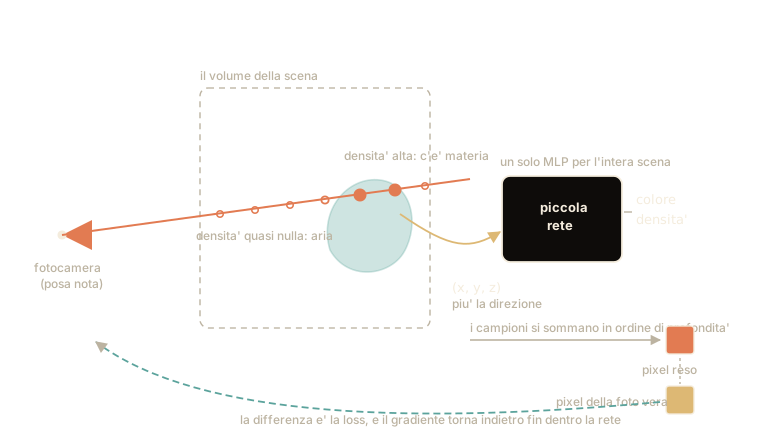
Fig. 11.14 Il ciclo che addestra un campo di radianza. Per ogni pixel si lancia un raggio, si campionano dei punti, si interroga la rete, si compone il risultato in ordine di profondità e si confronta con la foto vera. Di ogni passaggio si sa come cambierebbe il risultato cambiando un numero, quindi la correzione rifà la strada all’indietro.#
Segui Fig. 11.14. Dall’obiettivo della fotocamera parte un filo teso che attraversa la scena, e sul filo si infilano qualche decina di quadratini di carta velina, uno per ogni punto da guardare. Il colore di ciascuno, e quanto è fitto, li dice la rete, a cui si chiede punto per punto che colore c’è lì e quanto è solido. Guardando il filo di punta, dalla parte dell’obiettivo, i quadratini si sovrappongono in una macchia di colore sola, e quella macchia è un pixel.
I quadratini non contano tutti uguale. Si va dal primo all’ultimo tenendo il conto di quanta luce le veline già incontrate lasciano passare. Una velina quasi trasparente conta poco anche se sta davanti a tutte; una fitta conta pieno se è la prima, e quasi niente se ne ha un’altra fitta davanti, che la nasconde. La seconda vale per quel che passa della prima, la terza per quel che passa delle prime due, e così fino in fondo al filo.
Lungo il filo nessuno dice mai «qui comincia una superficie, mi fermo». Nessun quadratino viene scelto e nessuno scartato: si moltiplica e si somma, e di una catena di moltiplicazioni e somme si sa sempre dire come cambierebbe il risultato se un numero fosse un pochino più grande. Così la macchia si mette accanto al pixel vero della fotografia, si guarda di quanto sbagliano, si torna indietro lungo il filo a vedere quali veline dovevano essere più chiare o più rade, e si corregge la rete. Poi da capo, per milioni di pixel presi a caso da tutte le foto. Le superfici nessuno le ha mai indicate alla rete, e vengono fuori da sole.
Resta da decidere a che distanze infilare i quadratini. A distanze fisse la rete sarebbe interrogata sempre negli stessi posti, imparerebbe bene quelli e male ciò che sta in mezzo, e la scena uscirebbe a scalini. Si taglia allora il filo in tratti uguali, e dentro ogni tratto il quadratino va in un punto pescato a caso. Quasi tutti finiscono nell’aria vuota, dove non c’è niente da vedere, quindi si fa un primo giro rado per capire dove c’è qualcosa, e un secondo che infittisce solo lì. Anche il giro rado si confronta con le foto e si corregge: se no non imparerebbe mai a dire dove conviene infittire.
Con una fotografia sola la rete se la caverebbe piantando un muro dipinto davanti all’obiettivo, che da lì si vede identico alla foto e della scena non dice niente. Ma dal punto della seconda fotografia quel muro si vede di taglio, e non somiglia a niente. Ogni fotografia in più butta via una montagna di soluzioni comode, e con qualche decina di fotografie prese tutt’attorno le sagome che le spiegano tutte insieme, senza contraddirne nemmeno una, sono sostanzialmente quelle vere. Non le sole, però: anche una sagoma sbagliata può mettere d’accordo tutte le foto, se la si dipinge con colori che cambiano molto in fretta a seconda di dove la si guarda. La rete di solito non ci cade, perché colori così le riescono male e scivola verso la spiegazione più semplice. Garanzie però non ce ne sono, e dove ha guardato una fotografia sola, o nessuna, la rete mette quello che le pare.
Il colore di un raggio \(\mathbf{r}(t) = \mathbf{o} + t\mathbf{d}\) fra i limiti \(t_n\) e \(t_f\) è l’integrale del rendering volumetrico:
\(T(t)\) è la trasmittanza: la frazione di luce che arriva fino a \(t\) senza essere stata assorbita. È la legge di Beer-Lambert, e il suo effetto è che un punto contribuisce in proporzione a quanto è denso e a quanto è libera la strada davanti a lui.
In pratica l’integrale si valuta per quadratura su \(N\) campioni con passo \(\delta_i = t_{i+1} - t_i\), supponendo \(\sigma\) e \(\mathbf{c}\) costanti dentro ciascun intervallo. Sotto questa ipotesi la formula che segue è esatta, e l’approssimazione sta tutta nel campionamento: dove i campioni sono radi una superficie più sottile di \(\delta_i\) può sparire del tutto:
Chi conosce la grafica riconoscerà l’alpha compositing classico: la forma discreta è esattamente il «sopra» di Porter e Duff, con l’opacità ricavata dalla densità. I pesi \(w_i = T_i \alpha_i\) formano una distribuzione lungo il raggio, e la loro massa \(\sum_i w_i\) è l’opacità totale, mentre \(\sum_i w_i t_i\) è la profondità attesa: una mappa di profondità si ottiene gratis, senza una supervisione dedicata. Attenzione però che quella è una somma pesata, non una media: i \(w_i\) sommano a uno solo se il raggio è completamente opaco, e dove non lo è la profondità va divisa per \(\sum_i w_i\), altrimenti risulta sistematicamente più corta del vero.
Con una rete sola la loss è la più elementare possibile, l’errore quadratico sui pixel resi rispetto a quelli osservati, sommato sui raggi di un batch:
Ogni operazione della catena (interrogazione della rete, esponenziali, prodotti cumulati, somma pesata) è derivabile, quindi \(\nabla_\theta \mathcal{L}\) si ottiene per differenziazione automatica come per qualunque altra rete del libro. Il rendering differenziabile è tutto il trucco: la supervisione arriva solo dalle immagini, e la struttura tridimensionale emerge come la spiegazione più semplice fra quelle coerenti con tutte insieme. Non è l’unica possibile. Una geometria sbagliata riproduce le viste di addestramento se a ogni punto della superficie si sceglie ad arte il colore emesso in ogni direzione: è l’ambiguità fra forma e radianza (shape-radiance ambiguity) [ZRSK20]. NeRF di solito la evita, secondo l’ipotesi degli autori di quell’analisi, per due ragioni: quel colore dovrebbe variare molto in fretta con la direzione, cosa che un MLP di capacità limitata rappresenta male, e la direzione entra nella rete soltanto vicino all’uscita, il che favorisce colori che cambiano dolcemente. Garanzie non ce ne sono.
Restano due accorgimenti pratici del lavoro originale. I campioni non stanno a posizioni fisse, altrimenti la rete viene valutata sempre negli stessi punti e la rappresentazione si discretizza: si divide \([t_n, t_f]\) in \(N\) intervalli uguali e in ciascuno se ne estrae uno a caso,
E si campiona in due fasi (hierarchical sampling), perché spendere calcolo nell’aria vuota è sprecarlo. Una rete grossolana valuta \(N_c = 64\) campioni e ne ricava i pesi \(w_i\); normalizzati come \(\hat{w}_i = w_i/\sum_j w_j\), definiscono lungo il raggio una densità costante a tratti, da cui si estraggono per trasformata inversa altri \(N_f = 128\) campioni, dove i pesi sono grandi. Una rete fine valuta tutti gli \(N_c + N_f\) campioni e rende il colore finale. Con due reti la loss ha due termini,
dove \(\hat{C}_c\) e \(\hat{C}_f\) sono i colori resi dalla rete grossolana e da quella fine. La grossolana impara soltanto dal proprio termine, perché il gradiente non attraversa il campionamento. Ogni raggio costa così \(64 + 192 = 256\) valutazioni della rete, e un’immagine \(800 \times 800\), cioè \(640\,000\) raggi, circa \(1{,}6 \cdot 10^8\): è il costo che i metodi successivi hanno fatto crollare.
Perché serve la codifica posizionale#
C’è un dettaglio che, tolto, fa collassare il metodo in un’immagine sfocata: le reti fanno una gran fatica a imparare tutto ciò che cambia in fretta da un punto all’altro. È un limite che il capitolo sulle PINN (le reti a cui si insegna una legge fisica) ritroverà davanti alle soluzioni che passano da un valore all’altro in uno spazio brevissimo, i cosiddetti fronti ripidi. Qui si presenta per la prima volta, e con la soluzione in mano.
Una rete alimentata direttamente con le coordinate \((x, y, z)\) impara facilmente le cose che cambiano lentamente nello spazio e con enorme fatica quelle che cambiano in fretta. Un muro uniforme lo prende subito; il bordo netto fra il muro e la finestra, o la trama del legno, quasi mai. Il risultato è una scena giusta ma smarrita nella nebbia.
Il rimedio è sorprendente: invece di dare alla rete le coordinate, le si danno molte onde di quelle coordinate. Onde regolari come quelle disegnate su un sismografo (in matematica si chiamano seno e coseno): la coordinata entra in un’onda e ne esce un numero fra \(-1\) e \(1\), che dice a che punto dell’onda si trova. Di onde se ne usano una decina, ciascuna fitta il doppio della precedente.
Il guadagno si vede con due numeri. I punti \(0{,}30\) e \(0{,}31\) sono quasi identici, e per la rete distinguerli è una tortura. Passati per l’onda più lenta restano quasi identici, come previsto. Ma passati per la decima, che è cinquecento volte più fitta, uno cade nel cavo dell’onda e l’altro dalla parte opposta, ben sopra lo zero: due valori lontanissimi. La rete non deve più spaccare il capello, le basta guardare l’onda giusta.
La stessa formula, con lo stesso nome di codifica posizionale, tornerà nel capitolo sui Transformer, ma per un altro problema. Là una rete che non ha nessun senso dell’ordine deve sapere in quale posto della frase sta ogni parola; qui le onde servono a far arrivare alla rete le variazioni rapide di una coordinata che cambia con continuità. Stessa forma, scopo diverso.
Il fenomeno è lo spectral bias: una rete densa apprende le componenti di Fourier a bassa frequenza in poche iterazioni e quelle ad alta frequenza in un numero molto maggiore [RBA+19]. Per un campo di radianza è letale, perché il dettaglio visivo è alta frequenza.
La soluzione è mappare l’ingresso in uno spazio di dimensione maggiore prima di darlo alla rete:
applicata a ciascuna delle tre coordinate (con \(L = 10\) nel lavoro originale) e alle componenti della direzione (con \(L = 4\)). Non è un espediente. Nel regime del neural tangent kernel, dove una rete larga addestrata a passi piccoli si comporta come una regressione con un nucleo fisso nel senso del kernel trick (il prodotto scalare fra i gradienti della rete nei due punti, non la media pesata di Nadaraya-Watson), l’errore lungo ogni autovettore del nucleo cala con una velocità proporzionale al suo autovalore. Per un MLP con ingresso a bassa dimensione gli autovalori calano rapidamente con la frequenza, e le alte frequenze richiedono un numero di passi impraticabile. Tancik e colleghi mostrano che le Fourier features rendono il nucleo stazionario, con una banda che si regola scegliendo le frequenze [TSM+20]. La mappa presuppone coordinate normalizzate, in NeRF dentro \([-1, 1]\): la frequenza più alta, \(2^{L-1}\pi\), fissa la scala più fine rappresentabile, e una \(L\) troppo grande produce rumore ad alta frequenza invece che dettaglio.
La forma coincide con la codifica posizionale dei Transformer, sinusoidi a frequenze scalate geometricamente, ma lo scopo è un altro, e gli autori di NeRF lo precisano nel punto in cui la introducono. Nei Transformer la codifica fornisce le posizioni discrete dei token a un’architettura che non ha alcuna nozione di ordine; qui mappa coordinate continue in uno spazio di dimensione maggiore, perché l’MLP approssimi più facilmente una funzione ad alta frequenza [MST+20]. Cambiano anche il dominio (posizioni intere in una sequenza contro coordinate reali in \(\mathbb{R}^3\)) e la scelta delle frequenze, che qui si fa in base alla risoluzione più fine che si vuole rappresentare.
Il costo, e come è crollato#
Il NeRF originale era splendido e proibitivo: uno o due giorni di addestramento su una GPU per una scena sola, e decine di secondi per rendere un fotogramma. Con quei numeri il metodo è un articolo, non una tecnologia. In due anni l’addestramento è sceso a pochi minuti e il fotogramma a pochi millisecondi, e la ragione per cui è successo è istruttiva.
Il conto è impietoso: per ogni pixel, fra il giro rado e quello fitto, servono un paio di centinaia di interrogazioni della rete, e un’immagine ha centinaia di migliaia di pixel. Se la rete è grande, non si finisce più. L’idea che ha sbloccato tutto è stata smettere di chiedere alla rete di ricordare anche dove stanno le cose, e darle un aiuto.
Sulla scena si appoggia una griglia, e in ogni nodo della griglia c’è un foglietto con sopra qualche numero. Quando si chiede il colore di un punto, non si costringe più la rete a ricordarsi tutto da sé: si vanno a leggere i foglietti dei nodi vicini, si mescolano fra loro secondo quanto sono vicini, e si passa alla rete il risultato. La rete deve solo interpretare quei numeri, non memorizzare la scena, e quindi può essere piccolissima. C’è anche chi ha tolto la rete del tutto, scrivendo sui foglietti direttamente il colore e la solidità: funziona, ma i foglietti diventano così tanti da riempire gigabyte.
I numeri sui foglietti all’inizio sono a caso, e si imparano esattamente come si impara tutto il resto: si rende un pixel, si vede quanto è sbagliato e si corregge all’indietro fino ai foglietti, ritoccandoli un pochino. E le griglie non sono una sola ma una quindicina, dalla più larga alla più fitta, così che una sappia dov’è il tavolo e un’altra dove sono le venature del legno.
I foglietti però sono contati, molti meno dei nodi delle griglie più fitte. Ogni nodo trova il suo con una regoletta fissa, che dalle coordinate del nodo calcola il numero di un foglietto, e capita che due nodi lontanissimi fra loro finiscano sullo stesso. Nessuno va a sbrogliare l’equivoco, e passa lo stesso, per due ragioni. Di due nodi che si dividono un foglietto quasi sempre uno sta nell’aria vuota, dove nessun pixel sbagliato reclama niente, e allora sul foglietto finisce scritto quello che serve all’altro, il nodo dove la materia c’è davvero. E le griglie sono tante, ognuna con la sua regoletta: due nodi che si pestano i piedi su una griglia finiscono su foglietti diversi in tutte le altre. Quando invece a dividersi il foglietto sono due nodi che stanno tutti e due su una superficie, quella griglia non sa più a quale dei due dare ragione, e il dettaglio lo devono recuperare le altre.
È lo stesso baratto che si incontra ovunque nell’informatica: memoria contro calcolo, come tenere le tabelline scritte su un foglio invece di rifare la moltiplicazione ogni volta. Qui la memoria costa poco e il calcolo costava tantissimo, e spostare il peso da una parte all’altra ha accorciato l’addestramento di diversi ordini di grandezza.
Instant-NGP tiene una rete minuscola e sostituisce la codifica sinusoidale con una codifica hash multirisoluzione: una sequenza di livelli di griglia a risoluzioni geometricamente crescenti, ciascuno con una tabella di vettori di feature addestrabili indicizzata da una funzione hash spaziale. Per un punto si interpolano trilinearmente i vettori degli otto vertici di ogni livello, si concatenano, e si dà il risultato a due MLP minuscoli: uno per la densità, con un solo strato nascosto da 64 unità, e uno per il colore, con due [MullerESK22].
La parte controintuitiva è che le collisioni della tabella hash non si risolvono: si lasciano. Il gradiente medio di due punti che collidono è dominato da quello dove c’è densità, perché la regione vuota contribuisce poco alla loss. Inoltre i livelli a risoluzione diversa collidono in modi diversi, quindi l’ambiguità di un livello viene sciolta dagli altri. Il risultato è un addestramento di ordini di grandezza più veloce, con qualità paragonabile, e un fotogramma in alta definizione reso in qualche decina di millisecondi.
Negli stessi mesi c’era anche chi toglieva la rete del tutto: Plenoxels [FKYT+22] ottimizza direttamente una griglia sparsa di coefficienti, densità e armoniche sferiche per il colore, e sui banchi di prova abituali raggiunge la qualità di NeRF cento volte più in fretta, a costo di gigabyte di memoria per scena. La codifica hash arriva a velocità simili con una memoria di due ordini di grandezza più piccola: nella tabella di confronto di Kerbl e colleghi Plenoxels occupa fra 2,1 e 2,7 GB per scena, Instant-NGP fra 13 e 48 MB [KKLeimkuhlerD23].
Il passaggio va letto per quello che è: una parte sostanziale della rappresentazione si è spostata dai pesi a una struttura dati esplicita e addestrabile. Il campo continuo resta, ma non è più tutto dentro l’MLP.
Splatting: dai raggi ai granelli#
Nel 2023 lo stesso obiettivo è stato raggiunto da un’altra direzione, cambiando la rappresentazione invece del modo di ottimizzarla.
Il rendering per raggi ha un costo strutturale: bisogna cercare dove sta la materia lungo ogni raggio, e la maggior parte dei campioni cade nel vuoto. E se invece di cercare la materia partendo dall’occhio, si partisse dalla materia e la si proiettasse sullo schermo?
È l’idea dello splatting, dall’inglese splat, il rumore di una cosa morbida che si spiaccica: la scena si rappresenta come qualche milione di granelli sfumati. Ciascuno ha la sua posizione, la sua forma (schiacciata, allungata, orientata come serve), il suo colore (che come prima cambia a seconda di dove ti metti a guardare) e la sua trasparenza. Per fare un’immagine, si spiaccica ogni granello sullo schermo, si ordinano dal più vicino al più lontano e si sovrappongono in quell’ordine. L’ordine conta perché un granello davanti nasconde in parte quello dietro, ed è la stessa somma pesata di prima: chi viene prima conta pieno, chi viene dopo conta per quel che resta. Nessuna ricerca, nessun campionamento a vuoto, e le schede grafiche fanno questo tipo di lavoro da trent’anni: è il loro mestiere.
Un’approssimazione c’è, e sta nella proiezione. Un granello ovale resta un ovale pulito finché lo si guarda più o meno in faccia; verso i bordi dell’inquadratura la prospettiva lo storce, e il conto continua a trattarlo come un ovale. Al centro dell’immagine non lo noti, agli angoli sì, ed è lì che conviene andare a cercare i difetti.
Il risultato è che la scena si guarda in tempo reale, muovendosi liberamente, con la stessa qualità di prima. E l’addestramento resta quello di sempre: confronta con le foto, correggi. Solo che qui a essere corretti sono posizione, forma, colore e trasparenza dei granelli, non i pesi di una rete, e ogni tanto si aggiungono granelli dove il dettaglio manca e si tolgono dove sono inutili.
Il prezzo è la memoria: milioni di granelli, ciascuno con una sessantina di numeri, pesano centinaia di megabyte, dove la rete di NeRF ne pesava pochi. E dove le foto hanno guardato poco i granelli si sistemano male: vengono fuori macchie allungate, e qualche granello grosso compare e sparisce di scatto mentre ci si muove.
Il 3D Gaussian Splatting rappresenta la scena con un insieme di gaussiane tridimensionali anisotrope, ciascuna definita da un centro \(\boldsymbol{\mu}\), una covarianza \(\boldsymbol{\Sigma}\) (parametrizzata come \(\mathbf{R} \mathbf{S} \mathbf{S}^\top \mathbf{R}^\top\) con scala e rotazione separate, per mantenerla semidefinita positiva durante l’ottimizzazione), un’opacità e dei coefficienti di armoniche sferiche per il colore dipendente dalla direzione [KKLeimkuhlerD23].
La proiezione di una gaussiana 3D sul piano immagine è ancora, con buona approssimazione, una gaussiana 2D, il che rende il rendering una rasterizzazione invece di un ray marching: si ordina per profondità e si compone con la stessa somma \(\hat{C} = \sum_i \mathbf{c}_i\, \alpha_i \prod_{j<i} (1 - \alpha_j)\), dove però l’opacità non viene da una densità integrata lungo il raggio ma dalla gaussiana proiettata valutata nel pixel \(\mathbf{u}\), \(\alpha_i = o_i \exp\!\big(-\tfrac{1}{2}(\mathbf{u} - \boldsymbol{\mu}'_i)^\top \boldsymbol{\Sigma}'^{-1}_i (\mathbf{u} - \boldsymbol{\mu}'_i)\big)\), con \(o_i\) l’opacità appresa e \(\boldsymbol{\mu}'_i\), \(\boldsymbol{\Sigma}'_i\) centro e covarianza proiettati. L’ordinamento si fa una volta per tile di \(16 \times 16\) pixel, sui centri delle gaussiane, e non pixel per pixel: dove due gaussiane si compenetrano l’ordine può scattare fra un fotogramma e l’altro. Le gaussiane infine, nelle scene reali, non partono a caso: nascono sulla nuvola di punti che la structure from motion produce insieme alle pose. Il rendering, poi, sfrutta appieno l’hardware grafico. Con una precisazione che il metodo non nasconde: sotto la prospettiva vera, che divide per \(Z\), l’immagine di una gaussiana non è una gaussiana. Lo diventa se la proiezione si linearizza localmente, e la covarianza proiettata è allora \(\boldsymbol{\Sigma}' = \mathbf{J}\mathbf{W}\boldsymbol{\Sigma}\mathbf{W}^\top \mathbf{J}^\top\), dove \(\mathbf{W}\) è la trasformazione di vista e \(\mathbf{J}\) lo jacobiano dell’approssimazione affine della proiezione (è la ricetta dello splatting con filtro ellittico della grafica volumetrica). Lo scarto si vede ai bordi dell’inquadratura, dove la linearizzazione è peggiore. Gli autori riportano sintesi di nuove viste in tempo reale (\(\geq\) 30 fotogrammi al secondo) a risoluzione 1080p, con qualità pari a quella dei migliori campi di radianza allora pubblicati e tempi di addestramento competitivi.
La qualità, qui come in tutta la sintesi di viste, si misura su fotografie tenute fuori dall’addestramento, rendendole dalle loro pose e confrontandole con gli originali. Le misure sono tre, e il verso va detto per ciascuna: il PSNR, \(10\log_{10}(\mathrm{MAX}^2/\mathrm{MSE})\) in decibel, cioè l’errore quadratico in scala logaritmica, dove più alto è meglio; l’SSIM, che confronta luminanza, contrasto e struttura su finestre locali, dove più alto è meglio, fino a un massimo di \(1\) [WBSS04]; e infine LPIPS, la distanza fra le attivazioni di una rete addestrata, dove più basso è meglio, e che segue meglio delle altre due il giudizio umano sulle sfocature [ZIE+18]. Anche la loss è diversa da quella di NeRF: è \(\mathcal{L} = (1-\lambda)\,\mathcal{L}_1 + \lambda\,\mathcal{L}_{\text{D-SSIM}}\), l’errore assoluto sui pixel combinato con un termine strutturale, con \(\lambda = 0{,}2\).
L’ottimizzazione alterna discesa del gradiente sui parametri e un controllo adattivo della densità: le gaussiane con gradiente di posizione grande vengono clonate (se piccole, la scena è sotto-ricostruita: manca geometria e serve coprirla) o divise (se grandi, la scena è sovra-ricostruita: una sola gaussiana copre un’area larga dentro cui c’è dettaglio da articolare), e quelle quasi trasparenti vengono rimosse. È una rappresentazione esplicita che si comporta come una continua, e chiude il cerchio: il pendolo torna verso le primitive geometriche, ma con la loss differenziabile del rendering neurale.
La velocità si paga in memoria. Ogni gaussiana porta 59 numeri (3 per il centro, 3 per la scala, 4 per la rotazione scritta come quaternione, 1 per l’opacità e 48 coefficienti di armoniche sferiche, quattro bande per tre canali), cioè 236 byte in virgola mobile a 32 bit, e una scena ne conta milioni: nei dati del lavoro originale la memoria va da 411 a 734 MB, contro gli 8,6 MB di Mip-NeRF 360 e i 13-48 MB di Instant-NGP. E gli autori elencano i propri limiti: artefatti nelle zone osservate male, gaussiane allungate o a macchie, e salti improvvisi (popping) quando l’ottimizzazione crea gaussiane grandi o quando l’ordinamento cambia da un fotogramma all’altro, aggravati dall’assenza di qualunque regolarizzazione [KKLeimkuhlerD23].
Cosa questo cambia, e cosa resta difficile#
Cosa funziona. Servono da qualche decina a un centinaio di fotografie di una scena ferma, cioè quello che si raccoglie girandoci attorno col telefono in un paio di minuti, e bisogna sapere da dove sono state scattate. Con alcuni minuti di calcolo per le griglie hash, e qualche decina per lo splatting alla qualità più alta, se ne ricava una rappresentazione che si guarda da punti di vista nuovi, trasparenze e riflessi compresi, e con lo splatting in tempo reale.
Cosa serve: le pose delle fotocamere, che arrivano dalla structure from motion della sezione precedente, con le conseguenze che lì si sono viste quando sono sbagliate. La geometria classica è diventata l’infrastruttura su cui il metodo poggia.
Cosa resta aperto, o aperto solo in parte:
Nei metodi originali si addestra una scena alla volta, e il modello di ieri non aiuta la scena di oggi. Esistono modelli addestrati su moltissime scene che ne ricostruiscono una nuova in un solo passaggio, anche da una o poche viste [YYTK21], e altri che ricavano la geometria di una coppia di fotografie senza conoscerne le pose [WLC+24]; a parità di viste fitte, rispetto all’ottimizzazione su una scena sola, pagano in qualità.
Le scene sono statiche. Estendere al tempo (persone che si muovono, foglie che oscillano) è possibile ed è materia di ricerca attiva, ma aggiunge una dimensione a un problema che già ammette più soluzioni (in gergo, mal posto).
Modificare è difficile. Una mesh (l’elenco di triangoli di cui si diceva all’inizio) si modifica: si sposta un vertice, si cambia una texture. Un campo di radianza è una funzione appresa, e «sposta quella sedia» non è un’operazione che abbia un senso ovvio. Lo splatting, essendo esplicito, sta un po’ meglio, ed è una delle ragioni della sua fortuna.
Su una cosa conviene non lasciarsi trascinare: questi metodi non capiscono la scena. Non sanno che c’è una sedia, non sanno che il tavolo continua dietro il vaso, non sanno cosa succederebbe spingendolo. Sono un’interpolazione straordinariamente buona fra le fotografie che hanno visto. La differenza fra saper rigenerare le apparenze di un mondo e averne un modello è precisamente il tema del capitolo sui world model, e questi sistemi stanno tutti dalla parte delle apparenze.
In pratica: la composizione lungo un raggio#
Il cuore del metodo, la somma pesata lungo il raggio, sono cinque righe di NumPy e si può guardare da vicino senza addestrare niente. Costruiamo un raggio che attraversa sei metri di vuoto con una superficie opaca a quattro metri, e guardiamo quanto conta ciascun punto. Attenzione a una parola che qui cambia mestiere: nel codice si chiamano pesi i numeri che dicono quanto ogni punto del raggio conta nel colore finale, e non hanno niente a che vedere con i pesi di una rete.
import numpy as np

def rendi_raggio(sigma, colori, delta):
    """Composizione volumetrica lungo un raggio.
    sigma: densità per campione; colori: (N,3); delta: passo fra i campioni."""
    alpha = 1.0 - np.exp(-sigma * delta)                 # quanto ogni campione occlude
    trasmittanza = np.cumprod(np.concatenate([[1.0], 1.0 - alpha[:-1]]))
    pesi = trasmittanza * alpha                          # quanto ogni campione conta
    return (pesi[:, None] * colori).sum(axis=0), pesi

N, lunghezza = 60, 6.0
delta = lunghezza / N                                    # 10 cm fra un campione e l'altro
t = np.arange(N) * delta                                 # 0.0, 0.1, ... 5.9 metri

# vuoto, e a quattro metri una superficie opaca
sigma = np.where(np.isclose(t, 4.0), 60.0, 0.0)
colori = np.tile(np.array([0.71, 0.33, 0.17]), (N, 1))   # terracotta

C, pesi = rendi_raggio(sigma, colori, delta)
print("colore reso       :", [round(float(c), 3) for c in C])
print("massa dei pesi    :", round(float(pesi.sum()), 4))
print("profondità attesa :", round(float((pesi * t).sum()), 3), "m")

# la stessa scena riempita di nebbia: nessuna superficie, i pesi si spalmano
C2, pesi2 = rendi_raggio(np.full(N, 0.45), colori, delta)
print("massa con la nebbia:", round(float(pesi2.sum()), 4))
print("picco dei pesi    :", round(float(pesi2.max()), 4),
      "contro", round(float(pesi.max()), 4), "della superficie")
colore reso       : [0.708, 0.329, 0.17]
massa dei pesi    : 0.9975
profondità attesa : 3.99 m
massa con la nebbia: 0.9328
picco dei pesi    : 0.044 contro 0.9975 della superficie
Tre numeri da leggere con attenzione.
Quanto conta, in tutto, il raggio? Se si sommano i pesi di tutti i sessanta punti viene \(0{,}9975\): la superficie ferma il \(99{,}75\%\) della luce e il restante quarto di punto percentuale passa oltre. È fisica, non un errore di calcolo. La luce che attraversa qualcosa di torbido non si spegne di colpo: cala di una frazione fissa per ogni tratto percorso, e dopo tanti tratti ne resta sempre un pochino, mai esattamente zero. Il conto lo si può rifare. La densità del campione è \(60\) e il suo spessore \(0{,}1\) metri, e il loro prodotto, \(60 \times 0{,}1 = 6\), dice quante volte la luce viene tagliata. Ogni taglio la riduce a \(0{,}368\) di quel che era: è la frazione che la legge di Beer-Lambert lascia passare per ogni unità di quel prodotto, \(1/e\), l’inverso del numero di Nepero. Sei tagli la riducono a \(0{,}368\) moltiplicato per sé stesso sei volte, cioè a \(0{,}0025\), un quattrocentesimo: è proprio il quarto di punto percentuale che passa oltre la superficie.
A che distanza sta la superficie? Il codice non l’ha mai calcolato, eppure lo sa: basta fare la media delle distanze dei sessanta punti pesandole per quanto ciascun punto conta. I punti che contano zero non spostano niente, quello sulla superficie si prende tutto, e viene \(3{,}99\) metri. È così che da un campo di radianza esce gratis anche una mappa di profondità.
Non viene esattamente quattro, ed è un dettaglio su cui è facile sbagliare. I pesi sommano a \(0{,}9975\) e non a uno, quindi quella è una somma e non ancora una media. Per farne una media va divisa per il totale dei pesi, e \(3{,}99 / 0{,}9975\) dà esattamente \(4{,}00\) metri, cioè dove la superficie sta davvero. Chi salta quella divisione ottiene mappe di profondità sistematicamente più corte del vero, e tanto più corte quanto più la scena è semitrasparente.
E se non c’è nessuna superficie? Nel caso della nebbia il punto che conta di più conta \(0{,}044\), contro lo \(0{,}9975\) di prima: nessuno comanda, il contributo si spalma su tutto il raggio. È la firma numerica di «qui non c’è un muro, c’è del torbido», ed è la ragione per cui questi metodi rendono bene il fumo e la foschia, dove una superficie fatta di triangoli non saprebbe che pesci pigliare.
Da ricordare
Un campo di radianza è una risposta a una domanda e non un elenco di triangoli: «in questo punto, visto da questa direzione, di che colore è la materia, e quanto è solida?». In NeRF a rispondere è una piccola rete, addestrata su quella scena sola e su nient’altro: finito l’addestramento, quella rete è quella scena.
Il colore di un pixel si ottiene lanciando un raggio e sommando i colori dei punti che incontra, ciascuno per quel che pesa: conta poco chi è trasparente, e conta poco anche chi sta dietro a qualcosa di opaco. È lo stesso conto di più vetrate sovrapposte, o della nebbia.
Di ogni passaggio del conto si sa dire come cambierebbe il risultato cambiando un numero: perciò basta confrontare il pixel calcolato con la foto vera e correggere all’indietro. Nessuno dice mai alla rete dove sono le superfici: la forma compare da sola, perché la rete trova la più semplice che mette d’accordo tutte le fotografie insieme. Garanzie non ce ne sono, e dove le foto sono poche può sbagliare.
Se alla rete si danno le coordinate nude, la scena esce sfocata: bisogna darle molte onde di quelle coordinate, sempre più fitte, così che due punti vicini smettano di somigliarsi. È la stessa formula della codifica posizionale dei Transformer, messa a servire un altro scopo.
I tempi sono crollati in due mosse: affiancare alla rete una tabella di appunti indicizzata per posizione, così che la rete possa essere minuscola; e poi smettere di cercare la materia lungo i raggi, rappresentandola come milioni di granelli sfumati da proiettare sullo schermo (è quello che le schede grafiche sanno fare da trent’anni), al prezzo di molta più memoria.
Serve sapere dove stava e da che parte guardava ogni fotocamera, e lo dice la sezione precedente: se quelle posizioni sono sbagliate, il risultato è una nuvola confusa, non solo impreciso.
Questi metodi non capiscono la scena: la sanno rifare. Non sanno che c’è una sedia, né che il tavolo continua dietro il vaso.
Da ricordare
Un campo di radianza rappresenta una scena come una funzione \((\mathbf{x}, \mathbf{d}) \mapsto (\mathbf{c}, \sigma)\), non come un elenco di triangoli: continua, senza griglia, e addestrata su una scena sola.
Il colore di un pixel si ottiene per composizione volumetrica lungo un raggio, \(\hat{C} = \sum_i T_i \alpha_i \mathbf{c}_i\): legge di Beer-Lambert, cioè l’\(\alpha\)-blending della grafica. I pesi \(w_i = T_i \alpha_i\) danno gratis anche la profondità, purché si ricordi che è una somma pesata e va normalizzata per la loro massa.
Tutta la catena è differenziabile, quindi basta confrontare i pixel resi con le foto vere: la geometria emerge da sola, come la spiegazione più semplice coerente con tutte le immagini insieme, senza garanzia di unicità (shape-radiance ambiguity). Nessuno la supervisiona.
Senza codifica posizionale il metodo produce nebbia: è lo spectral bias, lo stesso limite che il capitolo sulle PINN ritroverà, e la soluzione ha la forma sinusoidale della codifica posizionale dei Transformer, con un altro scopo: rendere rappresentabili le alte frequenze di una funzione continua.
Il costo è crollato spostando la rappresentazione dai pesi a una struttura dati addestrabile (Instant-NGP, codifica hash multirisoluzione) e poi passando dai raggi ai granelli (3D Gaussian Splatting), che rasterizza invece di marciare e rende in tempo reale, al prezzo di linearizzare localmente la prospettiva e di centinaia di megabyte per scena.
Le pose delle fotocamere restano l’ingresso dei metodi che ottimizzano una scena alla volta, e vengono dalla structure from motion: la geometria classica è diventata l’infrastruttura.
Questi metodi non capiscono la scena: la sanno rigenerare. È un’interpolazione eccellente fra le viste osservate, non un modello del mondo.
Fin qui la domanda è stata sempre che aspetto abbia la scena da un altro punto di vista. Il trasferimento di stile ne fa un’altra: che aspetto avrebbe la stessa foto se l’avesse dipinta qualcun altro. E ci arriva con una rete che non ricostruisce niente: la usa soltanto per guardare.