


Lo spazio latente: Stable Diffusion#
Il 22 agosto 2022 compare online un file da circa quattro gigabyte: i pesi di Stable Diffusion, cioè tutto quello che la rete ha imparato, rilasciati in forma aperta. Averli vuol dire avere il modello, ed è da quel rilascio che la generazione di immagini è diventata un fenomeno pubblico. Il modello è nato dai latent diffusion models del gruppo di Björn Ommer all’Università Ludwig Maximilian di Monaco [RBL+22], sviluppato con Runway e addestrato con la potenza di calcolo di Stability AI. La novità non è la qualità delle immagini (DALL·E 2 e Imagen, usciti pochi mesi prima, erano già impressionanti) ma le condizioni: quei modelli vivevano nei data center dei loro proprietari, accessibili con il contagocce dietro liste d’attesa e interfacce controllate. Stable Diffusion invece si scarica. Chiunque, gratis, può metterlo sul proprio computer, e per farlo girare basta la GPU di un computer da videogiochi, cioè il processore grafico, quel pezzo che nei giochi disegna le immagini a schermo e che qui fa i conti del modello. Nel giro di poche settimane i forum si riempiono di immagini, spuntano interfacce grafiche amatoriali, plugin per Photoshop e Blender, versioni modificate per ogni gusto. La generazione di immagini smette di essere una demo da guardare e diventa uno strumento da usare.
La domanda è che cosa lo renda possibile tecnicamente. Non un modello più grande: al contrario, uno più piccolo. La diffusione smette di lavorare sui pixel e si sposta su una rappresentazione compressa dell’immagine, decine di volte più piccola, dove ogni valutazione della rete costa una frazione. Il guadagno si misura in conti da fare, cioè in secondi di attesa e in memoria occupata sulla GPU: meno numeri da elaborare, meno conti, meno attesa.
La compressione la fa una rete a sé, diversa da quella che toglie il rumore, e la conosciamo già: è il variational autoencoder del capitolo sui modelli latenti, che la sezione sull’ELBO deriva per intero. Qui serve per un solo mestiere, comprimere e ricostruire, che non è quello per cui di solito lo si costruisce: a generare penserà la diffusione.
Il prezzo dei pixel#
Facciamo due conti. Nella sezione su come funziona la diffusione un’immagine era una griglia di numeri, uno per pixel, perché la guardavamo in bianco e nero. A colori i numeri per pixel diventano tre, uno per ciascuno dei colori con cui uno schermo compone tutti gli altri (rosso, verde, blu). Un’immagine a colori di \(512 \times 512\) pixel è fatta quindi di \(512 \times 512 \times 3 = 786\,432\) numeri. Il restauratore (la U-Net [RFB15] che predice il rumore) deve elaborarli tutti, e deve farlo a ogni passo di pulitura: centinaia o migliaia di passaggi per una sola immagine. Con le centinaia di macchine di un laboratorio si può fare; su un computer di casa no.
Ed è uno spreco, per una ragione precisa: la maggior parte di quei 786.432 numeri non descrive che cosa c’è nell’immagine, ma dettagli percettivi (la grana dell’intonaco, il micro-rumore del sensore, la trama del pelo). La compressione JPEG si fonda su questo da trent’anni: scarta gran parte dei bit e l’occhio quasi non se ne accorge. Un modello di diffusione che lavora sui pixel spende quindi la parte del leone del suo sforzo a modellare dettagli ad alta frequenza (i dettagli piccolissimi, quelli che cambiano da un pixel al suo vicino) che contano poco, e solo una frazione a decidere le cose importanti: dov’è il gatto, dov’è il muro, da che parte arriva la luce.
L’idea di Robin Rombach, Björn Ommer e colleghi [RBL+22] è dividere il lavoro tra due specialisti. Una prima rete impara la compressione percettiva: trasforma i pixel in una rappresentazione compatta che conserva il contenuto e scarta il dettaglio ricostruibile. La diffusione, poi, impara la composizione dentro quello spazio compatto, dove ogni passo costa decine di volte meno.
Quello spazio compatto è lo spazio latente del capitolo sui modelli latenti: l’insieme dei valori che può prendere \(\mathbf{z}\), la variabile che non si osserva (latente da latere, stare nascosto) e che la rete si costruisce da sola. Lo si era incontrato anche nei codec neurali, dove dentro c’era del suono; qui ci sono immagini; e cambia soprattutto che cosa ci si fa. Per un codec quello spazio è un corridoio: ci si entra da una parte per comprimere e si esce dall’altra. Qui invece ci si va ad abitare, perché è lì che avverrà tutta la diffusione. La ricetta si chiama infatti dei latent diffusion models, e Stable Diffusion ne è il figlio famoso.
L’archivista: il variational autoencoder#
Il pezzo che comprime è il variational autoencoder (VAE) di Diederik Kingma e Max Welling [KW14], del 2014, quindi più vecchio della diffusione moderna e persino delle GAN. Con lui viene anche la metafora della sezione su comprimere e ricostruire, che qui accompagna il resto del capitolo: la rete che comprime è un archivista e la rappresentazione compatta che scrive è la sua scheda; la rete che ricostruisce è un copista, che dalla scheda ridipinge il quadro. Da qui in avanti «scheda» vorrà dire sempre e solo questo.
Di quel capitolo qui serve una cosa sola, ed è la differenza fra la clessidra semplice, l’autoencoder, e la sua variante: la clessidra impara a comprimere e nient’altro, perché il suo unico voto è quanto la copia somiglia all’originale, e in quello spazio non si può pescare. Il VAE aggiunge due cose: un margine di tolleranza (l’encoder restituisce una media e una deviazione standard invece di un punto) e una penalità che tiene la distribuzione dei codici vicina a un centro comune, il prior. In Stable Diffusion la penalità pesa pochissimo e serve a una cosa sola, impedire che il latente prenda una scala arbitraria; lo spazio in cui la diffusione lavora lo modellano soprattutto il margine, la compressione convoluzionale e le due perdite in più con cui l’autoencoder è addestrato, una percettiva e una avversaria.

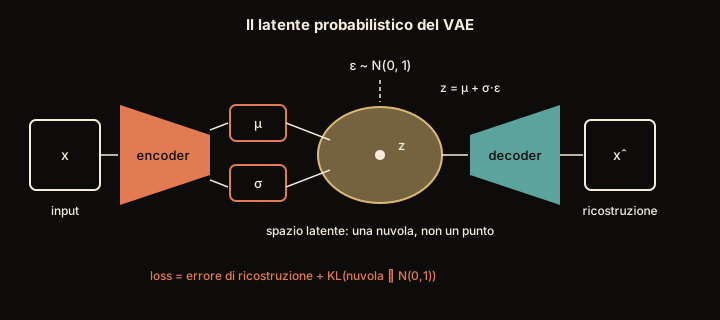
Fig. 27.6 La rete che comprime non restituisce una scheda sola, ma una scheda e un margine di tolleranza: «all’incirca questo, più o meno tanto». È quel margine la trovata, ed è ciò che costringe schede vicine a ridiventare immagini simili. (Sulla scheda il disegno mette i nomi tecnici: \(\mu\) è il valore scritto, \(\sigma\) il margine di tolleranza, e il pallino nero il punto sorteggiato dentro quel margine. La scheda, quindi, è la coppia: il valore e il margine.)#
La Fig. 27.6 riassume i due tratti che il VAE aggiunge all’autoencoder. Il primo è il margine \(\boldsymbol{\sigma}_\phi\): il codice si sorteggia dentro il margine, quindi in addestramento il decoder vede una zona attorno a ogni codice invece di un punto, e codici vicini tornano immagini simili. È quello che serve alla diffusione, che si muove nel latente a piccoli spostamenti e deve poter decodificare anche i punti intermedi. Il secondo è la penalità, il termine KL dell’ELBO (KL sta per Kullback e Leibler, la divergenza che misura quanto i codici si allontanano dal centro): con il peso minimo che gli si dà qui, impedisce soltanto al latente di prendere una scala arbitrariamente grande, ma non lo porta alla scala del rumore, cioè a varianza 1, e per questo servirà una riscalatura.
L’archivista del museo è la clessidra dei modelli latenti, la stessa che nei codec neurali comprimeva il suono, qui con due mestieri al posto delle due metà: per ogni quadro l’archivista scrive una scheda molto più piccola dell’originale, e il copista deve ridipingere il quadro leggendo solo quella. Se la copia somiglia all’originale la scheda conteneva l’essenziale, e i due si allenano insieme perché una scheda è buona o cattiva solo rispetto a chi la deve leggere.
Dopo milioni di prove su milioni di quadri, l’archivista ha imparato da solo che cosa annotare (soggetto, composizione, colori dominanti) e che cosa lasciar perdere: la grana della tela, le singole pennellate dello sfondo. Non perché il copista se le ricordi, ma perché se le inventa, e una grana di tela vale l’altra.
Nei numeri di Stable Diffusion: il quadro è fatto di 786.432 valori, la scheda di 16.384, quarantotto volte meno. Quel 16.384 esce da una scelta di progetto: la scheda è una griglia di 64 caselle per lato invece delle 512 dell’immagine (otto volte meno per lato) con quattro numeri per casella, e \(64 \times 64 \times 4\) fa appunto 16.384.
La compressione però distrugge, e quello che l’archivista non ha annotato non lo recupera più nessuno: la scheda è il soffitto della qualità finale. Quattro numeri per casella bastano per un gatto su un muro e non bastano per una scritta leggibile, per un volto in secondo piano o per una mano con cinque dita: se il copista si inventa la grana della tela nessuno se ne accorge, se si inventa le lettere di un’insegna se ne accorgono tutti. I successori hanno alzato quel soffitto mettendo più numeri per casella.
E il «variational» del nome, che in italiano diremmo «variazionale»? Sta in due regole che tengono l’archivio in ordine: la scheda descrive una nuvola di possibilità («un gatto nero più o meno così») invece di inchiodare il quadro a un punto esatto, e tutte le schede stanno raccolte attorno a uno stesso centro, così si sa in che zona cercarle. In Stable Diffusion la seconda regola è tenuta molto lasca: basta che le schede non si sparpaglino all’infinito.
Le due regole, però, non fanno dell’archivio un posto da cui pescare a caso. La regola del centro avvicina le schede una per volta, e non garantisce che insieme riempiano tutta la zona: restano dei buchi dove nessuna scheda è mai finita, e una scheda presa a caso in un buco il copista la trasforma in una macchia, perché lì non ha mai imparato niente. Da solo, quindi, il VAE è un generatore mediocre. In Stable Diffusion il problema non si pone, perché all’archivista non si chiede di inventare quadri per conto suo: su quale scheda fermarsi lo decide il restauratore, che arriva dopo e non pesca a caso.
Un VAE è una coppia di reti. L’encoder mappa il dato \(\mathbf{x}\) non in un punto ma in una distribuzione sul latente, \(q_\phi(\mathbf{z} \mid \mathbf{x}) = \mathcal{N}\big(\mathbf{z};\, \boldsymbol{\mu}_\phi(\mathbf{x}),\, \mathrm{diag}\big(\boldsymbol{\sigma}_\phi^2(\mathbf{x})\big)\big)\) (la covarianza è diagonale, con una varianza propria per componente, non un unico valore per tutte); il decoder definisce \(p_\psi(\mathbf{x} \mid \mathbf{z})\), la ricostruzione a partire dal codice (scriviamo \(\psi\) per i suoi parametri perché in questo capitolo \(\theta\) è già impegnato dalla rete di diffusione \(\boldsymbol{\epsilon}_\theta\): sono due reti distinte, addestrate separatamente). Sul latente si impone un prior semplice, \(p(\mathbf{z}) = \mathcal{N}(\mathbf{0}, \mathbf{I})\). L’addestramento massimizza l’ELBO (evidence lower bound):
dove il primo termine premia la fedeltà della ricostruzione e il secondo (la divergenza di Kullback–Leibler vista nei richiami di matematica) penalizza gli encoder che si allontanano dal prior. Quel termine tiene aperto il margine \(\boldsymbol{\sigma}_\phi\), senza il quale il campionamento degenererebbe in un punto, e raccoglie le \(q_\phi\) attorno al prior. Dal margine viene la continuità (input simili, codici vicini); dal raccoglierle, il fatto che si sappia dove pescare \(\mathbf{z}\) senza doverne stimare la distribuzione. L’obiettivo è che ogni regione con probabilità apprezzabile sotto il prior decodifichi in un dato plausibile. Nella convenzione del libro, dove \(\mathcal{L}\) si minimizza, la loss corrispondente è \(\mathcal{L} = -\mathrm{ELBO}\). La derivazione, come limite inferiore della log-verosimiglianza, sta nella sezione sull’ELBO; qui ci basta il ruolo funzionale dei due termini.
Di quel capitolo va richiamato anche il limite, perché in Stable Diffusion determina una scelta di progetto: lo scarto fra prior e posterior aggregata, per cui un \(\mathbf{z}\) campionato dal prior finisce anche in regioni che il decoder ha visto poco [HJ16, RLM18]. Qui il problema si aggira non risolvendolo: al VAE non si chiede affatto di generare, il peso KL è tenuto molto piccolo (la fedeltà della ricostruzione conta più della somiglianza al prior) e a decidere che cosa esce dal latente pensa la diffusione, non il decoder da solo.
Il VAE di Stable Diffusion è convoluzionale e riduce ogni lato di un fattore \(f = 8\), con 4 canali latenti: da \(512 \times 512 \times 3\) a \(64 \times 64 \times 4\), cioè da \(786\,432\) a \(16\,384\) valori, un fattore 48. Il fattore \(f\) è il primo parametro che Rombach e colleghi esplorano, su \(f \in \{1, 2, 4, 8, 16, 32\}\): con \(f\) piccolo la diffusione resta quasi nei pixel e ne paga il costo, con \(f = 32\) la compressione distrugge troppo; la fascia utile va da 4 a 16, e Stable Diffusion prende 8. Per non lasciare al latente una scala arbitraria il paper prova due regolarizzazioni: KL-reg, una penalità KL verso \(\mathcal{N}(\mathbf{0}, \mathbf{I})\) con peso dell’ordine di \(10^{-6}\), che del VAE conserva poco più del nome e non porta il latente a varianza unitaria; e VQ-reg, uno strato di quantizzazione vettoriale come nel VQ-VAE. Stable Diffusion usa la prima. In tutti e due i casi l’autoencoder è addestrato anche con una loss percettiva e una avversaria (un discriminatore in stile GAN, come nel capitolo precedente) che tengono nitide le ricostruzioni [RBL+22].
Sarebbe però un errore liquidarlo come un dettaglio di efficienza: la compressione è distruttiva, e il danno è misurabile e definitivo. Tutto ciò che il decoder non sa ricostruire è perduto prima che la U-Net veda alcunché, quindi la capacità di ricostruzione dell’autoencoder è un limite superiore sulla qualità dell’intero sistema, che nessuna quantità di diffusione può superare. Rombach e colleghi lo mettono fra i limiti dichiarati del metodo, e la conferma più netta arriva dai loro stessi successori: a parità di \(f\), portare i canali latenti da 4 a 16 migliora nettamente ogni misura di ricostruzione, ed è una delle scelte di Stable Diffusion 3 [EKB+24], che vedremo nella prossima sezione. Le due loss aggiuntive vanno lette nella stessa luce: il decoder non ricostruisce e basta, sceglie che cosa è plausibile ricostruire, il che è un’altra cosa e ha conseguenze proprie.
La ricetta in quattro mosse#
Manca un pezzo solo, tenuto finora in disparte: il testo. Le fotografie con cui questi modelli si addestrano non arrivano nude, arrivano con una didascalia accanto («un gatto nero seduto su un muro»), raccolta insieme all’immagine dal sito da cui è stata presa. È così che il modello impara ad associare le parole alle cose, ed è il motivo per cui alla fine gli si potrà scrivere che cosa disegnare. Le parole, però, una rete non le legge: legge numeri. A tradurle pensa una rete a parte, CLIP, quella della sezione su come si allineano due spazi, che qui viene riusata com’è.
La Fig. 27.7 mette allora in fila tutto: la rete che comprime, lo spazio delle schede dove avviene la diffusione, il testo che entra di lato, la rete che riporta ai pixel. Un dettaglio dell’ordine dei lavori conta più di quanto sembri: l’autoencoder (archivista e copista) si addestra prima, da solo, e poi viene congelato, cioè i suoi pesi non si aggiornano più mentre si addestra la rete di diffusione. La ragione è che quella rete deve allenarsi su latenti prodotti da un encoder che non cambia: se l’encoder cambiasse, il bersaglio si sposterebbe a ogni aggiornamento.

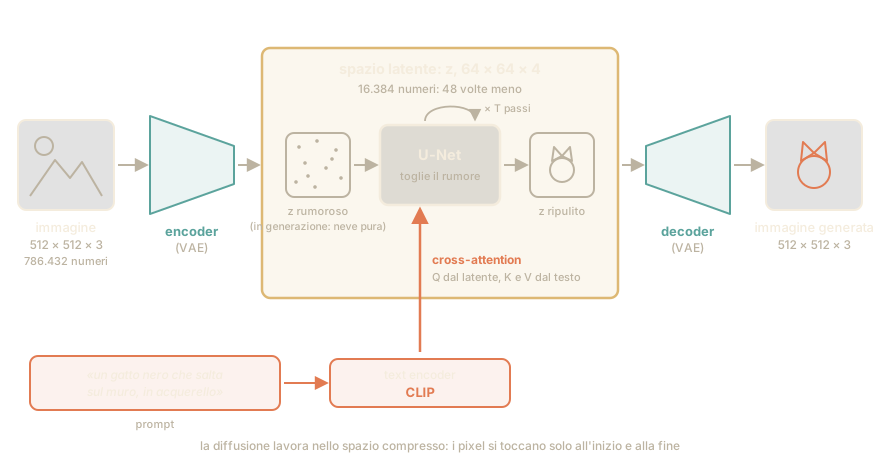
Fig. 27.7 La catena di montaggio di Stable Diffusion. La diffusione non tocca mai i pixel: lavora sulla scheda compressa, e a ogni passo dà un’occhiata alla richiesta scritta dall’utente, che entra di lato.#
Quattro mosse. Prima: l’archivista comprime ogni fotografia dell’archivio di addestramento nella sua scheda; d’ora in poi si lavora solo su schede. Seconda: il restauratore fa esattamente il suo solito mestiere (sporca di rumore, impara a indicare il disturbo) ma su schede da 16.384 numeri invece che su quadri da 786.432, come restaurare cartoline anziché affreschi. Ogni giro di domanda e risposta costa decine di volte meno. Non proprio quarantotto: quarantotto dice quanti numeri in meno ci sono, non quanti conti in meno si fanno, e la rete delle schede è disegnata apposta per loro invece di essere quella dei quadri rimpicciolita.
Le schede, però, vanno convertite prima di finire sul tavolo del restauratore: si moltiplicano tutte per uno stesso numero fisso, 0,18215, poco meno di un quinto. Il restauratore dosa lo sporco su numeri di una certa taglia, e dall’archivio le schede escono con numeri cinque volte e mezzo più grandi di quella (cinque volte e mezzo è proprio 1 diviso 0,18215): chi salta la conversione gli dà schede su cui quella stessa dose si vede appena, e lo manda ad allenarsi su un problema più facile del vero.
Terza: mentre pulisce, il restauratore tiene sul tavolo la commissione scritta dal cliente («un gatto nero che salta sul muro, in acquerello») e a ogni pennellata le dà un’occhiata, soffermandosi sulle parole che servono in quel momento: «nero» quando decide i toni, «acquerello» quando decide il tratto. È la stessa occhiata selettiva dell’interprete della traduzione automatica, ritrovata poi nei Transformer: lì collegava due lingue, qui collega parole e immagine. (Quella commissione si chiama prompt: è la frase che si scrive nella casella di un generatore di immagini, e le due parole valgono l’una per l’altra.) Quarta: finita la pulitura si disfa la conversione di prima, e la scheda passa al copista, che ridipinge il quadro a piena risoluzione.
Per generare un’immagine nuova si parte, come sempre, dalla fine: una scheda di puro rumore sorteggiato, mai appartenuta a nessun quadro. Non è ancora una scheda buona, e nessuno pretende che lo sia: lo diventa strada facendo. Il restauratore la pulisce passo dopo passo con la commissione sotto gli occhi, e il copista trasforma il risultato in pixel. Il gatto in acquerello che compare non esisteva da nessuna parte: né il quadro, né la sua scheda.
Formalmente, le quattro componenti sono queste.
1. Compressione. L’encoder congelato porta ogni immagine nel latente. Non è una funzione, ed è la distribuzione definita sopra: il latente di addestramento si campiona, \(\mathbf{z} \sim q_\phi(\cdot \mid \mathbf{x})\), con \(\mathbf{z} \in \mathbb{R}^{64 \times 64 \times 4}\) per \(\mathbf{x} \in \mathbb{R}^{512 \times 512 \times 3}\) (scriveremo \(\mathrm{Enc}(\mathbf{x})\) per brevità, ricordando che sotto c’è un campionamento, e \(\mathrm{Dec}(\mathbf{z})\) per la media di \(p_\psi(\mathbf{x} \mid \mathbf{z})\), cioè per la ricostruzione).
2. Diffusione nel latente. Il processo diretto e quello inverso hanno la stessa forma di quelli di DDPM, applicati a \(\mathbf{z}\) anziché a \(\mathbf{x}\), ma lo schedule è un altro: in Stable Diffusion 1.x \(\sqrt{\beta_t}\) cresce linearmente da \(\sqrt{0{,}00085}\) a \(\sqrt{0{,}012}\) su \(T = 1000\) passi, molto più dolce dello schedule lineare di DDPM, e ne segue \(\bar{\alpha}_T \approx 0{,}0047\) invece di \(4 \cdot 10^{-5}\). All’ultimo passo sopravvive quasi il 7% dell’ampiezza del latente, e il rumore puro da cui parte la generazione differisce dalla marginale su cui la rete si è addestrata: è il problema del rapporto segnale-rumore terminale non nullo di cui parla la sezione sul flow matching. Serve poi l’avvertenza che la spirale in miniatura aveva già anticipato: lo schedule variance-preserving presuppone dati a varianza unitaria, e il latente del VAE non ce l’ha. LDM lo riscala quindi per la deviazione standard misurata sui latenti, che è un solo numero e non uno per canale (in Stable Diffusion 1.x quella costante vale \(0{,}18215\), cioè l’inverso di quella deviazione standard). Non è una limatura: Rombach e colleghi documentano che il rapporto segnale/rumore indotto dalla scala del latente incide sensibilmente sul risultato, e senza quella riscalatura tutta la taratura dello schedule sarebbe sbagliata. Fatta la riscalatura, la U-Net \(\boldsymbol{\epsilon}_\theta\) è addestrata a predire il rumore con la solita regressione, ora condizionata anche dal testo \(c\):
dove \(\mathbf{z}_t\) è il latente rumoroso al passo \(t\), \(\boldsymbol{\epsilon}\) il rumore iniettato e \(\tau\) il text encoder. Ogni valutazione della rete lavora su \(16\,384\) valori invece di \(786\,432\): è qui che si paga l’affitto ridotto dello spazio latente. Il 48 resta però il rapporto fra i valori, non fra le operazioni. Il costo di una convoluzione cresce con il numero di posizioni spaziali, che scendono di \(f^2 = 64\) volte; quello della self-attention con il quadrato di quel numero, cioè \(f^4 = 4096\) volte meno coppie di posizioni; e il 48 è \(64 \cdot 3/4\), perché i canali passano da 3 a 4. In più la U-Net del latente è dimensionata per il latente, non è quella dei pixel rimpicciolita.
3. Condizionamento testuale. \(\tau\) è il text encoder di CLIP [RKH+21], il modello contrastivo della sezione su come si allineano due spazi: congelato, trasforma il prompt in una sequenza di 77 embedding da 768 dimensioni: 77 è la finestra fissa di CLIP, e i prompt più corti vengono riempiti fino a lì. Questi entrano nella U-Net tramite strati di cross-attention inseriti a più risoluzioni, la stessa identica formula del capitolo sui Transformer:
dove \(h(\mathbf{z}_t)\) sono le mappe di attivazione intermedie della U-Net appiattite in sequenza, \(\tau(c)\) gli embedding del prompt e \(\mathbf{W}_Q\), \(\mathbf{W}_K\), \(\mathbf{W}_V\) proiezioni apprese, che moltiplicano a destra le sequenze secondo la convenzione per righe (un token per riga) di quel capitolo. Come nel decoder del Transformer originale, le query vengono da chi genera e le key/value dalla sorgente da consultare: solo che qui chi genera è un’immagine e la sorgente è una frase.
4. Decodifica. Al termine della catena inversa la riscalatura del punto 2 va disfatta, perché il decoder è stato addestrato sui latenti grezzi; poi riporta ai pixel: \(\hat{\mathbf{x}} = \mathrm{Dec}(\mathbf{z}_0 / 0{,}18215)\).
Gli ordini di grandezza di Stable Diffusion v1: U-Net da circa 860 milioni di parametri, text encoder da 123 milioni (congelato), addestramento su sottoinsiemi in lingua inglese, filtrati per qualità estetica, di LAION-5B (un catalogo aperto di oltre cinque miliardi di coppie immagine–didascalia raccolte dal web).
L’asimmetria che ne risulta si misura in lavoro da fare, non in denaro. Addestrare Stable Diffusion è rimasto un mestiere da data center: la documentazione del modello dichiara centocinquantamila ore di calcolo su GPU professionali, cioè una GPU sola accesa per diciassette anni (nella realtà erano 256, in 32 macchine da otto, per poco più di tre settimane). Usarlo, grazie alla compressione nelle schede, chiede alla GPU quattro gigabyte di memoria e qualche secondo di attesa: il file, caricato a metà precisione, ne occupa circa due, e gli altri due servono ai calcoli. È il costo dell’uso, non quello dell’addestramento, ad aver cambiato chi può partecipare.
Quanto dare retta alla richiesta#
Manca un ingrediente, quello che decide quanto l’immagine obbedisce alla richiesta. L’occhiata al testo, da sola, è un suggerimento più che un ordine: lasciato libero, il modello tende a produrre immagini plausibili che rispettano il testo solo in parte; il gatto c’è, l’acquerello si è perso per strada. Il correttivo standard, usato da Stable Diffusion e da praticamente tutti i modelli che disegnano su richiesta, si chiama classifier-free guidance (letteralmente «guida senza classificatore»: fra poco si capirà da dove viene il nome), è di Jonathan Ho e Tim Salimans [HS22], ed è di una semplicità che spiazza. La Fig. 27.8 la mostra per intero.
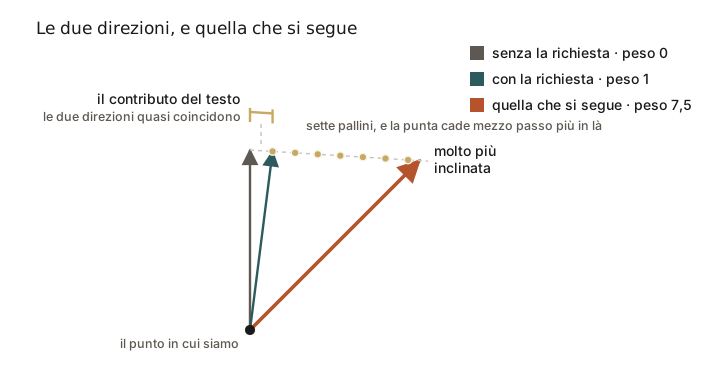
Fig. 27.8 Le due direzioni che la rete indica nello stesso punto: quella che ha in mente solo «una figura credibile» e quella che ha in mente anche la richiesta scritta. Sono quasi la stessa, e la piccola differenza fra le due è tutto quello che il testo ha da dire. La direzione che si segue davvero è la prima più quella differenza ripetuta sette volte e mezzo, che è il peso con cui Stable Diffusion esce di serie. Il disegno fissa un divario qualunque fra le due direzioni: quanto valga sul serio dipende dal modello e dal punto.#
Il trucco comincia in addestramento: circa una volta su dieci, al modello la commissione viene nascosta. Così impara due mestieri insieme: disegnare «un’immagine plausibile qualunque» quando non ha indicazioni, e disegnare «quello che dice il testo» quando le ha.
In generazione, allora, a ogni passo puoi porre la domanda due volte e ottenere due risposte, al prezzo di fare il lavoro due volte. È il cartello della salita, quello che indica in che direzione ritoccare l’immagine per renderla più credibile, che si sdoppia: uno dice «per una figura credibile, va’ di là», l’altro «per una figura credibile e che rispetta la richiesta, va’ di là». Chiamiamole le due bussole, tenendo a mente che ognuna indica la sua direzione, e le due direzioni non coincidono.
Le due direzioni sono quasi uguali, e la piccola differenza fra loro è tutto quello che il testo ha da dire. La prima bussola dice «nord», la seconda dice «nord, un pelo verso est»: quel «pelo verso est» è il contributo della richiesta. Seguire la seconda bussola e basta è quello che si faceva prima, e l’indicazione del testo nel totale pesa pochissimo. La rete tira soprattutto verso «un’immagine credibile», e «acquerello» è una spintarella dentro quella spinta grossa, che si perde per strada: il gatto viene a olio. Il colpo di genio è prendere quel pelo verso est e moltiplicarlo: non un passo, ma sette passi e mezzo verso est, e poi camminare verso nord-est. Sette e mezzo è il numero che Stable Diffusion usa di serie, e si chiama il peso della guida, \(w\).
A \(w = 1\) non si esagera niente, ed è il gatto a olio di prima. Sotto l’uno il modello va a briglia sciolta, con immagini varie e richiesta presa alla leggera, fino a \(w = 0\) dove la richiesta viene ignorata del tutto e si segue la prima bussola e basta; sopra l’uno ubbidisce di più e inventa di meno. Esagerando davvero, ben oltre il 7 e mezzo, l’immagine viene «sovracotta»: colori saturi, contrasti duri, composizioni tutte uguali.
E il sette e mezzo? Chi misura quanto le immagini somigliano alle fotografie vere trova il punto migliore molto più in basso, e a sette e mezzo la somiglianza è già peggiorata. Sette e mezzo resta il valore di serie, e quello che si guadagna a stare così in alto si vede con gli occhi più che nelle misure.
Resta il nome. Un classificatore è una rete che guarda un’immagine e dice che cosa contiene («questo è un gatto»), e il metodo che c’era prima, del 2021 (lo stesso lavoro che aveva visto la diffusione battere le GAN), ne addestrava uno a parte per tirare la generazione verso la categoria voluta: costoso, e un pezzo in più da mantenere. Ho e Salimans ottengono lo stesso effetto con due risposte della rete che c’è già, da qui classifier-free, «senza classificatore».
I negative prompt sono la stessa idea usata al contrario: al posto della bussola «qualunque cosa» ne metti una che punta verso ciò che non vuoi («sfocato, deforme, con una scritta sopra») e cammini allontanandotene.
In addestramento il condizionamento viene azzerato con probabilità fissa (condition dropout, circa \(0{,}1\) in Stable Diffusion): la stessa rete apprende sia \(\boldsymbol{\epsilon}_\theta(\mathbf{z}_t, c)\) sia il caso non condizionato \(\boldsymbol{\epsilon}_\theta(\mathbf{z}_t, \varnothing)\), dove \(\varnothing\) è il prompt vuoto. In inferenza le due predizioni si combinano per estrapolazione:
dove \(\tilde{\boldsymbol{\epsilon}}_\theta\) è la predizione di rumore effettivamente usata dal campionatore, \(c\) il prompt e \(w\) il peso di guidance: con \(w = 1\) si recupera la predizione condizionata, con \(w > 1\) ci si spinge oltre, nella direzione che separa il condizionato dal non condizionato (nella parametrizzazione originale di Ho e Salimans il coefficiente è scritto \(1 + w\), quindi la formula è la stessa e il numero no: il \(7{,}5\) di qui è \(w = 6{,}5\) nel loro paper).
Raccogliendo per peso, la stessa combinazione si scrive
ed è la forma che rende visibile tutto l’intervallo: fra \(0\) e \(1\) è una media pesata delle due predizioni, con \(w = 0\) che ignora il prompt del tutto e \(w = 1\) che usa la sola condizionata; sopra l’uno il peso della non condizionata diventa negativo, cioè non ci si limita a dar retta al testo, ci si allontana da «un’immagine plausibile qualunque».
L’ispirazione, ed è bene chiamarla così e non «l’interpretazione»: la differenza tra le due predizioni approssima \(-\sqrt{1-\bar{\alpha}_t}\,\nabla_{\mathbf{z}_t} \log p(c \mid \mathbf{z}_t)\), con il fattore negativo che lega \(\boldsymbol{\epsilon}\) e score nella sezione sotto il cofano: la differenza punta nel verso opposto al gradiente, ed è proprio sommandola alla predizione di rumore (che il campionatore poi sottrae) che si sale su \(\log p(c \mid \mathbf{z}_t)\). È ciò che la classifier guidance di [DN21] otteneva addestrando un classificatore esterno, ed è da lì che viene il nome «senza classificatore».
Qui però bisogna fermarsi, perché la formula suggerisce una conclusione che gli autori del metodo negano esplicitamente: il classificatore implicito non c’è. Essendo \(\boldsymbol{\epsilon}_\theta\) una rete non vincolata, il campo \(\tilde{\boldsymbol{\epsilon}}_\theta\) non è in generale conservativo, quindi non esiste alcun potenziale (nessuna log-verosimiglianza di classificatore) di cui sia il gradiente; è l’argomento di Ho e Salimans nel paper già citato, che aggiungono che il passo lungo \(\tilde{\boldsymbol{\epsilon}}_\theta\) non può essere letto come un attacco avversario a un classificatore di immagini. Il «classificatore implicito» è una guida al ragionamento, non un oggetto che esiste da qualche parte.
E c’è una seconda conseguenza, che le interfacce non dichiarano mai: per \(w > 1\) il campionatore non campiona più da \(p(\mathbf{x} \mid c)\), e nemmeno dalla distribuzione «inclinata» \(p(\mathbf{x})\,p(c \mid \mathbf{x})^w\) che di solito si cita per giustificarlo [BN24]; che cosa faccia davvero alla distribuzione, misurato su un caso in cui tutto si calcola a mano, lo racconta la sezione sulla guida. Il \(w = 7{,}5\) di default sta ben oltre il punto in cui la somiglianza statistica con i dati veri comincia a peggiorare: non è una manopola della qualità, è una manopola della preferenza, e la distinzione conta ogni volta che si valuta un modello con una metrica invece che con gli occhi.
Il prezzo è dunque triplice. Computazionale: due valutazioni della U-Net per ogni passo (in pratica, un batch di due). Statistico: al crescere di \(w\) aumenta l’aderenza al prompt ma cala la diversità dei campioni, con saturazione e artefatti per valori estremi (il trade-off fedeltà–varietà misurato sistematicamente nel paper [HS22]). E concettuale: si perde la garanzia di star campionando da una distribuzione definita. Il negative prompt delle interfacce comuni è la stessa formula con \(\varnothing\) sostituito da un prompt negativo \(c_{\mathrm{neg}}\): si estrapola allontanandosi da esso.
Dieci righe di Python#
Non riscriveremo da zero tutta la catena di montaggio: nessuno lo fa, e il modo
in cui la si usa davvero è la libreria diffusers di Hugging Face, che gira su
PyTorch e impacchetta in un blocco solo l’archivista, il copista, il
restauratore, la rete che legge la commissione scritta e la procedura che
scende la scala
(pip install diffusers transformers accelerate). Al primo avvio scarica i
pesi (qualche gigabyte); così com’è scritto vuole una GPU NVIDIA con circa
quattro gigabyte di memoria, perché la riga pipe.to("cuda") la nomina. Sulla
CPU la stessa pipeline gira togliendo quella riga e anche torch_dtype, cioè
tornando alla precisione piena (che lì è la scelta sicura, e raddoppia la
memoria), e molto più lentamente. Chi non ha una GPU così legge il blocco
invece di lanciarlo, perché quello che c’è da capire sta nei nomi delle
opzioni.
import torch
from diffusers import StableDiffusionPipeline

# carica l'intera pipeline (VAE + U-Net + CLIP + campionatore)
pipe = StableDiffusionPipeline.from_pretrained(
    "stable-diffusion-v1-5/stable-diffusion-v1-5",
    torch_dtype=torch.float16,  # mezza precisione: meno memoria
)
pipe = pipe.to("cuda")          # sposta tutto sulla GPU

immagine = pipe(
    prompt="a black cat jumping on a wall, watercolor",
    negative_prompt="blurry, deformed, watermark",
    guidance_scale=7.5,         # il peso w della guidance
    num_inference_steps=50,     # i passi di denoising nel latente
).images[0]

immagine.save("gatto_acquerello.png")
Tre note pratiche. Il prompt è in inglese perché i modelli della famiglia
SD v1 sono addestrati su didascalie in inglese: con altre lingue i
risultati peggiorano sensibilmente. I cinquanta passi non sono quelli del
campionamento ancestrale di DDPM: la procedura che questo modello usa di serie
è PNDM, un metodo multipasso che percorre l’ODE del flusso di probabilità.
Si sostituisce in una riga con uno dei metodi della sezione sui campionatori veloci: per DPM-Solver++
basta assegnare a pipe.scheduler un DPMSolverMultistepScheduler costruito
con from_config(pipe.scheduler.config). E se la memoria non basta,
pipe.enable_model_cpu_offload() tiene sulla GPU un pezzo di modello per
volta e lascia gli altri nella memoria del computer: si paga in secondi, ma il
picco di memoria scende di molto.
L’onda lunga dei pesi aperti#
Il rilascio dei pesi ha fatto qualcosa che nessuna API può fare: ha permesso a chiunque di modificare il modello. Nel giro di mesi è nato un ecosistema di personalizzazioni leggere. Con LoRA [HSW+22], una tecnica nata per i modelli di linguaggio, si specializza il modello su uno stile o un soggetto senza toccarlo tutto: accanto ai pesi originali, che restano fermi, si addestrano due tabelle di numeri molto più piccole che ne correggono l’uscita. Il file da condividere pesa qualche megabyte invece di qualche gigabyte, ed è la ragione per cui gli stili si sono messi a circolare come circolano le canzoni. Con ControlNet [ZRA23] si vincola invece la generazione a uno schizzo, una posa o una mappa di profondità (un’immagine in cui ogni pixel dice quanto è lontano quel punto) forniti dall’utente. LoRA è la stessa del post-training dei Transformer. Sono tutte e due il motivo per cui attorno a Stable Diffusion esiste una comunità e non solo un’utenza.
Le versioni successive raccontano una traiettoria che qui interessa per una ragione sola: dice dove è andata a finire l’architettura. Le prime rifiniscono la ricetta senza cambiarla; poi la si ingrandisce, con una rete più capiente, due lettori di testo invece di uno e una risoluzione nativa doppia; infine, nel 2024, si butta la U-Net e le si mette al posto un Transformer. Chi ha letto il capitolo sui Transformer se lo aspettava, perché la stessa sostituzione era già avvenuta nella traduzione e nella visione; ma che funzionasse anche qui non era affatto scontato.
Un controllo che parte da zero#
Una richiesta scritta dice che cosa disegnare, non dove: «un gatto che salta su un muro» lascia al modello la posa del gatto, l’inquadratura e la forma del muro. ControlNet, di Lvmin Zhang, Anyi Rao e Maneesh Agrawala [ZRA23], aggiunge a un modello già addestrato un secondo ingresso, un’immagine di controllo (i contorni di uno schizzo, lo scheletro di una posa, una mappa di profondità), senza cambiare nemmeno uno dei suoi pesi. Le mosse sono due. La prima è una copia allenabile di metà della U-Net. La U-Net, come racconta la sezione su come funziona la diffusione, lavora in due fasi: una metà rimpicciolisce via via la griglia del latente, da \(64\times64\) a \(8\times8\), l’altra la riporta a \(64\times64\), e dei ponti, le connessioni di salto, passano dall’una all’altra i dettagli di ogni livello. ControlNet copia la prima metà, quella che rimpicciolisce, e le fa leggere in più l’immagine di controllo. Quella metà si chiama anche codificatore della U-Net, ma con l’encoder del VAE non ha niente in comune: quello sta fuori dalla U-Net e trasforma l’immagine in latente prima che tutto cominci. La seconda mossa sono le convoluzioni a zero, strati i cui pesi all’inizio valgono zero, attraverso i quali le uscite della copia entrano nella rete originale sui ponti.
Il restauratore è bravissimo, e non lo si vuole rimandare a scuola: costerebbe tantissimo, e ritoccando tutti i suoi numeri su pochi esempi nuovi, un quadro ciascuno con il suo schizzo, si guasterebbero anche quelli che gli servono per il resto. Si vuole soltanto che segua uno schizzo. Il suo lavoro ha due fasi: prima si allontana dalla scheda e ne vede le forme grandi, poi si riavvicina per scrivere la risposta punto per punto, e dei ponti gli riportano gli appunti presi a ogni distanza. Gli si affianca allora un apprendista che è la sua copia esatta nella prima fase, quella che si allontana, e che in più guarda lo schizzo, rimpicciolito alla taglia di una scheda. Una copia, e non un apprendista nuovo, perché così parte già sapendo guardare una scheda, e gli resta da imparare soltanto lo schizzo. Su ogni ponte l’apprendista aggiunge i suoi appunti a quelli del restauratore.
Su ogni ponte c’è una manopola del volume per gli appunti dell’apprendista, e all’inizio sono tutte a zero: sono le convoluzioni a zero. Un’altra manopola, anche lei a zero, dosa lo schizzo che entra nell’apprendista. Il primo giorno, quindi, il restauratore lavora esattamente come prima, e niente di quello che sa viene sporcato da un apprendista che dello schizzo non sa ancora niente.
Al primo giro di addestramento si muovono soltanto le manopole dei ponti. L’apprendista lavora già, perché è una copia, e i suoi appunti sono sensati: solo che le manopole a zero li fermano sul ponte, e il restauratore non li riceve. Per ora ripetono quasi quello che il restauratore sa già, e farli passare non basterebbe a fare il quadro giusto. Bastano però a dare all’addestramento, che confronta il quadro uscito con quello che doveva uscire, una direzione da cui cominciare: per ogni manopola vede da che parte girarla perché il quadro si avvicini, e la gira di un filo. Se l’apprendista non avesse niente da dire, girare la manopola non cambierebbe niente, e l’addestramento non saprebbe da che parte girarla. Con le manopole aperte di un filo, dal secondo giro l’apprendista si fa sentire, e cominciano a imparare anche lui e la manopola dello schizzo. Se invece le manopole partissero da posizioni a caso, il restauratore non si guasterebbe, perché i suoi numeri non si toccano, ma i suoi quadri uscirebbero sporcati da appunti a caso, e le correzioni arriverebbero all’apprendista a caso anche loro, rovinando proprio quello che sapeva: essere una buona copia.
Siccome parte già sapendo guardare una scheda, all’apprendista bastano relativamente pochi esempi: da qualche decina di migliaia di quadri con il loro schizzo in su, contro le centinaia di milioni di immagini da cui ha imparato il restauratore. Ci si aspetterebbe che migliori a poco a poco; invece, raccontano gli autori, per qualche migliaio di giri sembra non servire a niente, e poi di colpo il restauratore segue lo schizzo. Perché succeda di colpo, gli autori non lo spiegano. Intanto i quadri restano buoni per tutto il tempo: il restauratore non cambia mai, e togliendo l’apprendista lo si riavrebbe com’era.
In metà dei giri la commissione viene tolta e resta solo lo schizzo, così l’apprendista è costretto a leggerlo, invece di lasciare che il restauratore indovini tutto dalla frase. E più apprendisti, uno per la posa e uno per la profondità, possono lavorare insieme, ciascuno sommando i suoi appunti sugli stessi ponti.
Il limite è che l’apprendista aggiunge appunti e basta, e la seconda fase resta del restauratore. L’apprendista gli dice dove e con che forma mettere ciò che sa già fare, e per uno stile nuovo si usa di solito LoRA. Se schizzo e commissione non si accordano esce un compromesso: negli esempi degli autori, uno schizzo di casa con la commissione «una torta squisita» dà torte a forma di casa.
Sia \(\mathcal{F}(\cdot\,;\Theta)\) un blocco della rete pre-addestrata, con \(\Theta\) congelati, e \(\mathcal{F}(\cdot\,;\Theta_c)\) una sua copia con \(\Theta_c\) inizializzati a \(\Theta\). Una convoluzione a zero \(\mathcal{Z}(\cdot\,;\Theta_z)\) è una convoluzione \(1\times1\) con pesi e bias posti a zero. Con \(\mathbf{x}\) l’ingresso del blocco e \(\mathbf{c}_f\) il controllo, già portato alla forma di \(\mathbf{x}\) (la somma lo richiede),
e all’inizializzazione \(\mathbf{y}_c = \mathcal{F}(\mathbf{x};\Theta)\): il modello parte esattamente dal comportamento pre-addestrato, e nei primi passi la copia non riceve gradienti rumorosi che ne guasterebbero i pesi, mentre il congelamento di \(\Theta\) protegge l’originale dall’oblio e dal sovradattamento ai pochi esempi nuovi. Che lo zero serva lo mostra l’ablazione degli autori: con convoluzioni di collegamento inizializzate a caso la qualità scende a quella di ControlNet-lite, una variante che al posto della copia ha un solo strato convoluzionale per blocco, cioè la copia perde quello che sapeva.
Nulla però resta bloccato. In ogni posizione \(p\) della griglia la convoluzione d’uscita è una mappa lineare sui canali, \(\mathbf{v}_p = \mathbf{W}_z\mathbf{u}_p + \mathbf{b}_z\), con \(\Theta_{z2} = (\mathbf{W}_z, \mathbf{b}_z)\) e \(\mathbf{u}_p\) l’uscita della copia, quindi
con la somma su tutte le posizioni (e su tutti gli esempi), in generale diversa da zero perché \(\mathbf{u}_p\) non è nulla; mentre \(\partial\mathbf{v}_p/\partial\mathbf{u}_p = \mathbf{W}_z = \mathbf{0}\), quindi al primo passo la copia e la convoluzione a zero d’ingresso hanno gradiente nullo. Dopo il primo aggiornamento \(\mathbf{W}_z \neq \mathbf{0}\) e il gradiente arriva anche a loro.
In Stable Diffusion la copia è quella dei 12 blocchi del codificatore della U-Net e del blocco centrale, e le sue uscite, passate per convoluzioni a zero, si sommano alle 12 connessioni di salto e all’uscita del blocco centrale della U-Net congelata. Il controllo, un’immagine a piena risoluzione, viene portato alla forma del latente da una piccola rete convoluzionale, ed è la sua uscita il \(\mathbf{c}_f\) dell’equazione; stando prima della convoluzione a zero d’ingresso, quella rete riceve gradiente solo dal terzo passo. L’obiettivo è la stessa perdita di denoising, condizionata su testo e controllo, \(\mathbb{E}\,\|\boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta(\mathbf{z}_t, t, \tau(c), \mathbf{c}_f)\|^2\) (con \(\tau(c)\) gli embedding del prompt, come nella ricetta), minimizzata rispetto ai soli parametri nuovi, cioè \(\Theta_c\), \(\Theta_{z1}\) e \(\Theta_{z2}\) di ogni blocco e quelli della piccola rete, mentre i \(\theta\) della U-Net restano fermi. Metà delle richieste è sostituita a caso dalla stringa vuota, perché la rete impari a ricavare il contenuto dal solo controllo (è un’altra cosa dal prompt vuoto una volta su dieci con cui il modello di partenza impara la guida senza classificatore: qui lo scopo è costringere la copia a leggere il controllo). Gli autori riportano una convergenza improvvisa, che osservano senza spiegarla: per tutto l’addestramento le immagini restano di buona qualità, grazie alle convoluzioni a zero, e la rete non impara il controllo a poco a poco, ma comincia a seguirlo di colpo, di solito in meno di diecimila passi. L’addestramento è stabile tanto con meno di cinquantamila coppie quanto con più di un milione (non collassa nemmeno con mille, e migliora con i dati), perché la copia parte da pesi che sanno già leggere un’immagine. Su una A100, per passo di addestramento, gli autori misurano circa il 23% di memoria e il 34% di tempo in più che per addestrare Stable Diffusion senza ControlNet. Più controlli si combinano sommando i loro residui, senza coefficienti di miscela.
È la stessa mossa di LoRA, dove \(\mathbf{B} = \mathbf{0}\) all’inizio e quindi \(\Delta\mathbf{W} = \mathbf{0}\): un ramo nuovo che all’inizio restituisce esattamente il modello originale. Anche la cascata è la stessa. Al primo passo riceve gradiente solo \(\mathbf{B}\), perché quello di \(\mathbf{A}\) passa per \(\mathbf{B}^\top = \mathbf{0}\), come qui la sola convoluzione d’uscita. Il limite è di progetto: il controllo entra solo come somma alle connessioni di salto e al blocco centrale, mentre il decodificatore della U-Net, il text encoder e il VAE restano quelli del modello congelato. Serve a disporre nello spazio ciò che il modello sa già generare, e per uno stile o un soggetto nuovi si ricorre di solito a LoRA; fin dove la copia possa spingersi oltre, il lavoro originale non lo misura. E testo e controllo possono chiedere cose incompatibili. Con lo schizzo di una casa e il prompt «delicious cake», negli esempi degli autori escono torte a forma di casa, la forma dal controllo e il contenuto dal testo.
Un blocco convoluzionale «originale» congelato, la sua copia e le due convoluzioni a zero bastano a controllare in piccolo le tre affermazioni: al primo passo l’uscita è quella dell’originale; solo la convoluzione a zero d’uscita riceve un segnale per correggersi, il gradiente; e dopo l’addestramento il controllo ha imparato la regola, anche su esempi che non ha mai visto, senza che un peso dell’originale sia cambiato.
import copy
import torch
from torch import nn

torch.manual_seed(0)

# il blocco del modello già addestrato: resta fermo
originale = nn.Sequential(nn.Conv2d(4, 16, 3, padding=1), nn.SiLU(),
                          nn.Conv2d(16, 16, 3, padding=1))
originale.requires_grad_(False)

# la copia allenabile, che parte dagli stessi pesi, e le due convoluzioni a zero
copia = copy.deepcopy(originale).requires_grad_(True)
zero_in, zero_out = nn.Conv2d(4, 4, 1), nn.Conv2d(16, 16, 1)
for z in (zero_in, zero_out):
    nn.init.zeros_(z.weight)
    nn.init.zeros_(z.bias)

def controllato(x, c_f):
    return originale(x) + zero_out(copia(x + zero_in(c_f)))

x = torch.randn(8, 4, 16, 16)                  # il latente rumoroso
c_f = torch.randn(8, 4, 16, 16)                # il controllo (schizzo, posa)
guida = nn.Conv2d(4, 16, 3, padding=1)         # la regola che il controllo deve insegnare
with torch.no_grad():
    bersaglio = originale(x) + guida(c_f)

print("al primo passo l'uscita è quella dell'originale:",
      torch.equal(controllato(x, c_f), originale(x)))
perdita = (controllato(x, c_f) - bersaglio).pow(2).mean()
perdita.backward()
for nome, modulo in [("convoluzione a zero in uscita", zero_out),
                     ("copia allenabile", copia),
                     ("convoluzione a zero in ingresso", zero_in)]:
    g = sum(p.grad.abs().sum() for p in modulo.parameters())
    print(f"gradiente sulla {nome:32}: {'diverso da zero' if g > 0 else 'zero'}")

allenabili = [*copia.parameters(), *zero_in.parameters(), *zero_out.parameters()]
ottimizzatore = torch.optim.Adam(allenabili, lr=1e-2)
iniziale, prima = perdita.item(), [p.clone() for p in originale.parameters()]
for passo in range(500):
    ottimizzatore.zero_grad()
    perdita = (controllato(x, c_f) - bersaglio).pow(2).mean()
    perdita.backward()
    ottimizzatore.step()
print("dopo 500 passi la perdita è sotto un decimo di quella iniziale:",
      perdita.item() < iniziale / 10)
print("l'originale è rimasto identico:",
      all(torch.equal(a, b) for a, b in zip(prima, originale.parameters())))

with torch.no_grad():                          # esempi mai visti
    x_nuovo, c_nuovo = torch.randn(64, 4, 16, 16), torch.randn(64, 4, 16, 16)
    atteso = originale(x_nuovo) + guida(c_nuovo)
    errore = (controllato(x_nuovo, c_nuovo) - atteso).pow(2).mean()
    senza = guida(c_nuovo).pow(2).mean()       # l'errore del solo originale
print("su esempi nuovi l'errore è sotto un decimo di quello senza controllo:",
      bool(errore < senza / 10))
al primo passo l'uscita è quella dell'originale: True
gradiente sulla convoluzione a zero in uscita   : diverso da zero
gradiente sulla copia allenabile                : zero
gradiente sulla convoluzione a zero in ingresso : zero
dopo 500 passi la perdita è sotto un decimo di quella iniziale: True
l'originale è rimasto identico: True
su esempi nuovi l'errore è sotto un decimo di quello senza controllo: True
Le domande che restano aperte#
Il capitolo sui Transformer si era chiuso elencando i problemi aperti dei modelli di linguaggio, senza addolcirli. Qui i problemi sono paralleli e altrettanto strutturali, e sono tre.
Il primo è il consenso. La stessa catena di montaggio che dipinge un gatto in acquerello dipinge il volto di una persona reale in una scena mai avvenuta, e i pesi aperti rendono facili da rimuovere le contromisure decise da chi distribuisce il modello (filtri, parole vietate nella richiesta).
Il secondo sono i dati. Stable Diffusion è addestrato su LAION, un enorme elenco pubblico di indirizzi di immagini raccolte dal web con la loro didascalia: miliardi di voci, prese dove capitava. Dentro ci sono anche opere protette da diritto d’autore e fotografie di persone che non hanno mai acconsentito. Su questo si è aperto un contenzioso vero. All’inizio del 2023 Getty Images ha citato in giudizio Stability AI, e un gruppo di artisti ha fatto causa a Stability AI, Midjourney e DeviantArt. A qualche anno dai primi depositi, le sentenze sono parziali e diverse da un paese all’altro, e la domanda di fondo, cioè se addestrare un modello su opere protette sia lecito, non ha ancora una risposta stabile.
Il terzo è la provenienza, cioè poter dire se un’immagine è stata generata o no. Il codice di rilascio di Stable Diffusion incorporava di serie una filigrana invisibile (un segnale nascosto nei pixel, che un programma sa riconoscere) nelle immagini che produceva, e ci sono standard, come le Content Credentials del consorzio C2PA, che provano a certificare l’origine dei contenuti. Ma chi possiede i pesi disattiva la filigrana con una riga di codice, e riconoscere l’origine dopo il fatto resta una rincorsa. Sono problemi aperti nel senso pieno: tecnici solo in parte, e non risolvibili solo con la tecnica.
Da ricordare
Lavorare sui pixel è uno spreco: quasi tutti i 786.432 numeri di una fotografia servono a descrivere la grana, non il gatto. L’idea di Stable Diffusion è spostare tutto il lavoro su una versione compressa della fotografia, quarantotto volte più piccola, e tornare ai pixel solo alla fine.
Chi comprime è l’archivista: per ogni quadro scrive una scheda molto più piccola, e chi la legge per ridipingere il quadro è il copista. I due si allenano insieme, e la prova che la scheda è buona è che la copia somigli all’originale. La trovata dell’archivista è non scrivere un valore esatto ma un valore con un margine, così che schede vicine diventino immagini simili e attorno a ogni scheda ci sia una zona intera che il copista sa leggere. Non che l’archivio sia coperto tutto: a pescare a caso si finisce dove nessuna scheda è mai arrivata, ed è il restauratore, non il sorteggio, a decidere su quale fermarsi.
Quello che l’archivista non annota è perso per sempre: la scheda è il soffitto della qualità finale, e nessuna bravura di chi viene dopo lo alza. È una delle ragioni per cui i primi modelli di questa famiglia sbagliavano scritte, volti piccoli e mani, che sono tutte cose di dettaglio fine.
La ricetta in quattro mosse: l’archivista comprime, il restauratore fa il suo solito mestiere sulle schede invece che sui quadri, tenendo d’occhio la commissione scritta dal cliente, poi il copista ridipinge. L’archivista impara prima e poi smette di imparare.
Per decidere quanto dare retta alla richiesta si interroga la rete due volte, una senza dirle niente e una dandole la richiesta, e si guarda di quanto le due risposte differiscono: quella differenza è il contributo del testo, ed è piccola. Si cammina lungo la prima risposta più quella differenza moltiplicata, di solito per sette e mezzo. Più si moltiplica, più il modello ubbidisce e meno inventa; esagerando, l’immagine viene «sovracotta».
I pesi aperti hanno generato una comunità e non solo un’utenza: sono nate tecniche per specializzare il modello con file da pochi megabyte, o per fargli seguire uno schizzo. Per lo schizzo, al restauratore che non si vuole toccare si affianca un apprendista, copia della sua prima fase, che guarda anche lo schizzo ed è collegato con manopole che partono da zero: all’inizio il restauratore lavora come prima, e le manopole si aprono già dal primo giro di addestramento. Se schizzo e commissione non si accordano, esce un compromesso.
Restano aperti i problemi del consenso di chi finisce ritratto, dei diritti sulle immagini con cui questi modelli sono addestrati e della provenienza, cioè del riuscire a dire se un’immagine è stata generata. Sono altrettanto strutturali dei difetti dei modelli di linguaggio, e non si risolvono con la sola tecnica.
Da ricordare
Diffondere sui pixel è uno spreco: gran parte dei \(786\,432\) numeri di un’immagine \(512 \times 512\) è dettaglio percettivo. I latent diffusion models [RBL+22] spostano la diffusione in uno spazio compresso (\(64 \times 64 \times 4\): 48 volte meno).
La compressione la fa il variational autoencoder [KW14]: encoder \(q_\phi(\mathbf{z} \mid \mathbf{x})\) e decoder \(p_\psi(\mathbf{x} \mid \mathbf{z})\) addestrati sull’ELBO, il cui termine KL tiene aperto il margine e raccoglie i codici attorno al prior. In Stable Diffusion quel termine pesa pochissimo e si aggiungono una loss percettiva e una avversaria; il VAE è addestrato prima e poi congelato, e la sua capacità di ricostruzione è un limite superiore sulla qualità del sistema.
Il latente va riscalato prima di diffonderci sopra (in SD 1.x per la costante \(0{,}18215\)), e la riscalatura va disfatta prima di decodificare: lo schedule variance-preserving presuppone varianza unitaria, che il latente del VAE non ha.
La ricetta: encoder → diffusione con U-Net nel latente → decoder; il prompt, trasformato dal text encoder di CLIP [RKH+21], entra nella U-Net via cross-attention (la stessa formula dei Transformer, con \(\mathbf{Q}\) dal latente e \(\mathbf{K}\), \(\mathbf{V}\) dal testo).
La classifier-free guidance [HS22] addestra il modello anche senza prompt e in inferenza estrapola tra predizione condizionata e non, con peso \(w\): più aderenza al testo, meno varietà. Il «classificatore implicito» è un’ispirazione, non un oggetto (il campo guidato non è conservativo), e per \(w > 1\) non si campiona più da \(p(\mathbf{x} \mid c)\) e nemmeno dall’inclinata \(p(\mathbf{x})\,p(c \mid \mathbf{x})^w\), che è la giustificazione corrente [BN24]. I negative prompt sono la stessa formula al contrario.
I pesi aperti (agosto 2022) hanno generato un ecosistema (LoRA [HSW+22], ControlNet [ZRA23], interfacce di comunità) e una traiettoria che finisce col sostituire la U-Net con un Transformer (i Diffusion Transformer).
ControlNet: copia allenabile del codificatore della U-Net, collegata con convoluzioni \(1\times1\) inizializzate a zero (inizializzate a caso, la copia perde ciò che sapeva). All’inizio \(\mathbf{y}_c = \mathcal{F}(\mathbf{x};\Theta)\), al primo passo riceve gradiente solo la convoluzione a zero d’uscita, e i pesi originali non cambiano mai: la stessa mossa di LoRA, con \(\mathbf{B} = \mathbf{0}\).
Restano aperti i nodi di consenso, diritti sui dati di addestramento e provenienza delle immagini: paralleli ai bias e alle allucinazioni dei modelli di linguaggio, e altrettanto strutturali.
Della ricetta di Stable Diffusion tre elementi servono ancora: il VAE che comprime (l’archivista), il condizionamento sul testo attraverso la cross-attention (la commissione scritta) e il peso della guida. Resta da vedere che cosa succede quando al posto del restauratore, la U-Net, si mette il Transformer dei modelli di linguaggio: è la storia dei Diffusion Transformer.