


Dal suono alle feature#
Quando pronunciamo una parola non facciamo altro che spingere aria. Le corde vocali vibrano, l’aria si comprime e si dirada (si rarefà, dicono i fisici), e un’onda di pressione viaggia fino al timpano di chi ascolta, o alla membrana di un microfono. Negli anni Quaranta, ai Bell Labs, il gruppo guidato da Ralph Potter costruì il sound spectrograph, una macchina che trasformava quest’onda in un’immagine [KDL46]; e le immagini che ne uscivano le chiamò visible speech, «parola visibile», riprendendo il titolo dell’alfabeto fonetico che Alexander Melville Bell aveva pubblicato ottant’anni prima [PKG47]. È esattamente il percorso che compie oggi qualsiasi sistema che lavora sull’audio (riconoscere una voce, un canto, un allarme) prima ancora di provare a capire cosa quel suono significhi: trasformare un’onda in numeri, e i numeri in un’immagine su cui un modello sa lavorare.
Le feature sono le grandezze numeriche con cui si descrive un esempio a un modello. Per un suono vanno dai campioni dell’onda fino allo spettrogramma log-mel, e quali scegliere dipende da che cosa il modello deve riconoscere.
Il suono come numeri#
Un microfono trasforma la variazione di pressione dell’aria in un segnale elettrico: una membrana si sposta seguendo la pressione, e il suo spostamento diventa una tensione che si può misurare. Quel movimento è un’oscillazione, e la membrana non fa che ricopiare quella dell’aria: quante volte al secondo l’aria si comprime e si dirada si chiama frequenza. Si misura in hertz (Hz), e mille hertz fanno un kilohertz (kHz). Frequenza alta vuol dire suono acuto, frequenza bassa suono grave: il la del diapason oscilla 440 volte al secondo, cioè 440 Hz, e la stessa nota un’ottava sopra ne fa il doppio, 880.
Per portare quell’oscillazione dentro un calcolatore la si misura a intervalli regolari. Ciascuna misura è un campione: il valore del segnale in un istante preciso, e prenderle si dice campionare. (Il termine ha qui un senso diverso da quello della statistica, dove un campione è un gruppo di esempi estratti da una popolazione.) Un suono digitale è una fila di campioni, e restano due scelte: quanti prenderne al secondo, cioè la frequenza di campionamento, e con quanta finezza scrivere ciascuno, cioè la risoluzione, contata in bit. Alla prima risponde il teorema di Nyquist. Per la seconda la risposta abituale è sedici bit per campione: sedici risposte sì/no, e siccome ogni risposta raddoppia i casi possibili, 65.536 livelli. Il gradino fra due livelli vicini è allora un sessantacinquemillesimo dell’escursione, e in un ascolto normale l’orecchio non lo coglie; a otto bit sarebbe un duecentocinquantaseiesimo, e un suono debole ci finirebbe sotto. Proprio con 256 livelli lavora però WaveNet, una rete che genera l’onda un campione alla volta, e Generare suono e musica racconta il trucco con cui li fa bastare.
Un sismografo disegna la scossa con un pennino che sale e scende su un rullo di carta. Una macchina fa lo stesso mestiere con il suono, solo che invece di una linea scrive numeri: annota dov’è la membrana del microfono, migliaia di volte al secondo. Il risultato è una lunghissima lista: quanto era «in avanti» o «in indietro» la membrana in ogni istante. Un suono, per il computer, è tutto qui: una sequenza di numeri che sale e scende nel tempo. Numeri grandi (in positivo o in negativo), quando il suono è forte, vicini allo zero quando c’è silenzio.
Due decisioni restano da prendere: ogni quanto guardare la membrana, e con quanta finezza scrivere quello che si è visto. Il pennino può fermarsi ovunque, il numero no: ogni misura viene arrotondata alla tacca più vicina di un righello, e le tacche sono in numero fisso, deciso una volta per tutte.
Il suono è un segnale continuo \(x(t)\): l’ampiezza dell’onda di pressione in funzione del tempo. La digitalizzazione compie due operazioni. Il campionamento discretizza il tempo, misurando \(x\) a intervalli regolari \(T_s\) e ottenendo la sequenza \(x[n] = x(nT_s)\). La quantizzazione discretizza l’ampiezza su un numero finito di livelli: con la codifica PCM a \(b = 16\) bit ogni campione è un intero su \(2^{16} = 65536\) valori. Un secondo di audio «CD» è quindi, per ogni canale, un vettore di \(44\,100\) interi.
Il campionamento, sotto le ipotesi del teorema che segue, non perde niente; la quantizzazione perde sempre. Con passo uniforme \(\Delta = 2A/2^b\) su un’escursione \([-A, A]\), l’errore di arrotondamento sta in \([-\Delta/2, \Delta/2]\), e se il segnale è abbastanza vario da renderlo scorrelato da \(x\) lo si modella come rumore uniforme di varianza \(\Delta^2/12\). Per una sinusoide a piena scala, di potenza \(A^2/2\), il rapporto segnale-rumore di quantizzazione vale
circa \(98\) dB a \(16\) bit e \(50\) a \(8\): ogni bit vale sei decibel. Il conto però è a piena scala. Il rumore \(\Delta^2/12\) resta lo stesso qualunque sia il segnale, quindi un suono dieci volte più debole perde \(20\) dB di SNR, e un sussurro a \(8\) bit finisce sotto il rumore del gradino; a livelli così bassi l’errore smette anche di somigliare a un rumore indipendente, e il modello uniforme non vale più. È il difetto che la compansione \(\mu\)-law di Generare suono e musica corregge, spendendo i livelli dove l’ampiezza è piccola perché l’SNR resti quasi costante.
Quanti campioni al secondo? Il teorema di Nyquist#
Quante misure al secondo servono per non perdere informazione? Se sono troppo poche compare l’aliasing: una frequenza troppo alta per il ritmo delle misure si traveste da una più bassa, che nel suono non c’era. Se sono troppe, crescono memoria e calcolo senza alcun guadagno. Da qui in avanti «frequenza» fa due mestieri. La frequenza di un suono dice se è acuto o grave, e dipende dal suono; la frequenza di campionamento \(f_s\) dice quante misure al secondo si prendono, e la si sceglie. Si scrivono tutte e due in hertz, ed è lì che ci si confonde.
Nei film le ruote delle auto ogni tanto sembrano girare al contrario, o stare ferme: capita perché la telecamera scatta troppe poche foto al secondo per tenere il passo del giro. Con il suono succede la stessa cosa, e la battuta finale è altrettanto strana. Un fischio troppo acuto per il numero di misure che stiamo prendendo non sparisce: si traveste, e ricompare più grave di quanto era, come una nota che nessuno ha mai suonato.
E una volta sulla pellicola il travestimento non si smaschera più: quella ruota che sembra girare al rovescio non si distingue da una ruota che girava davvero al rovescio. Per questo, prima di misurare, si fa passare il suono per un filtro che lascia passare le note gravi e ferma quelle troppo acute: tolto prima, il fischio non ha modo di travestirsi.
La regola che tiene lontano il travestimento è semplice: misurare più del doppio delle volte rispetto alla vibrazione più rapida che vogliamo catturare. E il doppio viene da qui: per accorgersi che qualcosa sale e scende bisogna sorprenderlo almeno due volte a ogni giro, una mentre è su e una mentre è giù. Chi guarda una volta sola per giro lo ritrova sempre allo stesso punto, e lo vede fermo, come la ruota. L’orecchio umano arriva a circa 20.000 oscillazioni al secondo, quindi servono più di 40.000 misure al secondo: i CD ne fanno 44.100, che stanno larghi apposta. Per la voce al telefono ne bastano 8.000, perché la linea toglie, prima di misurare, le oscillazioni sopra le 3.400 al secondo, e sotto quella soglia la voce «vive» quasi tutta; il margine fra il doppio di 3.400 e gli 8.000 c’è perché nessun filtro taglia di netto.
La via di mezzo, 16.000 misure al secondo, è la scelta abituale dei sistemi che lavorano sulla voce. Per la musica non basta, e si sale fino a 48.000: il brillare di un piatto della batteria, o il fischio acutissimo di certi uccelli, vivono lassù, dove la voce non arriva.
È il teorema del campionamento di Nyquist–Shannon: per ricostruire senza perdita un segnale la cui frequenza massima è \(f_{\max}\), la frequenza di campionamento deve soddisfare
dove \(f_{\max}\) è la frequenza oltre la quale lo spettro del segnale (la sua decomposizione in frequenze pure, prodotta dalla trasformata di Fourier) è nullo: per un segnale che non sia una sinusoide pura, «la frequenza più alta» non è definibile senza quella decomposizione, ed è la ragione per cui l’enunciato di Nyquist ha bisogno di quello strumento.
La soglia \(f_s/2\) è la frequenza di Nyquist. Sotto l’ipotesi che lo spettro sia nullo oltre \(f_{\max}\) (segnale a banda limitata), il teorema dà anche la ricostruzione esplicita,
un’interpolazione con un nucleo che si estende all’infinito nei due versi: esatta in teoria, approssimata con un filtro troncato in pratica. Se invece il segnale contiene componenti oltre la soglia, esse si «ripiegano» su frequenze più basse generando l’aliasing: un coseno a frequenza \(f\) dà gli stessi campioni di un coseno a \(|f - k f_s|\) per ogni intero \(k\), quindi dopo il campionamento è indistinguibile dalla sua immagine nella banda \([0, f_s/2]\) (un tono a \(5\) kHz campionato a \(8\) kHz dà esattamente i campioni di un tono a \(3\) kHz). Sono artefatti irreversibili. Per questo si applica un filtro anti-aliasing (passa-basso) prima di campionare. La voce viene tipicamente trattata a \(f_s = 16\,\text{kHz}\), un buon compromesso tra fedeltà e peso.
Dal tempo alla frequenza: la trasformata di Fourier#
La lista di campioni ha un nome, forma d’onda, ed è il disegno che farebbe un sismografo: quanto era in avanti o indietro la membrana, istante per istante. Dice quando il suono è forte o debole, ma non di quali «note» è fatto, ed è proprio quella composizione a distinguere una «a» da una «i», o la voce di una persona da un’altra. Il cambio di punto di vista che la rende leggibile è la trasformata di Fourier. Nella forma che usa un calcolatore, la trasformata di Fourier discreta (DFT), prende \(N\) campioni \(x[0], \dots, x[N-1]\) e restituisce \(N\) coefficienti
Si legge così. Per ogni \(k\) si prende un’oscillazione che compie esattamente \(k\) giri negli \(N\) campioni, cioè di frequenza \(k\,f_s/N\) hertz; la si confronta con il segnale moltiplicando campione per campione, e si somma. Se il segnale contiene quell’oscillazione i prodotti vanno d’accordo e la somma è grande; se non la contiene si compensano, e la somma resta vicina a zero. Il fattore \(e^{-i\theta} = \cos\theta - i\sin\theta\) porta insieme un coseno e un seno della stessa frequenza, e per questo \(X[k]\) è un numero complesso: il suo modulo \(|X[k]|\) dice quanta parte di quella frequenza c’è nel segnale, il suo angolo dice a che punto della propria oscillazione si trova, ed è la fase (modulo e angolo sono quelli dei numeri complessi incontrati con le catene di Markov). L’algoritmo con cui la si calcola in pratica, la FFT (Fast Fourier Transform), richiede \(O(N\log N)\) operazioni invece delle \(N^2\) della somma scritta così.
Ascolta un accordo al pianoforte: senti più note insieme, ma il tuo orecchio riesce a dire quali sono. La trasformata di Fourier fa lo stesso con un suono qualsiasi: prende l’onda ingarbugliata e la scompone nelle sue frequenze pure, dicendoti quanto di ciascuna è presente. È come un prisma che separa la luce bianca nei colori dell’arcobaleno: la luce sembrava una sola, invece era una somma. La trasformata fa la sua cernita così: mette il suono accanto a una nota pura alla volta, e guarda quanto le somiglia, molto, poco o niente.
Per strada non si perde niente. I colori rimessi insieme ridanno la luce bianca, e le frequenze rimesse insieme ridanno l’onda esatta di partenza: sono gli stessi numeri, tanti quanti erano, scritti in un altro alfabeto. Di ogni nota la trasformata dice due cose, quanta ce n’è e a che punto della propria oscillazione si trova quando il tratto comincia; e servono tutte e due, perché senza la seconda le note non si rimettono insieme nel modo giusto.
L’idea risale a Joseph Fourier (1822): un segnale si scrive come somma di sinusoidi di frequenze diverse. Nel discreto le \(N\) esponenziali \(\boldsymbol{\phi}_k = \big(e^{\,i\,2\pi kn/N}\big)_{n=0}^{N-1}\), \(k = 0, \dots, N-1\), sono ortogonali in \(\mathbb{C}^N\),
perché per \(k \ne k'\) la somma è una serie geometrica di ragione \(e^{\,i\,2\pi(k-k')/N} \ne 1\) che compie un numero intero di giri e si annulla. Formano quindi una base, e \(X[k] = \langle \mathbf{x}, \boldsymbol{\phi}_k \rangle\) è la coordinata di \(\mathbf{x}\) lungo la \(k\)-esima: la DFT è un cambio di base ortogonale, a meno del fattore \(\sqrt{N}\) (come le basi ortonormali di Ortogonalità e proiezioni). Ne seguono l’inversa,
e la conservazione dell’energia (identità di Parseval),
\(\sum_n |x[n]|^2 = \frac{1}{N}\sum_k |X[k]|^2\), che giustifica il nome di
spettro di potenza per \(|X[k]|^2\). L’inversa ha bisogno dei coefficienti
complessi, modulo e fase: con i soli moduli il cambio di base non si inverte.
Se \(x\) è reale vale poi \(X[N-k] = \overline{X[k]}\), quindi metà dei
coefficienti ripete l’altra metà e bastano i primi \(\lfloor N/2 \rfloor + 1\),
che coprono le frequenze da \(0\) a \(f_s/2\): oltre la frequenza di Nyquist lo
spettro di un segnale campionato è la copia speculare di quello sotto, ed è la
stessa piega dell’aliasing. Con \(N = 400\) a \(16\) kHz sono \(201\) righe spaziate
di \(40\) Hz, da \(0\) a \(8\) kHz, ed è il numero di righe che librosa calcola
prima di applicare il banco mel.
Lo spettrogramma: l’immagine del suono#
C’è un problema: i moduli \(|X[k]|\) della trasformata di un intero file dicono quali frequenze ci sono, ma non quando. L’informazione sui tempi non è persa, ma sta nelle fasi di tutti i coefficienti insieme, in una forma che non si legge; e una frase è fatta di suoni che cambiano di continuo. La soluzione è tagliare l’audio in finestre brevi (20–40 millisecondi), calcolare la trasformata di ciascuna, e affiancare i risultati. È la trasformata di Fourier a finestre brevi, che in letteratura si trova sempre con la sigla inglese: STFT, Short-Time Fourier Transform. Il risultato, disposto in una tabella, è lo spettrogramma: un’immagine con il tempo sull’asse orizzontale, la frequenza su quello verticale, e l’intensità di ciascuna frequenza resa dal colore (Fig. 23.2).
Di ogni frequenza l’immagine tiene il modulo, quanta ce n’è, e butta via la fase. Senza la fase dall’immagine non si risale al suono in modo univoco: per riaverlo la fase va stimata, per esempio per tentativi successivi con l’algoritmo di Griffin e Lim [GL84], oppure fatta produrre a una rete addestrata apposta, un vocoder. Per riconoscere un suono non serve; servirà quando si vorrà produrne uno.

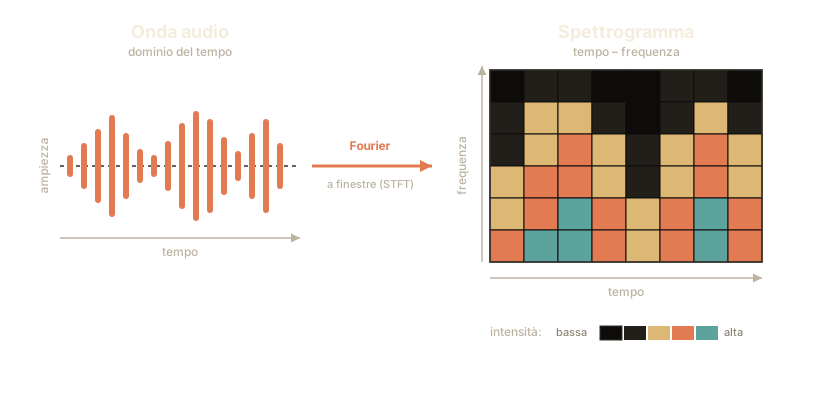
Fig. 23.2 Dalla forma d’onda allo spettrogramma. La trasformata di Fourier a finestre (STFT) trasforma il segnale nel tempo in una mappa tempo–frequenza: ogni cella dice quanta energia c’è a una certa frequenza in un certo istante.#
Quella mappa non nasce tutta insieme: si riempie una colonna alla volta, e Fig. 23.3 mostra il gesto. La finestra scorre sul segnale a passi regolari, e ogni sua posizione lascia dietro di sé una colonna.

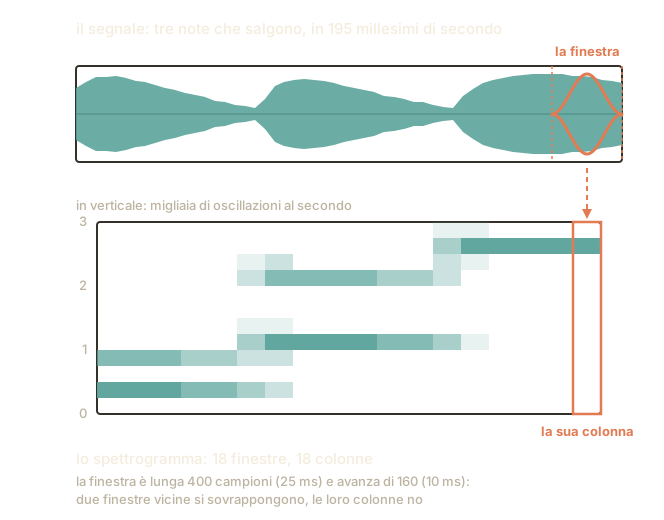
Fig. 23.3 Il segnale sono tre note che salgono, una dopo l’altra. La finestra ci scorre sopra un passo alla volta e a ogni posizione lascia una colonna dello spettrogramma: è lunga 25 millesimi di secondo e avanza di 10 alla volta, quindi due finestre vicine coprono in parte lo stesso pezzo di suono, mentre le colonne che ne escono restano una accanto all’altra. Le note che salgono si vedono come gradini, ed è esattamente l’informazione che la trasformata del file intero non saprebbe dare.#
Le finestre a cavallo fra una nota e l’altra mostrano entrambe le frequenze, ed è la cosa più istruttiva del disegno: è il compromesso su cui la trasformata a finestre è costruita, non una sbavatura. Una finestra lunga distingue bene le frequenze e male gli istanti, perché dentro ci finiscono due note; una corta fa il contrario. Non esiste una lunghezza che vinca su tutti e due i fronti, ed è per questo che sceglierla è una decisione e non un dettaglio.
Nel disegno la finestra è gonfia in mezzo e va a zero ai bordi, invece del rettangolo che la parola «finestrella» lascerebbe immaginare. Tagliare di netto un pezzo di onda creerebbe due gradini artificiali agli estremi, e la trasformata leggerebbe quei gradini come frequenze che nel suono non ci sono. Smussando i bordi il taglio diventa una dissolvenza e il difetto quasi sparisce, al prezzo di dare meno peso a ciò che capita ai margini. La curva più usata per farlo si chiama finestra di Hann, dal nome del meteorologo austriaco Julius von Hann, ed è quella disegnata in Fig. 23.3.
Chi accorda un pianoforte non guarda niente, ascolta. Tiene il diapason vicino alla corda del la e aspetta che il suono ondeggi: due note quasi uguali si rinforzano e si smorzano a turno, e quelle ondate si contano. Più sono vicine, più le ondate vengono lente, e più bisogna aspettare per sentirne una. Chi ha fretta sente una nota sola e se ne va convinto.
La finestra ascolta allo stesso modo, e paga lo stesso prezzo: per dire che nota era deve sentirla oscillare un po’ di volte, e quel po’ di tempo è esattamente l’istante che si perde.
I due lati del baratto hanno dei numeri, e si misurano come una dispersione, la stessa idea della deviazione standard di Probabilità e statistica: di quanto si allarga la macchia che la finestra lascia nel tempo, e di quanto nelle note. Con la finestra da 25 millesimi di secondo la macchia nel tempo è larga circa 3,5 millesimi, quella nelle note circa 23 oscillazioni al secondo, e il loro prodotto fa \(3{,}5 \times 23 = 80{,}5\).
Quel 23 non è però la distanza minima fra due note che si riescono a separare, che è più larga: con questa finestra ne servono una sessantina, cioè una volta e mezza di ondata dentro i 25 millesimi, e anche così le due note si separano o no a seconda della fase, cioè di dove si trova ciascuna nella propria oscillazione quando la finestra si apre. Due tasti vicini attorno al la distano 26 oscillazioni al secondo, e di ondate non ne fanno nemmeno una: restano una macchia sola.
Allunghiamo la finestra a 100 millesimi, quattro volte tanto. Adesso le ondate ci stanno, e i due tasti si separano: fra i due picchi si apre un avvallamento ben visibile. La macchia nelle note si è stretta di quattro volte (23 diviso 4 fa 5,75), quella nel tempo si è allargata di quattro (3,5 per 4 fa 14 millesimi), e il prodotto è quello di prima: \(14 \times 5{,}75 = 80{,}5\).
Quel prodotto resta lo stesso comunque si allunghi o accorci la finestra. Cambiandole la forma si scende un pochino, poi ci si ferma: sotto una certa soglia non ci va nessuna curva. Nemmeno far scorrere la finestra a passi più fitti aiuta: le colonne si stringono, ma la macchia resta la stessa, solo disegnata su più colonne.
Formalmente la STFT di un segnale \(\mathbf{x}\), i cui campioni sono gli \(x[n]\), è
dove \(\mathbf{w}\) è la finestra (lunga \(N\) campioni), \(H\) il passo (hop) di cui
essa avanza da una colonna alla successiva, \(m\) l’indice della colonna e \(k\)
quello del bin di frequenza. La finestra di Hann, nella forma periodica che
usano librosa e scipy, è \(w[n] = \tfrac12\big(1 - \cos\frac{2\pi
n}{N}\big)\) per \(0 \le n < N\), e lo spettrogramma di potenza è
\(S[m,k] = |X[m,k]|^2\): è la matrice da cui parte tutto il resto della pagina.
Con frequenza di campionamento \(f_s\) la trasformata restituisce bin spaziati di
\(f_s/N\) hertz e una colonna ogni \(H/f_s\) secondi. Sono i passi con cui
campioniamo il piano tempo-frequenza, e non vanno confusi con la
risoluzione: infittirli (zero-padding in frequenza, \(H\) più piccolo nel tempo)
non aggiunge informazione, la interpola soltanto. La risoluzione vera dipende
dalla lunghezza della finestra (a parità di forma, solo da quella), e ha un
limite che nessuna scelta di parametri aggira. Per il parlato la scelta
standard è una finestra di 25 ms e un passo di 10 ms (a 16 kHz sono
\(N = 400\) campioni e \(H = 160\), cioè
n_fft=400 e hop_length=160 per librosa), perché i fonemi durano decine di
millisecondi e una finestra più lunga ne mescolerebbe due.
Con modulo e fase la STFT si inverte: si antitrasforma ogni colonna, la si rimoltiplica per la finestra, si sommano i pezzi sovrapposti e si divide per \(\sum_m w^2[n - mH]\). Basta che quella somma non si annulli (la condizione detta NOLA, nonzero overlap-add), e con la finestra di Hann e un passo più corto della finestra all’interno del segnale non si annulla mai. Con il solo modulo, cioè con lo spettrogramma, l’inversione è invece un problema mal posto: si cerca un segnale la cui STFT abbia quel modulo, e l’algoritmo di Griffin e Lim lo fa alternando una stima della fase e la ricostruzione che le corrisponde, con un errore che non cresce da un giro all’altro ma senza garanzia di ritrovare l’originale [GL84].
Il compromesso è teorico e non pratico: viene dalla relazione di indeterminazione di Gabor (1946), l’analogo per l’analisi di Fourier del principio di indeterminazione di Heisenberg,
dove \(\sigma_t\) e \(\sigma_f\) sono le deviazioni standard dell’energia della finestra nel tempo e in frequenza. L’uguaglianza vale per la finestra gaussiana; per la finestra di Hann il prodotto vale \(0{,}0817\) contro il limite \(1/(4\pi) = 0{,}0796\), ed è costante al variare della lunghezza: la Hann da 25 ms ha \(\sigma_t \approx 3{,}54\) ms e \(\sigma_f \approx 23{,}1\) Hz, quella da 100 ms \(\sigma_t \approx 14{,}1\) ms e \(\sigma_f \approx 5{,}77\) Hz. Quadruplicare la finestra quadruplica \(\sigma_t\) e divide \(\sigma_f\) per quattro, senza sconti. Non esiste una finestra furba: esiste un cambio fisso, e sceglierne la lunghezza significa decidere quale delle due risoluzioni si vuole comprare.
È la stessa «parola visibile» di Potter. Nello spettrogramma di una vocale alcune bande orizzontali sono più intense delle altre: sono le frequenze che la bocca e la gola, facendo da cassa di risonanza come il corpo di una chitarra, rinforzano più delle vicine. Cambiano a seconda di come teniamo lingua e labbra, ed è per questo che distinguono una «a» da una «i». Si chiamano formanti, e sono il primo esempio di una cosa che si vede nell’immagine del suono e non si vedeva nell’onda. Un modello può quindi trattare lo spettrogramma come un’immagine a un canale, con le reti convoluzionali o con i Transformer a tessere. Con una riserva, che la sezione sulla classificazione riprende: i due assi non si equivalgono, perché spostare un motivo nel tempo lo lascia uguale, mentre spostarlo in frequenza ne cambia l’altezza.
MFCC e la scala mel: ascoltare come un orecchio#
Lo spettrogramma contiene molti più numeri di quanti ne servano a distinguere un suono dall’altro: righe vicine si somigliano parecchio e molti valori ripetono quello che c’è accanto. Lo si riassume imitando il modo in cui l’orecchio percepisce davvero i suoni: le differenze che l’orecchio non coglie vengono scartate. Il riassunto più famoso porta la sigla inglese MFCC, da mel-frequency cepstral coefficients, cioè «coefficienti cepstrali in scala mel». I coefficienti sono semplicemente i numeri del riassunto; la scala mel è il modo di riscrivere le frequenze a orecchio; «cepstrale» è la parola strana, e vuole una spiegazione a parte.
«Cepstrale» non è un refuso per «spettrale». È un gioco di parole degli ingegneri che negli anni Sessanta inventarono il metodo: rovesciarono le prime lettere di spectrum (spec diventa ceps) per dire che allo spettro si applica una seconda trasformata, dopo quella di Fourier. La prima scompone il suono nelle sue frequenze; la seconda prende quella scomposizione e ne ricava un riassunto ancora più corto. Il termine è rimasto.
Il nostro orecchio non è un righello: distingue benissimo due note gravi vicine, ma fatica con due note acute altrettanto vicine. La scala mel riscrive le frequenze proprio così, come le sente una persona. Persone vere, per la precisione: la scala esce da gente messa ad ascoltare suoni in laboratorio, e non tutti hanno risposto allo stesso modo. Di scale mel ne circola più d’una, le bande che ne escono non coincidono, e quale si è usata va detto.
Gli MFCC prendono lo spettrogramma, lo rileggono con questa scala e lo riassumono in una manciata di numeri per finestrella (di solito 13) che catturano la «forma» del suono buttando via i dettagli inutili. Perché proprio 13? Nessuna legge di natura: negli anni Ottanta funzionavano bene sul parlato, e sono rimasti.
Quel riassunto serviva a macchine con pochissima memoria e pochissimo calcolo, e a un’altra cosa ancora. Quelle macchine trattavano ciascuno dei 13 numeri per conto suo, come se non avesse niente a che fare con gli altri, e per non sbagliare avevano bisogno di numeri che non si somigliassero. Le righe vicine dell’immagine invece si somigliano parecchio, e l’ultimo passaggio del riassunto le rimescola apposta, finché quella somiglianza sparisce. Le reti di oggi non hanno quel bisogno e si fermano un passo prima, all’immagine riletta a orecchio. Il rimescolamento anzi le danneggerebbe: una rete convoluzionale guarda insieme le righe vicine, come guarda insieme i pixel vicini di una foto, e dopo il rimescolamento due righe vicine non parlano più di frequenze vicine.
Resta il nome che ricorre dappertutto: log-mel. La parte «mel» è la riscrittura delle frequenze a orecchio. La parte «log» è la stessa idea applicata alle intensità: fra un sussurro e un concerto l’energia del suono cambia di cento milioni di volte, e sulla stessa immagine il sussurro sparirebbe sotto il concerto. Allora le intensità si schiacciano, in modo che passare da 1 a 10 conti quanto passare da 10 a 100 e da 100 a 1.000. È il trucco dei decibel, la scala con cui si misurano i rumori: ogni volta che l’energia si moltiplica per dieci si salgono dieci gradini, e cento milioni, che sono otto moltiplicazioni per dieci, fanno ottanta gradini. È la distanza fra 30 decibel (un sussurro) e 110 (un concerto), due numeri vicini per due mondi lontanissimi. Uno spettrogramma log-mel è l’immagine del suono con le frequenze riscritte a orecchio e le intensità schiacciate allo stesso modo.
La conversione da hertz a mel comprime le alte frequenze in modo logaritmico. Le formule in circolazione però sono più d’una, perché la scala mel è un’interpolazione di dati sperimentali di ascolto e non una legge fisica: non esiste la conversione. Gli esperimenti da cui la scala nasce sono di Stevens, Volkmann e Newman [SVN37], che chiesero a degli ascoltatori di dividere a metà l’altezza percepita di un tono e fissarono il riferimento in modo che un tono di 1000 Hz valesse 1000 mel. La formula più diffusa, proposta da Makhoul e Cosell nel 1976 e resa popolare dal manuale di O’Shaughnessy (1987), adottata dal toolkit HTK, è
mentre l’implementazione di Slaney, che librosa usa per impostazione
predefinita, tiene la scala lineare sotto 1 kHz e logaritmica sopra. Le due non
danno le stesse bande: con i parametri dell’esempio in librosa (\(f_s = 16\)
kHz, 40 bande) la decima banda è centrata a 594 Hz con la formula HTK e a
736 Hz con quella di Slaney, il 24 % più in alto. I centri si leggono da
librosa.mel_frequencies(n_mels=42, fmax=8000, htk=…)[1:-1], perché per 40
bande triangolari servono 42 frequenze e le due estreme sono bordi, non centri.
È una differenza che va dichiarata quando si confrontano due sistemi, ed è il
motivo per cui l’esempio passa htk=True: i centri delle bande diventano
quelli della formula di HTK, che rispetta il riferimento,
\(2595\log_{10}(1 + 1000/700) \approx 1000\). L’altezza dei triangoli resta invece
quella di Slaney, perché librosa normalizza ogni filtro per la sua area anche
con htk=True (norm="slaney" è il valore predefinito), mentre HTK non
normalizza: per riprodurlo per intero va passato anche norm=None.
La pipeline degli MFCC [DM80] parte dallo spettro di
potenza \(S[m,k]\) di una colonna della STFT e fa tre passi. Un banco di \(J\)
filtri triangolari \(H_j[k]\), con i centri spaziati uniformemente sulla scala
mel, ne raccoglie l’energia per banda, \(E_j = \sum_k H_j[k]\,S[m,k]\). Il
logaritmo delle energie di banda, \(\log E_j\), imita la percezione
dell’intensità, ed è la scala dei decibel: per una potenza \(P\) rispetto a un
riferimento \(P_0\) il livello è \(10\log_{10}(P/P_0)\) dB, per un’ampiezza \(A\),
che entra nella potenza al quadrato, \(20\log_{10}(A/A_0)\), e
librosa.power_to_db applica la prima allo spettrogramma di potenza, con
ref al posto di \(P_0\). Infine una trasformata coseno discreta (DCT-II),
decorrela le bande e concentra l’informazione nei primi coefficienti
(librosa ne usa la versione normalizzata, che cambia soltanto un fattore di
scala). Si tengono i primi \(\sim 13\) (compreso o no, secondo la convenzione,
\(c_0\), che è proporzionale all’energia logaritmica media della colonna): sono
le feature classiche dei sistemi pre-deep-learning basati su modelli di Markov
nascosti (HMM).
Senza la sua storia la DCT sembra un accorgimento di buon senso valido sempre. Non lo è: serviva a una cosa precisa e datata. I sistemi GMM-HMM modellavano ogni stato con gaussiane a covarianza diagonale, per costo e per scarsità di dati, e una covarianza diagonale su feature correlate è un modello sbagliato; le bande mel si sovrappongono, quindi correlate lo sono parecchio. Decorrelare le rendeva lecite. Caduta l’ipotesi, è caduta la ragione: una rete non chiede feature scorrelate, e la DCT le fa pagare un prezzo, perché mescolando tutte le bande in ogni coefficiente distrugge la località in frequenza su cui una convoluzione lavora. Per questo dagli anni Dieci si è tornati allo spettrogramma log-mel grezzo, mentre i 13 MFCC restano una feature d’archivio, ancora comoda dove serve un vettore piccolo (HuBERT li usa proprio per il primo raggruppamento).
Da qui in poi le strade si dividono. I modelli che prevedono un’etichetta o del testo partono dal log-mel (come AST, che ne usa 128 bande, o Whisper, che ne usa 80 e 128 nelle versioni più recenti). Quelli che generano del suono lavorano invece sui campioni, o ci ritornano con una rete addestrata apposta (un vocoder), perché il log-mel butta via la fase necessaria a ricostruire l’onda. E chi vuole imparare tutto dai dati sceglie i campioni comunque, e il banco di filtri che qui abbiamo disegnato a mano se lo costruisce da sé.
Perché queste feature aiutano il modello#
La forma d’onda grezza è enorme (decine di migliaia di numeri al secondo) e piena di variazioni che, per riconoscere un suono, non contano: il volume a cui la frase è stata registrata, o uno scarto di due millesimi di secondo sul suo inizio. Lo spettrogramma log-mel ne toglie di mezzo una parte, ciascuna per una ragione precisa. Uno spostamento più corto della finestra cambia quasi soltanto le fasi, e le fasi nell’immagine non ci sono più. Un cambio di volume moltiplica tutte le energie per lo stesso fattore, e dopo il logaritmo diventa uno spostamento costante di tutta l’immagine, che una rete assorbe facilmente. La scala mel, infine, riduce il numero di righe e tiene la risoluzione dove l’orecchio la usa. Il modello parte così da una descrizione più piccola e più stabile. Non tutto però se ne va: il rumore di fondo della stanza resta nell’immagine, sommato al suono, e a separarlo deve pensarci il modello.
I sistemi più recenti, come wav2vec 2.0 [BZMA20], che impara dall’onda grezza senza etichette, o Whisper [RKX+23], il riconoscitore vocale di OpenAI che il capitolo successivo racconta, tendono a imparare le feature direttamente dai dati. Ma non partono dal nulla: Whisper, per esempio, riceve in input proprio uno spettrogramma log-mel. La scala mel, ispirata al nostro orecchio, resta il punto di partenza più diffuso anche nell’era del deep learning.
La parola feature, quella del titolo, qui cambia padrone. Fin dal capitolo sul machine learning le feature erano scelte da noi: qualcuno decideva quali numeri estrarre da ogni esempio, e quella decisione era metà del lavoro. D’ora in poi saranno quasi sempre imparate dalla rete, che si costruisce da sé i numeri che le servono. La parola indica lo stesso oggetto (i numeri che descrivono un esempio) e cambia solo chi li sceglie; ma è il passaggio che divide le feature scelte a mano da quelle imparate, e conviene saperlo prima di incontrarlo scritto come se fosse ovvio.
In pratica#
Con la libreria librosa l’intera catena, dall’onda allo spettrogramma mel e
agli MFCC, è una manciata di righe.
import numpy as np
import librosa

# Con un file vero basterebbe una riga:
#     y, sr = librosa.load("frase.wav", sr=16000)
# Qui l'onda la costruiamo: tre secondi a 16.000 misure al secondo (lo
# standard per la voce), una nota a 220 Hz con un'armonica a 660 Hz, che si
# gonfia e si sgonfia quattro volte al secondo come le sillabe di una frase.
sr = 16000
t = np.arange(3 * sr) / sr
inviluppo = 0.5 * (1 + np.sin(2 * np.pi * 4 * t))
nota = np.sin(2 * np.pi * 220 * t) + 0.3 * np.sin(2 * np.pi * 660 * t)
y = (0.4 * inviluppo * nota).astype(np.float32)

# spettrogramma mel: 40 bande, finestre da 25 ms ogni 10 ms
# htk=True sceglie una delle due scale mel in circolazione: danno bande
# diverse, quindi qual e' delle due va sempre dichiarato
S = librosa.feature.melspectrogram(
    y=y, sr=sr, n_fft=400, hop_length=160, n_mels=40, htk=True
)
# intensita' schiacciate (la parte "log" del log-mel): i suoni deboli
# tornano visibili accanto a quelli forti
S_db = librosa.power_to_db(S, ref=S.max())

# 13 coefficienti MFCC per ogni finestra temporale: il riassunto piu' corto,
# calcolato DALLA S_db appena ottenuta
mfcc = librosa.feature.mfcc(S=S_db, n_mfcc=13)

# lo stesso riassunto chiesto partendo dall'onda: librosa rifa' lo
# spettrogramma da capo con i propri default (n_fft=2048, hop_length=512)
mfcc_da_capo = librosa.feature.mfcc(y=y, sr=sr, n_mfcc=13)

print("log-mel:        ", S_db.shape)           # (bande, colonne)
print("MFCC da S_db:   ", mfcc.shape)           # (coefficienti, colonne)
print("MFCC dall'onda: ", mfcc_da_capo.shape)
log-mel:         (40, 301)
MFCC da S_db:    (13, 301)
MFCC dall'onda:  (13, 94)
Le prime due tabelle escono con lo stesso numero di colonne, 301: tre secondi a
una colonna ogni 10 millisecondi fanno 300 colonne, più una, perché librosa
centra la prima finestra sull’istante zero. Sono allineate finestra per
finestra, quindi si possono affiancare e dare al modello insieme. La terza riga
mostra che cosa succede chiamando mfcc(y=...) invece di mfcc(S=...):
librosa rifà lo spettrogramma con il suo passo predefinito, una colonna ogni
512 campioni, e le colonne diventano 94, su un asse dei tempi diverso da quello
delle altre due. Affiancarle darebbe un errore di dimensione, o peggio, se le
lunghezze per caso coincidessero, due tabelle che parlano di istanti diversi.
Da ricordare
Per un computer un suono è una lunghissima lista di numeri: la posizione della membrana del microfono, annotata migliaia di volte al secondo come fa un sismografo. Ognuna di quelle annotazioni è un campione.
Frequenza vuol dire quante volte al secondo qualcosa oscilla, e si misura in hertz: tanta frequenza è un suono acuto, poca è un suono grave. Da non confondere con la frequenza di campionamento, che è quante volte al secondo noi misuriamo.
Bisogna misurare più del doppio delle volte rispetto alla vibrazione più rapida che vogliamo catturare: sotto quella soglia una nota troppo acuta si traveste da una più grave, come la ruota che nei film sembra girare al contrario. Per questo le note troppo acute si tolgono con un filtro prima di misurare.
La trasformata di Fourier è il prisma che scompone l’onda nelle sue frequenze pure; applicata a tante finestrelle brevi una dopo l’altra dà lo spettrogramma, l’immagine del suono (tempo in orizzontale, frequenze in verticale). L’immagine però tiene di ogni frequenza soltanto quanta ce n’è, e non a che punto della propria oscillazione stava (la fase): per tornare da lì al suono quel punto va indovinato, o fatto inventare a una rete apposta.
Le finestrelle non si possono avere insieme corte e precise sulle note: allungarle di quattro volte fa guadagnare quattro sulle note e perdere quattro sugli istanti, e il prodotto delle due imprecisioni resta lo stesso. Sceglierne la lunghezza vuol dire decidere quale delle due si compra.
La scala mel e gli MFCC rileggono quell’immagine come la sente un orecchio (preciso sui suoni gravi, approssimativo sugli acuti) e la riassumono in pochi numeri per finestrella: meno dati, ma quelli che contano davvero, e il modello ha un compito più facile.
I modelli di oggi però si fermano un passo prima: prendono l’immagine riletta a orecchio (lo spettrogramma log-mel, con anche le intensità schiacciate) e saltano il riassunto finale. Quel riassunto serviva a macchine con molta meno memoria, che per giunta trattavano ogni numero per conto suo e li volevano diversi l’uno dall’altro; a una rete non serve, e anzi il suo rimescolamento le confonde le righe vicine, che sono ciò su cui lavora. Un accorgimento intelligente smette di servire quando cambia chi lo usa.
Da ricordare
Un suono digitale è una sequenza di numeri (ampiezza nel tempo), \(x[n] = x(nT_s)\): campionamento del tempo e quantizzazione dell’ampiezza (PCM a 16 bit).
Il teorema di Nyquist impone \(f_s > 2 f_{\max}\): sotto quella soglia compare l’aliasing, e serve un filtro passa-basso prima di campionare.
La trasformata di Fourier passa dal tempo alle frequenze: la DFT è un cambio di base ortogonale, invertibile con modulo e fase, calcolata con la FFT in \(O(N\log N)\), e per un segnale reale bastano \(\lfloor N/2\rfloor + 1\) coefficienti. Applicata a finestre brevi (STFT) produce lo spettrogramma, che tiene il solo modulo: da lì si risale a un segnale plausibile (Griffin e Lim, o un vocoder), non in modo univoco all’originale.
La finestra impone un limite, non un compromesso negoziabile: \(\sigma_t \cdot \sigma_f \ge 1/(4\pi)\) (Gabor, 1946). Per una finestra di Hann il prodotto vale \(0{,}0817\) a ogni lunghezza: raddoppiare la finestra dimezza \(\sigma_f\) e raddoppia \(\sigma_t\), senza sconti.
La scala mel è un adattamento a dati percettivi, non una legge: di formule ne esiste più d’una (HTK contro Slaney) e danno bande diverse, quindi la scelta va dichiarata.
Gli MFCC (banco di filtri, logaritmo, DCT, primi \(\sim 13\) coefficienti) sono una feature d’archivio: la DCT serviva a rendere lecita la covarianza diagonale delle GMM, e con le reti profonde quell’ipotesi non c’è più. Chi in uscita ha un’etichetta o del testo parte dal log-mel grezzo; chi produce suono lavora sui campioni, o ci torna con un vocoder, perché il log-mel butta via la fase.
Con lo spettrogramma log-mel in mano un suono è diventato un’immagine a un canale, e riconoscerlo diventa in buona parte il mestiere delle reti che riconoscono immagini. Da lì parte Riconoscere i suoni, con una domanda che nell’audio è la regola: che cosa rispondere quando nella stessa clip suonano dieci cose insieme.