


Le basi di Python#
Il nucleo di Python è piccolo: 35 parole chiave nelle versioni attuali (quelle
che il linguaggio riserva a sé, come if, for e def, e che quindi non si
possono usare come nomi) e una manciata di costrutti che si combinano fra loro
invece di una regola speciale per ogni caso. Imparati quelli, il tempo si
spende a decidere che cosa dire, non a ricordare eccezioni.
Prima vengono i mattoni, poi gli attrezzi che si incontrano appena si legge codice scritto da altri: le comprehension, i messaggi d’errore, le classi, i decoratori, e il modo in cui Python fa più cose nello stesso momento.
Tipi fondamentali e variabili#
Il primo gesto della programmazione è dare un nome a un valore, per poterlo
richiamare più avanti: quel nome si chiama variabile. In Python la crei con
il segno =, che qui non significa «è uguale a» come in matematica, ma
«attacca il nome di sinistra al valore di destra», come si attacca
un’etichetta: eta = 34 si legge «da adesso eta vale 34». (Per chiedere se
due cose sono uguali serve il doppio uguale, ==.) Ogni valore appartiene
a una famiglia, il suo tipo: un numero, un testo, un vero-o-falso, una
lista di altri valori. La comodità è che
il tipo non lo devi dichiarare tu: Python guarda il valore e lo riconosce da
sé.
Tre tipi tornano più degli altri, e la differenza fra loro conta più di quanto sembri: il numero singolo, la stringa (una fila di caratteri, cioè del testo) e la lista (una fila di valori, ciascuno al suo posto: primo, secondo, terzo).

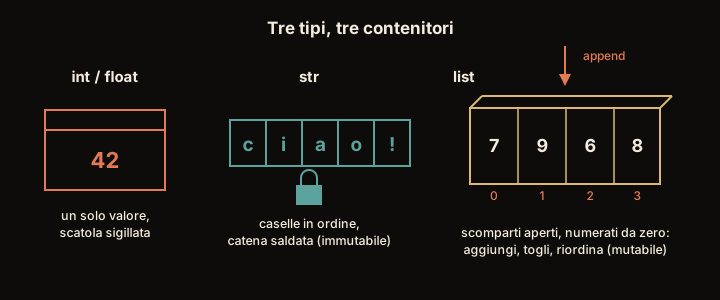
Fig. 2.3 Tre forme di contenitore. La differenza che conta non è cosa contengono ma se si può cambiarne il contenuto: la lista sì, la stringa no.#
Nel disegno le caselle della lista sono numerate a partire da zero: la prima è la numero 0, la seconda la numero 1. Sembra una stranezza, ed è invece la convenzione che fa tornare i conti: il numero di una casella dice quanti passi fare dall’inizio per arrivarci, e sulla prima sei già.
La distinzione mostrata in Fig. 2.3 tornerà spesso, con il nome di mutabilità, ed è all’origine di parecchi errori dei primi giorni. Una stringa non si può cambiare: si può solo fabbricarne una nuova a partire da quella vecchia, che resta intatta. Una lista invece si cambia sul posto. Detta così sembra una sottigliezza; è invece la ragione per cui, quando arriveremo alle funzioni, ne vedrai una modificare la lista che le passi e non la stringa.
eta = 34             # int   -> un numero intero
temperatura = 36.6   # float -> un numero con la virgola
nome = "Ada"         # str   -> una stringa di testo
attiva = True        # bool  -> vero (True) o falso (False)
Sono i quattro tipi di base: interi (int), decimali (float, e nel codice i
decimali si scrivono col punto, all’inglese: 36.6), stringhe (str) e
booleani (bool, cioè i due soli valori True e False). Per
sapere di che tipo è un valore si chiama type: chiamare vuol dire
scriverne il nome e mettere fra parentesi ciò su cui deve lavorare, e in
risposta si ottiene un valore (le cose che si usano così si chiamano
funzioni, e la sezione che porta il loro nome le riprende per bene).
type(temperatura)    # -> <class 'float'>
type(nome)           # -> <class 'str'>
La risposta nomina una classe: float è la classe di tutti i numeri con la
virgola, e la classe di un valore è il suo tipo detto con la parola tecnica. Su
che cosa sia una classe in generale, e su come ci si costruisce la propria,
torna la sezione sugli oggetti; per ora si legge «è un float».
Un’ultima cosa sulle stringhe, che tornano di continuo: le
f-string. Mettendo una f prima delle virgolette puoi infilare direttamente
il valore di una variabile fra parentesi graffe, invece di concatenare pezzi.
nome, eta = "Ada", 36            # due nomi a sinistra, due valori a destra:
                                 # nome <- "Ada", eta <- 36, in ordine
f"{nome} ha {eta} anni"          # -> 'Ada ha 36 anni'
f"la metà di {eta} è {eta / 2}"  # -> 'la metà di 36 è 18.0'
Perché 18.0 e non 18? Perché in Python 3 la divisione con la barra /
restituisce sempre un numero con la virgola, anche quando il risultato è
intero. (Per il quoziente intero esiste la doppia barra: 36 // 2 dà 18.)
Dentro le graffe può stare qualsiasi espressione, cioè qualunque cosa che
Python sappia ridurre a un valore: un conto, il nome di una variabile, una
chiamata a una funzione. Dopo i due punti si può aggiungere una specifica di
formato, fatta di due parti: quante cifre mostrare dopo la virgola, e il tipo
di presentazione (f per un decimale in notazione ordinaria, % per una
percentuale, che moltiplica per cento e aggiunge il segno). Serve ogni volta
che si vuole leggere un numero senza le cifre in eccesso che il computer
calcola:
loss = 0.0347218                 # l'errore di un modello: troppe cifre da leggere
f"loss: {loss:.3f}"              # -> 'loss: 0.035'      tre cifre, da decimale
f"accuratezza: {0.8723:.1%}"     # -> 'accuratezza: 87.2%'  una cifra, in percento
Una variabile è un’etichetta adesiva attaccata a un valore.
nome = "Ada" vuol dire «d’ora in poi l’etichetta nome sta su questa
stringa». La cosa comoda è che puoi spostare l’etichetta su un valore di tipo
diverso quando vuoi:
x = 5          # x è appiccicata a un intero
x = "cinque"   # ora la stessa etichetta sta su una stringa
Nessuna cerimonia, nessuna dichiarazione anticipata: assegni e vai. Questo modo di fare ha un nome, tipizzazione dinamica, e vuol dire soltanto che il tipo lo decide il valore, non una dichiarazione scritta da te. È una delle ragioni per cui Python è veloce da scrivere.
E niente impedisce di mettere due etichette sullo stesso valore: b = a
attacca il secondo nome alla stessa cosa a cui è attaccato il primo, senza
fabbricare niente di nuovo. Con i numeri la differenza non si sente; con una
lista si sente eccome, perché la lista si cambia sul posto: se a è [1, 2]
e dopo b = a scrivi b.append(3), anche a adesso è [1, 2, 3]. La lista
è una sola, con due etichette attaccate sopra, e chi la guarda da a vede
quello che è successo passando da b.
Se quello che volevi era una lista a parte, la copia va chiesta: b = a.copy()
fabbrica una seconda lista con dentro gli stessi valori, e da quel momento le
due vanno per conto loro.
Python è dinamicamente tipizzato: il tipo appartiene all’oggetto, non al
nome. Dinamico non vuol dire debole: fra tipi incompatibili Python non
converte di nascosto, e "1" + 1 solleva TypeError invece di produrre
"11" o 2. Un nome è solo un riferimento; x = 5 lega il nome x all’oggetto
intero 5. Ogni valore è un oggetto con un tipo a runtime, e lo stesso nome può
essere rilegato a oggetti di tipo diverso in momenti diversi.
Dettagli che contano più avanti. Gli int hanno precisione arbitraria
(non c’è overflow a 64 bit). I float sono double IEEE 754 a 64 bit, con una
quindicina di cifre decimali significative e decimali come \(0{,}1\) non
rappresentabili esattamente (0.1 + 0.2 == 0.3 è False, e due float si
confrontano con math.isclose). Le str sono sequenze Unicode
immutabili, e bool è una sottoclasse di int: infatti True == 1 e
False == 0. Dalla stessa premessa, il tipo che appartiene all’oggetto, viene
lo stile duck typing: conta cosa un oggetto sa fare, non a quale classe
appartiene.
Il modello a riferimenti ha due conseguenze immediate. La prima è l’alias: b = a non copia niente, dà un secondo nome allo stesso oggetto, e b.append(3)
si vede anche da a (per copiare servono a.copy(), che è superficiale, o
copy.deepcopy). La seconda è la distinzione fra i due confronti: is chiede
«sono lo stesso oggetto?», == chiede «valgono la stessa cosa?». L’unico uso
di is da imparare a memoria è if x is None. Usarlo sui numeri dà risultati
che dipendono da come CPython riusa gli oggetti (x = 1000; y = 1000; x is y
risponde True se le due righe stanno nello stesso blocco compilato e False
se le si digita separatamente all’interprete): è il motivo per cui non va usato
così.
Le strutture dati di ogni giorno#
Quattro contenitori coprono quasi tutto quello che si fa ogni giorno: la
lista, la tupla,
il dizionario e l’insieme. Nel codice si scrivono con i nomi inglesi
(list, tuple, dict, set), e ciascuno si riconosce dalle parentesi che
usa (dizionario e insieme usano entrambi le graffe, e li distinguono i due
punti che nel dizionario separano la chiave dal valore):
numeri = [3, 1, 4, 1, 5]                 # list: ordinata, modificabile
punto  = (45.46, 9.19)                   # tuple: ordinata, immutabile
prezzi = {"pane": 1.2, "latte": 0.9}     # dict: coppie chiave: valore
unici  = {3, 1, 4, 1}                    # set: il secondo 1 sparisce da solo
Nel dizionario ogni valore si trova cercando la
sua chiave, cioè la parola scritta prima dei due punti: prezzi non si
interroga per posizione, ma per nome. E nel set i valori
scritti sono quattro mentre quelli che restano sono tre: mettere due volte lo
stesso elemento non dà errore, semplicemente non aggiunge niente. Il set serve
a togliere i doppioni e a verificare in fretta se un elemento c’è; fra poche
righe len(unici) risponderà 3.

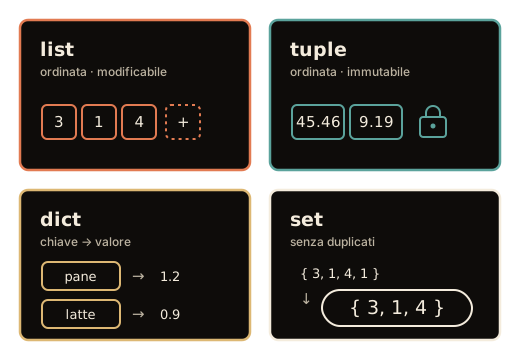
Fig. 2.4 Che aspetto hanno, una accanto all’altra: le quadre della lista, le tonde della tupla, le coppie del dizionario, e il set in cui i doppioni si fondono da soli.#
Fra i quattro si sceglie rispondendo a poche domande, non a memoria: gli elementi si possono cambiare dopo la creazione? Si cercano per posizione, per chiave, o basta sapere se ci sono? Possono ripetersi?

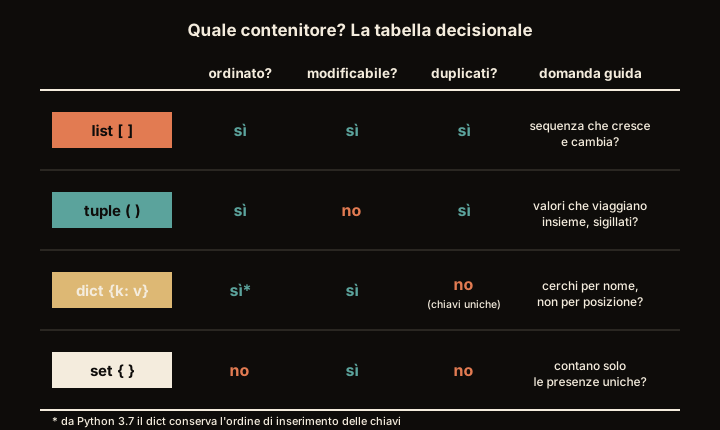
Fig. 2.5 Le quattro righe rispondono a queste domande, e l’ultima colonna dà per ciascun contenitore quella che lo sceglie. Scegliere il contenitore è rispondere a quelle, invece di ricordare a memoria quale si usa di solito.#
La colonna della modificabilità in Fig. 2.5 è quella che decide più spesso, e spiega a cosa serva una tupla, che a prima vista sembra soltanto una lista con qualcosa in meno. Il primo vantaggio è che nessuna parte del programma può sostituire un elemento di una tupla: se scrivi le coordinate di Milano in una tupla, quelle restano (se un elemento è a sua volta una lista, è la lista a poter cambiare, non il posto che occupa nella tupla).
Il secondo è che una tupla può fare da chiave di un dizionario, e una lista no. Il dizionario calcola dove tenere ogni valore a partire dal contenuto della chiave (è una tabella hash): se la chiave cambiasse dopo l’inserimento, il valore resterebbe nel posto calcolato dal contenuto vecchio e nessuno lo cercherebbe più. Come chiave va quindi bene solo qualcosa che non cambia, e che non cambia neanche dentro: una tupla di numeri va bene, una tupla che contiene una lista no. Ed ecco perché una coppia di nomi è molto comoda:
distanze = {("Milano", "Roma"): 573, ("Milano", "Napoli"): 770}
distanze[("Milano", "Roma")]     # -> 573
Sono i due vantaggi dell’immutabilità, che a prima vista sembrava soltanto una mancanza.
Le analogie aiutano (Fig. 2.4):
list, i fogli numerati di un quaderno: in fila, se ne aggiungono e se ne tolgono; aprire al decimo è immediato, ma per trovare il foglio su cui sta scritta una certa cosa bisogna sfogliarli dall’inizio.
tuple, le coordinate scritte a penna: una coppia fissa, non si cancella.
dict, il guardaroba di un teatro: consegni il cappotto (il valore) e ti danno un numero (la chiave). Il guardarobiere non scorre i ganci uno per uno: dal numero ricava il posto e ci va dritto, che i cappotti appesi siano dieci o diecimila. In una lista, invece, per trovare qualcosa bisogna passarla tutta, e più è lunga più costa. Ed è anche il motivo per cui la chiave non deve poter cambiare: se qualcuno riscrivesse il numero sullo scontrino, il guardarobiere andrebbe al gancio sbagliato, e il cappotto resterebbe appeso dove nessuno lo cerca più.
set, un sacchetto in cui i doppioni si fondono: mettere due volte lo stesso elemento non cambia nulla.
La differenza tecnica è mutabilità e hashabilità. list, dict e
set sono mutabili; tuple è immutabile, ed è hashable solo se lo sono
anche i suoi elementi: solo in quel caso può fare da chiave di dizionario.
dict e set sono tabelle hash: l’accesso e il test di appartenenza sono in
media \(O(1)\) (nel caso peggiore, con molte collisioni, \(O(n)\)), contro
l’\(O(n)\) della ricerca lineare in una lista. La lista è a sua volta un array
dinamico di riferimenti: l’accesso per indice è \(O(1)\), append e pop() in
coda sono \(O(1)\) ammortizzati, perché la lista cresce a scatti e tiene spazio
di riserva, mentre insert(0, x) e pop(0) sono \(O(n)\), perché spostano di
un posto tutti gli elementi. Una coda da cui si toglie in testa si scrive con
collections.deque, che fa \(O(1)\) ai due capi. Le chiavi di
un dict e gli elementi di un set devono essere hashable, cioè avere un
hash che non cambia nel tempo. Per i tipi built-in la proprietà coincide in
pratica con l’immutabilità (una tupla che contiene una lista, per esempio,
non è hashable): è il motivo per cui una lista non può stare in un set ma
una tupla di numeri sì. Fuori dai built-in la coincidenza cade, perché
un’istanza di una classe definita dall’utente è mutabile ed è hashable per
default (l’hash deriva dall’identità dell’oggetto), finché la classe non
ridefinisce __eq__. In quel caso Python pone __hash__ = None e l’istanza
smette di essere hashable, a meno di scrivere un __hash__ coerente con
l’uguaglianza (oggetti uguali devono avere hash uguale).
Le operazioni comuni sono brevi, e ricorrono di continuo:
numeri[0]            # il primo elemento (si conta da zero) -> 3
numeri[-1]           # l'ultimo, contando dalla fine        -> 5
numeri[1:4]          # una fetta: da 1 incluso a 4 escluso  -> [1, 4, 1]
numeri.append(9)     # aggiunge in coda   -> [3, 1, 4, 1, 5, 9]
numeri.remove(9)     # toglie il primo 9  -> [3, 1, 4, 1, 5]
prezzi["latte"]      # accesso per chiave -> 0.9
"pane" in prezzi     # test di appartenenza -> True
len(unici)           # quanti elementi    -> 3
La terza riga introduce la fetta (in inglese slice), che è il modo di
prendere un pezzo di una lista invece di un elemento solo: si scrivono due
posizioni (gli indici) separate dai due punti, e la seconda è esclusa.
Escluderla sembra scomodo, e fa guadagnare due comodità: la lunghezza della
fetta è la differenza dei due numeri, e due fette scritte di seguito, [0:3]
e [3:6], si incastrano senza sovrapporsi e senza buchi. Una fetta di una
lista è una copia (superficiale: gli elementi sono gli stessi oggetti):
modificarla non tocca l’originale. Con un array di NumPy la fetta è invece una
vista sugli stessi dati, e scriverci dentro cambia l’originale.
In quelle otto righe convivono due scritture diverse, che da qui in poi tornano di continuo.
len(unici) è una funzione generica: si scrive il nome, e fra parentesi le si
passa la cosa su cui lavorare.
numeri.append(9) invece si legge da sinistra a destra come una frase, «alla
lista numeri, aggiungi 9». Prima del punto c’è un oggetto (una lista, una
tabella), dopo il punto ciò che quell’oggetto sa fare, cioè un metodo: così
sono df.head() e modello.fit(...). Anche np.array(...) ha la forma
«nome, punto, nome», ma np è una libreria e array è una funzione che ne fa
parte, non un metodo.
Decidere e ripetere: il controllo di flusso#
Qui si vede la scelta di stile più visibile di Python. Un blocco è un gruppo di righe che vanno insieme (quelle da eseguire se una condizione è vera, per esempio), e in Python si segna facendolo rientrare verso destra: due punti, si va a capo, si spinge il testo dentro di qualche spazio. Quegli spazi sono sintassi a tutti gli effetti: sono loro a dire dove il blocco comincia e dove finisce, e sbagliarli è un errore come sbagliare una parola.
Si comincia dal decidere. if esegue il blocco rientrato solo se la
condizione che lo precede è vera, e se non lo è si passa alle alternative:
voto = 27
if voto >= 28:
    esito = "ottimo"
elif voto >= 18:      # "else if": una condizione alternativa
    esito = "promosso"
else:
    esito = "bocciato"

print(esito)          # -> promosso
Con voto che vale 27 la prima condizione è falsa, la seconda è vera, e delle
tre righe rientrate viene eseguita solo la seconda. L’ultima riga fa uscire il
risultato: print scrive sullo schermo ciò che gli si mette fra parentesi (il
nome viene da «stampare», ma la stampante non c’entra). In un programma
salvato in un file, senza un print il calcolo avviene e non se ne vede
niente: è la prima cosa che sconcerta chi comincia, e la ragione per cui
l’interprete, che invece risponde da sé, è più comodo per provare.
Per ripetere ci sono due cicli. Il for scorre gli elementi di un contenitore;
il while continua finché una condizione resta vera.
for v in numeri:      # v diventa a turno ogni elemento della lista
    print(v * 2)      # -> 6, 2, 8, 2, 10, uno per riga

i = 0
while i < 3:           # ripete finché la condizione è vera
    print("giro", i)   # -> giro 0, giro 1, giro 2
    i += 1             # scorciatoia di "i = i + 1": senza, ciclo infinito
Due cose servono subito. La prima è range: range(5) produce i numeri da 0 a
4, ed è il modo abituale di ripetere qualcosa un numero fissato di volte. La
seconda è come si esce da un ciclo prima della fine: break lo interrompe sul
posto, continue salta al giro successivo senza eseguire il resto.
for i in range(5):
    if i == 3:
        break         # esce qui: il giro con i = 3 finisce, il 4 non parte
    if i == 1:
        continue      # salta il resto di questo giro, e passa al prossimo
    print(i)          # -> 0, 2
Il while è quello a cui guardare con sospetto, ed è il soggetto della
Fig. 2.6.

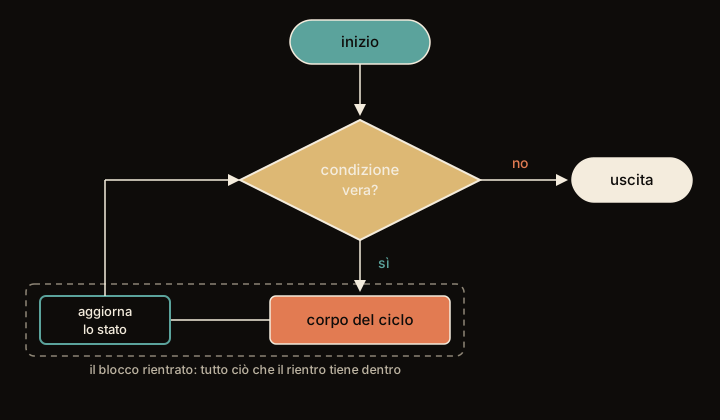
Fig. 2.6 Il ciclo come figura. Il riquadro tratteggiato è il blocco rientrato del codice: il rientro disegna esattamente quel contorno, e dice dove il corpo comincia e dove finisce.#
Il rombo è il punto in cui si annidano quasi tutti i cicli infiniti dei primi
giorni. Nel while di prima, i += 1 è l’istruzione che prima o poi rende
falsa la condizione: senza, i resterebbe 0, i < 3 sarebbe vera per sempre
e la freccia di ritorno riporterebbe sempre alla stessa condizione. Un ciclo
infinito non segnala nessun errore: il programma continua a girare. Lo si
ferma premendo Ctrl+C nella finestra in cui gira.
Due comodità rendono questi cicli più semplici di quanto ci si aspetti, e si incontrano subito tutte e due.
La prima: il for non conta, scorre. In molti altri linguaggi si scrive «da
zero fino alla lunghezza, prendi l’elemento numero i»; qui si dice «per ogni
elemento», e funziona su qualunque cosa si possa attraversare un pezzo per
volta: una lista, una stringa (un carattere alla volta), un dizionario (una
chiave alla volta). Gli indici, quando non servono, non si scrivono proprio.
La seconda: nelle condizioni, i valori «vuoti» contano come falsi. Una lista
vuota, la stringa vuota, il dizionario o l’insieme vuoti, lo zero (anche
0.0) e None (che è il modo in cui Python dice «niente»: un valore che sta
al posto di un valore mancante) si comportano come False, e quasi tutto il
resto come True. La regola non va imparata a memoria,
perché a rispondere è il contenitore stesso: interrogato, dice «sono vuoto», e
Python si limita a dargli retta.
carrello = []
if carrello:                  # una lista vuota è "falsa"
    print("hai articoli")
else:
    print("carrello vuoto")   # <- viene stampato questo
Così scrivi if carrello: invece di if len(carrello) > 0:, e si legge come
una frase.
Il for di Python è un for-each costruito sul protocollo di iterazione:
funziona su qualunque oggetto iterabile perché sa chiedergli un iteratore e
poi, a ripetizione, l’elemento successivo. Liste, tuple, stringhe, dizionari e
generatori rispondono tutti a quel protocollo, e il ciclo non sa nulla di come
sono fatti dentro. range(n) lo implementa in modo pigro, producendo gli
indici a richiesta senza materializzare la lista; enumerate dà
(indice, valore) e zip allinea più sequenze, fermandosi sulla più corta:
for i, prezzo in enumerate([1.2, 0.9]):   # 0 1.2 ; 1 0.9
    print(i, prezzo)
La «verità» di un oggetto è definita nello stesso modo, da un metodo speciale:
__bool__ se c’è, altrimenti __len__. Da qui il fatto che un contenitore
vuoto valga False, e il fatto che la regola valga identica per una classe
scritta da te, che quei metodi li può definire.
Funzioni: dare un nome a un blocco di lavoro#
Una funzione impacchetta un pezzo di logica dietro un nome, così lo riusi senza
riscriverlo. Si definisce con def; i valori che le si danno da lavorare si
chiamano argomenti (in italiano la parola fa pensare a «di cosa si parla»,
qui invece sono gli ingredienti che le passi); e il risultato lo consegna
indietro con return.

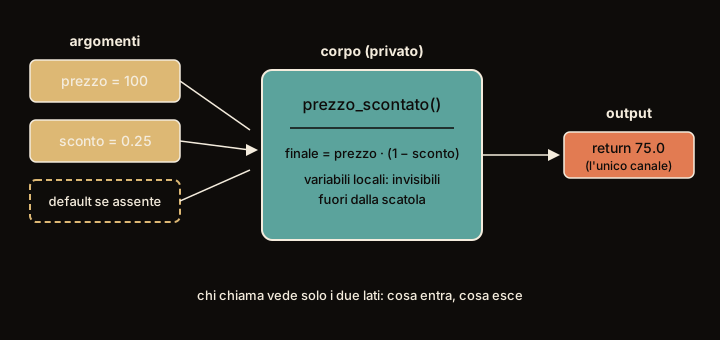
Fig. 2.7 La funzione come scatola. Chi la usa deve conoscere solo i due lati, cosa darle e cosa ne ottiene; il corpo può cambiare senza che nessuno se ne accorga.#
La linea che in Fig. 2.7 separa il dentro dal fuori è l’interfaccia della funzione, e il principio vale in ogni linguaggio: finché i due lati restano gli stessi, il corpo si può riscrivere, ottimizzare o correggere senza toccare una riga del codice che la chiama.
def area_rettangolo(base, altezza):
    return base * altezza

def saluta(nome, saluto="Ciao"):   # 'saluto' ha un valore di default
    return f"{saluto}, {nome}!"

area_rettangolo(3, 4)     # -> 12
saluta("Ada")             # -> "Ciao, Ada!"
saluta("Ada", "Salve")    # -> "Salve, Ada!"
return restituisce il valore a chi ha scritto la chiamata: l’espressione
area_rettangolo(3, 4) vale 12, e si può usare come qualunque altro valore,
dandole un nome, sommandola, passandola a un’altra funzione, stampandola.
risultato = area_rettangolo(3, 4)   # il 12 va a finire in 'risultato'
print(risultato)                    # -> 12
print(area_rettangolo(3, 4) + 8)    # -> 20  (il 12 è lì, e ci si somma 8)
Ed è anche il motivo per cui return e print non sono la stessa cosa, benché
nell’interprete si somiglino: print scrive sullo schermo e non consegna
niente a nessuno, return consegna un valore al programma e non scrive niente.
Una funzione che stampasse invece di restituire sarebbe inutilizzabile dentro
un conto più grande.
Gli argomenti si possono anche passare con il loro nome davanti, e allora l’ordine non conta più:
saluta(saluto="Salve", nome="Ada") # -> "Salve, Ada!"
È una scrittura che vedrai molto spesso, perché rende leggibile chi chiama:
bins=20 dice cosa sono quei venti, mentre un 20 da solo lascia indovinare.
Una funzione lavora come una macchinetta: dentro metti gli ingredienti
(gli argomenti), esce un risultato. area_rettangolo prende base e altezza,
restituisce l’area.
Il valore di default è un ingrediente preimpostato: saluto="Ciao" significa
«se non mi dici come salutare, uso Ciao». Puoi chiamare saluta("Ada") e
lasciar decidere alla funzione, oppure passare il tuo saluto.
C’è però un punto in cui l’immagine della macchinetta inganna, ed è la mutabilità. Una macchinetta vera non tocca gli ingredienti che le hai dato; una funzione Python, se l’ingrediente è una lista, può modificartela per davvero, perché la lista che riceve è proprio la tua, senza copie di mezzo.
def aggiungi_zero(fila):
    fila.append(0)          # modifica la lista che ha ricevuto

def maiuscolo(parola):
    parola = parola.upper() # fabbrica una stringa nuova e attacca il nome a lei
    return parola

mia_lista = [1, 2]
aggiungi_zero(mia_lista)
mia_lista                   # -> [1, 2, 0]   la mia lista è cambiata

mia_parola = "ciao"
maiuscolo(mia_parola)       # -> 'CIAO'
mia_parola                  # -> 'ciao'      la mia stringa è intatta
La differenza sta in ciò che la funzione fa al valore: append cambia la
lista sul posto, mentre .upper() non può cambiare una stringa (nessuno può)
e quindi ne restituisce una nuova. Ecco perché la lista di fuori si trova
modificata e la stringa no. Quando una funzione ti cambia i dati sotto il naso
senza che tu l’abbia chiesto, la causa è quasi sempre un metodo che modifica
l’oggetto ricevuto invece di costruirne uno nuovo.
Lo stesso fenomeno ha un rovescio, e tocca proprio il valore preimpostato di
poco fa. Se quel valore è una lista, la lista viene fabbricata una volta
sola, quando Python legge la riga con def, e resta la stessa a ogni
chiamata: chi ci
aggiunge qualcosa se la ritrova già piena al giro dopo. Per questo un valore
preimpostato è quasi sempre un numero, una stringa, oppure None.
E un’ultima cosa, che capita il primo giorno: aggiungi_zero non ha return.
Una funzione senza return consegna comunque qualcosa, e quel qualcosa è
None. Se ne stampi il risultato vedi scritto None, ed è la funzione che
dice «da me non torna indietro niente».
Nella definizione def saluta(nome, saluto="Ciao"), nome e saluto sono i
parametri; nella chiamata saluta("Ada", "Salve"), "Ada" e "Salve"
sono gli argomenti. Python passa gli argomenti per assegnazione (call by
sharing): ogni parametro diventa un nuovo nome per lo stesso oggetto passato
da chi chiama, senza copiarlo. Ne seguono le due conseguenze del modello a
riferimenti: rilegare il parametro dentro la funzione (fila = fila + [0])
non tocca l’oggetto di chi chiama, mentre mutarlo (fila.append(0), e anche
fila += [0] su una lista) lo cambia per tutti i nomi che lo indicano. Non
c’è quindi né un passaggio «per valore» né uno «per riferimento» nel senso di
C++.
Gli argomenti si passano per posizione o per nome (keyword):
saluta(nome="Ada", saluto="Salve") è equivalente ma esplicito. Fra i
parametri posizionali, quelli con un default vengono dopo quelli
obbligatori (def g(a=1, b) è un errore di sintassi). Dopo un * nudo
cominciano invece i parametri keyword-only, che si passano solo per nome e
che possono essere obbligatori anche venendo dopo dei default: def f(a=1, *, b) è legale, e b va passato. È il motivo per cui tante firme di scikit-learn,
e quelle di PyTorch dove i parametri sono molti (Adam, DataLoader), hanno un
asterisco solitario in mezzo: costringere a scrivere il nome degli argomenti
rende leggibile il codice di chi chiama e permette di aggiungere parametri senza
rompere il codice altrui.
Una trappola classica: il valore di default è valutato una sola volta, alla
definizione. Non usare mai un oggetto mutabile come default (def f(x, acc=[]))
o l’acc sarà condiviso tra le chiamate. Le funzioni in Python sono
first-class: si assegnano a variabili, si passano ad altre funzioni, si
restituiscono. Senza return esplicito, una funzione restituisce None.
Per le funzioni usa-e-getta c’è una forma compatta, la lambda: una funzione anonima che sta su una riga e restituisce il valore dell’unica espressione che contiene.
# lambda x: x ** 2   fa lo stesso lavoro di   def quadrato(x): return x ** 2
# ma non si scrive «quadrato = lambda x: ...»: se le serve un nome, usa def.

# l'uso tipico: passarla a qualcosa che si aspetta una funzione
coppie = [("Grace", 45), ("Ada", 36), ("Alan", 41)]
sorted(coppie, key=lambda c: c[1])       # ordina per età
# -> [('Ada', 36), ('Alan', 41), ('Grace', 45)]
La regola pratica: va bene per un’espressione breve passata a sorted, map,
filter o alle API di scikit-learn e PyTorch che accettano callable. Se la
logica cresce oltre la riga, o se la funzione ha bisogno di un nome per essere
capita, usa def.
List comprehension: l’idioma pythonico#
Costruire una lista trasformandone un’altra è talmente comune che Python ha una sintassi dedicata. Il nome inglese, list comprehension, viene dalla matematica: un insieme si può definire per elencazione (0, 1, 4, 9, …) oppure per comprensione («i quadrati dei numeri da 0 a 9»), ed è esattamente ciò che fa questa scrittura. Il ciclo esplicito funziona, ma la comprehension dice la stessa cosa in una riga, e chi programma in Python la legge a colpo d’occhio:

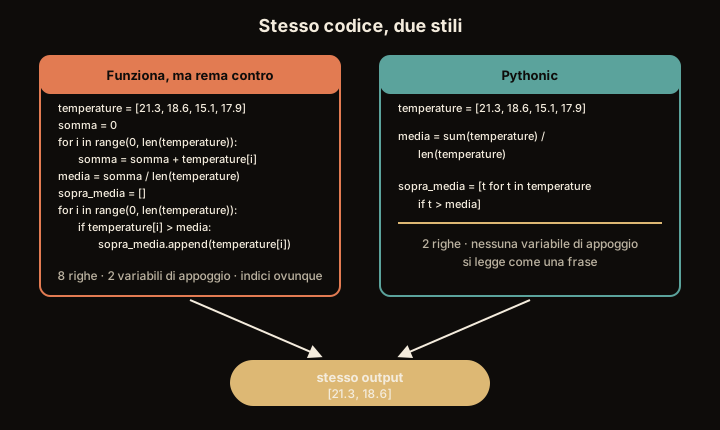
Fig. 2.8 Lo stesso risultato, due modi di dirlo. La versione di destra non è più corta per vezzo: nomina il risultato invece di descrivere la procedura per ottenerlo.#
Un codice si dice «pythonico» quando usa le forme che il linguaggio offre per quel compito invece di riprodurre a mano le procedure di altri linguaggi. La Fig. 2.8 ne mostra un caso: la comprehension si legge come una frase che descrive il risultato, e chi la scorre non deve simulare il ciclo per capire che cosa produrrà.
# la via lunga
quadrati = []
for n in range(10):        # range(10): i dieci numeri da 0 a 9
    quadrati.append(n ** 2)          # ** è l'elevamento a potenza

# la via pythonica: stesso risultato, una riga
quadrati = [n ** 2 for n in range(10)]

# con filtro: solo i numeri pari
pari = [n for n in range(10) if n % 2 == 0]    # -> [0, 2, 4, 6, 8]
Nell’ultima riga lavorano insieme due segni già incontrati: %, il resto
della divisione (7 % 2 fa 1), e ==, che chiede «sono uguali?» ed è doppio
proprio per non confondersi con l’uguale singolo, che invece assegna.
n % 2 == 0 significa quindi «il resto della divisione di n per due è zero»,
cioè «n è pari», e la riga intera si legge quasi in italiano: «n, per ogni
n da 0 a 9, se n è pari». La stessa forma esiste per i dizionari ({k: v for ...}) e per i set. Con le parentesi tonde (o senza, come unico argomento
di una funzione) si ottiene un’espressione generatrice: produce i valori uno
alla volta invece di costruire la lista, ed è la forma giusta quando il
risultato si consuma subito, come in sum(n ** 2 for n in range(10)). La
variabile del ciclo vive solo dentro la comprehension: fuori non esiste.
Quando il programma si rompe: il traceback, e il paracadute#
Prima o poi una riga va storta, e Python risponde con un traceback: la
ricostruzione dell’incidente, stampata un attimo prima di fermarsi. Salvato in
un file errore.py, questo programma chiede il voto di una persona che nel
registro non c’è:
voti = {"Ada": 30, "Bruno": 28}

def voto_di(nome):
    return voti[nome]

print(voto_di("Carla"))
Eseguito con python3 errore.py, si ferma così:
Traceback (most recent call last):
  File "/home/utente/errore.py", line 6, in <module>
    print(voto_di("Carla"))
          ^^^^^^^^^^^^^^^^
  File "/home/utente/errore.py", line 4, in voto_di
    return voti[nome]
           ~~~~^^^^^^
KeyError: 'Carla'
Un traceback si legge dal fondo. L’ultima riga dice che cosa è successo:
KeyError: 'Carla', cioè «ho cercato la chiave Carla e non c’era». Le righe
sopra dicono dove: ogni coppia «File, line» è una tappa del viaggio che il
programma stava facendo, dalla prima chiamata in cima fino alla riga incriminata
in fondo. Qui il viaggio ha due tappe: la riga 6 ha chiamato voto_di, e dentro
voto_di la riga 4 è quella che è caduta. Le tilde (~) e i cappucci (^)
sotto ciascuna riga, che compaiono da Python 3.11, indicano il pezzo esatto che
ha dato problemi, e in una riga lunga sono l’indicazione più utile che il
traceback contenga.
Davanti a un traceback si legge prima l’ultima riga, che dice che cosa è successo, e poi si risale per capire dove. È la prima cosa da imparare a leggere in Python, perché è un messaggio che si incontra fin dai primi programmi.
Un guasto di questo genere, in Python, si chiama eccezione, e si dice che viene sollevata: il programma smette di eseguire le righe, risale fino a qualcuno che sappia che farsene e, se non lo trova, si ferma stampando il traceback.
Si può fare di meglio che schiantarsi: mettere un paracadute attorno
alla riga che può cadere. Si scrive try: («prova»), e sotto, con except
(«se è andata male»), che cosa fare invece, nominando l’incidente che ci si
aspetta: except KeyError: si legge «se la chiave non c’era». Il paracadute si
mette attorno alla riga fragile, non attorno al programma intero, e si apre per
quell’incidente e per quello solo: un paracadute che copre tutto nasconde anche
gli errori che avresti voluto vedere.
Il paracadute, in codice, è il costrutto try/except, e la regola d’oro è
catturare poco:
si dichiara sempre quale eccezione si sta aspettando (
except KeyError:), perché unexcept:nudo prende qualunque cosa, compreso ilCtrl+Ccon cui vorresti fermare il programma, e trasforma ogni guasto in un silenzio;con
except KeyError as e:l’oggetto-eccezione finisce ine, e porta il messaggio;raisesenza argomenti, dentro unexcept, rilancia l’eccezione appena catturata: si usa quando si vuole registrare il guasto ma non nasconderlo;i rami facoltativi:
elseviene eseguito solo se iltrynon solleva eccezioni,finallyviene eseguito comunque, ed è il posto delle pulizie (chiudere un file, rilasciare una risorsa). Il mestiere difinallyè esattamente quello che il costruttowithautomatizza.
Lo stile che ne esce ha un nome, EAFP (easier to ask forgiveness than
permission): si prova e si gestisce il fallimento, invece di controllare
tutto prima (if nome in voti: ..., lo stile look before you leap). In
Python l’EAFP è idiomatico anche per una ragione pratica: fra il controllo e
l’uso il mondo può cambiare (un file cancellato, un altro thread che modifica
il dizionario), mentre il try è un gesto solo. Per il caso di una chiave che
può mancare esiste una scorciatoia, voti.get(nome), che restituisce None
(o il secondo argomento, voti.get(nome, 0)) invece di sollevare KeyError;
try serve quando la gestione non si riduce a un valore di ripiego.
Il paracadute, sul programma di prima:
voti = {"Ada": 30, "Bruno": 28}

def voto_di(nome):
    try:
        return voti[nome]
    except KeyError:
        return f"{nome} non è a verbale"

print(voto_di("Bruno"))
print(voto_di("Carla"))
28
Carla non è a verbale
Adesso la chiave mancante è un caso previsto dal programma, che risponde con un messaggio scelto da chi l’ha scritto invece di fermarsi.
Un assaggio di oggetti: le classi#
Il codice delle librerie si usa quasi sempre attraverso oggetti, e saperli leggere serve fin da subito. Un oggetto è una cosa che Python tiene in memoria e che porta con sé due cose insieme: dei dati, e le azioni che sa fare su quei dati (i metodi del punto, quelli che si scrivono dopo il punto). In Python tutto è un oggetto: numeri, stringhe, liste, perfino le funzioni. Quando ti servono oggetti su misura, definisci una classe, cioè un tipo nuovo: la classe dice quali dati (gli attributi) ha ogni oggetto di quel tipo e che cosa sa fare (i metodi).

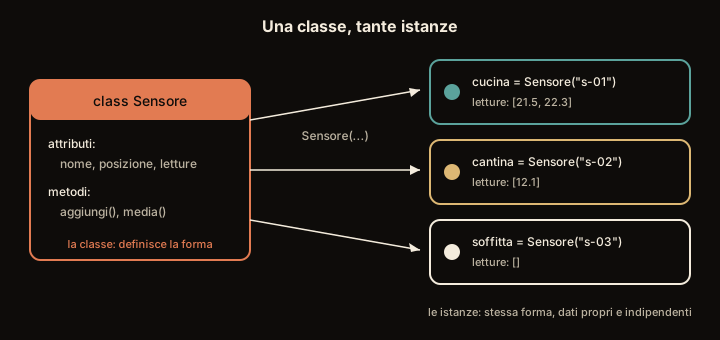
Fig. 2.9 Una classe e tre istanze. La classe dice quali dati esistono e cosa si può fare; ogni istanza porta i propri valori, mentre i metodi restano quelli della classe.#
Nella Fig. 2.9 la struttura sta nella classe e si scrive una volta; i valori stanno negli oggetti, uno per oggetto, e i metodi sono quelli della classe.
Ogni oggetto costruito da una classe è un’istanza di quella classe. La parola viene dall’inglese instance, «esemplare», e non ha niente a che vedere con l’istanza che si presenta a un ufficio: è quella che si trova in ogni documentazione.
class Punto:
    def __init__(self, x, y):    # il metodo che prepara un nuovo oggetto: si
        self.x = x               # chiama sempre così, con due trattini bassi
        self.y = y               # prima e due dopo. 'self' è l'oggetto stesso

    def distanza_origine(self):
        return (self.x ** 2 + self.y ** 2) ** 0.5   # ** 0.5 = radice quadrata

p = Punto(3, 4)
p.distanza_origine()     # -> 5.0   (il triangolo 3, 4, 5 di Pitagora)
Una classe è come uno stampo per biscotti: Punto è lo stampo, ogni p
che crei è un biscotto diverso fatto con lo stesso stampo. I metodi (come
distanza_origine) sono le cose che l’oggetto sa fare; gli attributi (x,
y) sono ciò che l’oggetto ricorda. La parola self è il modo in cui
l’oggetto parla di sé stesso.
Vale la fatica di prenderci la mano adesso, perché più avanti quasi tutto ha
questa forma. Un modello di scikit-learn è un oggetto a cui si dice .fit
(impara da questi dati) e poi .predict (adesso prevedi); una rete neurale in
PyTorch è una classe, con dentro i propri numeri e i propri metodi. Chi
riconosce lo stampo legge quel codice senza doverlo studiare.
__init__ è l’inizializzatore, che in pratica tutti chiamano costruttore:
Python lo esegue quando si scrive Punto(3, 4), su un oggetto che __new__,
il costruttore in senso stretto, ha appena creato (e che quasi mai si scrive).
self è il riferimento esplicito all’istanza, primo parametro di ogni metodo,
e gli attributi assegnati con self.x = x sono dati d’istanza.
L’ereditarietà specializza una classe riusando quella di partenza: la
derivata eredita attributi e metodi, può sostituirne alcuni e chiama
l’inizializzatore della base con super().
class Punto3D(Punto):
    def __init__(self, x, y, z):
        super().__init__(x, y)          # la parte che viene da Punto
        self.z = z

    def distanza_origine(self):         # sostituisce il metodo ereditato
        return (self.x ** 2 + self.y ** 2 + self.z ** 2) ** 0.5

Punto3D(1, 2, 2).distanza_origine()     # -> 3.0
isinstance(Punto3D(1, 2, 2), Punto)     # -> True
È la forma di ogni rete in PyTorch: class Rete(nn.Module) eredita da
nn.Module, e senza la riga super().__init__() assegnare uno strato a
self si ferma con AttributeError: cannot assign module before Module.__init__() call.
I decoratori: la @ che troverai ovunque#
Nel codice di PyTorch, e in quello di scikit-learn, si incontrano righe come
@torch.no_grad() sopra la definizione di una funzione. La sintassi compare
spesso e sembra magica solo finché non si guarda sotto.

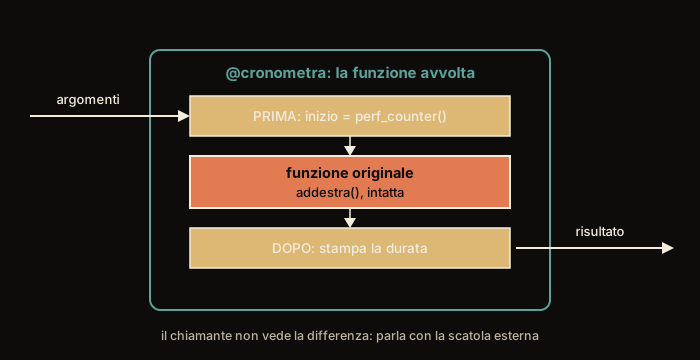
Fig. 2.10 Un decoratore è un involucro. La funzione originale resta intatta al centro: quello che cambia è che chi la chiama passa prima e dopo per il codice dell’involucro.#
In Fig. 2.10 la scatola grande è l’involucro e quella piccola al
centro è la funzione di partenza, che resta intatta. La @ è una scorciatoia
di scrittura, e vale «prendi questa funzione, passala a qualcosa, e tieni al
suo posto ciò che torna».
Al banco all’ingresso di un laboratorio c’è un custode con un cronometro. Chi vuole parlare con la ricercatrice della stanza in fondo passa di lì: il custode fa partire il cronometro, lo lascia entrare e all’uscita segna quanto è durata la visita. La ricercatrice lavora come sempre e del cronometro non sa niente. Un decoratore è quel custode, e la ricercatrice è la funzione che il decoratore avvolge.
Perché il custode si possa mettere al banco servono due fatti, che in Python valgono per tutte le funzioni. Il primo: il nome di una funzione è la targa sulla porta della stanza, e le parentesi sono il bussare. Una targa si stacca e si riappende altrove senza che la stanza cambi.
def buongiorno():
    return "Buongiorno!"

copia = buongiorno    # nessuna parentesi: non la chiamo, le do un secondo nome
copia()               # -> 'Buongiorno!'   chiamare 'copia' chiama 'buongiorno'
Il secondo: una funzione può costruire un’altra funzione e consegnarla, e quella nuova si ricorda con che cosa è stata costruita. Chiedine una tarata sul 3 e triplicherà tutto quello che le passa davanti, anche molto tempo dopo: il cinque che entra esce quindici.
def moltiplicatore(n):        # fabbrica funzioni, non numeri
    def moltiplica(x):
        return x * n          # 'n' è quello che c'era quando 'moltiplica' è nata
    return moltiplica         # niente parentesi: restituisce la funzione

triplica = moltiplicatore(3)  # ora 'triplica' è una funzione
triplica(5)                   # -> 15
Il custode col cronometro si costruisce allo stesso modo, solo che invece di un numero riceve la porta, cioè la funzione da sorvegliare.
import time

def cronometra(funzione):         # riceve una funzione...
    def involucro():              # ...e ne prepara una versione avvolta
        inizio = time.perf_counter()      # un cronometro molto preciso
        risultato = funzione()            # qui in mezzo gira l'originale
        print(f"ci ha messo {time.perf_counter() - inizio:.2f} secondi")
        return risultato
    return involucro              # restituisce l'involucro, non il risultato

@cronometra                       # equivale a: addestra = cronometra(addestra)
def addestra():
    time.sleep(0.3)               # facciamo finta di lavorare
    return "fatto"

addestra()        # stampa il tempo (circa 0.30 s), poi restituisce 'fatto'
Il custode, nel codice, si chiama involucro, e sta dentro cronometra perché
è lì che gli viene detta la porta: solo nascendo lì se la ricorda. E
cronometra finisce con return involucro, senza parentesi: consegna il
custode senza farci passare nessuno.
La riga @cronometra è il gesto di mettere il custode al banco, e vale
addestra = cronometra(addestra): da quel momento chi cerca addestra trova
il custode. Dietro c’è ancora la funzione di prima, che dorme i suoi tre decimi
di secondo e risponde "fatto", mentre sul foglio del custode finisce 0.30.
Questo custode, però, fa passare solo chi arriva a mani vuote: involucro non
prende argomenti, e se la funzione da avvolgere ne vuole il programma si ferma
prima ancora di cronometrare. Un custode che lascia passare chiunque accetta
tutto quello che il visitatore porta e lo consegna identico alla ricercatrice;
in Python quel «tutto» si scrive con gli asterischi, *args e **kwargs.
C’è anche un rovescio: da fuori, la stanza adesso porta la targa del custode.
Chi chiede il nome della funzione (addestra.__name__) si sente rispondere
involucro. È un fastidio piccolo finché il programma funziona, e diventa
grosso quando si va a cercare un guasto; per questo esiste una riga che ricopia
la targa vecchia sul custode.
@torch.no_grad() mette al banco un custode di un altro mestiere: per la
durata della visita tiene spento il calcolo dei gradienti, le quantità con
cui una rete neurale impara, e all’uscita lo rimette com’era. Serve quando la rete
deve solo rispondere e non più imparare.
Due dettagli separano un decoratore giocattolo da uno usabile:
accettare qualunque firma e non falsificare l’identità di ciò che si avvolge.
L’involucro sostituisce l’originale, quindi deve poter ricevere gli argomenti
che riceveva quella: *args raccoglie in una tupla tutti gli argomenti passati per
posizione, **kwargs in un dizionario tutti quelli passati per nome. E poiché
è l’involucro a prendere il posto dell’originale, __name__, __doc__ e la
firma diventano i suoi, con danni a help(), ai debugger e a qualunque codice
che faccia introspezione. Il rimedio è una riga, functools.wraps:
import functools
import time

def cronometra(funzione):
    @functools.wraps(funzione)             # ricopia nome, docstring, annotazioni
    def involucro(*args, **kwargs):        # accetta qualunque argomento...
        inizio = time.perf_counter()
        risultato = funzione(*args, **kwargs)   # ...e lo gira all'originale
        print(f"{funzione.__name__}: {time.perf_counter() - inizio:.3f}s")
        return risultato
    return involucro

@cronometra
def addestra(epoche, lr=0.1):
    time.sleep(0.05 * epoche)
    return "fatto"

addestra(2, lr=0.01)          # -> "fatto", preceduto dal tempo
addestra.__name__             # 'addestra', non 'involucro'
Le parentesi di @torch.no_grad(), però, hanno un’altra origine.
torch.no_grad è una classe, e non una funzione.
torch.no_grad() costruisce un oggetto, e quell’oggetto sa fare due mestieri
perché definisce sia __enter__/__exit__ (e allora sta dopo with) sia
__call__ (e allora sta dopo @). È per questo che le due forme sono la
stessa cosa, e infatti PyTorch accetta anche @torch.no_grad senza parentesi
(la classe base si chiama _NoParamDecoratorContextManager, cioè
«decoratore senza parametri»). I decoratori che i parametri li prendono davvero
(@functools.lru_cache(maxsize=128)) hanno invece un livello in più: sono
funzioni che restituiscono il decoratore, quindi parametri, funzione,
chiamata.
Il parente stretto è @property, che fa sembrare attributo il risultato di
un metodo. Serve quando un valore è derivato o va validato, ma si vuole
continuare a scrivere oggetto.valore invece di oggetto.get_valore():
import numpy as np

class Modello:
    def __init__(self, pesi):
        self._pesi = pesi

    @property
    def n_parametri(self):                 # si legge come attributo...
        return sum(p.size for p in self._pesi)

m = Modello([np.zeros((3, 4)), np.zeros(4)])
m.n_parametri                              # -> 16, e senza le parentesi
È il motivo per cui in scikit-learn e PyTorch alcune cose si leggono come dati e altre si chiamano come metodi: la distinzione risponde a una scelta di interfaccia, e dice se quel valore è un dato o un lavoro.
with: lo stesso gesto su un blocco#
C’è un secondo modo di dire «per la durata di questo blocco, cambia qualcosa e
poi rimetti a posto», ed è la parola chiave with. L’esempio classico è
leggere un file dal disco: open lo apre e restituisce un oggetto da cui il
testo si tira fuori con f.read(), e un file aperto va sempre richiuso,
altrimenti resta occupato.
with open("dati.csv") as f:      # il file si apre...
    testo = f.read()
                                 # ...e si chiude da solo, anche in caso di errore
Nella prima riga la parolina as significa «e chiamalo»: open consegna
l’oggetto che rappresenta il file aperto, e as f gli dà il nome f, che
useremo dentro il blocco. Il nome lo scegli tu, f è solo l’abitudine.
L’oggetto usato con with si chiama context manager («gestore di
contesto»): definisce cosa fare all’ingresso e cosa all’uscita del blocco. Il
valore sta tutto nella seconda metà, cioè nel rimettere a posto: chiudere il
file, liberare la memoria, riaccendere ciò che si era spento. E avviene
comunque, anche quando il programma, dentro il blocco, incontra un guasto e
solleva un’eccezione. Chiudere un file a mano è facile da dimenticare; con
with non serve ricordarsene.
In PyTorch lo incontrerai soprattutto così:
with torch.no_grad():            # dentro il blocco niente gradienti
    previsioni = modello(x)
ed è la stessa identica cosa del decoratore @torch.no_grad(): la differenza è
solo l’ambito, perché il decoratore avvolge un’intera funzione e with avvolge
un blocco. Molte API offrono entrambe le forme proprio per questo.
Un lavoratore alla volta: il GIL#
Un computer di oggi ha quattro, otto, sedici nuclei di calcolo, cioè altrettanti conti che possono davvero avvenire nello stesso istante, e viene naturale pensare che per andare più in fretta basti dividere il lavoro fra loro. Con i thread di Python, però, il calcolo scritto in Python non si divide così, e la ragione ha tre lettere.
Le tre lettere sono GIL, global interpreter lock: «il lucchetto dell’interprete». Una cucina professionale con un solo coltello.
Puoi assumere quattro cuochi, ma il coltello è uno: mentre uno taglia, gli altri tre stanno fermi. Assumerne altri non fa uscire i piatti più in fretta, perché il coltello va passato di mano e quel passaggio si mangia il poco che si guadagna.
E il coltello è uno per una ragione precisa: la cucina tiene un registro solo di che cosa è ancora in uso e che cosa si può sparecchiare, e due mani che lo aggiornassero insieme lo rovinerebbero.
I cuochi, in un programma, si chiamano thread: sono le linee di lavoro che procedono insieme dentro lo stesso programma, e condividono tutto, come quattro cuochi nella stessa cucina. Il coltello è il permesso di eseguire istruzioni Python, e ce n’è uno solo: un thread alla volta. Da cui la regola pratica, che è tutto ciò che serve ricordare:
se il lavoro è aspettare (scaricare pagine, leggere file, interrogare un database), i thread aiutano eccome: mentre uno aspetta posa il coltello, e gli altri lavorano;
se il lavoro è calcolare, i thread non servono a niente. Per usare davvero più nuclei bisogna avviare processi separati, che sono cucine diverse, ciascuna con il suo coltello.
I processi hanno un prezzo: non condividono la memoria, quindi tutto ciò che si scambiano va impacchettato, spedito e riaperto dall’altra parte. Per questo si avviano una volta sola e si tengono, invece di crearne uno per ogni pezzetto di lavoro.
E c’è un’ultima cosa, che è il motivo per cui in pratica il problema si sente molto meno di quanto la cucina con un coltello solo faccia temere: quando il conto vero avviene dentro NumPy o PyTorch, quelle librerie posano il coltello prima di mettersi a calcolare, perché il calcolo lo fanno in C e non hanno bisogno dell’interprete. Nel codice che addestra modelli e macina numeri, insomma, il lucchetto è aperto quasi sempre.
Il Global Interpreter Lock è un mutex nell’implementazione di riferimento
di Python (CPython) che protegge lo stato interno dell’interprete, in
particolare il conteggio dei riferimenti con cui ogni oggetto tiene traccia
di quanti riferimenti lo puntano (un nome, un posto in una lista, un
attributo). È il meccanismo primario con cui CPython libera la memoria; il gc
vero e proprio gli sta sopra e serve a raccogliere i cicli.
La sua conseguenza è netta: un solo thread per interprete esegue bytecode
Python in un dato istante. Resta una scelta di implementazione e non una
proprietà del linguaggio, tanto che Jython e IronPython il GIL non ce l’hanno;
ma è la scelta dell’interprete che tutti usano.
Le tre vie alla concorrenza in Python vanno quindi tenute distinte, perché risolvono problemi diversi:
threading: thread veri del sistema operativo, memoria condivisa, serializzati dal GIL sul bytecode. Il GIL viene però rilasciato durante le operazioni di I/O bloccanti e dentro le estensioni C che lo dichiarano. Utile per lavoro I/O-bound, inutile per quello CPU-bound.multiprocessing: processi separati, ciascuno con il proprio interprete e il proprio GIL, quindi parallelismo reale sui nuclei. Il costo è che la memoria non è condivisa: gli argomenti e i risultati attraversano una serializzazione (pickle), che per tensori grandi può dominare il guadagno.asyncio: un solo thread, multitasking cooperativo su un ciclo di eventi. Unawaitcede il controllo esplicitamente. Nessun parallelismo di calcolo, ma scala a decine di migliaia di attese contemporanee senza il costo di altrettanti thread. È il modello dei server, ed è quello dei client verso le API dei modelli, dove il tempo se ne va aspettando la rete.
La ragione per cui il GIL, in pratica, morde meno di quanto sembri: NumPy e
PyTorch lo rilasciano durante le operazioni pesanti, che girano in codice C o in
routine di calcolo compilate apposta per il processore (BLAS) o per la scheda
grafica (CUDA), già multi-thread al loro interno. Anche quelle si chiamano
kernel, ed è la stessa parola con un mestiere diverso da quello del processo
che tiene vivo un notebook. Una moltiplicazione fra matrici usa tutti i nuclei
anche da un solo thread Python. Il GIL torna a mordere sul codice Python puro: i
cicli sui campioni, le trasformazioni scritte in Python, il preprocessing. È
lì che il DataLoader di PyTorch avvia processi con num_workers, ed è la
stessa ragione per cui DataParallel, che pilota più GPU da un solo processo, è
sconsigliato in favore di DistributedDataParallel, che ne usa uno per GPU.
Il GIL non è per sempre
Con la PEP 703 il GIL sta diventando opzionale. CPython 3.13 ha introdotto
una build sperimentale senza GIL (free-threading); con la PEP 779
quella build passa da sperimentale a ufficialmente supportata in CPython 3.14,
pur non essendo ancora quella predefinita. Resta un costo sul codice a thread
singolo, che la documentazione di CPython 3.14 dà «attorno al 5-10%, a seconda
della piattaforma e del compilatore C» (la PEP 779, scritta prima, riportava
circa il 10%, e circa il 3% su macOS). Nel 3.13 era circa il 40% sulla suite
pyperformance, e il salto viene soprattutto dall’interprete adattivo della PEP
659, che nella build senza GIL adesso è acceso e in quella del 3.13 non lo
era. Farne il default è una terza fase annunciata ma non ancora datata. Esiste
anche, da Python 3.14, una quarta via per usare più nuclei senza processi: i
sub-interpreti (concurrent.interpreters, PEP 734), ciascuno con il proprio
GIL dentro lo stesso processo; concurrent.futures.InterpreterPoolExecutor li
usa come un pool di thread, con un costo di avvio e di memoria ancora alto e
pochi oggetti condivisibili. È materia in movimento: quel che
resta vero, e che conviene ricordare, è la distinzione fra lavoro che
aspetta e lavoro che calcola, e il fatto che condividere memoria e condividere
nuclei sono due problemi diversi.
Che i thread non aiutino a calcolare, e aiutino invece ad aspettare, si può vedere con una misura da fare una volta con le proprie mani. Il programma che segue prova cinque casi: lo stesso calcolo fatto in sequenza e con quattro thread, la stessa attesa fatta in sequenza e con quattro thread, e il calcolo diviso fra quattro processi. Dei primi quattro stampa due tempi, perché i tempi da guardare sono due; del quinto soltanto il primo, perché il tempo di CPU dei processi avviati (i figli) il programma che li avvia (il padre) non lo vede. Il tempo di parete è quello dell’orologio appeso al muro, cioè quanto si è aspettato; il tempo di CPU è quanto lavoro ha fatto davvero il processore, sommato su tutti i lavoratori. È la differenza fra «quanto ci ha messo» e «quanta fatica ha fatto», e servono tutte e due per distinguere un thread che lavora da uno che aspetta.
import multiprocessing as mp
import sys
import time
from concurrent.futures import ThreadPoolExecutor   # un gruppo di thread

def calcola(n):
    """Lavoro puro di CPU: nessun file, nessuna rete, solo somme."""
    return sum(i * i for i in range(n))

def aspetta(secondi):
    """Lavoro puro di attesa: il processore non fa niente."""
    time.sleep(secondi)

def durata(funzione, lavori, thread=1):
    """Esegue i lavori e restituisce (tempo di parete, tempo di CPU)."""
    t0, c0 = time.perf_counter(), time.process_time()
    if thread == 1:
        [funzione(x) for x in lavori]
    else:
        with ThreadPoolExecutor(thread) as ex:
            list(ex.map(funzione, lavori))
    return time.perf_counter() - t0, time.process_time() - c0

# Il trattino basso dentro un numero è solo un separatore per l'occhio:
# 2_000_000 è due milioni, e Python lo legge come se non ci fosse.
# La lista per un numero, invece, la ripete: [x] * 4 fa una lista di quattro x.
CPU = [2_000_000] * 4        # quattro lavori di calcolo identici
ATTESE = [0.25] * 4          # quattro attese da un quarto di secondo

for etichetta, funzione, lavori, thread in [
    ("CPU, in sequenza    ", calcola, CPU, 1),
    ("CPU, con 4 thread   ", calcola, CPU, 4),
    ("attesa, in sequenza ", aspetta, ATTESE, 1),
    ("attesa, con 4 thread", aspetta, ATTESE, 4),
]:
    parete, cpu = durata(funzione, lavori, thread)
    print(f"{etichetta}: parete {parete:.2f} s | CPU {cpu:.2f} s")

# I processi hanno ciascuno il proprio interprete, quindi il proprio GIL.
def lavoratore(n, coda):
    coda.put(calcola(n))

t0 = time.perf_counter()
# Su macOS e Windows il metodo predefinito è "spawn" (su Linux era "fork" fino
# a Python 3.13, e da 3.14 è "forkserver"): il figlio non eredita la memoria del
# padre, reimporta il modulo, e quindi la funzione dev'essere definita in un
# modulo importabile e il codice che avvia i processi va protetto da
# `if __name__ == "__main__":`. Senza quella riga il figlio riesegue anche
# l'avvio, e i processi si moltiplicano finché la macchina non cede.
# Così com'è, con "fork" chiesto esplicitamente, questo blocco gira su Linux e
# su Colab.
ctx = mp.get_context("fork")
coda = ctx.Queue()
processi = [ctx.Process(target=lavoratore, args=(n, coda)) for n in CPU]
for p in processi:
    p.start()
# il trattino basso da solo è un nome come un altro, e per convenzione dice
# «questo valore non mi serve»: qui conta solo quante volte girare
risultati = [coda.get() for _ in CPU]   # svuotare la coda PRIMA del join
for p in processi:
    p.join()
print(f"CPU, con 4 processi : parete {time.perf_counter() - t0:.2f} s")

if hasattr(sys, "_is_gil_enabled"):     # la domanda esiste da Python 3.13
    print("GIL attivo:", sys._is_gil_enabled())
Su una macchina Linux a quattro nuclei che non stia facendo altro, con CPython
3.12 (da 3.13 esiste sys._is_gil_enabled, e le ultime due righe del
programma stampano anche GIL attivo: True), esce qualcosa del genere:
CPU, in sequenza    : parete 0.26 s | CPU 0.26 s
CPU, con 4 thread   : parete 0.31 s | CPU 0.29 s
attesa, in sequenza : parete 1.00 s | CPU 0.00 s
attesa, con 4 thread: parete 0.25 s | CPU 0.00 s
CPU, con 4 processi : parete 0.12 s
I numeri assoluti dipendono dalla macchina, ma la grandezza da guardare è sempre la stessa: il tempo di parete con quattro thread confrontato con quello in sequenza. Sul lavoro di calcolo non scende: resta lì dov’era, e da un’esecuzione all’altra oscilla di qualche centesimo in su o in giù, perché passarsi il turno ha un costo dello stesso ordine del rumore della misura. I quattro thread non stanno lavorando in quattro, si stanno alternando, ed è esattamente ciò che significa GIL. Sull’attesa scende invece a un quarto, da un secondo tondo a 0,25, perché lì il lucchetto è posato e nessuno si ostacola. Con i processi accelera anche il calcolo, quanto lo permettono i nuclei disponibili. Tre confronti, e la regola resta in mente.
L’esperimento vale solo su una macchina scarica, e prima di cominciare
conviene guardare il carico (uptime, oppure os.getloadavg() in Python su
Linux e macOS), che deve stare ben sotto il numero dei nuclei. La prima riga
dell’uscita aiuta a sospettarlo: se il tempo di parete supera di molto quello
di CPU (qui sono uguali, 0,26 e 0,26), il programma ha passato parte del tempo
in coda dietro a qualcun altro. Non basta a escluderlo, però: un thread solo
su quattro nuclei risente poco del carico, mentre l’ultima riga, quella dei
processi, ne risente subito. Con la macchina carica, le altre righe
dell’uscita non parlano più del GIL.
Sotto carico pesante può perfino capitare il risultato opposto, i quattro thread che finiscono prima di quello solo: non lavorano in parallelo (il tempo di CPU resta identico), ma con quattro candidati pronti in coda capita più spesso che almeno uno di loro abbia il turno. È un effetto instabile, e un motivo in più per misurare a macchina scarica.
Il tempo di CPU stampato accanto serve a distinguere le due situazioni in
cui la parete non scende, e va letto con una cautela: process_time()
somma il lavoro di tutti i thread, quindi resta all’incirca uguale sia quando
i thread si alternano sia quando lavorano davvero insieme, e da solo non
dimostra nulla. Quello che dice è un’altra cosa, utile: quando la parete non
scende, una CPU alta vuol dire che si sta calcolando a turno, ed è il caso del
GIL; una CPU quasi a zero, che si sta soltanto aspettando.
Da ricordare
Il tipo di un valore lo decide il valore, non tu: si assegna con
=e si va avanti. I mattoni sono i numeri interi (int), quelli con la virgola (float), il testo (str) e il vero-o-falso (bool).Quattro contenitori coprono quasi tutto: list (fila ordinata, si modifica), tuple (fila fissa), dict (si cerca per nome, cioè per chiave), set (senza doppioni). Nel dizionario il valore si trova in un colpo, qualunque sia la sua taglia; in una lista bisogna scorrerla tutta.
Alcuni valori si cambiano sul posto e altri no: una lista sì, una stringa e una tupla no. Da qui vengono quasi tutte le sorprese dei primi giorni: due nomi possono stare sulla stessa lista, e una funzione può modificarti la lista che le passi. Se vuoi una lista a parte, la copia si chiede (
a.copy()).I blocchi si delimitano rientrando le righe:
if/elif/elseper decidere,forewhileper ripetere.printè ciò che fa uscire un valore sullo schermo: senza, il programma calcola e tace.Una funzione (
def…return) è un pezzo di lavoro con un nome, da riusare; una list comprehension costruisce una lista in una riga; una classe è uno stampo per fabbricare oggetti su misura, ciascuno con i propri dati e le proprie azioni.Le f-string (
f"{nome} ha {eta} anni") infilano valori dentro il testo, e dopo i due punti si dice che aspetto devono avere:f"{loss:.3f}"sono tre cifre dopo la virgola.Un traceback si legge dal fondo: l’ultima riga dice che cosa è successo, risalendo si scopre dove. E il paracadute (
try/except) si mette attorno alla riga fragile, non attorno a tutto il programma.Un decoratore (
@qualcosa) avvolge una funzione senza toccarla:@cronometraè solof = cronometra(f).withfa la stessa cosa su un blocco, e garantisce che alla fine si rimetta tutto a posto anche se qualcosa va storto.Il GIL lascia eseguire istruzioni Python a un thread alla volta: i thread aiutano quando il lavoro è aspettare (rete, disco), non quando è calcolare. Per usare più nuclei servono processi, cucine separate che però non condividono niente e devono impacchettare e spedirsi tutto quello che si scambiano. NumPy e PyTorch, mentre fanno i conti pesanti, posano il coltello: è per questo che in pratica il problema morde molto meno di quanto sembri.
Da ricordare
Python è dinamicamente tipizzato: assegni un valore e il tipo si deduce da solo. I mattoni sono
int,float,str,bool.Quattro strutture dati coprono quasi tutto: list (ordinata, modificabile), tuple (immutabile), dict (chiave → valore, accesso in media \(O(1)\) contro l’\(O(n)\) della ricerca in lista), set (senza duplicati). Chiavi e elementi devono essere hashable.
La mutabilità decide più di quanto sembri:
b = adà un secondo nome allo stesso oggetto (per copiare,a.copy()ocopy.deepcopy); il default di una funzione è valutato una sola volta, quindi mai un oggetto mutabile comeacc=[]; eischiede «stesso oggetto?» mentre==chiede «stesso valore?», conif x is Nonecome unico uso diisda tenere a memoria.I blocchi sono definiti dall’indentazione;
if/elif/else,forewhilebastano per il controllo di flusso.Le funzioni (
def…return) e le list comprehension rendono il codice conciso; le classi modellano oggetti su misura: la stessa forma di scikit-learn e PyTorch.Le f-string (
f"{nome} ha {eta} anni") inseriscono valori nel testo, con il formato dopo i due punti:f"{loss:.3f}".Le eccezioni si gestiscono con
try/exceptstretto (maiexcept:nudo),else/finallyper il seguito e le pulizie,raiseper rilanciare: è lo stile EAFP, e il traceback si legge dall’ultima riga risalendo la pila delle chiamate.Un decoratore (
@qualcosa) avvolge una funzione senza modificarla:@cronometraè solof = cronometra(f).withfa la stessa cosa su un blocco invece che su una funzione, e garantisce la pulizia anche in caso di errore.Il GIL lascia eseguire codice Python a un thread alla volta: i thread aiutano quando il lavoro è aspettare (rete, disco), non quando è calcolare. Per usare più nuclei servono processi, che però non condividono la memoria e devono serializzare ciò che si scambiano;
asyncioè la terza via, un solo thread che gestisce molte attese. NumPy e PyTorch rilasciano il GIL durante i conti pesanti, ed è per questo che in pratica morde molto meno di quanto sembri.
Con questi mattoni un programma che fa qualcosa si scrive già. Quello che ancora manca è la scala: finché i dati sono cinque numeri in una lista il ciclo scritto a mano va benissimo, ma appena diventano un milione smette di bastare, e serve un contenitore costruito apposta per tenerli in fila e farci i conti sopra tutti insieme.