


Modelli di sequenza: da RNN ai Transformer#
«Il gatto nero salta sul muro, e dopo un attimo lo scavalca.» Leggila da sinistra a destra, una parola alla volta: quando arrivi a «lo», sai già che cosa viene scavalcato, perché hai tenuto in memoria ciò che è venuto prima. Il linguaggio funziona così: ogni parola prende senso dal contesto, e in buona parte da quelle che la precedono. «Il gatto nero salta sul muro» non è un sacchetto di parole mescolabili a piacere: l’ordine fa parte del significato.
Le reti viste finora non sanno farlo. Una rete feed-forward, come il percettrone multistrato o la rete convoluzionale, calcola l’uscita dal solo ingresso che ha davanti: l’ingresso ha una dimensione fissa, e da un esempio al successivo non resta niente. I classificatori della sezione sulla classificazione aggiravano il limite riducendo la frase a un vettore di lunghezza fissa, il sacchetto di parole o la media degli embedding, e così ne perdevano l’ordine. Gli n-gram l’ordine lo tengono, ma solo per le ultime \(n-1\) parole, e trattano ogni parola come un simbolo isolato: per loro «gatto» e «micio» restano due estranei.
Un modello che vuole capire o generare testo deve invece fare due cose in più: accettare una sequenza di lunghezza qualsiasi (le frasi non hanno tutte lo stesso numero di parole) e portarsi dietro, parola dopo parola, un riassunto di quello che ha già letto. Tra gli anni Ottanta e il 2017 la risposta sono state le reti ricorrenti. Sanno fare la stessa scommessa degli n-gram sulla parola successiva, ma con un contesto che non si tronca a una distanza fissa; e siccome le parole vi entrano come embedding, due parole vicine nel significato, come «gatto» e «micio», arrivano alla rete come vettori vicini e tendono a lasciarle riassunti vicini. Poi è venuta l’architettura dei Transformer, su cui oggi si costruiscono i grandi modelli linguistici e a cui è dedicato il capitolo che segue.
Le reti ricorrenti: una memoria che scorre nel tempo#
Una rete neurale ricorrente (RNN, recurrent neural network) legge la frase una parola alla volta e a ogni passo \(t\) aggiorna un vettore di lunghezza fissa, lo stato nascosto \(\mathbf{h}_t\). Il nuovo stato si calcola da due soli elementi: la parola corrente, già trasformata nel suo embedding \(\mathbf{x}_t\), e lo stato del passo precedente \(\mathbf{h}_{t-1}\), che all’inizio della sequenza è \(\mathbf{h}_0\), di solito un vettore di zeri. Così \(\mathbf{h}_t\) riassume tutto ciò che la rete ha letto fino a quel momento, senza limiti fissi alla lunghezza del contesto. Si dice nascosto perché resta dentro la rete: la risposta \(\hat{\mathbf{y}}_t\) se ne ricava a parte.
La funzione che calcola \(\mathbf{h}_t\) da \(\mathbf{x}_t\) e da \(\mathbf{h}_{t-1}\) si chiama cella, e i suoi pesi sono gli stessi a ogni passo. Per vederlo si «srotola» la rete nel tempo, come in Fig. 15.15: una copia della cella per ogni passo, ciascuna collegata alla successiva dallo stato. Le copie sono un modo di disegnare il calcolo, non reti diverse: la cella è una sola, con gli stessi pesi al passo 3 e al passo tremila. Ecco perché una rete ricorrente resta piccola anche su testi lunghissimi: allungare il testo allunga il disegno, non la rete.

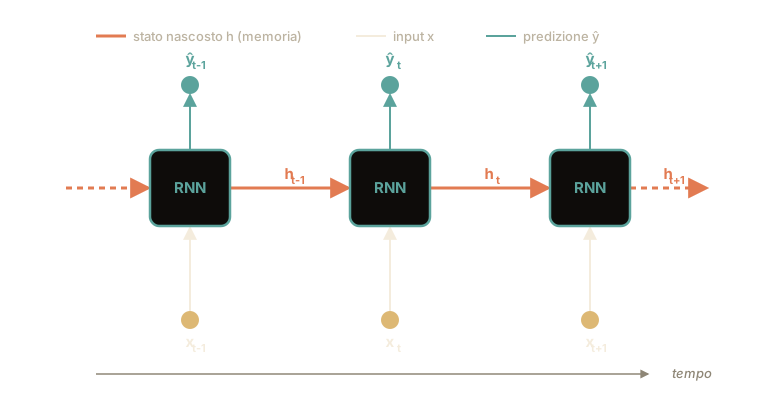
Fig. 15.15 Una RNN srotolata nel tempo: la stessa cella, con gli stessi pesi, ai passi \(t-1\), \(t\) e \(t+1\). A ogni passo riceve l’ingresso \(\mathbf{x}_t\) e lo stato \(\mathbf{h}_{t-1}\), e produce il nuovo stato \(\mathbf{h}_t\) e la previsione \(\hat{\mathbf{y}}_t\), che secondo il compito è la parola successiva o l’etichetta della parola corrente. Le tre copie sono tre istanti, non tre reti.#
Un foglietto accanto al libro, su cui scrivi riga dopo riga un riassunto di ciò che è successo finora. Per ogni nuova frase fai sempre lo stesso gesto: guardi la frase, guardi il foglietto, e riscrivi il foglietto aggiornato. Il foglietto è lo stato nascosto; il gesto che ripeti è la cella della RNN. È «la stessa mano» che lavora a ogni riga, per questo la rete ha bisogno di pochi parametri anche per testi lunghissimi: non impara un gesto diverso per ogni parola, ne impara uno solo e lo riusa.
Quello che consegni però è un’altra cosa. A ogni riga, appena hai aggiornato il foglietto, ci butti sopra un occhio e dici la tua, quale parola verrà o di che cosa parla la frase. Quella è la risposta, e la ricavi dal foglietto con un secondo gesto, più corto del primo. Il foglietto resta un appunto privato.
E la mano come impara a fare meglio? Ogni tanto ti fermi, confronti le risposte che hai dato con quello che il libro diceva davvero, e ripercorri le righe all’indietro per capire in quale punto il gesto ti ha portato fuori strada. Ripercorrerle tutte vorrebbe dire tenere mille righe sotto gli occhi insieme, e sul tavolo non ci stanno. Allora si lavora a blocchi, per esempio di trenta righe. Correggi la mano guardando quelle trenta, poi riparti dal foglietto così com’è, senza più tornare su come ci sei arrivato.
Il prezzo di questa scorciatoia è chiaro, ed è meglio saperlo. Il foglietto non viene azzerato al confine fra un blocco e il successivo: passa di là com’è, e in avanti la lettura non si interrompe mai. A fermarsi al confine è la correzione. Così la mano non impara mai a legare una cosa di riga cinque con una di riga sessanta, perché quando c’è da correggere quel legame riga cinque non è più sul tavolo.
A ogni passo temporale \(t\) la cella combina l’input corrente \(\mathbf{x}_t\) con lo stato precedente \(\mathbf{h}_{t-1}\) tramite una trasformazione lineare seguita da una non linearità. È lo schema che Jeffrey Elman descrive nel 1990 [Elm90], e che da allora si chiama rete ricorrente semplice, scritto nella forma di oggi:
Qui \(\mathbf{h}_t \in \mathbb{R}^d\) è lo stato nascosto, con \(d\) scelto da chi costruisce la rete, \(\mathbf{x}_t\) è l’input al passo \(t\) e \(\hat{\mathbf{y}}_t\) la distribuzione sul vocabolario, mentre \(\mathbf{W}_{hh}, \mathbf{W}_{xh}, \mathbf{W}_{hy}\) sono matrici di pesi e \(\mathbf{b}_h, \mathbf{b}_y\) i bias. Il punto cruciale è che queste matrici non dipendono da \(t\): sono condivise su tutta la sequenza (weight sharing). L’addestramento avviene con la backpropagation through time, cioè la retropropagazione applicata alla rete srotolata.
Usata come modello di linguaggio sulla frase \(w_1, \dots, w_n\), la rete riceve
come \(\mathbf{x}_t\) l’embedding di \(w_t\), e \(\hat{\mathbf{y}}_t\) stima
\(P(w_{t+1} \mid w_1, \dots, w_t)\): la scommessa degli n-gram, con un contesto
che non si tronca. Si addestra minimizzando la cross-entropia media sulla
parola successiva,
\(\mathcal{L} = -\frac{1}{n-1}\sum_{t=1}^{n-1} \log \hat{y}_{t,\,w_{t+1}}\),
dove \(\hat{y}_{t,\,w}\) è la componente di \(\hat{\mathbf{y}}_t\) relativa alla
parola \(w\). La perplessità della sezione sugli n-gram è
\(e^{\mathcal{L}}\) con il logaritmo naturale, che è quello delle librerie, e
coincide con il \(2^{H}\) calcolato in bit sullo stesso testo. Senza la softmax
quello che esce sono i logit, i punteggi grezzi: è la forma che
nn.CrossEntropyLoss vuole in ingresso, perché softmax e logaritmo li calcola
da sé, ed è per questo che in PyTorch l’ultimo strato di un classificatore si
ferma un passo prima e la softmax non si scrive.
Srotolare, però, ha un costo: la rete srotolata su una sequenza di mille passi
è una rete profonda mille strati, e per retropropagare bisogna tenere in
memoria tutte le attivazioni intermedie. Su un testo lungo, o su un flusso che
non finisce mai, la cosa non sta in piedi. Il rimedio si chiama BPTT
troncato: si spezza la sequenza in blocchi di lunghezza fissa (tipicamente
qualche decina di passi), si retropropaga dentro un blocco e si stacca lo
stato nascosto al confine, passandolo al blocco successivo come un valore
qualunque, senza la sua storia. In PyTorch è letteralmente una chiamata,
h = h.detach(), e per la LSTM, il cui stato è una coppia, la stessa cosa
scritta su tutti e due i pezzi: h = tuple(s.detach() for s in h).
Il prezzo è noto: il gradiente non attraversa mai il confine, quindi la rete non può imparare dipendenze più lunghe del blocco. Lo stato in avanti continua a propagarsi e a portare informazione; a fermarsi è il segnale di apprendimento. Quando si legge che una ricorrente fatica sulle dipendenze lunghe, la ragione è duplice: da una parte la matematica del gradiente che svanisce, dall’altra questa scelta di ingegneria necessaria per far entrare l’addestramento in memoria.
Dipendenze a lungo termine: il gradiente che svanisce#
Sulla carta una RNN può collegare la prima parola all’ultima; in pratica impara a farlo male. Nella frase «Le chiavi che ho lasciato ieri sul tavolo della cucina di mia nonna… sono sparite» il verbo si accorda con «chiavi», e fra le due ci sono undici parole. Una rete ricorrente può rappresentare queste dipendenze a lungo termine; il difficile è insegnargliele. Perché l’errore sul verbo corregga il modo in cui la rete ha trattato «chiavi», il gradiente (il segnale di correzione che risale all’indietro) deve ripercorrere una dozzina di passi, e a ogni passo viene moltiplicato per la jacobiana della cella, la matrice delle derivate dello stato nuovo rispetto al vecchio. Se quei fattori lo rimpiccioliscono, il segnale decade in modo esponenziale con la distanza, e si dice che il gradiente svanisce; se lo ingrandiscono, può crescere allo stesso modo, ed esplode.
Torniamo al foglietto dei riassunti. A ogni riga lo riscrivi, e ogni riscrittura riduce un pochino i dettagli vecchi per far posto a quelli nuovi. Dopo cento riscritture, di cosa succedeva a pagina uno non resta quasi nulla. Una mano che ricopiasse i dettagli vecchi senza alterarli potrebbe conservarli: il guaio è insegnarle a farlo.
Alla correzione va anche peggio. La correzione è come una freccia: dice alla mano da che parte spostarsi, e di quanto. Per capire dove la mano ha sbagliato devi risalire le righe una per una, e a ogni riga la freccia ripassa per la stessa riscrittura che, nella lettura in avanti, aveva già smorzato i dettagli vecchi; si accorcia un pochino, poi ancora, poi ancora. Bastano poche decine di righe risalite e quando arriva in cima non sposta più niente. La mano si aggiusta benissimo su quello che è appena successo, mentre su quello che è lontano non riceve nessuna indicazione.
Le RNN soffrono esattamente di questo doppio smorzamento, dei dettagli mentre si legge in avanti e della correzione mentre si risale, e il modello finisce per «dimenticare» ciò di cui avrebbe ancora bisogno. È il problema delle dipendenze a lungo termine.
Ogni tanto capita il rovescio. Un gesto che a ogni riga allunga la freccia invece di accorciarla la fa crescere mentre risale, finché quello che arriva in cima è uno strattone che scompone la mano invece di aggiustarla. Che un gesto, preso da solo, sappia allungare è necessario ma non basta: un gesto può allungare la freccia in una direzione e il successivo accorciarla proprio in quella, e allora i due si compensano. Per sapere se lo strattone arriva bisogna seguirli nell’ordine in cui si susseguono. Per lo strattone il rimedio è semplice: se la freccia arriva più lunga di una misura fissata, la si accorcia a quella misura prima di usarla, senza cambiarne la direzione. Per lo smorzamento no: serve un foglio diverso.
Durante la backpropagation through time, il gradiente che risale da un passo lontano si ottiene moltiplicando molte matrici jacobiane in cascata. Il termine critico ha la forma
un prodotto di \(k\) fattori, e l’ordine conta perché le jacobiane non commutano.
Per la rete di Elman ciascun fattore si scrive per esteso,
\(\partial \mathbf{h}_s / \partial \mathbf{h}_{s-1} = \mathrm{diag}\big(1 - \mathbf{h}_s \odot \mathbf{h}_s\big)\,\mathbf{W}_{hh}\),
e poiché la derivata della \(\tanh\) non supera \(1\) vale
\(\big\|\partial \mathbf{h}_t / \partial \mathbf{h}_{t-k}\big\| \le \|\mathbf{W}_{hh}\|^{k}\),
con \(\|\cdot\|\) la norma spettrale: se il massimo valore singolare di
\(\mathbf{W}_{hh}\) è minore di \(1\) il gradiente svanisce in modo esponenziale
(vanishing gradient), e la diagonale, che tende a zero quando le unità
saturano, lo spinge ancora più giù. Il maggiorante non dice invece quando il
gradiente esplode: un valore singolare maggiore di \(1\) è condizione necessaria,
non sufficiente [PMB13]. Per l’esplosione lo stesso lavoro
propone di tagliare la norma del gradiente (gradient clipping; Mikolov lo
faceva già, componente per componente): detto \(\mathbf{g}\) il gradiente di tutti
i parametri messi in fila, se \(\|\mathbf{g}\| > \tau\) si riscala
\(\mathbf{g} \leftarrow \tau\,\mathbf{g}/\|\mathbf{g}\|\) (in PyTorch
torch.nn.utils.clip_grad_norm_), che cura l’esplosione e non tocca la
scomparsa. Che una rete ricorrente «semplice» faccia fatica su molti passi lo
analizza Sepp Hochreiter già nella tesi del 1991
[Hoc91], e lo dimostrano Yoshua Bengio, Patrice
Simard e Paolo Frasconi nel 1994 [BSF94]; il loro risultato
va enunciato per quello che è: un compromesso, non un divieto. Se la rete
conserva l’informazione in modo robusto, cioè in modo che
un disturbo non la cancelli, allora il gradiente svanisce in modo esponenziale;
e quindi è la discesa del gradiente a non riuscire a trovare quei legami, non la
rete a non poterli rappresentare.
LSTM e GRU: cancelli per la memoria#
La soluzione la propongono nel 1997 Sepp Hochreiter e Jürgen Schmidhuber [HS97], e si chiama LSTM (Long Short-Term Memory, memoria a breve termine lunga: il nome è un gioco di parole, ed è appunto una memoria di lavoro che però dura).
L’idea è dare alla cella una seconda memoria. Accanto allo stato nascosto \(\mathbf{h}_t\), che si ricalcola da capo a ogni passo, la LSTM tiene un secondo vettore, lo stato di cella \(\mathbf{c}_t\), che a ogni passo non viene riscritto ma ritoccato: una parte del vecchio contenuto si cancella, una parte di contenuto nuovo si aggiunge, e il resto passa com’è. Quello che ci si scrive può quindi sopravvivere a cento parole di distanza. A dosare i ritocchi sono tre cancelli (gate). Un cancello è un vettore di numeri fra zero e uno, uno per componente, che moltiplica ciò che passa: a uno lascia passare tutto, a zero niente, nel mezzo una parte. Quei numeri non sono fissati una volta per tutte: li calcola la rete a ogni passo, dalla parola nuova e dallo stato precedente, con pesi che si imparano come tutti gli altri. Il cancello di dimenticanza \(\mathbf{f}_t\) decide quanto conservare del vecchio \(\mathbf{c}_{t-1}\), quello d’ingresso quanto contenuto nuovo scrivere, quello d’uscita quanto di \(\mathbf{c}_t\) mostrare in \(\mathbf{h}_t\).
Il cancello di dimenticanza, però, nel lavoro del 1997 non c’era: i cancelli erano due, d’ingresso e d’uscita, e lo stato di cella si aggiornava solo per addizione, senza poter mai essere svuotato. Arriva tre anni dopo, con Felix Gers, Jürgen Schmidhuber e Fred Cummins [GSC00], e nasce da un difetto scoperto all’uso. Su una sequenza che non finisce, e che quindi non azzera mai lo stato, \(\mathbf{c}_t\) cresce senza fermarsi. A guastarsi è la lettura: il valore letto passa per una funzione a S che schiaccia ogni numero fra \(-1\) e \(1\) (la \(\tanh\), nella forma di oggi), e con \(\mathbf{c}_t\) enorme ne esce sempre un estremo, qualunque cosa ci sia scritta. La cella smette di distinguere un contenuto dall’altro e torna a comportarsi come una ricorrente qualunque. Su un testo che finisce va bene lo stesso; su un flusso che non finisce mai (una trasmissione, un sensore, una conversazione senza fine) è fatale. La forma con tre cancelli è quella che oggi si chiama LSTM senz’altra specificazione, ed è quella che segue.

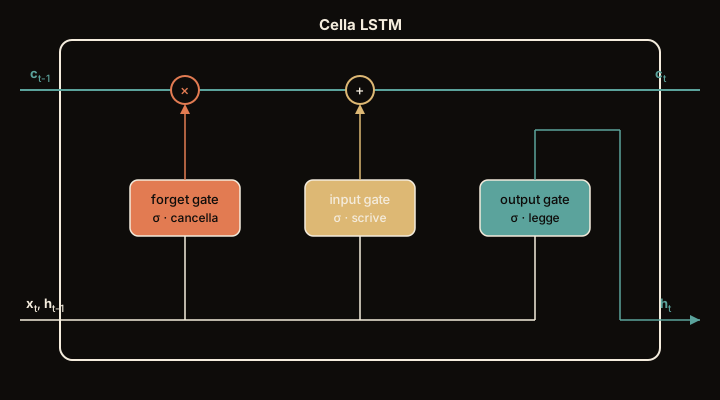
Fig. 15.16 I tre cancelli della LSTM. La linea che attraversa la cella da parte a parte è lo stato di cella, che i cancelli modificano poco per volta invece di riscriverlo da capo a ogni passo. Nel disegno \(\mathbf{c}_t\) è lo stato di cella e \(\mathbf{h}_t\) lo stato nascosto; ogni σ è una sigmoide, la funzione che dà a un cancello i suoi valori fra zero e uno; forget, input e output gate sono i nomi inglesi dei cancelli che cancellano, scrivono e leggono.#
Il dettaglio decisivo di Fig. 15.16 è la linea orizzontale che attraversa la cella quasi indisturbata: è lo stato di cella \(\mathbf{c}_t\), che da un passo all’altro viene soltanto moltiplicato per il cancello di dimenticanza \(\mathbf{f}_t\) e sommato a un contenuto nuovo. Il gradiente che risale lungo quella linea incontra quindi, a ogni passo, un solo fattore, e quel fattore la rete lo calcola dall’ingresso: dove deve ricordare, può tenerlo quasi a uno. Quanto vicino a uno, lo dicono le potenze. Dopo cento passi un fattore \(0{,}999\) lascia passare il \(90\%\) del segnale (\(0{,}999^{100} \approx 0{,}905\)), un fattore \(0{,}9\) ne lascia \(0{,}9^{100} \approx 0{,}000027\). Nella rete semplice, invece, il gradiente passa a ogni passo per la stessa matrice di pesi \(\mathbf{W}_{hh}\) e per la derivata della \(\tanh\), la funzione che schiaccia lo stato fra \(-1\) e \(1\), e nessun cancello decide, parola per parola, dove lasciarlo passare.
Sul tavolo adesso ci sono due fogli. Il foglietto dei riassunti è quello di prima, e a ogni riga lo riscrivi da capo. Accanto c’è il taccuino, e sul taccuino non si riscrive niente. Ci aggiungi una riga, ne cancelli una, e tutto il resto resta dov’è.
A regolare il traffico ci sono tre manopole, i cancelli (in inglese gate). La prima decide quanto di ciò che sta sul taccuino tenere e quanto dimenticarne. Per la seconda prepari prima l’appunto per esteso, la frase che scriveresti se dovessi scrivere tutto, e poi la manopola decide quanta parte annotarne davvero. La terza decide quanto del taccuino mostrare sul foglietto. Il taccuino fa da archivio, il foglietto è quello che si tiene sott’occhio per rispondere e per leggere la riga dopo.
Le manopole si girano poco per volta, come il rubinetto dell’acqua. Di quanto girarle lo decidi riga per riga, guardando la riga nuova e il foglietto, e a deciderlo bene la rete ci arriva da sé. Se una cosa serve ancora («stiamo parlando di chiavi, plurale»), la prima manopola resta spalancata, dal taccuino non si cancella niente, e quella riga arriva intatta cento righe più in là.
Ed è per la stessa ragione che la correzione, risalendo, arriva in cima. Sul foglietto ogni riga ripassa per la stessa riscrittura, e cento riscritture che conservano nove decimi lasciano meno di un trentamillesimo: \(0{,}9\) moltiplicato per sé stesso cento volte fa \(0{,}000027\). Sul taccuino la riga vecchia non si riscrive, le si scrive accanto. Se scrivo \(b = a + c\) e cambio \(a\) di un centesimo, \(b\) cambia di un centesimo esatto; così la correzione che risale lungo il taccuino attraversa cento aggiunte e arriva com’era partita. L’unica moltiplicazione è la prima manopola, e finché resta spalancata moltiplica per uno.
Nella prima versione, del 1997, le manopole erano due, annota e mostra. Quella che dimentica sembrava superflua (perché mai insegnare a una memoria a cancellarsi?) e fu aggiunta solo tre anni dopo, quando ci si accorse che su un testo che non finisce mai il taccuino si carica di segni sempre più calcati, uno sopra l’altro, finché a leggerlo è tutto nero e una riga non si distingue più dall’altra. Saper dimenticare, si scoprì, è parte del saper ricordare.
Esiste anche una versione più snella della stessa idea, proposta nel 2014 da Kyunghyun Cho e colleghi e chiamata GRU (Gated Recurrent Unit, «unità ricorrente con i cancelli»: il nome descrive esattamente quello che è). Le manopole sono due invece di tre, e taccuino e foglietto dei riassunti diventano un foglio solo. Una sola manopola decide insieme quanto tenere del vecchio e quanto scrivere del nuovo, perché lo spazio è uno: quello che lasci al vecchio lo togli al nuovo. L’altra decide quanto del vecchio guardare mentre prepari l’appunto. Meno pezzi, meno numeri da imparare, e spesso risultati altrettanto buoni. Le due sigle compaiono quasi sempre appaiate, LSTM e GRU: sono due tagli dello stesso vestito.
La LSTM affianca allo stato nascosto \(\mathbf{h}_t\) uno stato di cella \(\mathbf{c}_t\), la memoria a lungo termine. I gate sono vettori in \([0,1]\) prodotti da una sigmoide \(\sigma\); nella formulazione del 1997 erano due, input \(\mathbf{i}_t\) e output \(\mathbf{o}_t\), e la memoria si aggiornava per pura addizione, senza poter mai essere svuotata: \(\mathbf{c}_t = \mathbf{c}_{t-1} + \mathbf{i}_t \odot \tilde{\mathbf{c}}_t\), con \(\tilde{\mathbf{c}}_t\) la memoria candidata, definita poco più avanti. La versione con il forget gate \(\mathbf{f}_t\) [GSC00], quella che segue, è la forma canonica di oggi:
Qui \(\oplus\) è la concatenazione: \(\mathbf{h}_{t-1} \oplus \mathbf{x}_t\) mette in fila le componenti dei due vettori, e se \(\mathbf{x}_t\) ha dimensione \(d_x\) ogni matrice \(\mathbf{W}\) è \(d \times (d + d_x)\). L’aggiornamento della memoria è quasi additivo, ed è questo a tenere vivo il gradiente:
dove
\(\tilde{\mathbf{c}}_t = \tanh(\mathbf{W}_c(\mathbf{h}_{t-1}\oplus\mathbf{x}_t)+\mathbf{b}_c)\)
è la memoria candidata e \(\odot\) è il prodotto elemento per elemento. Il perché
si legge nella derivata lungo la strada della memoria: trascurando la dipendenza
da \(\mathbf{h}_{t-1}\) dei gate e della candidata,
\(\partial \mathbf{c}_t / \partial \mathbf{c}_{t-1} = \mathrm{diag}(\mathbf{f}_t)\),
una diagonale che la rete porta vicino a \(1\) quando deve ricordare, al posto del
fattore \(\mathrm{diag}(1 - \mathbf{h}_s \odot \mathbf{h}_s)\,\mathbf{W}_{hh}\)
della rete semplice, dove la matrice è la stessa a ogni passo e nessun cancello
tiene la diagonale vicina a \(1\). Nel 1997 quel fattore era l’identità per
costruzione, il constant error carousel di Hochreiter e Schmidhuber; per la
stessa ragione conviene inizializzare a \(1\) il bias di \(\mathbf{f}_t\), che con i
pesi piccoli di partenza terrebbe il cancello intorno a \(0{,}5\) e dimezzerebbe
il gradiente a ogni passo: Jozefowicz e colleghi lo raccomandano notando che
pochi lo facevano [JZS15], e nn.LSTM di PyTorch non lo
fa da sé. La GRU (Gated Recurrent Unit, [CvMerrienboerG+14]) fonde
stato e memoria in un solo vettore e usa due gate, update \(\mathbf{z}_t\) e
reset \(\mathbf{r}_t\):
L’update gate fa insieme il lavoro del forget e dell’input della LSTM, legati in
modo da sommare a uno; il reset decide quanta parte dello stato passato entra
nella candidata. Questa è la forma di Cho e colleghi, in cui il reset agisce su
\(\mathbf{h}_{t-1}\) prima del prodotto con la matrice. nn.GRU di PyTorch,
quella con cui si può sostituire la LSTM nel classificatore di sentiment, lo
applica dopo: spezzata \(\mathbf{W}_h\) nel blocco \(\mathbf{U}_h\) che moltiplica
lo stato e nel blocco \(\mathbf{V}_h\) che moltiplica l’ingresso, calcola
\(\tilde{\mathbf{h}}_t = \tanh\big(\mathbf{V}_h\mathbf{x}_t + \mathbf{b}_h + \mathbf{r}_t \odot (\mathbf{U}_h\mathbf{h}_{t-1} + \mathbf{b}'_h)\big)\),
con un secondo bias \(\mathbf{b}'_h\) dentro il prodotto. Le due varianti hanno
le stesse matrici e calcolano funzioni diverse: chi confronta la formula con il
codice, o carica in un’implementazione i pesi addestrati con l’altra, ottiene
stati diversi.
Con \(d\) unità nascoste e ingressi di dimensione \(d_x\), ogni blocco di pesi conta \(d(d + d_x)\) parametri più i bias, che in PyTorch sono due vettori da \(d\): la rete semplice ha un blocco, la GRU tre e la LSTM quattro, quindi la GRU ha tre quarti dei parametri della LSTM a parità di dimensione. Il costo per passo cresce nello stesso rapporto, \(O(d(d + d_x))\) per blocco, e la retropropagazione su \(n\) passi tiene in memoria \(O(n\,d)\) attivazioni, che è la ragione del troncamento a blocchi. I confronti sistematici non danno un vincitore netto: il verdetto fra le due cambia con il compito e con l’inizializzazione del forget gate [JZS15], e legare forget e input come fa la GRU non peggiora la LSTM in modo significativo [GSKoutnik+17].
In pratica, con PyTorch#
La cella, i cancelli e lo stato nascosto si condensano in PyTorch in poche righe. Il compito di esempio è quello affrontato nella sezione sulla classificazione: leggere una recensione e decidere se è entusiasta o stroncatoria.
I tre strati del programma corrispondono uno a uno ai pezzi della rete.
nn.Embedding è la tabella che trasforma ogni parola nel suo embedding.
nn.LSTM è lo strato ricorrente: applica la cella con i suoi cancelli a tutta
la frase, un passo dopo l’altro, e restituisce lo stato di ogni passo (la cella
di un passo solo, in PyTorch, è nn.LSTMCell). nn.Linear trasforma l’ultimo
stato nei due punteggi del verdetto, uno per classe: è la regressione logistica
della sezione sulla classificazione, applicata al riassunto della frase invece
che al sacchetto di parole. Siccome i tre strati ricorrenti (nn.RNN,
nn.LSTM e nn.GRU) condividono l’interfaccia, per passare dall’uno all’altro
basta cambiare il nome della classe; l’unica differenza è lo stato finale, che
per la LSTM è una coppia, \((\mathbf{h}, \mathbf{c})\).
import torch
from torch import nn

class ClassificatoreSentiment(nn.Module):
    def __init__(self, vocab=10000, dim=64, hidden=128):
        super().__init__()
        self.embedding = nn.Embedding(vocab, dim)  # parola -> vettore
        self.rnn = nn.LSTM(dim, hidden, batch_first=True)  # prova nn.RNN o nn.GRU
        self.out = nn.Linear(hidden, 2)            # 2 classi: negativo/positivo

    def forward(self, x):          # x: (batch, lunghezza), indici di parole
        e = self.embedding(x)      # (batch, lunghezza, dim)
        h, _ = self.rnn(e)         # stato nascosto a ogni passo
        return self.out(h[:, -1])  # ultimo passo -> logit per CrossEntropyLoss
Il blocco nasconde però una semplificazione che in un programma reale produce
errori: h[:, -1] prende l’ultimo posto della fila. In un mini-batch le frasi
hanno lunghezze diverse, e per metterle in una tabella sola le si allunga tutte
alla stessa misura con dei riempitivi (il padding). L’ultimo posto letto è
allora l’ultimo riempitivo, non l’ultima parola, e lo stato estratto dipende da
quanti riempitivi si sono aggiunti.
Il rimedio è dire alla rete quanto è lunga davvero ciascuna frase. In PyTorch lo
si fa impacchettando il mini-batch con pack_padded_sequence, a cui si passano
le lunghezze vere (con enforce_sorted=False se le frasi non sono ordinate
dalla più lunga alla più corta). La rete restituisce allora, come secondo
valore, lo stato finale h_n (per la LSTM la coppia h_n, c_n), che per
ciascuna frase si ferma alla sua ultima parola vera. Lo si legge come
h_n[-1]: il primo indice di h_n scorre sugli strati della rete, anche con
batch_first=True, e -1 prende l’ultimo. Prendere invece h[:, -1] dopo aver
srotolato l’uscita con pad_packed_sequence darebbe un vettore di zeri per ogni
frase più corta delle altre. Senza impacchettare, lo stato giusto si prende,
frase per frase, alla posizione della sua ultima parola vera, cioè alla sua
lunghezza meno uno.
Il ciclo di addestramento è quello che conosciamo dal capitolo su PyTorch. E provare, come si è detto, costa una parola: si scambia
nn.LSTM con nn.RNN o con nn.GRU, e il resto del programma non cambia di
una riga. Cambia invece il numero dei pesi, che con le dimensioni del
classificatore si conta così:
from torch import nn

for Strato in (nn.RNN, nn.GRU, nn.LSTM):
    rete = Strato(input_size=64, hidden_size=128)  # misure del classificatore
    print(f"{Strato.__name__:5} {sum(p.numel() for p in rete.parameters()):6}")
RNN    24832
GRU    74496
LSTM   99328
Una RNN semplice ha un blocco di pesi, una GRU tre e una LSTM quattro, tutti della stessa forma: la GRU ha esattamente tre quarti dei pesi della LSTM. Su sequenze lunghe LSTM e GRU si addestrano in genere meglio della RNN semplice, per la ragione appena vista: i cancelli lasciano aperta una strada su cui il gradiente arriva anche da lontano. Lo mostra il confronto sistematico di Chung e colleghi su musica polifonica e segnale vocale [CGCB14], dove fra LSTM e GRU, invece, nessuna delle due prevale con chiarezza.
Il collo di bottiglia sequenziale#
Per qualche anno, grosso modo fra il 2013 e il 2017, LSTM e GRU sono state l’architettura di riferimento per la traduzione automatica, il riconoscimento vocale e la generazione di testo. Restava però un limite di calcolo, oltre a quello di apprendimento appena visto: lo stato al passo \(t\) dipende da quello al passo \(t-1\), quindi i passi di una sequenza non si possono eseguire in parallelo.
Una RNN legge in ordine, come una persona: per calcolare il passo 100 deve prima aver fatto il 99, che dipende dal 98, e così via. Non puoi «saltare avanti». Su una frase lunga significa cento passi obbligatoriamente in fila, uno dopo l’altro.
Perché è un guaio? Perché le macchine su cui girano queste reti sono fatte apposta per il contrario. Una scheda grafica (la stessa che nel computer di casa disegna i videogiochi, e che in gergo si chiama GPU) è brava a fare migliaia di conti facili tutti insieme, più che un conto difficile. Metterle davanti una rete ricorrente è come una catena di montaggio con una postazione sola: per quanti operai tu abbia, devono aspettare il proprio turno, e la fila non si accorcia.
La fila lunga si paga anche in un altro modo. Per legare quello che c’è alla riga cento con quello che c’era alla riga uno, la correzione deve risalire tutte le righe di mezzo, una per una. Le manopole tengono la strada aperta molto meglio di un foglio riscritto da capo, ma cento passaggi restano cento passaggi, e imparare un legame così lontano resta difficile.
La catena si potrebbe spezzare solo se ogni postazione facesse un gesto semplicissimo e sempre dello stesso tipo, moltiplicare e aggiungere, senza guardare il foglietto per decidere come. Allora due postazioni di fila si potrebbero riassumere in una sola, che fa i due gesti in uno; e quattro operai, lavorando insieme, ridurrebbero otto postazioni a quattro, poi a due, poi a una: tre giri invece di otto. Con le manopole che dipendono dal foglietto non si può. È la strada che riprenderanno, molti anni dopo, i modelli a spazio di stati.
La ricorrenza \(\mathbf{h}_t = f(\mathbf{h}_{t-1}, \mathbf{x}_t)\) è intrinsecamente sequenziale: il calcolo su una sequenza di lunghezza \(n\) richiede \(O(n)\) passi che non possono essere parallelizzati lungo l’asse temporale. Questo mal si sposa con le GPU, progettate per eseguire in parallelo enormi moltiplicazioni tra matrici. Inoltre il segnale tra due token distanti deve attraversare \(O(n)\) celle, il che rende ancora arduo (pur mitigato dai gate) l’apprendimento di dipendenze molto lunghe. Con stato di dimensione \(d\) il conto è \(O(n\,d^2)\) operazioni in \(O(n)\) passi sequenziali; l’autoattenzione paga \(O(n^2 d)\) operazioni, ma in \(O(1)\) passi sequenziali e con un cammino di lunghezza \(O(1)\) fra due posizioni qualsiasi, e costa meno finché \(n\) resta sotto \(d\) [VSP+17]. La sequenzialità, del resto, è un vincolo delle ricorrenze non lineari. Se l’aggiornamento è lineare in \(\mathbf{h}_{t-1}\), \(\mathbf{h}_t = \mathbf{A}_t\mathbf{h}_{t-1} + \mathbf{b}_t\) con \(\mathbf{A}_t\) e \(\mathbf{b}_t\) che dipendono solo dall’ingresso, due passi consecutivi si fondono in un passo della stessa forma, \((\mathbf{A}_2\mathbf{A}_1,\ \mathbf{A}_2\mathbf{b}_1 + \mathbf{b}_2)\); la fusione è associativa, e si calcola con una scansione parallela in \(O(\log n)\) passi. Perché convenga, \(\mathbf{A}_t\) si prende diagonale: con una matrice piena ogni fusione costa \(O(d^3)\). È la strada presa dai modelli a spazio di stati.
Dove ci porta tutto questo#
Le celle ricorrenti che abbiamo costruito qui sono i mattoni del passo successivo: mettere due RNN una di fronte all’altra (una che legge, una che scrive) e farle tradurre una frase intera. È la storia della traduzione con le reti, ed è proprio lì, per rimediare ai limiti di questa architettura, che nascerà il meccanismo di attenzione: la possibilità, per ogni parola in uscita, di tornare a guardare tutte le parole in ingresso e pesare da sola quali contano.
Quell’idea si rivelerà così potente da fare, nel 2017, un passo ulteriore: eliminare del tutto la ricorrenza e tenere solo l’attenzione [VSP+17], il salto che ha reso possibili i grandi modelli linguistici di oggi.
Le RNN, le LSTM e le GRU restano però in uso dove i dati arrivano un pezzo alla volta e non finiscono mai (il segnale di un sensore, l’audio di un microfono sempre acceso) e dove memoria ed energia sono poche. La ragione è la stessa ricorrenza che le rende lente da addestrare: lo stato ha dimensione fissa, quindi elaborare un elemento in più costa sempre lo stesso, qualunque sia la lunghezza del contesto già letto. Con l’attenzione, invece, ogni elemento nuovo si confronta con tutti quelli che lo precedono, e il costo cresce con la lunghezza.
Da ricordare
Il testo è una sequenza: l’ordine fa parte del significato, e per capirlo serve ricordare quello che si è già letto.
Il foglietto dei riassunti: una rete ricorrente legge una parola alla volta e a ogni parola riscrive un foglietto che riassume tutto il pregresso. È sempre la stessa mano a riscriverlo, e per questo la rete resta piccola anche su testi lunghissimi.
Ogni riscrittura però riduce un pochino il vecchio, e dopo cento righe di pagina uno non resta quasi niente. Una mano più brava potrebbe conservarlo, ma insegnarglielo è difficile: la correzione, mentre risale le righe all’indietro, si accorcia a ogni passaggio finché in cima non sposta più niente. Sono le dipendenze lontane che si dissolvono. (Il rovescio, la correzione che cresce fino a diventare uno strattone, si cura accorciandola a una misura fissa.)
La correzione, poi, si fa a blocchi di righe, e si ferma al confine di ogni blocco: un legame più lungo di un blocco non si impara, qualunque foglio si usi.
La LSTM affianca al foglietto un taccuino protetto, che non viene riscritto da capo a ogni passo ma solo ritoccato, e tre manopole che decidono quanto del taccuino dimenticare, quanta parte dell’appunto annotarci e quanto mostrarne sul foglietto: così un’informazione può restare intatta finché serve. Si girano poco per volta, come il rubinetto dell’acqua. Curiosamente quella che dimentica è arrivata tre anni dopo le altre due, ed è la più importante quando il testo non finisce mai. La GRU è la stessa idea in versione più snella, due manopole invece di tre e un foglio solo invece di due.
Il limite che resta è di tempo: una rete ricorrente legge in fila, e per fare il passo cento deve aver fatto il novantanove. È una catena di montaggio con una postazione sola, e finché ogni gesto guarda il foglietto per decidere come riscriverlo non c’è computer che la possa mandare più veloce. La fila lunga si paga due volte, perché per legare la riga cento con la riga uno la correzione deve risalire tutte quelle di mezzo. È il collo di bottiglia che i Transformer toglieranno di mezzo, e che i modelli a spazio di stati aggireranno rendendo semplicissimo il gesto di ogni postazione.
Da ricordare
Il testo è una sequenza: l’ordine fa parte del significato, e serve memoria del contesto.
Una RNN riusa la stessa cella a ogni passo, facendo scorrere lo stato nascosto \(\mathbf{h}_t\) nel tempo.
Una RNN fatica sulle dipendenze a lungo termine per due ragioni distinte. Il gradiente che svanisce, che è matematica e riguarda soprattutto le reti semplici (la LSTM lo attenua; l’esplosione si cura col clipping). E il BPTT troncato, che è ingegneria e vale per ogni ricorrente, LSTM compresa: staccando lo stato al confine del blocco (
h.detach()) il gradiente non lo attraversa, quindi un legame più lungo del blocco la rete non lo impara mai.LSTM e GRU introducono i gate, che decidono cosa ricordare e cosa dimenticare, proteggendo la memoria. L’architettura del 1997 [HS97] ne aveva due; il forget gate è del 2000 [GSC00].
Il limite residuo è la sequenzialità delle ricorrenze non lineari (poca parallelizzazione): i Transformer la superano con l’attenzione, i modelli a spazio di stati rendendo lineare la ricorrenza.