


Il latente che si usa#
Con uno spazio latente ben fatto si può fare una cosa che ha l’aria di un gioco di prestigio: si prende il codice di un’immagine, si cambia un numero solo, lo si fa decodificare, e l’immagine che esce è quella di prima con una cosa sola diversa. Più luce. La stessa faccia girata di lato. Lo stesso volto con gli occhiali.
Quando funziona è una meraviglia, perché vuol dire che l’encoder, senza che nessuno glielo abbia chiesto, ha scoperto da solo di che cosa sono fatte le immagini. E qui c’è la domanda, ed è in due tempi: si può chiedergli di farlo? E se si chiede, che cosa si paga?
Un peso sul costo di descrizione#
Il VAE (l’autoencoder variazionale della sezione precedente) si addestra su una perdita fatta di due termini: quanto male si ricostruisce, e quanto costa descrivere il dato nel codice. Chi ha un conto con due voci prima o poi prova a cambiare il peso di una delle due, ed è esattamente quello che fecero Irina Higgins e colleghi nel 2017 [HMP+17]: moltiplicare il costo di descrizione per un coefficiente \(\beta > 0\). La macchina che ne esce si chiama \(\beta\)-VAE: con \(\beta = 1\) è il VAE di prima, con \(\beta > 1\) il costo di descrizione pesa di più, con \(\beta < 1\) di meno.
Girare la manopola vuol dire chiedere all’archivista di essere ancora più sintetico. Con la manopola a uno siamo al patto della sezione precedente; a due gli si dice che ogni riga scritta costa il doppio; a quattro, il quadruplo. Un tetto e un prezzo, per lui, sono due modi di dare lo stesso ordine: invece di scrivergli sul contratto «non più di tre righe», si alza il prezzo della riga finché di righe ne scrive tre, e la manopola è quel prezzo.
L’idea è che un archivista sotto pressione debba mettersi in ordine. Se le righe costano care, gli conviene spenderle bene: usare una riga sola per la luce, una sola per l’inclinazione, invece di spargere ogni cosa un po’ dappertutto.
Il modo in cui obbedisce ha una parte che sorprende: non accorcia soltanto le righe, ne spegne qualcuna del tutto, lasciando cadere per intero quelle che gli rendono meno e concentrandosi su quelle che restano. Fin qui è proprio il mestiere che gli abbiamo chiesto.
Ma quel mestiere ha un punto in cui si rovescia, ed è lo stesso di cui la sezione precedente aveva già avvertito. A un archivista a cui la scrittura costa troppo non conviene più essere sintetico: conviene smettere di scrivere. Prima cadono le righe che servivano meno, poi quelle che servivano un po’, e alla fine consegna schede vuote. A quel punto il copista dipinge sempre lo stesso quadro, che è la media di tutti quelli che ha visto, e cambiare i numeri della scheda non cambia più niente perché non c’è più niente da cambiare.
A volte la manopola c’era già, con un altro nome. Certe pagelle dicono al copista «su ogni pixel tollero un errore di tanto»: più si tollera, meno conta ricostruire bene, e più pesa, al confronto, il costo della scheda, cioè quel «tanto» fa lo stesso lavoro della manopola. Vale finché la tolleranza la sceglie chi addestra; se la si lascia scegliere al copista, la manopola sparisce. La pagella di queste cifre giudica ogni pixel come una scommessa fra bianco e nero, e una tolleranza da regolare non ce l’ha: la manopola va messa a mano, ed è quello che facciamo adesso, girandola su quattro tacche.
Il \(\beta\)-VAE [HMP+17] sostituisce l’ELBO con
dove \(\beta > 0\) pesa il costo di descrizione. Con \(\beta = 1\) si torna all’ELBO. Gli autori lo ricavano come lagrangiana di un problema vincolato, «massimizza la ricostruzione con \(D_{\mathrm{KL}} \le \varepsilon\)», dove \(\varepsilon\) è il tetto che ci si dà e \(\beta\) è il moltiplicatore: sotto quella luce \(\beta\) è il prezzo di quel tetto, cioè dice di quanto migliorerebbe la ricostruzione se al costo di descrizione si concedesse un nat in più.
Due osservazioni che tolgono al parametro l’aria di magia. La prima: \(\beta\) era già lì, nascosto nella scelta della verosimiglianza. Con un decoder gaussiano il cui rumore ha varianza \(\sigma^2\) fissata (è il \(\sigma^2\) dell’apertura del capitolo, non la larghezza della zona proposta dall’encoder), il termine di ricostruzione porta davanti a sé un fattore \(1/(2\sigma^2)\); moltiplicando l’obiettivo per \(2\sigma^2\), che è positivo e quindi non sposta l’ottimo, si ottiene \(-\lVert \mathbf{x} - f_\theta(\mathbf{z}) \rVert^2 - 2\sigma^2 D_{\mathrm{KL}}\), cioè l’obiettivo del \(\beta\)-VAE con \(\beta = 2\sigma^2\) quando la sua ricostruzione è scritta come somma dei quadrati degli scarti. Il valore numerico dipende da quella convenzione (con \(-\tfrac{1}{2}\lVert\cdot\rVert^2\) verrebbe \(\sigma^2\), con la media sui pixel invece della somma \(2\sigma^2/D\)); quello che non ne dipende è che \(\beta\) e la varianza del rumore regolano la stessa cosa. Due riserve, però, e la seconda morde qui: se \(\sigma^2\) viene appreso invece che fissato, il termine additivo \(-\tfrac{D}{2}\log(2\pi\sigma^2)\) non è più una costante e quel grado di libertà sparisce; e il nostro decoder non è gaussiano ma di Bernoulli, cioè un \(\sigma^2\) da girare non ce l’ha affatto. Nell’esperimento delle quattro tacche, quindi, \(\beta\) è un parametro vero e non è assorbito da niente.
La seconda: l’effetto atteso è che le componenti latenti si specializzino, e il meccanismo per cui dovrebbe succedere è la pressione a spegnerne alcune. Ogni componente con \(D_{\mathrm{KL}}\) vicino a zero è una componente che l’encoder ha rinunciato a usare, e in cui \(q_\phi(z_j \mid \mathbf{x}) \approx p(z_j)\): è il collasso della posterior della sezione precedente, che qui compare non come guasto ma come strumento di selezione. Nel caso lineare-gaussiano la soglia si scrive: con \(\sigma^2\) fissato una componente si spegne quando il suo autovalore non supera \(\sigma^2\) [TB99], e siccome \(\beta\) fa il mestiere di \(2\sigma^2\), alzare \(\beta\) spegne le componenti a partire dalla più debole. Fra strumento e guasto passa il valore di \(\beta\), e l’esperimento sulle quattro tacche misura dove.
import torch
from torch import nn
from torch.nn import functional as F
from sklearn.datasets import load_digits

torch.set_num_threads(1)      # numeri riproducibili su qualunque macchina
X = torch.tensor(load_digits().data / 16.0, dtype=torch.float32)
LATENTE = 8


class VAE(nn.Module):
    def __init__(self):
        super().__init__()
        self.tronco = nn.Sequential(nn.Linear(64, 48), nn.ReLU())
        self.testa = nn.Linear(48, 2 * LATENTE)
        self.decoder = nn.Sequential(nn.Linear(LATENTE, 48), nn.ReLU(),
                                     nn.Linear(48, 64))

    def codifica(self, x):
        return self.testa(self.tronco(x)).chunk(2, dim=1)


def addestra(beta):
    """Lo stesso VAE della sezione scorsa, col costo di descrizione pesato."""
    torch.manual_seed(0)
    vae = VAE()
    opt = torch.optim.Adam(vae.parameters(), lr=3e-3)
    for passo in range(4000):
        media, log_var = vae.codifica(X)
        z = media + torch.exp(0.5 * log_var) * torch.randn_like(media)
        ricostruzione = F.binary_cross_entropy_with_logits(
            vae.decoder(z), X, reduction="sum") / len(X)
        # il costo tenuto separato riga per riga, per poterlo poi leggere
        costo = (-0.5 * (1 + log_var - media ** 2 - log_var.exp())).mean(0)
        perdita = ricostruzione + beta * costo.sum()
        opt.zero_grad()
        perdita.backward()
        opt.step()
    return vae, ricostruzione.item(), costo.detach()


print(f"{'beta':>5} {'ricostruzione':>14} {'costo':>7} {'righe usate':>12}   nat per riga")
reti = {}
for beta in (0.5, 1, 2, 4):
    reti[beta], ricostruzione, costo = addestra(beta)
    print(f"{beta:>5} {ricostruzione:>14.1f} {costo.sum():>7.2f} "
          f"{(costo > 0.05).sum().item():>9}/{LATENTE}   "
          + " ".join(f"{v:.2f}" for v in costo.sort(descending=True).values))
 beta  ricostruzione   costo  righe usate   nat per riga
  0.5           18.6    6.03         6/8   1.41 1.40 1.19 0.94 0.70 0.39 0.00 0.00
    1           20.2    3.59         4/8   1.05 1.03 0.89 0.63 0.00 0.00 0.00 0.00
    2           23.6    1.41         3/8   0.51 0.47 0.43 0.00 0.00 0.00 0.00 0.00
    4           27.1    0.00         0/8   0.00 0.00 0.00 0.00 0.00 0.00 0.00 0.00
La tabella dice tre cose.
Il baratto va sempre nella stessa direzione: al crescere di \(\beta\) si spende meno in costo di descrizione e si ricostruisce peggio, da 18,6 nat a 27,1. È quello che ci si aspetta da un problema vincolato come quello da cui nasce il \(\beta\)-VAE: ogni valore di \(\beta\) sceglie un punto diverso della stessa frontiera fra ricostruzione e costo, nessuno è «giusto» in assoluto, e dove stare dipende da che cosa serve.
Le righe del codice si spengono, e non sempre una alla volta: da \(\beta =
0{,}5\) a \(\beta = 1\) se ne spengono due, da 1 a 2 una, da 2 a 4 le ultime tre
insieme. Già a \(\beta = 1\), il VAE della sezione precedente, quattro delle otto
righe portano zero nat: la rete ha scelto da sé di usarne quattro. La
dimensione effettiva del latente è quindi il numero di componenti attive,
quelle con un costo di descrizione sopra zero, e la sceglie l’ottimizzazione
in funzione di \(\beta\), non chi dichiara LATENTE = 8; in pratica si dichiara
un latente abbondante e si contano le righe usate. (Ogni tacca è un
addestramento solo, con un seme fisso: con un altro seme le cifre si spostano
di poco e una riga debole può accendersi o spegnersi, mentre la discesa al
crescere di \(\beta\) resta.)
A \(\beta = 4\) l’encoder ha smesso di codificare. Costo zero su tutte le righe: è il collasso della posterior, arrivato non per sfortuna ma perché lo abbiamo comprato alzando \(\beta\). E c’è una conferma indipendente, che viene da due sezioni fa: la ricostruzione a \(\beta = 4\) vale 27,1 nat, che è lo stesso costo di chi non guarda la cifra e dichiara per ogni pixel il grigio medio di tutte. Non è una coincidenza. A codice vuoto il decoder non può fare altro che produrre sempre la stessa immagine, e quella che gli conviene produrre è proprio la media: i due numeri devono coincidere. La prova del collasso, però, non è il 27,1, è la colonna del costo, che a quella tacca vale zero su tutte e otto le righe; il 27,1 è la conferma che arriva da fuori. E dice una cosa che resta vera in generale: il collasso non è un modello brutto, è nessun modello.
Per vederlo si fa variare una sola componente del codice, tenendo ferme le altre, e si decodifica ogni variante: è una traversata del latente.
LIVELLI = " .:-=+*#%"


def affianca(*immagini):
    griglie = [(im.reshape(8, 8) * 8).round().long().clamp(0, 8) for im in immagini]
    return "\n".join("   ".join("".join(LIVELLI[i] for i in g[r]) for g in griglie)
                     for r in range(8))


for beta in (1, 4):
    with torch.no_grad():
        vae = reti[beta]
        media, log_var = vae.codifica(X)
        costo = (-0.5 * (1 + log_var - media ** 2 - log_var.exp())).mean(0)
        riga = int(costo.argmax())
        # a beta = 4 il costo e' zero su tutte, quindi argmax sceglie fra pareggi
        quale = "la piu' carica" if costo[riga] > 0.05 else "una qualunque"
        varianti = media[:1].repeat(5, 1)          # la scheda della prima cifra
        varianti[:, riga] = torch.linspace(-2.5, 2.5, 5)
        print(f"\nbeta = {beta}: la riga {riga}, {quale}, "
              f"portata da -2,5 a +2,5")
        print(affianca(*torch.sigmoid(vae.decoder(varianti))))
beta = 1: la riga 5, la piu' carica, portata da -2,5 a +2,5
  -#+.       -**-       -**+:      =##*-      +##+.
  ##**      .#*+*.     .#*=*-     .++=#=     .+=**.
 :%:.#:     :#:.+:     :#::+:      -.-#.      ..+*.
 -*  ==     :*. =-     .*+#+.      .=*+.       -#*:
 -*  -=     -+. +-      :-++.      .*#=.      .+#=.
 -%  +-     :* .*:      ..=+.      .+*-       .+-.
 .#+*#.      *=+*       -=*=       :+=.       :*-
  :##:       -#*:       -#+.       =#:        *+.

beta = 4: la riga 2, una qualunque, portata da -2,5 a +2,5
  -**-.      -**-.      -**-.      -**-.      -**-.
 .+*+=.     .+*+=.     .+*+=.     .+*+=.     .+*+=.
 .+-==.     .+-==.     .+-==.     .+===.     .+===.
 .+=+=.     .+=+=.     .+=+=.     .+=+=.     .+=+=.
 .=++=.     .=++=.     .=++=.     .=++=.     .=++=.
 .-===:     .-===:     .-===:     .-===:     .====:
  =++=:      =++=:      =++=:      =++=:      =++=:
  -**-.      -**-.      -**-.      -**-.      -**-.
Con \(\beta = 4\) le cinque immagini sono la stessa immagine: fra la prima e l’ultima si contano due caratteri di differenza, uno nella terza riga e uno nella sesta, e a occhio non si vedono. Il codice non governa più niente.
Con \(\beta = 1\), invece, succede qualcosa, ed è il punto. A sinistra c’è uno zero, con il buco aperto in mezzo; spostandosi verso destra il buco si chiude, la figura si stringe e si sposta di lato, e l’ultima immagine non è più uno zero né si riesce a dire che cifra sia. Sono cambiate insieme la forma del tratto, la posizione e l’identità della cifra, e non una cosa sola. Quella componente del codice è una direzione lungo la quale parecchie cose si muovono insieme, e non «lo spessore» né «l’inclinazione».
Ed è la regola, non l’eccezione. Chiamiamo fattori gli ingredienti di cui un dato è fatto e che si vorrebbero tenere separati: per un volto, la luce, quanto la testa è girata, l’espressione. La parola arriva dall’analisi fattoriale di Spearman, con cui il capitolo si apre, e vuol dire cause che concorrono a un effetto: i fattori di una moltiplicazione sono un’altra cosa. Tenerli separati in inglese si chiama disentanglement, ed è il nome con cui cercarne la letteratura. Nel 2019 Francesco Locatello e colleghi hanno addestrato più di dodicimila modelli di questa famiglia, su sette insiemi di dati e con le varianti più diffuse, per rispondere a una domanda sola: alzare \(\beta\), o usare le sue varianti, separa davvero i fattori? La risposta ha due parti, e la prima è un teorema di impossibilità, uno dei pochi che incontrerai: dimostra che una cosa non si può fare, e non soltanto che è difficile [LBL+19].
Il teorema dice che, senza ipotesi in più sul modello e sui dati, separare i fattori senza supervisione è impossibile. La ragione si vede con un esempio. Supponiamo che l’encoder ci sia riuscito: la prima componente del codice misura quanto la testa è girata, la seconda quanta luce c’è. Ruotiamo ora quelle due componenti insieme, come si gira di sbieco una coppia di assi disegnata su un foglio: al posto di «inclinazione» e «luce» restano due componenti che ne portano un po’ per una (Fig. 25.6).
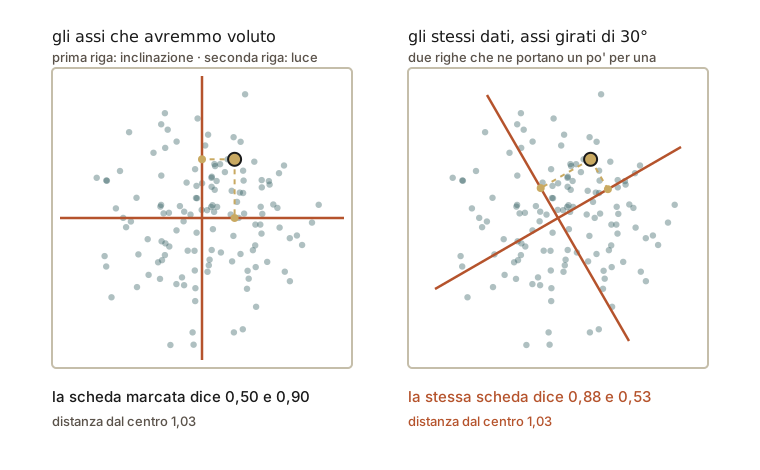
Fig. 25.6 Ogni pallino è un codice, e le due nuvole sono la stessa nuvola: a spostarsi sono gli assi, non i codici. Quella marcata resta dov’è, alla stessa distanza dal centro, e cambiano soltanto i due numeri con cui la si scrive: \(0{,}50\) e \(0{,}90\) diventano \(0{,}88\) e \(0{,}53\).#
Il prior non se ne accorge. La gaussiana \(\mathcal{N}(\mathbf{0}, \mathbf{I})\) è uguale in tutte le direzioni (isotropa, in termini tecnici), e ruotata resta identica: se \(\mathbf{R}\) è una matrice ortogonale, cioè una rotazione o una riflessione degli assi, \(\mathbf{R}\mathbf{z}\) ha la stessa distribuzione di \(\mathbf{z}\). Un decoder che prima di lavorare riporta indietro la rotazione, applicando \(\mathbf{R}^\top\), produce quindi esattamente gli stessi dati, e la probabilità dei dati \(p_\theta(\mathbf{x})\) non si sposta di un nat. Il teorema di Locatello e colleghi generalizza l’esempio a ogni prior a componenti indipendenti, \(p(\mathbf{z}) = \prod_j p(z_j)\): esistono infinite trasformazioni invertibili \(f\) che lasciano invariata la distribuzione di \(\mathbf{z}\) e in cui ogni componente di \(f(\mathbf{z})\) dipende da tutte quelle di \(\mathbf{z}\) (\(\partial f_i / \partial z_j \neq 0\) quasi ovunque), cioè che mescolano del tutto i fattori senza che la verosimiglianza se ne accorga. Nei dati, quindi, non c’è niente che dica che la coppia di partenza sia più giusta di quella girata: sono due descrizioni ugualmente buone, e dai dati non arriva nessun motivo per preferire quella che a noi sembra sensata.
Un motivo, per la verità, c’è, e non viene da quello che abbiamo chiesto: viene da com’è fatto l’encoder. La posterior approssimata ha covarianza diagonale, e le sue ellissi stanno dritte lungo gli assi del latente, come ovali che non si possono inclinare sul foglio. Ruotare il latente le inclinerebbe, e la famiglia gaussiana diagonale le ellissi inclinate non le sa rappresentare: l’ELBO, a differenza della verosimiglianza, cambia se si ruota il latente. Questa asimmetria spinge le direzioni scelte verso quelle della PCA [RZM19]: è un appiglio, e spiega perché qualcosa si separi invece di niente; ma la PCA guarda dove i dati variano di più, e quello non è l’elenco degli ingredienti.
La seconda parte è sperimentale, ed è la più scomoda. Fra i dodicimila modelli, a contare non era quale metodo si fosse scelto. Contavano il sorteggio con cui la rete era stata inizializzata, cioè i suoi numeri interni prima di imparare, e il valore degli iperparametri, \(\beta\) compreso. E nello studio non si è trovato un criterio per sceglierli senza etichette: la selezione del modello senza supervisione resta un problema aperto, e per adesso si prova.
Il che non rende \(\beta\) inutile: regola quanta informazione porta il codice, non quali fattori separa.
Quando il latente è fatto di simboli#
Al codice si può chiedere anche un’altra cosa, ed è la più conseguente di tutte per quello che viene dopo: che invece di numeri porti simboli, presi da un elenco finito di cui decidiamo in anticipo soltanto quanto sia lungo. La macchina che lo fa si chiama VQ-VAE, dove VQ sta per vector quantization, quantizzazione vettoriale: ogni vettore prodotto dall’encoder viene sostituito dal più vicino di un dizionario finito, e il codice diventa una sequenza di indici, cioè di simboli.
Fin qui l’archivista scriveva numeri, cioè poteva mettere sulla scheda qualunque sfumatura. Adesso gli si dà un prontuario da riempire: milleventiquattro caselle, che è il numero che i codec audio usano davvero per il suono. Le caselle gliele contiamo noi; a riempirle, con le descrizioni-tipo che tornano più spesso nei quadri, pensa lui. E da lì in poi non descrive più niente: guarda il quadro, cerca la casella che gli somiglia di più, e scrive quel numero. La scheda smette di essere una fila di misure e diventa una fila di numeri di catalogo. E la manopola non fa più presa: una casella costa quanto le altre, quindi la scheda costa uguale comunque la si scriva.
Il guadagno è enorme, e lo abbiamo già incassato due volte. Una fila di numeri di catalogo è, alla lettera, un testo: simboli in fila presi da un alfabeto finito, come le parole di una frase sono prese da un vocabolario. E su una cosa fatta così si può mettere al lavoro tutta la macchina costruita per il linguaggio, quella che indovina il simbolo dopo. È il modo in cui una macchina genera musica, e il modo in cui genera parlato.
C’è però un ostacolo, ed è esattamente quello che la sezione precedente aveva annunciato. Il trucco per far tornare indietro le correzioni funzionava perché lo scarto si poteva decidere prima e poi appoggiare sulla zona proposta. Fra la descrizione numero tre e la numero quattro non c’è niente in mezzo, quindi non c’è nessuno scarto da decidere, e il trucco non si applica. Ci vuole un’altra idea, e la si trova nella sezione sui codec neurali, dove il prontuario si chiamava tavolozza: all’indietro si fa finta che la scelta della casella non ci sia, e la correzione arriva all’archivista come se avesse consegnato la sua descrizione esatta invece della casella più vicina. È un’approssimazione, ma funziona. La stessa idea torna nel capitolo sulle GAN, le reti che si sfidano, che leggerai più avanti: nella sezione sulle loro evoluzioni serve a fare lo stesso con le immagini.
Il VQ-VAE [vdOVK17] sostituisce il latente continuo con uno discreto: l’uscita dell’encoder viene sostituita dalla voce più vicina di un dizionario appreso di \(K\) vettori, e il codice diventa una sequenza di indici in \(\{1, \dots, K\}\). La sezione sui codec neurali lo spiega per esteso, dove serve a fabbricare un alfabeto per il suono, e la sezione sulle evoluzioni delle GAN lo riprende come base di VQ-GAN. L’obiettivo, con \(\mathbf{z}_e = e_\phi(\mathbf{x})\), \(\mathbf{e}_{k^\star}\) la voce più vicina e \(\mathrm{sg}\) lo stop-gradient, è
dove il secondo termine porta il dizionario verso l’encoder e il terzo, la commitment loss, trattiene l’encoder vicino al dizionario (\(\beta = 0{,}25\) nel lavoro originale: è il \(\beta\) del VQ-VAE, e con quello del \(\beta\)-VAE di poco sopra ha in comune solo la lettera). Il decoder riceve \(\mathbf{z}_q\), che in avanti vale \(\mathbf{e}_{k^\star}\) e all’indietro passa il gradiente a \(\mathbf{z}_e\) come se la quantizzazione fosse l’identità, \(\partial \mathcal{L} / \partial \mathbf{z}_e = \partial \mathcal{L} / \partial \mathbf{z}_q\): è lo straight-through estimator [BLeonardC13], distorto, perché il gradiente calcolato in \(\mathbf{e}_{k^\star}\) viene applicato in \(\mathbf{z}_e\). Senza quella riscrittura il primo termine non dipenderebbe da \(\mathbf{z}_e\), e la ricostruzione non insegnerebbe niente all’encoder. Il punto di rottura sta nel dizionario: una voce che nessun codice sceglie non riceve gradiente da nessuno dei tre termini e resta inutilizzata, e la capacità effettiva scende sotto \(K\). Il lavoro originale propone, in appendice, di aggiornare il dizionario con medie mobili esponenziali [vdOVK17]; altri riavviano le voci inutilizzate su codici presi dai dati [DJP+20]. Qui interessa la posizione del VQ-VAE in questa famiglia.
La posizione è questa. Con un latente categorico la riparametrizzazione non è disponibile: non esiste una scrittura \(\mathbf{z} = g(\boldsymbol{\epsilon}, \phi, \mathbf{x})\) derivabile in \(\phi\), perché la mappa da \(\phi\) a un indice è costante a tratti e ha derivata nulla quasi ovunque. Restano tre strade, e si incontrano tutte e tre in punti diversi: lo stimatore a punteggio della sezione precedente, che si applica ma paga in varianza; un rilassamento continuo come la Gumbel-softmax, che la sezione sulle rappresentazioni auto-supervisionate usa per wav2vec 2.0; e lo straight-through estimator, cioè copiare all’indietro il gradiente saltando la quantizzazione, che è la scelta di VQ-VAE.
Dell’ELBO, poi, resta poco. Con prior uniforme sugli indici e posterior deterministica il termine di divergenza vale \(\log K\), cioè è una costante: c’è, ma non ha gradiente e non partecipa all’ottimizzazione. Quello che si minimizza davvero è la ricostruzione più due termini che nell’ELBO non compaiono affatto, e che servono a tenere insieme dizionario ed encoder. Il prior sugli indici viene semmai appreso dopo, con un modello autoregressivo sulla sequenza di simboli, ed è quel modello, non il VQ-VAE, a generare.
Quattro macchine, adesso che si sa come sono fatte#
Il modello a variabile latente è al lavoro in quattro sezioni di capitoli diversi, e adesso possiamo saldare il conto. Due li abbiamo già attraversati, e là c’era una promessa al posto della derivazione; due arrivano dopo, e possono darla per fatta.
Nei codec neurali, per fabbricare un alfabeto del suono. Là il codice è fatto di simboli e non di numeri, cioè è il caso in cui la riparametrizzazione non si applica e serve lo straight-through.
Nell’offline reinforcement learning, dove si impara a decidere da partite già giocate senza poterne giocare di nuove, per l’uso più insolito dei quattro: là questa macchina non serve né a generare né a comprimere, serve a recintare. Un VAE condizionato sullo stato si addestra sulle coppie di stato e azione dei dati, e genera le azioni plausibili in quello stato; il programma poi sceglie la migliore soltanto fra quelle, invece che fra tutte, così da non valutare azioni che nei dati non compaiono mai. È un modello generativo usato come vincolo.
Gli altri due arrivano dopo, e quando li incontrerai saprai già che cosa c’è dentro.
In Stable Diffusion, per far stare un generatore di immagini in un computer di casa. Là all’autoencoder non si chiede affatto di generare: gli si chiede solo di rimpicciolire le immagini di quarantotto volte, così che il generatore vero e proprio possa lavorare su qualcosa di piccolo. L’autoencoder impara prima, da solo, e poi smette di imparare; e il costo di descrizione, che tiene i codici raccolti, ha un peso apposta piccolissimo. È il caso in cui il difetto misurato nella sezione sull’ELBO, lo scarto fra il prior e l’insieme vero dei codici, non si risolve: si aggira, perché a decidere che cosa esce dal codice pensa un altro modello.
Nei mondi in miniatura, in cui un programma si allena immaginando invece che giocando, per spremere un fotogramma di videogioco in trentadue numeri. Là il punto è proprio la regolarità dello spazio latente: se avesse buchi, la macchina che immagina il fotogramma successivo produrrebbe presto un codice a cui non corrisponde nessuna immagine, e il sogno si spezzerebbe dopo pochi passi.
Da ricordare
Si può mettere una manopola sul costo della scheda e chiedere all’archivista di essere ancora più sintetico. Sulle quattro tacche provate il baratto va sempre nella stessa direzione: la scheda costa meno e la copia peggiora, e su nessuna si guadagna da tutte e due le parti.
Girando la manopola le righe della scheda si spengono, non sempre una alla volta: già al valore normale, quattro righe su otto portano zero. La dimensione del latente la decide la rete, pagandola, e non la dichiarazione.
Girata troppo, l’archivista smette di scrivere: la scheda non governa più niente e il copista dipinge sempre lo stesso quadro.
La manopola compra spazio sulla scheda, non significato: muovendo una riga cambiano più cose insieme. È dimostrato, e non è una difficoltà pratica: senza aiuti dall’esterno, e senza qualche idea in più su com’è fatta la macchina, gli ingredienti di un dato non si separano. E che in pratica contino più il sorteggio iniziale e le manopole del metodo scelto lo hanno mostrato, nel 2019, dodicimila modelli.
La scheda può essere fatta di simboli invece che di numeri, e allora diventa un testo su cui si può mettere al lavoro la macchina del linguaggio. Costa un’altra idea, perché con i simboli il trucco delle correzioni non funziona più.
Questa macchina lavora in quattro capitoli, due già letti e due che verranno: fabbrica l’alfabeto dei codec audio, fa da recinto attorno alle mosse ammissibili quando si impara da partite già giocate, comprime per Stable Diffusion, riassume i fotogrammi dei mondi in miniatura.
Da ricordare
\(\beta\)-VAE [HMP+17]: il termine \(D_{\mathrm{KL}}(q_\phi \,\|\, p)\) pesato da \(\beta\), ricavabile come lagrangiana di «massimizza la ricostruzione con \(D_{\mathrm{KL}} \le \varepsilon\)». Con decoder gaussiano di varianza \(\sigma^2\) fissata non è nemmeno un parametro nuovo, perché \(\beta = 2\sigma^2\); con \(\sigma^2\) appreso l’equivalenza cade, e con un decoder di Bernoulli come quello di questo capitolo un \(\sigma^2\) da girare non c’è affatto: qui \(\beta\) è un parametro vero.
Su cifre 8x8 con \(L = 8\), passando da \(\beta = 0{,}5\) a \(\beta = 4\), la ricostruzione va da 18,6 a 27,1 nat e le componenti con \(D_{\mathrm{KL}} > 0{,}05\) passano da 6 a 0 (un addestramento per valore, con un seme fisso). La dimensione effettiva del latente la sceglie l’ottimizzatore, non chi scrive
LATENTE = 8.La separazione dei fattori non si compra alzando \(\beta\): [LBL+19] dimostra che senza ipotesi induttive sul modello e sui dati è impossibile in modo non supervisionato, e misura su oltre 12 000 modelli che a contare sono il seme e gli iperparametri più della scelta del metodo, e che nello studio non si è trovato nessun modo, in assenza di etichette, di fissare né gli uni né gli altri: per gli autori la selezione del modello senza supervisione resta un problema aperto.
Latente discreto (VQ-VAE [vdOVK17]): la riparametrizzazione non si applica (mappa costante a tratti). Le tre alternative, che si incontrano in punti diversi, sono lo stimatore a punteggio, la Gumbel-softmax e lo straight-through. Nell’obiettivo del VQ-VAE il termine di divergenza vale \(\log K\) ed è quindi costante, cioè resta lì senza avere gradiente, e accanto compaiono due termini estranei all’ELBO che allineano dizionario ed encoder. Ma lo scostamento che conta è un altro: lo straight-through dà un gradiente distorto, quindi non si sta più ottimizzando un limite in senso stretto. Il guasto tipico sono le voci del dizionario che nessuno sceglie, e che restano inutilizzate.
Quattro usi in altrettanti capitoli, due già letti e due che verranno: tokenizzazione del suono (codec neurali) e vincolo di supporto sulle azioni (offline RL); poi compressione percettiva (Stable Diffusion) e riassunto dello stato (world model).
Adesso la macchina sa fare due cose insieme: comprimere un dato in poche componenti, e restituire un dato nuovo partendo da un codice che nessun dato ha mai prodotto. Le fa bene tutte e due, e nessuna delle due benissimo: le immagini che produce sono morbide, e la ragione è nell’obiettivo, che punisce molto il modello se dimentica qualcosa di vero e poco se inventa qualcosa che non esiste. Nel dubbio, quindi, copre.
Il capitolo sulle GAN, che segue, rinuncia alla verosimiglianza. Il generatore definisce ancora una distribuzione, da cui si sa campionare, ma di cui non si calcola la densità: niente limite inferiore, niente costo di descrizione, e al posto dell’obiettivo una seconda rete, il discriminatore, che guarda il risultato e dice se ci crede. Perdiamo la possibilità di dire quanto un dato è probabile; in cambio i campioni sono di norma più nitidi, al prezzo di un addestramento meno stabile.