



Meno passi: risolvere l’equazione invece di simularla#
Il modo che tutti conoscono per seguire numericamente una traiettoria lo scrive Eulero nelle Institutiones calculi integralis del 1768: si guarda in che direzione si sta andando, si fa un passetto in quella direzione, si guarda di nuovo. Con passi abbastanza piccoli funziona; è il metodo più semplice, del primo ordine, e fra quelli in uso è tra i meno precisi, perché l’errore cala solo in proporzione al passo. Ignora poi la struttura che dell’equazione si conosce in anticipo, trattandola come una scatola nera da interrogare passo per passo.
L’equazione della diffusione, invece, ha una struttura particolare: è semilineare. Il termine lineare nello stato viene dal programma di rumore, che abbiamo scelto noi, e si risolve in forma chiusa, senza approssimare niente; il termine che contiene la rete, e solo quello, va approssimato numericamente. Un integratore che tiene separati i due termini ha portato il costo di un’immagine da qualche centinaio di valutazioni della rete a una ventina, con la stessa rete e gli stessi pesi: nessun riaddestramento, soltanto un modo più accorto di percorrere la stessa strada.
Metà dell’equazione si risolve a mano#
Una barca scende un fiume. Due cose la muovono: la corrente, che la trascina in un modo perfettamente noto perché del fiume abbiamo la carta (con i tratti lenti e le rapide), e i colpi di remo di chi ci sta sopra, che dipendono da dove si trova e da cosa vede.
Chi volesse prevedere dove finirà la barca ha due strade. La prima è misurare ogni secondo lo spostamento complessivo e sommarlo: onesto ma sprecato, perché a ogni secondo si ricalcola anche la corrente, che era già nota. La seconda è tenere i due contributi separati: la corrente si calcola una volta per tutte con carta e penna (in gergo, si integra), e i passi numerici si spendono soltanto per i colpi di remo, che sono la parte imprevedibile.
L’equazione della diffusione è fatta proprio così. Un pezzo dice «restringi lo stato di questo fattore», e il fattore dipende dal programma di rumore, scelto da noi: si conosce in forma esatta a qualunque istante. L’altro pezzo dice «e adesso correggi come indica la rete», e solo quello è ignoto.
Un metodo che tratta i due pezzi allo stesso modo, come fa quello di Eulero, spreca passi per ricalcolare qualcosa di già noto. Un metodo che li separa, invece, usa gli stessi passi tutti sul pezzo che conta. Il guadagno è grande perché il pezzo noto, in queste equazioni, cambia molto in fretta: all’inizio del ritorno il fattore di scala si muove di ordini di grandezza, e chi lo insegue a passetti deve farne moltissimi.
La PF-ODE, scritta con la parametrizzazione sul rumore, ha struttura semilineare:
dove si è usata \(\nabla\log p_t = -\boldsymbol{\epsilon}_\theta/\sigma_t\). La parte lineare ammette soluzione esatta per fattore integrante: posto \(\alpha_t = \exp\!\big(\int_0^t f\big)\), la variazione delle costanti dà, per un passo da \(s\) a \(t\),
Il primo addendo è esatto, per qualunque ampiezza del passo: nessuna approssimazione, nessun errore accumulato. Ne segue che tutto l’errore di discretizzazione sta nell’integrale, cioè nella sola parte che dipende dalla rete.
Questa è la definizione di integratore esponenziale, una famiglia di metodi sviluppata per i problemi stiff, quelli con costanti di tempo molto più corte del passo che si vorrebbe usare. Nella PF-ODE, però, la rigidità sta nel termine della rete vicino a \(t = 0\), e il coefficiente lineare ne è esente: \(f(t) = -\tfrac12\beta(t)\) resta fra \(-0{,}05\) e \(-10\), e all’indietro, nel verso della generazione, allarga invece di smorzare, con \(|hf| \le 1{,}25\) a otto passi uniformi: nessun modo da inseguire più in fretta del passo. Con \(\boldsymbol{\epsilon}_\theta \approx (\mathbf{x} - \alpha_t\mathbf{x}_0)/\sigma_t\), invece, la derivata del termine della rete rispetto a \(\mathbf{x}\) vale circa \(g^2(t)/(2\sigma_t^2)\), che sul banco di prova passa da \(10\) a \(t = 1\) a circa \(545\) a \(t = 10^{-3}\). Il cambio di variabile in \(\lambda\) lo disinnesca: il fattore \(1/\sigma_t\) diventa il peso \(e^{-\lambda}\), integrato in forma chiusa, e ad essere approssimata resta la sola \(\hat{\boldsymbol{\epsilon}}_\theta(\lambda)\), che in \(\lambda\) varia lentamente. Eulero a passi uniformi in \(t\) non ha nessuna delle due difese, e per questo si comporta peggio del suo ordine nominale.
Il tempo giusto non è il tempo#
C’è una seconda idea, indipendente dalla prima e altrettanto redditizia: la scelta di come spaziare i passi.
Distribuirli uniformemente nel tempo sembra naturale e non lo è, perché lungo il percorso non succede sempre la stessa quantità di cose. Nella prima parte del ritorno l’immagine è indistinguibile dal rumore e i cambiamenti sono grossolani; nell’ultimo tratto si decidono i dettagli, e lì i passi vanno fitti. Passi uniformi nel tempo ne sprecano parecchi dove non serve.
La grandezza rispetto a cui conviene spaziarli è quanto segnale c’è rispetto al rumore, e conviene contarla per moltiplicazioni invece che per somme. Ad esempio, un passo porta il rapporto fra segnale e rumore da un centesimo a un decimo, il successivo da un decimo a 1, quello dopo da 1 a 10: ogni passo moltiplica per dieci, cioè cambia le cose nella stessa proporzione, e i passi risultano ugualmente informativi. Contare così, per fattori invece che per differenze, si chiama usare una scala logaritmica.
È un cambio di variabile, cioè un’operazione che non tocca l’equazione ma solo il modo di percorrerla, e vale già una parte importante del risparmio. Chi usa una libreria trova la spaziatura come impostazione a sé, staccata dal metodo di calcolo: sono due manopole, e girare la prima cambia l’immagine anche lasciando ferma la seconda.
Introduciamo il log-rapporto segnale-rumore
funzione strettamente decrescente di \(t\), quindi invertibile: \(t = t_\lambda(\lambda)\). Il rapporto è quello fra le ampiezze, quindi \(\lambda_t\) è la metà del logaritmo del rapporto segnale-rumore \(\mathrm{SNR}(t) = \alpha_t^2/\sigma_t^2\) della sezione sul limite continuo (DPM-Solver lo chiama infatti half-logSNR), e chi scrive il log-SNR sulle potenze trova \(2\lambda_t\) dove qui c’è \(\lambda_t\).
Cambiando variabile nell’integrale, e usando le identità \(\mathrm{d}\lambda = -\tfrac{g^2}{2\sigma_t^2}\mathrm{d}t\) valide per i programmi affini, la soluzione esatta assume la forma
con \(\hat{\boldsymbol{\epsilon}}_\theta(\lambda) := \boldsymbol{\epsilon}_\theta(\mathbf{x}_{t_\lambda},t_\lambda)\). È la riscrittura su cui si fonda DPM-Solver [LZB+22b], e ha due conseguenze.
La prima è che l’integrale è pesato esponenzialmente, quindi si approssima bene con una espansione di Taylor di \(\hat{\boldsymbol{\epsilon}}\) in \(\lambda\): i coefficienti che servono sono gli integrali \(\int e^{-\lambda}\lambda^k\,\mathrm{d}\lambda\), che hanno primitiva elementare. Non serve dunque alcuna quadratura numerica.
La seconda riguarda la griglia. Spaziare uniformemente in \(\lambda\) invece che in \(t\) concentra i passi dove \(\hat{\boldsymbol{\epsilon}}\) varia di più, e su programmi come quello lineare di DDPM la differenza fra le due griglie è sostanziale a parità di valutazioni; ma il verso della differenza dipende dal metodo e dal programma di rumore, e il banco di prova lo mostra. È il motivo per cui i campionatori delle librerie espongono la griglia come parametro separato dal metodo: sono due scelte distinte.
La parametrizzazione che le librerie hanno adottato più di tutte è quella di Karras e colleghi [KAAL22]. Si scrive il dato rumoroso come \(\mathbf{x} = \mathbf{x}_0 + \sigma\boldsymbol{\epsilon}\) e si usa \(\sigma\) stesso come tempo, così che la PF-ODE diventa \(\mathrm{d}\mathbf{x}/\mathrm{d}\sigma = \big(\mathbf{x} - D_\theta(\mathbf{x};\sigma)\big)/\sigma\), con \(D_\theta\) la rete che stima \(\mathbf{x}_0\). La griglia è
con \(\rho = 7\), \(\sigma_{\min} = 0{,}002\) e \(\sigma_{\max} = 80\): per \(\rho = 1\) sarebbe uniforme in \(\sigma\), per \(\rho \to \infty\) geometrica, cioè uniforme in \(\lambda = -\log\sigma\), e \(\rho = 7\) sta in mezzo. Il metodo è quello di Heun, del secondo ordine: un passo di Eulero, una seconda valutazione nel punto d’arrivo e la media delle due pendenze, con l’ultimo passo verso \(\sigma = 0\) lasciato a Eulero. Le valutazioni della rete sono quindi \(2N - 1\), e su CIFAR-10 ne bastano trentacinque. È la griglia che le librerie accendono con l’opzione dei «sigma di Karras».
DDIM è il primo gradino della scala, e si vede#
Torniamo alla barca, con la corrente calcolata a penna. Resta da stimare l’effetto dei colpi di remo lungo ciascun tratto, e la stima più semplice è supporre che, per tutto il tratto, il rematore continui a remare come all’inizio. Il conto che ne esce era già noto: è DDIM, il campionatore veloce comparso pochi mesi dopo DDPM. All’epoca ci si era arrivati da tutt’altra parte, la strada raccontata nella sezione su come funziona la diffusione; visto da qui è il primo gradino di una scala.
I gradini della scala si chiamano ordini. Un metodo del primo ordine, come DDIM, fa ogni passo guardando soltanto che cosa succede all’inizio del passo. Uno del secondo ordine fa anche una prova a metà strada, vede se la risposta della rete sta cambiando, e corregge il passo di conseguenza: due domande alla rete invece di una, ma un passo molto più preciso. L’ordine dice quanto in fretta cala l’errore quando si accorciano i passi: dimezzandoli, l’errore di un metodo del primo ordine si dimezza, quello di un metodo del secondo ordine si divide per quattro. Riconoscere DDIM come primo gradino ha quindi un vantaggio pratico immediato: si sa come costruire il secondo.
Approssimando \(\hat{\boldsymbol{\epsilon}}_\theta(\lambda)\approx \hat{\boldsymbol{\epsilon}}_\theta(\lambda_s)\) costante sul passo, l’integrale si risolve e resta
che, riscritta, è l’aggiornamento DDIM [SME21]:
Le due scritture sono la stessa cosa, e la seconda è quella con cui DDIM viene di solito presentato: si stima il dato pulito e lo si rimescola al livello di rumore successivo. L’errore locale è \(O(h^2)\) e quello globale \(O(h)\): DDIM è un metodo del primo ordine e un integratore esponenziale, non un Eulero. La differenza si misura, e risulta grande.
Il secondo ordine (DPM-Solver-2) valuta la rete anche in un punto intermedio \(s_1\), con \(\lambda_{s_1} = \lambda_s + r_1 h\):
dove il termine finale corregge il passo del primo ordine con la variazione di \(\boldsymbol{\epsilon}_\theta\) fra l’inizio e il punto intermedio, cioè con una stima della sua derivata in \(\lambda\). Con \(r_1 = \tfrac12\) i due termini in \(\boldsymbol{\epsilon}_\theta(\mathbf{x}_s,s)\) si elidono e resta \(\mathbf{x}_t = (\alpha_t/\alpha_s)\,\mathbf{x}_s - \sigma_t(e^{h}-1)\,\boldsymbol{\epsilon}_\theta(\mathbf{u},s_1)\), che è il passo del blocco di codice: due valutazioni per passo, errore globale \(O(h^2)\) [LZB+22b].
Le tre affermazioni (il pezzo noto risolto a penna conviene, spaziare i passi sul rapporto segnale-rumore conviene, l’ordine alto conviene) si misurano sullo stesso banco di prova della sezione sul limite continuo: due sole modalità, punteggio esatto scritto a mano, nessuna rete addestrata. Isolare i metodi dalla qualità del modello serve infatti a confrontarli.
import numpy as np

MODI = np.array([-1.5, 1.5])
T_MIN = 1e-3
B_MIN, B_MAX = 0.1, 20.0
beta = lambda t: B_MIN + t * (B_MAX - B_MIN)
alpha = lambda t: np.exp(-0.5 * (B_MIN * t + 0.5 * (B_MAX - B_MIN) * t**2))
sigma = lambda t: np.sqrt(1 - alpha(t)**2)
lam = lambda t: np.log(alpha(t) / sigma(t))          # log-SNR

def eps(x, t):
    """La rete perfetta: il rumore atteso, in forma chiusa."""
    a, s = alpha(t), sigma(t)
    d = x[:, None] - a * MODI[None, :]
    w = np.exp(-0.5 * (d / s)**2)
    w /= w.sum(axis=1, keepdims=True)
    return (w * d).sum(axis=1) / s

# t in funzione di lambda, invertito una volta sola su una griglia fitta
_t = np.linspace(T_MIN, 1.0, 200_001)
_l = lam(_t)
t_di_lam = lambda L: float(np.interp(L, _l[::-1], _t[::-1]))

rng = np.random.default_rng(0)
z = rng.normal(size=2000)

def eulero(M):
    """Eulero in t: tratta l'equazione come una scatola nera."""
    ts = np.linspace(1.0, T_MIN, M + 1)
    x = z.copy()
    for k in range(M):
        t = ts[k]
        campo = -0.5 * beta(t) * x + 0.5 * beta(t) / sigma(t) * eps(x, t)
        x = x + (ts[k + 1] - t) * campo
    return x

def ddim(M):
    """Integratore esponenziale del primo ordine, a passi uguali in lambda."""
    Ls = np.linspace(lam(1.0), lam(T_MIN), M + 1)
    x = z.copy()
    for k in range(M):
        s, t = t_di_lam(Ls[k]), t_di_lam(Ls[k + 1])
        h = Ls[k + 1] - Ls[k]
        x = alpha(t) / alpha(s) * x - sigma(t) * (np.exp(h) - 1) * eps(x, s)
    return x

def dpm2(M):
    """DPM-Solver del secondo ordine: due valutazioni per passo."""
    Ls = np.linspace(lam(1.0), lam(T_MIN), M + 1)
    x = z.copy()
    for k in range(M):
        s, t = t_di_lam(Ls[k]), t_di_lam(Ls[k + 1])
        h = Ls[k + 1] - Ls[k]
        m = t_di_lam(Ls[k] + h / 2)
        u = alpha(m) / alpha(s) * x - sigma(m) * (np.exp(h / 2) - 1) * eps(x, s)
        x = alpha(t) / alpha(s) * x - sigma(t) * (np.exp(h) - 1) * eps(u, m)
    return x

riferimento = dpm2(1000)                     # la soluzione, praticamente esatta
scarto = lambda x: float(np.abs(x - riferimento).mean())

print("valutazioni   Eulero      DDIM        DPM-2")
misure = {}
for N in (8, 16, 32, 64, 128):
    misure[N] = (scarto(eulero(N)), scarto(ddim(N)), scarto(dpm2(N // 2)))
    print(f"{N:11d}   {misure[N][0]:.3e}   {misure[N][1]:.3e}   "
          f"{misure[N][2]:.3e}")
# -> valutazioni   Eulero      DDIM        DPM-2
# ->           8   1.164e-01   1.265e-02   5.940e-02
# ->          16   3.015e-02   4.737e-03   5.012e-03
# ->          32   1.059e-02   2.063e-03   6.528e-04
# ->          64   5.673e-03   9.624e-04   1.411e-04
# ->         128   3.593e-03   4.650e-04   3.655e-05

print("ordine misurato:", [round(float(np.log(misure[32][i] / misure[128][i])
                                       / np.log(4)), 2) for i in range(3)])
# -> ordine misurato: [0.78, 1.07, 2.08]

# la griglia e il metodo, separati: ciascuno sulla griglia dell'altro
def eulero_in_lambda(M):
    Ls = np.linspace(lam(1.0), lam(T_MIN), M + 1)
    ts = [t_di_lam(L) for L in Ls]
    x = z.copy()
    for k in range(M):
        t = ts[k]
        campo = -0.5 * beta(t) * x + 0.5 * beta(t) / sigma(t) * eps(x, t)
        x = x + (ts[k + 1] - t) * campo
    return x

def ddim_in_t(M):
    ts = np.linspace(1.0, T_MIN, M + 1)
    x = z.copy()
    for k in range(M):
        s, t = ts[k], ts[k + 1]
        h = lam(t) - lam(s)
        x = alpha(t) / alpha(s) * x - sigma(t) * (np.exp(h) - 1) * eps(x, s)
    return x

print("32 valutazioni: Eulero in lambda", f"{scarto(eulero_in_lambda(32)):.3e}",
      "  DDIM in t", f"{scarto(ddim_in_t(32)):.3e}")
rapporto = scarto(eulero_in_lambda(32)) / scarto(eulero_in_lambda(128))
print("ordine di Eulero in lambda:", round(float(np.log(rapporto) / np.log(4)), 2))
# -> 32 valutazioni: Eulero in lambda 2.787e-03   DDIM in t 1.143e-03
# -> ordine di Eulero in lambda: 1.09
Gli ordini misurati (l’esponente \(p\) per cui, raddoppiando i passi, l’errore si divide per \(2^p\)) dicono che i metodi si comportano come la teoria prevede: DDIM è del primo ordine (\(1{,}07\)), DPM-Solver del secondo (\(2{,}08\)). Eulero invece non raggiunge il primo ordine (\(0{,}78\)), e il confronto va letto con un’avvertenza: Eulero cammina a passi uniformi in \(t\), DDIM e DPM-Solver a passi uniformi in \(\lambda\), quindi la tabella mescola il metodo e la griglia. Le ultime due righe li separano sullo stesso banco: Eulero sulla griglia in \(\lambda\) torna del primo ordine (\(1{,}09\)) e a trentadue valutazioni scende da \(1{,}1 \cdot 10^{-2}\) a \(2{,}8 \cdot 10^{-3}\), mentre DDIM sulla griglia uniforme in \(t\) fa meglio che su quella in \(\lambda\) (\(1{,}1 \cdot 10^{-3}\) contro \(2{,}1 \cdot 10^{-3}\)). Il ritardo di Eulero viene soprattutto dalla griglia, che in \(t\) lascia pochi passi dove il termine della rete è più ripido; e quale griglia convenga dipende dal metodo e dal programma di rumore.
Fig. 28.10 mette le due griglie una sopra l’altra.
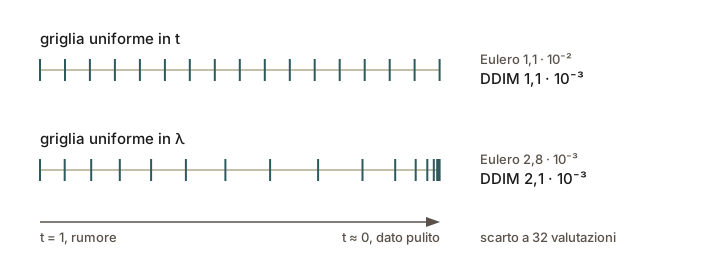
Fig. 28.10 Gli stessi sedici passi, distribuiti in due modi fra il rumore e il dato pulito. La griglia uniforme in \(\lambda\) si infittisce verso il dato, dove il termine della rete è ripido; a trentadue valutazioni Eulero ci guadagna quasi quattro volte, DDIM ci perde. Gli scarti sono quelli stampati dal codice della sezione.#
Il confronto a parità di valutazioni della rete, che è il costo reale di un campione, completa il quadro. Per arrivare allo stesso scarto che DDIM ottiene con trentadue valutazioni, a Eulero ne servono più di centoventotto; a DPM-Solver del secondo ordine ne basta una ventina, a stimarlo fra le righe da sedici e da trentadue, e con le stesse trentadue è già tre volte più preciso.
Quando l’ordine alto smette di aiutare#
La tabella contiene anche il suo controesempio, il punto che in pratica sorprende.
Con otto sole valutazioni il metodo del secondo ordine fa peggio del primo ordine: quasi sei centesimi contro poco più di uno. Nei numeri non c’è un errore: i metodi di ordine alto sono più precisi quando i passi sono piccoli, e più fragili quando sono grandi. Un metodo del secondo ordine guarda avanti usando l’informazione presa a metà passo; se il passo è enorme, quella informazione è presa in un posto molto diverso da dove si finirà, e la correzione fa danni invece che bene. Dove cada il confine dipende però dal problema: sul banco di prova attorno alle sedici valutazioni, nei modelli veri molto prima, tanto che lì l’ordine alto vince già con dieci, e lo stesso rovescio si vede semmai fra il secondo ordine e il terzo.
Ci sono altre due cose che in pratica limitano l’ordine alto.
La prima riguarda la guida, il trucco raccontato nella sezione su Stable Diffusion che interroga la rete due volte, con e senza la richiesta, e moltiplica la differenza per sette o dieci. Quella moltiplicazione rende l’uscita della rete molto più grande del normale. Un metodo del secondo ordine, che dalle risposte già avute prevede come la risposta cambierà lungo il passo (si chiama estrapolare), su una grandezza così gonfiata prevede male ed esce di strada. La cura è cambiare la grandezza su cui si fa la previsione: invece del disturbo si prevede la stima dell’immagine pulita, che resta di taglia normale molto più a lungo e, quando esagera, si può riportare dentro i limiti dell’immagine. È la modifica che porta da DPM-Solver a DPM-Solver++, con i suoi due «più», pensata per il caso guidato, che in pratica è quello di tutti.
La seconda è che sotto una certa soglia il limite smette di essere il metodo. Infatti, se la rete stima il disturbo con un certo errore suo, nessun integratore può fare meglio di quell’errore: si arriva a un pavimento, e da lì in giù aggiungere ordine o passi non serve. Chi vuole scendere sotto quel pavimento deve cambiare il modello, e i modi per farlo sono l’argomento della sezione sui generatori a un passo.
Tre limiti, in ordine di importanza pratica.
Stabilità a passo grande. L’errore locale di un metodo di ordine \(p\) è \(O(h^{p+1})\), con costante proporzionale alla derivata \(p\)-esima di \(\hat{\boldsymbol{\epsilon}}\) in \(\lambda\). Per \(h\) grande la costante domina l’esponente, e la gerarchia degli ordini si rovescia. Sul banco di prova il punto di pareggio fra primo e secondo ordine cade attorno alle sedici valutazioni. Si noti che sui modelli addestrati la soglia non si trasporta: nel lavoro di DPM-Solver, su CIFAR-10, l’ordine alto batte DDIM già a dieci valutazioni, e il rovescio si osserva fra secondo e terzo ordine, con il secondo avanti a dodici valutazioni e il terzo a diciotto [LZB+22b]; è una delle ragioni per cui le librerie predefiniscono il secondo ordine e non il terzo.
Guida forte. Con classifier-free guidance la quantità integrata è \(\tilde{\boldsymbol{\epsilon}} = \boldsymbol{\epsilon}_\varnothing + w\,(\boldsymbol{\epsilon}_c-\boldsymbol{\epsilon}_\varnothing)\), dove \(\boldsymbol{\epsilon}_\varnothing\) e \(\boldsymbol{\epsilon}_c\) sono la predizione senza e con il testo e \(w\) è il peso della guida (un numero, non il peso \(w(t)\) della loss). La norma di \(\tilde{\boldsymbol{\epsilon}}\) cresce linearmente in \(w\) e la sua derivata in \(\lambda\) cresce con essa. DPM-Solver++ [LZB+22a] risolve il problema riscrivendo l’integrale nella parametrizzazione \(\hat{\mathbf{x}}_0\), che a guida alta esce dall’intervallo dei dati molto meno del rumore predetto (e quel che ne esce si riporta dentro con una soglia dinamica), e adottando uno schema multipasso (che riusa le valutazioni precedenti, come i metodi di Adams) invece che a passo singolo: a parità di ordine dimezza le valutazioni. Nella parametrizzazione sul dato, con \(\hat{\mathbf{x}}_0\) al posto di \(\boldsymbol{\epsilon}_\theta\), il passo del primo ordine è
che è ancora DDIM; il secondo ordine multipasso ci aggiunge la differenza fra le ultime due stime di \(\hat{\mathbf{x}}_0\), con una sola valutazione nuova per passo. DEIS [ZC23], uscito poco prima di DPM-Solver, arriva alla stessa famiglia di integratori esponenziali estrapolando \(\boldsymbol{\epsilon}_\theta\) con un polinomio.
Il pavimento dell’errore del modello. Detto \(\delta\) l’errore quadratico medio della rete rispetto al punteggio vero, l’errore del campione generato porta un termine che dipende da \(\delta\) e che nessun integratore riduce: i limiti noti sono superiori, cioè dicono che quel termine non sparisce rimpicciolendo il passo, non che esista un pavimento sotto cui non si possa scendere. Dove quel termine cominci a dominare, nei modelli veri, dipende dal modello e dal compito, e non c’è una cifra che valga per tutti. Si osserva che sotto le dieci valutazioni la qualità dei solutori senza addestramento cala in modo netto; il lavoro è continuato anche dopo DPM-Solver++, con metodi come UniPC [ZBR+23], ma i guadagni in quella fascia si contano in punti di FID. Sotto quella soglia conviene cambiare modello: uno che percorra una traiettoria più corta, o che la salti.
In pratica: quale campionatore#
# la stessa qualita' con quattro budget di valutazioni della rete
for N in (8, 16, 32, 64):
    print(N, f"{misure[N][1]:.1e}", f"{misure[N][2]:.1e}",
          "primo ordine" if misure[N][1] < misure[N][2] else "secondo ordine")
# -> 8 1.3e-02 5.9e-02 primo ordine
# -> 16 4.7e-03 5.0e-03 primo ordine
# -> 32 2.1e-03 6.5e-04 secondo ordine
# -> 64 9.6e-04 1.4e-04 secondo ordine
Sul banco di prova la regola è netta: fino alle sedici valutazioni conviene il primo ordine, sopra il secondo. Sui modelli veri la lezione resta, ma la soglia non è la stessa.
Ad esempio, nel lavoro di DPM-Solver, su CIFAR-10 con un modello addestrato, l’ordine alto batte DDIM già con dieci valutazioni (FID \(13{,}58\) per DDIM, da \(6{,}4\) a \(11{,}3\) per DPM-Solver secondo la variante; a quindici, \(8{,}92\) contro valori fra \(3{,}8\) e \(4{,}8\)), e a rovesciarsi con pochi passi è il confronto fra secondo e terzo ordine: a dodici valutazioni, su un modello a tempo continuo, fa meglio il secondo (\(5{,}28\) contro \(6{,}03\)), a diciotto il terzo (\(3{,}43\) contro \(2{,}90\)) [LZB+22b]. Sono numeri riportati dal lavoro, non misurati qui.
Nelle librerie i nomi sono DDIM per il primo, e anche Euler,
che però non è l’Eulero della tabella: fa i suoi passi sulla scala del rumore
invece che sul tempo, e così finisce per comportarsi quasi come DDIM;
DPMSolverMultistep (nella variante «più») o Heun per il secondo.
La scelta della griglia è un’impostazione a parte, ma attenzione al nome: il parametro che si chiama timestep spacing sceglie fra tre spaziature tutte uniformi nel tempo, mentre la griglia che concentra i passi dove servono si accende con un altro interruttore, il parametro che ridistribuisce i livelli di rumore.
Da ricordare
L’equazione da percorrere è per metà nota: un pezzo riscala lo stato secondo il programma di rumore che abbiamo scelto noi e si risolve a penna, l’altro contiene la rete. I metodi buoni spendono i passi solo sul secondo, quelli generici li spendono su tutti e due.
I passi vanno spaziati non nel tempo ma rispetto a quanto segnale c’è rispetto al rumore, in scala logaritmica: così ogni passo cambia le cose della stessa proporzione. È un parametro a parte rispetto al metodo, e già questo dà una fetta del risparmio.
DDIM è il primo gradino di questa scala, ricavato per un’altra strada nel 2020. Riconoscerlo come tale dice subito come costruire i gradini successivi.
Sul banco di prova, per arrivare dove DDIM arriva con trentadue valutazioni, a Eulero ne servono più di centoventotto e a un metodo del secondo ordine una ventina; con trentadue, quello del secondo ordine è già tre volte più preciso.
L’ordine alto non conviene sempre. Con pochissimi passi è più fragile e fa peggio (sul banco di prova sotto le sedici valutazioni; nei modelli veri il confine cade più in basso, e l’ordine alto vince già con dieci); con la guida forte va riscritto in modo da prevedere la stima dell’immagine pulita invece del disturbo; e sotto una certa soglia il limite diventa l’errore della rete, che nessun integratore può togliere.
Da ricordare
La PF-ODE è semilineare: la parte \(f(t)\mathbf{x}\) ha soluzione esatta per fattore integrante, e l’unico errore di discretizzazione sta nell’integrale che contiene \(\boldsymbol{\epsilon}_\theta\). È la definizione di integratore esponenziale, famiglia nata per i problemi stiff.
Nel tempo \(\lambda_t=\log(\alpha_t/\sigma_t)\) la soluzione è \(\mathbf{x}_t = \frac{\alpha_t}{\alpha_s}\mathbf{x}_s - \alpha_t\int_{\lambda_s}^{\lambda_t}e^{-\lambda} \hat{\boldsymbol{\epsilon}}_\theta\,\mathrm{d}\lambda\): l’integrale è pesato esponenzialmente, quindi Taylor in \(\lambda\) con coefficienti \(\int e^{-\lambda}\lambda^k\) in forma chiusa.
Troncando all’ordine zero si riottiene DDIM, \(\mathbf{x}_t=\frac{\alpha_t}{\alpha_s}\mathbf{x}_s-\sigma_t(e^h-1) \boldsymbol{\epsilon}_\theta\), che è quindi un integratore esponenziale del primo ordine e non un Eulero. Ordini misurati sul banco di prova: Eulero \(0{,}78\), DDIM \(1{,}07\), DPM-Solver-2 \(2{,}08\).
I tre limiti dell’ordine alto: instabilità a passo grande (sul banco di prova il pareggio col primo ordine cade attorno alle sedici valutazioni; su CIFAR-10 con un modello addestrato l’ordine alto vince già a dieci, e il rovescio si vede fra secondo e terzo ordine), norma di \(\tilde{\boldsymbol{\epsilon}}\) che cresce con la guida (donde DPM-Solver++, che estrapola \(\hat{\mathbf{x}}_0\) ed è multipasso), e il pavimento dovuto all’errore \(\delta\) della rete.
La griglia è una scelta separata dal metodo, e non ha una risposta unica: sul banco di prova la griglia uniforme in \(\lambda\) salva Eulero e penalizza DDIM. Per questo le librerie offrono più spaziature (uniforme in \(t\), in \(\lambda\), o quella di Karras e colleghi in \(\sigma^{1/\rho}\)).
Il pavimento dell’errore del modello è il punto in cui questa strada finisce. Percorrere meglio una traiettoria ha un limite pratico, e per scendere sotto le dieci valutazioni bisogna cambiare il problema: invece di seguire la traiettoria un tratto alla volta con un solutore, si insegna a una rete a saltare da un capo all’altro, cioè a coprire un tratto lungo, o tutta la traiettoria, con una valutazione sola.