


Quante repliche accendere: la capacità e il suo prezzo#
Il 4 luglio 1990, allo stadio delle Alpi di Torino, la semifinale dei Mondiali fra Inghilterra e Germania Ovest finisce ai rigori. In Inghilterra la stanno guardando milioni di persone, e nei minuti dopo l’ultimo tiro molte fanno la stessa cosa: si alzano dal divano e accendono il bollitore per il tè. La rete elettrica inglese vede la domanda salire di 2.800 megawatt, cioè di 2,8 milioni di kilowatt: sono più di novecentomila bollitori da tre kilowatt accesi quasi nello stesso istante. Gli ingegneri lo chiamano TV pickup, e quello di Torino è ancora citato come il più grande mai registrato.
Come la rete si prepara a questi minuti l’ha raccontato la National Grid, che la gestisce. Un gruppo di statistici sfoglia i palinsesti televisivi per prevedere i picchi (le partite decisive, le puntate attese delle serie più viste); prima del fischio finale alle centrali si chiede di produrre sotto il massimo, così che abbiano margine da dare subito; e nel Galles la centrale di Dinorwig, che tiene l’acqua in un lago in cima a una montagna e la fa cadere quando serve, con le turbine già in rotazione passa da zero a 1.320 megawatt in dodici secondi. Tanta preparazione ha una ragione semplice. La corrente va prodotta nell’istante in cui la si consuma, e una centrale a carbone spenta ha bisogno di ore per arrivare a regime: accesa quando la domanda arriva, arriva tardi.
Un servizio che risponde con un modello ha lo stesso problema, con una differenza che lo peggiora. Le sue centrali sono schede prese a nolo a ore, e una scheda accesa e ferma costa quanto una che lavora. L’unità con cui si ragiona è la replica, una copia completa del servizio: il modello caricato sulle sue schede, raggiungibile al proprio indirizzo (endpoint), pronto a rispondere. Il traffico non è mai piatto (di giorno cresce, di notte cala, e ogni tanto qualcosa lo fa saltare), e quante repliche tenere accese è una decisione che si prende di continuo. Per prenderla bene servono quattro cose: quanto regge una replica, che cosa guardare per capire che ne servono di più, quanto tempo passa fra chiederne una e averla, e quanto costa ogni token quando le repliche sono accese, che dipende anche da quanta parte di ciascuna scheda si usa davvero.
Quanto regge una replica#
Tutto parte da una capacità, il numero massimo di richieste al secondo che una replica serve mantenendo le promesse. È il goodput di Misurare un servizio rovesciato: invece di chiedersi quante richieste la replica serve bene a un certo carico, si cerca il carico più alto a cui le serve ancora bene quasi tutte. Quel numero non si calcola, si misura, mandando alla replica traffico finto e alzandolo finché le promesse saltano. E il modo in cui il traffico finto viene generato decide se la misura è vera.
Un panettiere vuole sapere quanti clienti regge il suo bancone, e chiede a dieci amici di fargli da clienti per una mattina. Gli amici sono gentili: ciascuno entra, compra, esce, e si rimette in fila solo quando è stato servito. Se il panettiere rallenta, rallentano anche loro, perché nessuno rientra prima di avere il suo pane. La fila non può superare le dieci persone, l’attesa resta ragionevole, e il panettiere conclude che il bancone regge. Non vedrà mai i clienti che, in una mattina vera, sarebbero entrati proprio mentre lui arrancava: nella prova non ci sono, perché ogni amico, finché aspetta il suo pane, non può entrare una seconda volta.
I clienti veri arrivano quando arrivano, senza guardare se dentro c’è ressa. Se il panettiere rallenta la fila cresce, e continua a crescere finché lui non torna a servire più in fretta di quanto la gente entri. Il bancone è lo stesso, ma le due prove misurano cose diverse: la prima quanto va veloce il panettiere con dieci persone davanti, la seconda se ce la fa quando ne entrano due al minuto.
Il collaudo onesto, quindi, fa entrare clienti a un ritmo fissato, due al minuto, poi tre, poi quattro, e a ogni ritmo conta quanti escono entro il tempo promesso: lasciando perdere il primo quarto d’ora, quando la fila si sta ancora formando, e contando abbastanza clienti da non farsi ingannare da una mezz’ora fortunata. Finché il bancone sta dietro agli arrivi la quota resta alta; poi, a un certo ritmo, precipita, perché da lì in avanti la fila si allunga da sola. La capacità è l’ultimo ritmo prima del crollo, e la si prende con un margine sotto, perché lì vicino basta una mattina storta. E i clienti finti devono comprare come quelli veri: dieci persone che chiedono una rosetta ciascuna non dicono niente di un sabato con le torte da ritirare (con i modelli, cento domande di una riga non dicono niente di un giorno di documenti da riassumere).
La prova con gli amici resta quella giusta in un caso solo: quando i clienti sono davvero sempre gli stessi dieci, e ciascuno torna solo dopo essere stato servito. Succede a un forno che rifornisce un ufficio con dieci fattorini, ognuno dei quali riparte per il bancone solo dopo aver consegnato il pane di prima. Con i modelli è un programma che tiene aperte dieci richieste alla volta e ne manda un’altra solo quando una è tornata: per lui la prova con gli amici misura proprio quello che gli succederà.
Un generatore di carico è a ciclo chiuso (closed loop) quando mantiene \(N_u\) utenti virtuali, ciascuno dei quali invia la richiesta successiva solo dopo aver ricevuto la risposta alla precedente e atteso un tempo di pausa \(T_{\text{pausa}}\); è a ciclo aperto (open loop) quando genera gli arrivi con un processo indipendente dalle risposte, per esempio poissoniano di tasso \(\lambda\). Le due classi si comportano in modo radicalmente diverso sullo stesso servente [SWHB06]. Nel ciclo chiuso vale la legge del tempo di risposta interattivo,
dove \(W\) è il tempo di permanenza medio di una richiesta, lo stesso della legge di Little. Se il servente rallenta, \(W\) cresce e il tasso d’arrivo cala da sé, e il numero di richieste nel sistema non supera mai \(N_u\): il generatore si adegua al servente invece di metterlo alla prova. Le richieste che avrebbero trovato la coda lunga, e che in produzione arriverebbero comunque, non vengono mai inviate, e le loro latenze mancano dal campione: è la coordinated omission, come l’ha chiamata Gil Tene. In ciclo aperto, al contrario, sopra la capacità non c’è regime, e il numero di richieste nel sistema cresce senza limite.
La capacità di una replica si definisce allora in ciclo aperto. Si fa scorrere \(\lambda\) su una griglia (lo sweep), a ogni valore si misura la frazione di richieste che rispettano le soglie su TTFT e TPOT, e
con la quota fissata dalla promessa. È la variante duale del goodput, quella con cui il servizio si dimensiona. Tre condizioni la rendono significativa. La conformità a un \(\lambda\) dato dipende dalla distribuzione congiunta delle lunghezze di prompt e risposte, quindi lo sweep si fa rigiocando un campione del traffico vero e non richieste tutte uguali. A ogni \(\lambda\) si scartano i secondi di riscaldamento, in cui la coda si sta ancora formando, e si misura su una finestra di almeno qualche migliaio di richieste: la conformità è una frequenza, e su 200 richieste una quota del 90% ha uno scarto tipo di \(\sqrt{0{,}9 \cdot 0{,}1/200} \approx 2\) punti. E vicino a \(\mu^\ast\) la curva di conformità è ripida: nella coda M/M/1, con \(\mu\) il tasso di servizio grezzo della replica, il tempo di permanenza è esponenziale di parametro \(\mu-\lambda\), la conformità a una soglia \(\tau\) vale \(1 - e^{-(\mu-\lambda)\tau}\), e quindi \(\mu^\ast = \mu - \ln 10/\tau\) per la quota del 90%. Per questo si opera a una frazione di \(\mu^\ast\), non a \(\mu^\ast\). La M/M/1 resta un modello didattico: serve una richiesta alla volta con tempi esponenziali, mentre una replica con batching continuo ne serve molte insieme e deve rispettare due soglie, su TTFT e TPOT. Dà la forma della curva, ripida vicino alla saturazione, e lascia il valore di \(\mu^\ast\) alla misura.
Il ciclo chiuso resta il modello corretto quando la popolazione di chi chiede è davvero fissa: un lavoro batch con \(N_u\) worker, un agente che non lancia la chiamata successiva prima di avere la risposta. Lì il ciclo aperto inventerebbe un sovraccarico che non può accadere.
Che cosa guardare#
Una volta misurata la capacità, la regola sembra ovvia. Se arrivano \(\lambda\) richieste al secondo (il tasso d’arrivo) e una replica ne regge \(\mu^\ast\) (la capacità appena misurata, con l’asterisco a ricordare il tetto per le promesse), servono in tutto \(\lambda/\mu^\ast\) repliche, arrotondando per eccesso: sessanta richieste al secondo con repliche da otto fanno 7,5, cioè otto repliche. Il guaio è che \(\lambda\) non si conosce in anticipo. Il sistema che decide quante repliche tenere accese si chiama autoscaler, e lo stima da qualcos’altro: ogni pochi secondi legge una grandezza, la confronta con un bersaglio, e aggiunge o toglie repliche. È un anello di controllo (misura, confronta, corregge, e ricomincia), e funziona bene quanto la grandezza che guarda.
Nella sala di controllo della rete elettrica il numero che conta più di tutti è la frequenza. La corrente di casa alterna cinquanta volte al secondo perché i generatori delle centrali girano a quel ritmo. Se la domanda supera per un attimo la produzione, l’energia che manca viene tirata fuori dalla rotazione stessa: i generatori rallentano, e la frequenza scende sotto i cinquanta. Se la produzione supera la domanda, sale. La frequenza non dice quanto lavora una centrale, dice se domanda e offerta sono in pari.
Guardare quanto lavora ciascuna centrale sembrerebbe più naturale, e non servirebbe. Una centrale al massimo può coprire la domanda al megawatt o restare indietro di mille, e il suo indicatore segna «al massimo» in tutti e due i casi.
Con un modello va nello stesso modo, e peggio. Il contatore d’uso della scheda segna per quanto tempo c’è almeno un calcolo in corso, piccolo o grande che sia. Con il mazzo continuo, appena c’è una richiesta sola, un calcolo in corso c’è sempre: il contatore segna il pieno sia con una conversazione aperta sia con sessanta. Il mestiere della frequenza lo fanno due numeri. Il primo è la fila, le richieste che aspettano un posto nel mazzo: se cresce, arriva più di quanto si serva. Il secondo è quante richieste sono aperte in tutto, in fila o già in lavorazione: sale e scende con il traffico anche quando la fila è vuota, ed è lui a dire quando le repliche sono troppe. E nessuno fa girare le centrali al cento per cento: il margine sotto il massimo è ciò che assorbe il bollitore in più.
Poi c’è il modo di reagire. La regola è in proporzione. Si fissa quante richieste aperte deve avere ogni replica, diciamo dieci, e il numero non si sceglie a caso: è quante ne tiene aperte una replica che lavora alla sua capacità, misurata con la prova del panettiere, meno il margine. Se con quattro repliche ce ne sono ottanta aperte, venti ciascuna, cioè il doppio, se ne chiedono otto; se ce ne sono dieci e mezza ciascuna, appena sopra le dieci, non si muove niente. Salire si sale subito, perché ogni minuto di ritardo è un minuto di clienti in coda; scendere si scende piano, dopo aver visto il traffico basso per qualche minuto di fila, perché chi spegnesse a ogni calo passerebbe la giornata a spegnere e riaccendere. E chi ha già chiesto tre repliche, e le sta aspettando, non ne chiede altre tre solo perché nel frattempo la fila è ancora lunga: quelle tre sono già in arrivo, come le centrali che la sala di controllo ha già chiamato.
Siano \(\mu^\ast\) la capacità di una replica e \(\lambda(t)\) il tasso d’arrivo. Le repliche necessarie sono \(N_r^\ast(t) = \lceil \lambda(t)/(\rho^\ast\mu^\ast) \rceil\), dove \(\rho^\ast < 1\) è l’utilizzazione bersaglio, una frazione di \(\mu^\ast\): il margine \(1-\rho^\ast\) tiene lontani dal bordo in cui la conformità precipita, e più in là dal muro della coda M/M/1 di Servire un modello, dove la latenza esplode. L’autoscaler non conosce il \(\lambda\) dei prossimi minuti, e nemmeno quanto valga \(\mu^\ast\) sul mix di richieste di adesso: li stima da una metrica. Lo schema dell’autoscaler orizzontale di Kubernetes, il riferimento di fatto, è un controllo proporzionale sul rapporto fra metrica e bersaglio,
con \(N_r\) le repliche accese e \(N_r'\) quelle raccomandate, che non interviene se \(|\text{metrica}/\text{bersaglio} - 1|\) non supera una tolleranza (0,1 di default).
La scelta della metrica è il punto. L’utilizzazione che nvidia-smi espone
come utilization.gpu è la frazione del periodo di campionamento in cui almeno
un kernel era in esecuzione: con il continuous batching vale quasi 100% da una
sequenza in su, non distingue un mazzo da 1 da uno da 64, e satura molto prima
della capacità. Serve una grandezza che cresca con lo squilibrio fra arrivi e
servizio. Per la legge di Little il numero di richieste in volo per replica è
\(L_r = \lambda W / N_r\), e finché le promesse tengono \(W\) varia poco: \(L_r\) è
proporzionale al carico, e un bersaglio sulla concorrenza insegue \(\lambda\).
Rispetto a \(\lambda\) ha un vantaggio, perché pesa ogni richiesta per quanto
dura: \(\mu^\ast\) in richieste al secondo cambia con il mix delle lunghezze, la
concorrenza che una replica regge molto meno. Più diretta ancora è la lunghezza
della coda d’attesa \(L_q\): la coda è stabile se e solo se \(\lambda < N_r\mu\), e
sopra cresce senza limite. I motori di serving espongono anche l’occupazione
della KV cache, che anticipa il momento in cui lo scheduler dovrà sfrattare
sequenze. Strumenti come KEDA portano metriche di questo tipo (la lunghezza di
una coda di messaggi, un contatore del servizio) dentro lo stesso anello.
Il bersaglio sulla concorrenza discende dalla capacità misurata. Una replica che lavora a \(\rho^\ast\mu^\ast\) richieste al secondo, con permanenza media \(\bar W\), ha in volo per la legge di Little
richieste. Con \(\mu^\ast = 8\) richieste al secondo, \(\rho^\ast = 0{,}8\) e una permanenza di circa otto secondi (risposte da 320 token a 40 token al secondo, i valori dell’esempio sul costo per token) il bersaglio è \(0{,}8 \cdot 8 \cdot 8 \approx 51\) richieste in volo per replica.
Due non linearità completano il controllore. La prima è un’isteresi asimmetrica: salire tardi costa violazioni degli SLO, scendere troppo presto costa un’accensione in più, e il comportamento di default di Kubernetes sale subito (fino al raddoppio, o a quattro repliche in più, ogni 15 secondi) e scende solo al massimo delle raccomandazioni degli ultimi 300 secondi (la finestra di stabilizzazione). La seconda è il ritardo: una replica chiesta al tempo \(t\) è pronta a \(t + T_{\text{avvio}}\), e un controllore che non conta quelle in arrivo continua a leggere una metrica sopra il bersaglio e a chiederne altre, con la sovraelongazione tipica dei sistemi con ritardo. Per le metriche misurate su ciascuna replica, Kubernetes attenua la salita contando nella media quelle non ancora pronte come se consumassero zero; con una metrica esterna, come la lunghezza di una coda, e in un controllore scritto in proprio, le repliche in arrivo vanno contate da sé.
Il tempo di accendere#
Il ritardo è ciò che rende difficile il controllo. Fra la chiamata e la prima richiesta servita, una replica nuova attraversa quattro attese in fila. Prima si ottiene una macchina con le schede. Poi si scarica l’immagine del container, cioè il pacchetto sigillato con il programma e tutto ciò che gli serve, come in Servire un modello. Poi si caricano i pesi nella memoria delle schede: stanno dentro l’immagine, o in un volume a parte quando sono troppo grandi per starci. Infine c’è il riscaldamento, in cui il programma prepara i calcoli per quella scheda e riserva la memoria per la KV cache. Quando la macchina c’è già e i pesi arrivano dalla rete, per un modello grande quasi tutto il tempo se ne va nel caricamento dei pesi, ed è un conto di byte e di banda. Il tempo complessivo è l’avvio a freddo (cold start).
Una centrale a carbone spenta non produce niente per ore: prima del primo watt bisogna scaldare tonnellate d’acqua e d’acciaio, e il tempo lo decidono quanta roba c’è da scaldare e quanto calore si riesce a metterci dentro. Dinorwig parte in una dozzina di secondi per la ragione opposta: l’acqua è già lassù, nel lago in cima alla montagna, e per produrre basta aprire le paratoie.
Una replica nuova può essere l’una o l’altra, e dipende da dove stanno i suoi pesi, i miliardi di numeri del modello da portare nella memoria della scheda. Il tempo è la quantità divisa per la velocità del tubo da cui arrivano. Un modello da settanta miliardi di numeri, scritti con due byte ciascuno, pesa 140 gigabyte: da un archivio in rete che manda un gigabyte al secondo ci vogliono 140 secondi, più di due minuti; dal disco della stessa macchina una ventina di secondi; dalla memoria del computer che ospita la scheda, meno di tre. Tenere i pesi vicini è il modo di trasformare la centrale a carbone in Dinorwig.
Poi ci sono le mosse della sala di controllo. Si tengono alcune centrali accese sotto il massimo, pronte a salire: è la riserva, e si paga anche quando non serve. Si legge il palinsesto: se si sa che la partita finisce alle nove e mezza, le centrali si preparano prima, e il bollitore le trova pronte. E non si spegne tutto di notte, se al mattino il primo cliente non può aspettare la caldaia: spegnere tutto fa risparmiare, ma chi arriva per primo si prende l’attesa intera.
Quanta riserva tenere si ricava dalla rampa. Se la domanda sale di cento megawatt al minuto e una centrale ci mette dieci minuti a partire, nel momento in cui la si chiama bisogna averne già mille accesi in più, tanti quanti la domanda ne aggiungerà mentre si aspetta. Una rampa lenta vuole poca riserva, un salto improvviso ne vorrebbe quanto il salto intero, e nessuna riserva ragionevole lo copre. Lo coprono soltanto una centrale che parte così in fretta che il salto non fa in tempo a pesare, come Dinorwig, o il palinsesto, che lo fa vedere arrivare.
Il tempo di avvio si scompone in
con \(M_w\) i byte del checkpoint e \(B_{\text{canale}}\) la banda effettiva del canale più lento attraversato. Per \(N_p = 70 \cdot 10^9\) parametri in bf16, \(M_w = 2N_p = 140\) GB, che vanno comunque divisi su almeno due schede da 80 GB: da un archivio di oggetti in rete a 1 GB/s sono 140 s, da un disco NVMe locale a 7 GB/s 20 s, dalla memoria dell’host attraverso un collegamento PCIe da circa 50 GB/s 2,8 s, se tutto passa da un canale solo. Con il parallelismo tensoriale su \(g\) schede ciascuna carica \(M_w/g\), e se i canali non sono condivisi il termine si divide per \(g\). ServerlessLLM [FXH+24] è costruito su questa gerarchia: un formato di checkpoint pensato per essere letto in sequenza a banda piena, un caricamento a più livelli (rete, SSD, memoria dell’host) e uno scheduler che manda l’istanza nuova sulla macchina che tiene già i pesi più vicino alle schede. Il riscaldamento non è trascurabile: compilare e catturare i CUDA Graphs per le taglie di mazzo previste può costare decine di secondi. La compilazione si può mettere in cache fra un avvio e l’altro, la cattura dei grafi no, e con i pesi già nella memoria dell’host il riscaldamento pesa quanto il caricamento o di più; e se prima occorre ottenere una macchina con le schede, \(T_{\text{macchina}}\) può valere minuti da solo.
Con un ritardo \(T_{\text{avvio}}\), la condizione per non sforare è che la capacità disponibile al tempo \(t\) copra il carico che arriverà mentre la replica chiesta adesso si accende:
Un controllore reattivo conosce solo \(\lambda(t)\), e per soddisfarla deve tenere una riserva di \(\lceil \dot\lambda_{\max} T_{\text{avvio}} / (\rho^\ast\mu^\ast) \rceil\) repliche, con \(\dot\lambda_{\max}\) la rampa più ripida che si vuole assorbire. La riserva cresce con il prodotto di ripidità e ritardo. Per un gradino di altezza \(\Delta\lambda\) l’approssimazione al primo ordine non vale più, e la condizione esatta chiede \(\lceil \Delta\lambda/(\rho^\ast\mu^\ast) \rceil\) repliche in più: una riserva finita, ma grande quanto il salto e da pagare per tutto il tempo in cui il salto potrebbe arrivare. Accorciare \(T_{\text{avvio}}\) riduce la riserva per le rampe in proporzione, e per un gradino riduce la scopertura a \(T_{\text{avvio}}\) senza annullarla. La annulla soltanto conoscere \(\lambda(t + T_{\text{avvio}})\) in anticipo, con una previsione della stagionalità giornaliera o con un calendario degli eventi annunciati.
La scala a zero (spegnere tutte le repliche quando il traffico si annulla) azzera il costo dei periodi vuoti e aggiunge \(T_{\text{avvio}}\) al TTFT della prima richiesta dopo il silenzio. Conviene quando i periodi vuoti durano molto più di \(T_{\text{avvio}}\) e la promessa sul TTFT tollera il caso raro; con un avvio da minuti e uno SLO da mezzo secondo si tiene almeno una replica calda.
Il ritardo e la riserva si vedono all’opera su una giornata intera. Il traffico ha una gobba nel pomeriggio, da 12 a 60 richieste al secondo, e alle nove di sera un evento che per venti minuti ne aggiunge 30 tutte insieme. Ogni replica regge 8 richieste al secondo, e l’autoscaler ne chiede quante bastano a tenerle all’80% (per semplicità legge il traffico esatto di ogni minuto, come se la fila glielo dicesse senza errore): sale appena serve, contando quelle già in arrivo, e scende solo dopo cinque minuti di traffico basso. Cambiano soltanto il tempo di avvio e la strategia.
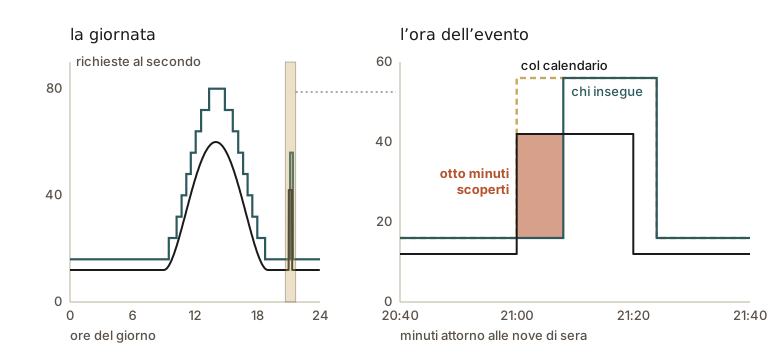
Fig. 36.17 La giornata simulata e l’ora attorno all’evento delle nove. Chi insegue il traffico vede il salto quando arriva, chiama le repliche, e le ha pronte otto minuti dopo: in mezzo la capacità non basta. Col calendario le stesse repliche si chiamano otto minuti prima, e il salto le trova accese.#
import numpy as np

MU = 8.0          # richieste al secondo che una replica serve dentro le promesse
MIRA = 0.8        # l'autoscaler vuole ogni replica all'80% della sua capacità

# Una giornata, minuto per minuto: le richieste al secondo in arrivo. La gobba
# del pomeriggio è un polinomio e non un'esponenziale, così i conti sono solo
# somme e prodotti e danno gli stessi bit su qualunque processore.
minuto = np.arange(1440)
x = (minuto - 14 * 60) / 300
arrivi = 12 + 48 * np.clip(1 - x**2, 0, None) ** 2
evento = (minuto >= 21 * 60) & (minuto < 21 * 60 + 20)       # venti minuti di picco
arrivi = arrivi + 30 * evento

def servono(tasso, riserva):
    return int(np.ceil(tasso / (MIRA * MU))) + riserva

def giornata(nome, avvio, riserva=0, fisse=None, calendario=False):
    """Repliche minuto per minuto; ognuna è pronta `avvio` minuti dopo la chiamata."""
    pronte = np.zeros(1440, dtype=int)
    pagate = np.zeros(1440, dtype=int)             # anche quelle che si stanno avviando
    chiamate = []                                  # i minuti in cui saranno pronte
    n = fisse if fisse is not None else servono(arrivi[0], riserva)
    ultime = [n] * 5                               # le ultime cinque raccomandazioni
    for m in range(1440):
        n += chiamate.count(m)
        chiamate = [p for p in chiamate if p > m]
        if fisse is None:
            # si guarda il traffico di adesso; col calendario, anche quello di
            # fra `avvio` minuti, perché gli eventi annunciati si conoscono prima
            davanti = arrivi[min(m + avvio, 1439)] if calendario else 0
            voglio = servono(max(arrivi[m], davanti), riserva)
            ultime = ultime[1:] + [voglio]
            if voglio > n + len(chiamate):         # salire: subito
                chiamate += [m + avvio] * (voglio - n - len(chiamate))
            elif max(ultime) < n and not chiamate: # scendere: dopo cinque minuti
                n = max(ultime)
        pronte[m], pagate[m] = n, n + len(chiamate)
    capacita = pronte * MU
    oltre = np.maximum(arrivi - capacita, 0)
    servite = np.minimum(arrivi, capacita)
    # con una fila vera l'eccesso passa al minuto dopo: per quanti minuti resta?
    arretrato, in_fila = 0.0, 0
    for m in range(1440):
        arretrato = max(0.0, arretrato + (arrivi[m] - capacita[m]) * 60)
        in_fila += arretrato > 0
    print(f"{nome:<27}{pagate.sum() / 60:7.1f}{(oltre > 0).sum():7d}{in_fila:8d}"
          f"{oltre.sum() / arrivi.sum():8.2%}{servite.sum() / capacita.sum():7.1%}")

print(f"{'politica':<27}{'ore':>7}{'minuti':>7}{'in fila':>8}{'oltre':>8}{'uso':>7}")
giornata("sempre al picco", 0, fisse=int(np.ceil(arrivi.max() / MU)))
giornata("insegue, avvio in 1 min", 1)
giornata("insegue, avvio in 8 min", 8)
giornata("8 min, 3 repliche di scorta", 8, riserva=3)
giornata("8 min, col calendario", 8, calendario=True)

# quante repliche chiede il salto delle nove, con la mira dell'80%
print(f"\nrepliche chieste: {servono(arrivi[21 * 60 - 1], 0)} alle 20:59, "
      f"{servono(arrivi[21 * 60], 0)} alle 21:00")
politica                       ore minuti in fila   oltre    uso
sempre al picco              192.0      0       0   0.00%  36.1%
insegue, avvio in 1 min       94.4      1       2   0.08%  73.5%
insegue, avvio in 8 min       94.4      8      20   0.63%  74.3%
8 min, 3 repliche di scorta  166.4      8       8   0.05%  42.0%
8 min, col calendario         96.1      0       0   0.00%  73.4%

repliche chieste: 2 alle 20:59, 7 alle 21:00
Le colonne sono le ore di replica pagate nella giornata (anche quelle in cui una replica si sta avviando, perché la scheda è già a nolo), i minuti scoperti, in cui le repliche pronte non bastano, i minuti con richieste ancora in fila se l’eccesso di un minuto passa al successivo, la quota di richieste arrivate quando non c’era posto (in fila oltre le promesse, o respinte) e l’uso medio, cioè le richieste servite divise per quelle che le repliche pronte avrebbero potuto servire.
Tenere accese tutto il giorno le otto repliche del picco non lascia indietro nessuno e costa 192 ore, con un uso del 36,1%: quasi due ore pagate su tre servono a stare fermi. E lo fa senza margine, perché al picco quelle otto lavorano al 94%; con la stessa mira dell’80% dell’autoscaler ne servirebbero dieci.
Inseguire il traffico dimezza il conto, 94,4 ore, e l’uso sale attorno al 74%. Ma l’evento delle nove arriva tutto insieme, e ogni minuto di avvio diventa un minuto scoperto: con un avvio da un minuto se ne perde uno, con otto se ne perdono otto (Fig. 36.17). Lo 0,63% delle richieste della giornata trova la porta stretta, e le ore pagate restano le stesse.
Tre repliche di scorta, accese per tutta la giornata, riducono il danno allo 0,05% al prezzo di 72 ore in più (166,4 contro 94,4, cioè tre repliche per ventiquattr’ore), ma i minuti scoperti restano otto. La scorta è scelta apposta più piccola del salto: l’evento porta le repliche richieste da due a sette, cinque in più, e le cinque accese prima delle nove (le due della sera più le tre di scorta) reggono 40 richieste al secondo contro le 42 dell’evento.
Il calendario chiude il buco quasi gratis, 96,1 ore contro 94,4, perché accende le repliche otto minuti prima di un evento che conosceva. Vale per gli eventi annunciati. Per quelli che nessuno ha messo in calendario, un avvio più corto accorcia il buco senza chiuderlo, e lo chiude soltanto una scorta grande quanto il salto.
I minuti scoperti contano ogni minuto per conto suo, come se le richieste in eccesso sparissero. Con una fila vera, che se le porta dietro, il buco dura di più, ed è la colonna «in fila»: con l’avvio da otto minuti le richieste restano arretrate per venti minuti, perché dopo il salto le repliche nuove devono smaltire anche l’arretrato; con l’avvio da un minuto, per due.
Quanto costa un token#
Le ore di replica sono l’unità giusta perché si paga a ore: una replica accesa costa lo stesso per ogni ora in cui resta accesa, qualunque cosa faccia. Il costo di un token, la grandezza con cui un servizio si vende e si confronta, è quindi un rapporto fra quanto costa un’ora e quanti token si servono in quell’ora, e il denominatore dipende da tutte le scelte fatte fin qui.
Una centrale di punta, di quelle che si accendono solo nelle ore di massima domanda, vende la corrente più cara di tutte. Produrla non le costa di più: l’impianto però va pagato tutto l’anno, e lei lavora poche centinaia di ore. Il prezzo dell’impianto si divide per poche ore, e ogni kilowattora se ne porta dietro una fetta grossa.
Con le schede il conto è lo stesso, ed è per questo che nella giornata simulata la colonna dell’uso conta più delle altre. Prendiamo una replica su una scheda sola, che costa due euro l’ora (un numero messo lì per fare il conto, non un listino) e che, piena, genera 2.560 token al secondo: in un’ora ne produce 9,2 milioni, e il milione le costa 2 diviso 9,2, circa 21,7 centesimi. Se lavora al 36%, come chi tiene accese tutto il giorno le repliche del picco, gli stessi due euro si dividono per poco più di un terzo dei token, e il milione costa 21,7 diviso 0,36, cioè 60 centesimi. Nessuno ha cambiato modello né scheda: sono cambiate soltanto le ore pagate per stare fermi.
C’è anche un modo di pagare meno l’ora, e la rete elettrica conosce pure questo. Un’acciaieria può comprare corrente interrompibile: le costa meno, e in cambio accetta che il gestore gliela stacchi con un preavviso brevissimo quando la rete è in difficoltà. Conviene a chi sa fermarsi senza rovinare il lavoro in corso. Le schede prerilasciabili, che il fornitore può riprendersi quando gli servono, sono la stessa offerta: costano molto meno, e chi le noleggia accetta di restituirle con qualche secondo o qualche minuto di avviso. Per un servizio che risponde, il lavoro in corso sono le conversazioni aperte con tutti i loro appunti: se la scheda sparisce, quelle risposte vanno ricominciate su un’altra, e chi aspettava aspetta il doppio.
Il conto è fra lo sconto e il lavoro da rifare. Con uno sconto del 60% si paga il 40% del prezzo, cioè 0,4; se il 10% del lavoro va buttato, ne arriva a buon fine il 90%, cioè 0,9. Un token servito costa allora 0,4 diviso 0,9 del prezzo pieno, il 44%, e conviene. Con uno sconto del 20% e metà del lavoro buttato fa 0,8 diviso 0,5, il 160%, e non conviene. Il lavoro buttato si abbassa usando il preavviso per mettere in salvo quello aperto, fissando fin dove ciascuna risposta era arrivata per riprenderla da lì. E sotto resta sempre una base di schede normali capace di reggere da sola il minimo.
Siano \(C_{\text{ora}}\) il prezzo orario di una replica, \(\nu^\ast\) i token generati al secondo che la replica sostiene dentro le promesse (la capacità \(\mu^\ast\) per il numero medio di token per risposta) e \(\bar\rho\) l’utilizzazione media, il rapporto fra i token serviti e quelli che le repliche accese avrebbero potuto servire. Il costo per token generato è
Con \(C_{\text{ora}} = 2\) € (un valore d’esempio) e \(\nu^\ast = 2560\) token/s (64 sequenze a 40 token/s), a \(\bar\rho = 1\) si ha \(c = 2/(3600 \cdot 2560) \approx 2{,}2 \cdot 10^{-7}\) €, circa 0,22 € per milione; a \(\bar\rho = 0{,}36\), circa 0,60 €. Il fattore \(1/\bar\rho\) è il prezzo della capacità in eccesso, e raccoglie in un numero tutte le scelte precedenti: il margine \(1 - \rho^\ast\), la riserva per il ritardo d’avvio, la finestra che scende piano, la replica calda tenuta contro la scala a zero. La formula addebita l’ora intera ai soli token generati; ripartirla anche sui token letti in prefill richiede una regola, e quella naturale pesa ciascuna fase per il tempo di scheda che occupa, tenendo conto che il prefill è compute-bound e si raccoglie in mazzi di migliaia di token mentre il decode è memory-bound. I listini, del resto, prezzano di solito in modo diverso i token in ingresso e quelli in uscita, e scontano quelli d’ingresso trovati nella cache del prefisso.
Le istanze prerilasciabili (spot, preemptible) vendono la capacità inutilizzata del fornitore con uno sconto \(d\), e possono essere revocate con un preavviso \(T_{\text{preavviso}}\) di secondi o minuti. Nell’addestramento il rimedio è il checkpoint periodico. Nel serving lo stato che si perde è la KV cache delle richieste in volo: ricostruirla vuol dire rifarne il prefill, con un costo proporzionale al contesto accumulato, e far pagare di nuovo il TTFT a chi aspettava. Se \(\omega\) è la frazione di lavoro perso o rifatto, il costo effettivo è
conveniente finché \(1 - d < 1 - \omega\), cioè finché lo sconto supera la quota di lavoro buttato; nel lavoro buttato entra anche l’avvio a freddo della replica che prende il posto di quella revocata. SpotServe [MSD+24] abbassa \(\omega\) in tre modi: riadatta la configurazione di parallelismo al numero di istanze disponibili, pianifica la migrazione come un accoppiamento bipartito (con l’algoritmo di Kuhn e Munkres) che minimizza i dati da spostare, e usa il preavviso per fissare l’avanzamento di ogni richiesta a grana fine, così che dopo la revoca la si riprenda da dove era arrivata. Nelle misure degli autori, su tracce reali di revoche, il costo scende del 54% rispetto alle sole istanze normali. Il disegno che ne esce è a due strati: una base di istanze normali dimensionata sul minimo del traffico e sulla quota che non tollera interruzioni, e la parte variabile su istanze prerilasciabili.
Quanto della scheda si usa davvero#
Il costo per token dice quanto si paga, e resta da sapere quanto la scheda potrebbe dare ancora. Lo si vede confrontando quello che fa con quello che potrebbe fare. L’utilizzazione dei FLOP del modello (MFU, la quota dei conti possibili che la scheda sta facendo davvero), la misura su cui si giudica l’addestramento, applicata alla generazione parola per parola, il decode, dà un numero molto basso: il 4% nell’esempio che segue. Basso, qui, non vuol dire sprecato.
Un furgone ha due limiti, e sulla fiancata c’è scritto solo il primo: quanti chili porta. Il secondo è quanto spazio c’è dentro. Carico di mattoni, finisce il peso molto prima dello spazio; carico di cuscini di piume, lo spazio è pieno quando la bilancia segna un ventesimo della portata. Un ispettore che giudicasse il furgone dei cuscini dal peso lo troverebbe sfruttato al 5% e scriverebbe «spreco». Avrebbe torto, perché non ci sta un cuscino in più.
Una scheda ha gli stessi due limiti, i due tetti visti con la memoria della GPU. I chili sono i conti che sa fare in un secondo; lo spazio è quanti numeri riesce a farsi arrivare dalla memoria in un secondo. Addestrare un modello, o leggere un prompt lungo, è un carico di mattoni: tanti conti per ogni numero portato, e il limite è il peso. Generare una parola alla volta è un carico di piume: per ogni parola si rilegge tutto il modello e ci si fa sopra pochissimi conti, e il limite è lo spazio.
Per questo un servizio si giudica con due misure, una per limite. La prima dice che quota dei conti possibili si sta facendo, la seconda che quota della velocità della memoria si sta usando. Quando si genera una parola alla volta la prima esce sempre bassa: per un modello medio che scrive per sessantaquattro persone insieme, sul 4%. Non segnala nessun difetto, ed è la seconda a dire quanto resta da guadagnare.
Si guadagna comprimendo le piume, cioè scrivendo i numeri del modello con meno cifre: il carico è sempre lo stesso modello, ma occupa meno spazio, e ogni viaggio, cioè ogni parola, dura meno. L’altra strada sembrerebbe quella di caricare più richieste nello stesso giro, ma funziona a metà. Il modello, riletto una volta, serve a tutte, e su quella parte il carico si fa più denso. Ma ogni richiesta porta con sé i propri appunti, che vanno riletti anche loro a ogni parola: sono altri cuscini, che occupano spazio e non pesano. Con conversazioni lunghe gli appunti diventano la parte più grossa del carico, e il furgone resta pieno di piume comunque lo si carichi. Per questo, nella generazione, conta quasi sempre la seconda misura, e si guadagna soprattutto rendendo più corti gli appunti.
L’MFU (model FLOPs utilization), introdotta per l’addestramento [CND+23] e già incontrata nel parallelismo distribuito, è il rapporto fra i FLOP al secondo che il modello richiede e il picco della scheda. In inferenza una passata costa circa \(2N_p\) FLOP per token, quindi a \(\nu\) token al secondo
con \(P_{\text{picco}}\) il picco di calcolo in FLOP/s, lo stesso simbolo del roofline di La memoria. Per \(N_p = 8\cdot10^9\) parametri, \(\nu = 2560\) token/s (64 sequenze a 40 token/s) e una scheda da \(P_{\text{picco}} = 10^{15}\) FLOP/s densi in 16 bit: \(\text{MFU} = 2 \cdot 8\cdot10^9 \cdot 2560 / 10^{15} \approx 4{,}1\%\). Il decode sta sotto il ginocchio del roofline, e il vincolo è la banda. L’indice pertinente è l’utilizzazione di banda del modello (MBU, model bandwidth utilization) [AQS+23], il rapporto fra i byte che ogni passo deve leggere, per passi al secondo, e la banda di picco:
con \(M_w\) i byte dei pesi, letti una volta per passo qualunque sia il mazzo, e \(M_{\text{kv}}\) quelli della KV cache di tutte le sequenze del mazzo. Con i pesi in bf16, \(M_w = 16\) GB, e un TPOT di 25 ms, i soli pesi chiedono \(16/0{,}025 = 640\) GB/s: su \(B_{\text{picco}} = 3\) TB/s, il 21%. La KV cache aggiunge la sua parte, che a 64 sequenze con qualche migliaio di token di contesto è dello stesso ordine dei pesi. Una MBU lontana dal 100% nel decode indica passi che non saturano la banda: kernel troppo piccoli, tempi di lancio non coperti, sincronizzazioni fra schede.
Le leve si leggono sul roofline, e il batching ha un limite che si vede solo contando anche la cache. In un passo con \(b\) sequenze di contesto \(n_{\text{ctx}}\) si fanno circa \(2N_p b\) FLOP e si leggono \(M_w + b\,n_{\text{ctx}}\,m_{\text{kv}}\) byte, con \(m_{\text{kv}}\) i byte di cache per token, quindi
Il batching ammortizza i pesi, non la cache, che ogni sequenza porta con sé. Con \(m_{\text{kv}} = 128\) KiB (GQA a otto teste di chiavi e valori) e \(n_{\text{ctx}} = 2000\) il limite è \(1{,}6\cdot10^{10}/(2000 \cdot 131\,072) \approx 61\) FLOP/byte, contro un ginocchio a \(P_{\text{picco}}/B_{\text{picco}} \approx 333\): nessun mazzo porta il decode oltre il ginocchio, e l’MFU resta sotto \(61/333 \approx 18\%\). Ci si arriva solo con contesti sotto i trecentosettanta token circa. Nel decode, quindi, l’indice pertinente resta quasi sempre la MBU, e le leve sono quelle che tolgono byte: la quantizzazione dei pesi, che alza il throughput a MBU costante, e le tecniche che rimpiccioliscono la cache (GQA, MLA, cache quantizzata). L’MFU torna l’indice giusto nel prefill di centinaia di token o più. E conta i soli FLOP del modello: una ricomputazione (di attivazioni scartate, o di una KV cache persa) consuma picco senza entrare nel numeratore, ed è giusto così, perché è lavoro che non produce token.
Queste scelte si tengono l’una con l’altra, ed è la ragione per cui vanno decise insieme. La capacità, misurata con un carico che arriva al suo ritmo come quello vero, fissa quanto regge una replica; la metrica dell’autoscaler e il tempo di avvio fissano quanta capacità in eccesso bisogna pagare per rispettare le promesse; e il costo per token è il conto finale di tutte e due le cose, diviso per quanto bene la scheda viene sfruttata dentro ogni passo.
Da ricordare
La capacità di una replica si misura facendo arrivare clienti finti a un ritmo fissato, come i clienti veri, e alzandolo finché le promesse saltano. Dieci amici che rientrano in fila solo dopo essere stati serviti rallentano con il panettiere, e la fila lunga non la vedranno mai.
Per decidere quante repliche accendere non si guarda quanto lavora la scheda, che con il mazzo continuo segna il pieno anche con una richiesta sola: si guardano la fila e le richieste aperte, che fanno il mestiere della frequenza nella rete elettrica. La regola è in proporzione; si sale subito, si scende piano, e si contano le repliche già in arrivo.
Una replica nuova arriva dopo un avvio a freddo, dominato dal tempo di portare i pesi nella scheda: minuti da un archivio in rete, pochi secondi se sono già vicini. Durante l’avvio il traffico continua a salire, e la riserva che serve è la rampa per il ritardo. Un salto improvviso non lo copre nessuna riserva ragionevole: lo coprono solo un avvio cortissimo, come quello di Dinorwig, o un calendario che lo fa vedere arrivare.
Nella giornata simulata, inseguire il traffico dimezza le ore pagate rispetto a tenere acceso il picco; otto minuti di avvio lasciano otto minuti scoperti, tre repliche di scorta costano 72 ore e non li tolgono, il calendario li toglie quasi gratis.
Il costo di un token è il prezzo dell’ora diviso per i token serviti in quell’ora: le ore pagate per stare fermi lo moltiplicano, come per le centrali di punta. Le schede prerilasciabili costano meno e possono sparire con poco preavviso; convengono se lo sconto supera il lavoro da rifare, e sopra una base di schede normali.
Nella generazione parola per parola la quota di conti usati esce sempre bassa, e basso non vuol dire sprecato: il furgone è pieno di piume. Quanto resta da guadagnare lo dice la quota della velocità della memoria.
Da ricordare
La capacità \(\mu^\ast\) è il massimo tasso d’arrivo con conformità sopra la quota dichiarata, misurato con un generatore a ciclo aperto su un campione del traffico vero. Il ciclo chiuso obbedisce a \(\lambda = N_u/(W + T_{\text{pausa}})\), si adegua al servente e omette le richieste che avrebbero trovato la coda [SWHB06]; è corretto solo per popolazioni fisse.
L’autoscaler è un controllo proporzionale, \(N_r' = \lceil N_r \cdot \text{metrica}/\text{bersaglio} \rceil\), con tolleranza e isteresi asimmetrica (in Kubernetes: sale subito, scende sul massimo degli ultimi 300 s).
utilization.gpusatura con il continuous batching; la metrica giusta è la concorrenza per replica, \(L_r = \lambda W/N_r\), o la coda \(L_q\), stabile se e solo se \(\lambda < N_r\mu\). Le repliche in avvio vanno contate.Quando i pesi arrivano dalla rete, \(T_{\text{avvio}}\) è dominato da \(M_w/B_{\text{canale}}\) (140 GB: 140 s a 1 GB/s, 2,8 s dalla memoria dell’host), e ServerlessLLM ne sfrutta la gerarchia [FXH+24]; con i pesi vicini contano anche il riscaldamento e l’attesa della macchina. Una rampa chiede una riserva \(\lceil \dot\lambda_{\max} T_{\text{avvio}} / (\rho^\ast\mu^\ast)\rceil\), un gradino \(\Delta\lambda\) una riserva grande quanto il salto; accorciare l’avvio riduce la scopertura a \(T_{\text{avvio}}\), solo la previsione la annulla. La scala a zero scambia il costo dei periodi vuoti con \(T_{\text{avvio}}\) sul primo TTFT.
Il costo per token generato è \(c = C_{\text{ora}}/(3600\,\nu^\ast\bar\rho)\): la capacità in eccesso entra come \(1/\bar\rho\), e le repliche si pagano anche mentre si avviano. Le istanze prerilasciabili convengono finché \(d > \omega\); SpotServe riduce \(\omega\) con riparallelizzazione, migrazione a costo minimo e ripresa dal punto raggiunto [MSD+24].
Nel decode l’MFU \(= 2N_p\nu/P_{\text{picco}}\) [CND+23] è bassa (4% nell’esempio), e il batching non la porta al ginocchio con contesti lunghi, perché ammortizza i pesi e non la cache: l’intensità tende a \(2N_p/(n_{\text{ctx}} m_{\text{kv}})\). L’indice pertinente è la MBU, \((M_w + M_{\text{kv}})/(\text{TPOT}\cdot B_{\text{picco}})\) [AQS+23], e le leve sono quelle che tolgono byte.
Il conto delle repliche dà per scontato che, una volta accese, funzionino. In produzione non è così: un fornitore rallenta, una replica muore a metà di una risposta, un cliente manda in un minuto il traffico di un’ora. Che cosa si mette fra le applicazioni e i modelli per reggere tutto questo è l’argomento di Davanti ai modelli.