



Il conto di un compito: token, cache e attesa#
Su HumanEval, i 164 problemi di programmazione che il loop engineering ha usato come esempio di controllo automatico, nel 2024 si confrontavano agenti sempre più elaborati: uno esplorava un albero di tentativi, un altro si scriveva la critica dei propri errori prima di riprovare, un terzo seguiva l’esecuzione del programma un pezzo alla volta per trovare dove sbagliava. Sayash Kapoor, Benedikt Stroebl, Zachary Siegel, Nitya Nadgir e Arvind Narayanan li hanno rimessi in fila accanto alla cosa più semplice che si possa fare con un modello, chiedergli di nuovo.
Una loro strategia di base chiama GPT-4 fino a cinque volte, si ferma appena il programma supera i test d’esempio del problema e dal secondo tentativo alza la temperatura (quanto il modello si concede parole meno probabili), da zero a 0,3 e poi a 0,5, perché il tentativo dopo non ripeta il primo. Ogni sistema ha girato cinque volte su tutti i problemi, e accanto alla quota di problemi risolti gli autori hanno messo quanto era costato [KSS+24].
La strategia che riprova risolveva il 93,2% dei problemi con 2,45 dollari per tutti e 164, ai prezzi dell’aprile 2024. Il migliore degli agenti, quello che segue l’esecuzione (LDB, con GPT-4), arrivava al 93,3% con 6,36 dollari: un decimo di punto in più, meno di quanto ciascuno oscillava da un’esecuzione all’altra, per più del doppio della spesa. LATS, l’agente dell’albero, si fermava all’88,0% con 134,50 dollari, cinquantacinque volte la strategia che riprova; Reflexion, l’agente della critica scritta, all’87,8% con 3,90.
Un’altra strategia di base partiva da un modello piccolo e saliva di modello in modello, fino a GPT-4, finché i test non passavano: 85,0% con 27 centesimi. Su due assi, costo e quota risolta, questi sistemi disegnano un fronte di Pareto, l’insieme di quelli che nessun altro batte su tutti e due gli assi insieme: ci stanno la scalata di modelli, la strategia che riprova e LDB, mentre LATS e Reflexion restano fuori, perché la strategia che riprova risolve di più e costa meno.
Gli autori lasciano aperta la domanda se esplorare, criticarsi e seguire l’esecuzione servano davvero, e concludono che una quota di problemi risolti, riportata da sola, non distingue un’idea nuova da un modello chiamato più volte.
Per un agente che lavora un’ora su un repository la domanda è la stessa, e più acuta: il costo è quello di un compito intero, decine o centinaia di chiamate al modello che rileggono ciascuna il contesto accumulato, più gli strumenti, i tentativi falliti, i controlli.
L’anatomia dell’harness ha fissato la grandezza giusta, il costo per compito risolto \(c(H)/s(H)\), cioè la spesa media di un compito con l’harness \(H\) divisa per la probabilità che riesca; il passaggio di consegne ha contato i token che una sessione rilegge, senza prezzi né cache. Il costo di un compito diventa così un oggetto di progetto, con i suoi fattori, i suoi sconti e i loro contro-costi, e con una dimensione che il conto in token non vede, il tempo.
Il conto come prodotto#
La spesa in token di un compito si lascia scrivere come un prodotto,
dove una richiesta è un messaggio dell’utente con il lavoro che l’agente fa prima di rispondere, un passo è un’iterazione del ciclo (una chiamata al modello e l’esecuzione di ciò che chiede), e ogni rapporto è fra totali, così che il prodotto torna sempre. Ad esempio, tre richieste da dieci passi, con ventimila token letti a passo, fanno seicentomila token. I fattori non sono indipendenti (raggruppare le letture toglie passi e allunga ciascuno), ma ognuno indica una leva.
Le richieste pesano più di quanto sembri, perché dentro una sessione ognuna rilegge tutte quelle prima; l’utente torna quando l’agente ha capito male, si è fermato a metà o ha consegnato senza controllare, e un piano confermato prima di agire e il collaudo fatto da sé tolgono i ritorni alla radice.
I passi scendono quando una chiamata fa il lavoro di più chiamate (cinque file letti in un passo, un piano scritto una volta sola come nel metodo ReWOO della sezione sulle architetture degli agenti, una decisione di routine scritta nel codice dell’harness), purché le azioni raggruppate non dipendano l’una dall’altra. I token per passo scendono tagliando gli esiti degli strumenti, o dandoli a pezzi, come chiede la sezione sugli strumenti, e chiedendo un’uscita breve.
Infine il prezzo scende con la cache del prefisso e con il lavoro differito, che i fornitori (le aziende che vendono l’accesso ai modelli) fanno pagare meno quando può aspettare ore.
Prima delle leve viene la contabilità. Un bilancio onesto somma tutte le chiamate al modello: quelle dell’agente principale, e quelle del modello che pianifica, di quello che sceglie a chi passare il lavoro, di quello che scrive i riassunti, di quello che controlla, degli agenti secondari a cui si delega. Separa i token letti dalla cache, quelli letti freschi e quelli scritti, che hanno prezzi diversi (i token del ragionamento, che il modello scrive prima di rispondere, si pagano come scritti), e aggiunge strumenti, esecuzione e tempo delle persone: è la somma di ciò che gli intervalli di una traccia registrano, chiamata per chiamata.
A parte sta la contabilità del progetto (le traiettorie, cioè le sequenze di passi di compiti già svolti, raccolte per addestrare un modello più piccolo, la ricerca di un modo di lavorare migliore, le batterie di valutazione). Ad esempio, un modo di lavorare che costa mille da trovare e fa risparmiare due a compito si ripaga dopo cinquecento compiti.
La cache del prefisso, dal lato di chi paga#
Il calcolo del passaggio di consegne trattava ogni rilettura come se costasse uguale. I fornitori, invece, riusano i calcoli fatti su un prefisso già visto, la parte iniziale del contesto identica a quella di una richiesta di poco prima, e la fanno pagare una frazione del prezzo pieno: la sezione sul context engineering ha descritto il meccanismo e la regola che ne segue, in testa ciò che non cambia. Per un agente la differenza pesa molto, perché a ogni passo il contesto è quello del passo prima più poche migliaia di token.
Il programma del passaggio di consegne, con gli stessi numeri, riceve due prezzi illustrativi, perché i listini cambiano: un token letto dalla cache costa 0,1 di un token letto fresco, uno scritto dal modello 5, e il costo si conta in token freschi equivalenti, cioè in token letti a prezzo pieno. Alle strategie di prima si aggiunge la ripartenza con una riga in testa al contesto che riporta l’ora corrente.
# Il modello a numeri tondi del passaggio di consegne, non una misura, con in
# più la cache del prefisso e un prezzo. Il contesto di una chiamata è una fila
# di pezzi (nome, token): due pezzi con lo stesso nome sono identici token per
# token. Ipotesi: la cache tiene il contesto della chiamata precedente e non
# scade fra un'iterazione e l'altra; scriverci costa quanto leggere un token
# fresco; il registro lo aggiorna l'ultima iterazione di ogni sessione, dentro
# la sua uscita.
FINESTRA, FISSO, CRESCITA, ITERAZIONI = 100_000, 5_000, 3_000, 60
RIASSUNTO, REGISTRO, PER_SESSIONE = 4_000, 2_000, 15
USCITA = 500            # dei 3.000 di un'iterazione, scritti dal modello
ORA = 20                # una riga con l'ora corrente, se la si mette in testa
# Prezzi illustrativi, in token freschi equivalenti: i listini cambiano.
P_CACHE = 0.1           # un token letto dalla cache
P_USCITA = 5            # un token scritto dal modello

def chiamate(strategia, ora=False):
    """Le chiamate di un compito: per ciascuna il contesto e i token scritti."""
    elenco, storia = [], []
    for t in range(ITERAZIONI):
        if strategia == "ripartenza" and t % PER_SESSIONE == 0:
            storia = [(f"registro {t}", REGISTRO)]       # sessione nuova
        testa = [(f"ora {t}", ORA)] if ora else []
        contesto = testa + [("fisso", FISSO)] + storia
        if strategia == "nessuna" and sum(n for _, n in contesto) > FINESTRA:
            break                                        # non ci sta più
        soglia = {"80%": 0.8, "50%": 0.5}.get(strategia)
        if soglia and sum(n for _, n in contesto) > soglia * FINESTRA:
            elenco.append((contesto, RIASSUNTO))   # la chiamata che riassume
            storia = [(f"riassunto {t}", RIASSUNTO)]
            contesto = testa + [("fisso", FISSO)] + storia
        elenco.append((contesto, USCITA))
        storia = storia + [(f"iterazione {t}", CRESCITA)]   # risposta ed esito
    return elenco

def comune(prima, dopo):
    """I token del prefisso comune: i pezzi uguali dall'inizio, in fila."""
    h = 0
    for a, b in zip(prima, dopo):
        if a != b:
            break
        h += a[1]
    return h

def conto(elenco, p_cache=P_CACHE):
    """Token letti, di cui dalla cache e freschi, token scritti, e il costo."""
    letti = cache = scritti = 0
    prima = []
    for contesto, u in elenco:
        letti += sum(n for _, n in contesto)
        cache += comune(prima, contesto)   # il prefisso della chiamata prima
        scritti += u
        prima = contesto
    freschi = letti - cache
    costo = p_cache * cache + freschi + P_USCITA * scritti
    return letti, cache, freschi, scritti, costo

def it(x, cifre=0):                      # 1648000 -> 1.648.000, 0.07 -> 0,07
    s = f"{x:,.{cifre}f}"
    return s.replace(",", "_").replace(".", ",").replace("_", ".")

print(f"{'':25}{'letti':>10}{'in cache':>11}{'freschi':>10}{'scritti':>8}"
      f"{'costo':>10}{'senza cache':>12}")
casi = {}
for nome, s, ora in [("compattazione all'80%", "80%", False),
                     ("compattazione al 50%", "50%", False),
                     ("ripartenza", "ripartenza", False),
                     ("ripartenza, ora in testa", "ripartenza", True)]:
    v = casi[nome] = conto(chiamate(s, ora))
    senza = conto(chiamate(s, ora), p_cache=1)[4]
    print(f"{nome:25}" + "".join(f"{it(x):>{w}}" for x, w in
          zip(v, (10, 11, 10, 8, 10))) + f"{it(senza):>12}")

_, c, f, u, costo = casi["ripartenza"]
print(f"ripartenza, il costo: {it(P_CACHE * c)} dalla cache, {it(f)} freschi, "
      f"{it(P_USCITA * u)} scritti")
print(f"l'ora in testa lo moltiplica per "
      f"{it(casi['ripartenza, ora in testa'][4] / costo, 1)}")

# Sotto quale prezzo della cache compattare tardi costa meno che presto?
_, c8, f8, u8, _ = casi["compattazione all'80%"]
_, c5, f5, u5, _ = casi["compattazione al 50%"]
pari = (f5 + P_USCITA * u5 - f8 - P_USCITA * u8) / (c8 - c5)
print(f"all'80% costa meno che al 50% se la cache costa meno di {it(pari, 3)}")

# Senza strategie, fino all'iterazione in cui il contesto non ci sta più.
el = chiamate("nessuna")
_, c, f, u, _ = conto(el)
print(f"nessuna strategia, {len(el)} iterazioni: "
      f"{it(P_CACHE * c)} dalla cache, "
      f"{it(f)} freschi, {it(P_USCITA * u)} scritti")
cresce = [conto(el, p)[4] / conto(el[:16], p)[4] for p in (P_CACHE, 1)]
print(f"{len(el)} iterazioni costano {it(cresce[0], 1)} volte 16 con la "
      f"cache, {it(cresce[1], 1)} senza")

# Dove il termine quadratico raggiunge quelli lineari, all'ordine principale.
lineari = CRESCITA + P_CACHE * FISSO + P_USCITA * USCITA
print(f"il quadrato raggiunge i termini lineari a "
      f"{it(2 * lineari / (P_CACHE * CRESCITA))} iterazioni con la cache, a "
      f"{it(2 * (FISSO + P_USCITA * USCITA) / CRESCITA)} senza")
                              letti   in cache   freschi scritti     costo senza cache
compattazione all'80%     2.538.000  2.348.000   190.000  38.000   614.800   2.728.000
compattazione al 50%      1.864.000  1.666.000   198.000  46.000   594.600   2.094.000
ripartenza                1.680.000  1.499.000   181.000  30.000   480.900   1.830.000
ripartenza, ora in testa  1.681.200          0 1.681.200  30.000 1.831.200   1.831.200
ripartenza, il costo: 149.900 dalla cache, 181.000 freschi, 150.000 scritti
l'ora in testa lo moltiplica per 3,8
all'80% costa meno che al 50% se la cache costa meno di 0,070
nessuna strategia, 32 iterazioni: 155.000 dalla cache, 98.000 freschi, 80.000 scritti
32 iterazioni costano 2,6 volte 16 con la cache, 3,6 senza
il quadrato raggiunge i termini lineari a 40 iterazioni con la cache, a 5 senza
I token letti sono quelli di prima (2.538.000, 1.864.000, 1.680.000); la colonna «senza cache» è più alta perché ci aggiunge i token scritti, a cinque volte tanto. Con la cache le distanze si accorciano e l’ordine resta quello di prima: le due compattazioni, che senza cache costavano 2.728.000 e 2.094.000, costano 614.800 e 594.600, perché i token in più che la prima rilegge passano quasi tutti dalla cache.
Basta però l’ora in testa per perdere tutto: ogni chiamata ha un prefisso diverso fin dal primo token, e la ripartenza costa 3,8 volte tanto, quanto costerebbe senza cache. Per la stessa ragione, con la cache, accorciare un esito vecchio a metà sessione, una leva della sezione sugli strumenti, fa rileggere a prezzo pieno tutto ciò che lo segue.
Torna al tavolo dell’artigiano che a ogni mossa rilegge da capo tutti i fogli (un foglio sta per un pezzo di testo, qualche migliaio di token). La bottega lo paga a fogli: un foglio letto costa una moneta, uno scritto da lui cinque. Mentre legge, l’artigiano prende appunti su un taccuino, e ogni appunto tiene conto dei fogli letti prima: «questa gamba va con il piano del foglio due». Il taccuino è la cache: finita la mossa resta sul banco, e alla mossa dopo, se i fogli cominciano esattamente come prima, l’artigiano non li rilegge, scorre gli appunti, e la bottega paga un decimo di moneta a foglio.
Quei fogli uguali dall’inizio, in fila, sono il prefisso; a prezzo pieno si leggono solo quelli arrivati in fondo. Dieci fogli, nove annotati e uno nuovo, più mezzo foglio di risposta: nove decimi, più una moneta, più due e mezzo, fanno 4,4 monete invece di 12,5. Il taccuino non fa ricordare niente di nuovo; risparmia soltanto la rilettura.
Gli appunti valgono solo fino al primo foglio cambiato. Se il foglio due cambia, l’appunto sulla gamba non vale più, e nemmeno quelli dopo, che si appoggiavano a lui: da lì si rilegge tutto, anche per una virgola. I primi fogli, il cartello e l’elenco degli attrezzi, sono quelli dove una modifica costa di più. Chi scrive in cima al primo foglio l’ora esatta fa rileggere tutto a ogni mossa: per chi smonta a ogni pezzo, quasi quattro volte tanto. Lo stesso, dal foglio cambiato in giù, se il capobottega riordina l’elenco degli attrezzi o toglie un foglio vecchio in mezzo alla pila per lasciarci una riga: risparmia quel foglio, e paga a prezzo pieno tutti quelli dopo.
E il taccuino è di chi l’ha scritto, a un altro artigiano non serve; resta sul banco solo qualche minuto, perché chi gestisce i banchi lo porta via per far posto agli altri, e se l’artigiano aspetta troppo che la colla asciughi non lo trova più.
Ne viene una regola di bottega: i fogli nuovi si mettono solo in fondo. L’ora, se serve, si scrive sull’ultimo foglio; un foglio vecchio sbagliato non si corregge, se ne aggiunge uno in fondo che dice la correzione; e l’elenco degli attrezzi resta nell’ordine di sempre.
Il taccuino, però, non ferma la pila: scorrere gli appunti di cento fogli costa dieci volte scorrere quelli di dieci, anche se finché la giornata è corta pesano di più i fogli nuovi e quelli scritti (una giornata doppia costa circa due volte e mezzo, senza taccuino più di tre volte e mezzo).
Anche lo sgombero conviene meno: fa scrivere un riassunto, pagato cinque volte e riletto a prezzo pieno, per risparmiare la rilettura dei fogli vecchi, che con il taccuino costava già poco. Sgomberare a metà tavolo o a tavolo quasi pieno costa quasi lo stesso, e con appunti ancora più economici converrebbe aspettare; smontare a ogni pezzo, che scrive soltanto le poche righe del registro, con calma dopo la dima, resta il modo più economico. Sgomberare serve quando il tavolo è pieno, o quando su un tavolo affollato l’artigiano lavora peggio.
Sia \(C_t\) la sequenza di token che la chiamata \(t\) manda al modello, \(\mathrm{tok}(C_t)\) il loro numero, come nella sezione sugli strumenti, e \(y_t\) il numero di token che il modello scrive. Il server conserva per un tempo limitato la KV cache delle chiamate recenti, come i motori di inferenza che la condividono fra richieste che cominciano allo stesso modo [ZYX+24], e la chiamata \(t\) ne riusa la parte iniziale comune:
dove \(\operatorname{lcp}\) è la lunghezza del più lungo prefisso comune, in token. In unità del prezzo di un token letto fresco, il costo della chiamata è
con \(\eta < 1\) il prezzo relativo di un token letto dalla cache e \(\omega > 1\) quello di un token scritto, ragionamento compreso; il programma usa \(\eta = 0{,}1\) e \(\omega = 5\). È il modello del server, a granularità di token.
Quello che i fornitori fatturano, invece, è più grossolano (contano il prefisso a blocchi, da punti dichiarati nella richiesta e sopra una lunghezza minima, e alcuni fanno pagare di più la scrittura in cache), e il modello lo trascura. L’organizzazione della cache nel server, un albero dei prefissi con le sue regole di sfratto, la racconterà la sezione sulle metriche di servizio nel capitolo su MLOps.
Il riuso esatto chiede l’identità token per token. L’attenzione causale lo permette: come mostra la sezione sull’attenzione in pratica, chiave e valore della posizione \(j\), a ogni strato, non dipendono dai token dopo \(j\). E la stessa dipendenza lo vincola, perché dipendono da tutti i token fino a \(j\): la cache di una chiamata precedente vale fino alla prima posizione in cui le due sequenze differiscono, e per nessuna dopo, qualunque sia la differenza. Un token cambiato in posizione \(j\) costa la rilettura fresca di \(\mathrm{tok}(C_t) - j + 1\) token.
Si noti che la chiave è la sequenza degli identificativi dei token: lo stesso oggetto serializzato con i campi in un altro ordine è un prefisso diverso. E la cache è per modello, perché chiavi e valori dipendono dai pesi: passare a un altro modello a metà traiettoria rilegge tutto a prezzo pieno.
Con la storia accodata e una cache che non scade fra un passo e l’altro, \(\chi_t = \mathrm{tok}(C_{t-1})\) e \(\mathrm{tok}(C_t) - \chi_t = d\), la crescita per iterazione. Con \(\mathrm{tok}(C_t) = \phi + t d\), come nel calcolo del passaggio di consegne, e \(y_t = y\) costante, la somma su \(T\) chiamate è
dove la prima chiamata legge fresco tutto il prefisso fisso \(\phi\). Il termine quadratico ha coefficiente \(\eta d/2\) invece di \(d/2\): la cache abbassa la costante, non l’esponente, come la sezione sul costo del coordinamento dirà per una trascrizione condivisa fra più agenti. È una grandezza di fattura: il numero dei token da calcolare, che con il riuso del prefisso diventa lineare nel numero delle chiamate come mostrerà la sezione sulle metriche di servizio, è un’altra.
La cache sposta però il punto in cui il quadrato domina: all’ordine principale il termine quadratico, circa \(\eta d T^2/2\), raggiunge quelli lineari, circa \(T(d + \eta\phi + \omega y)\), per \(T \approx 2(d + \eta\phi + \omega y)/(\eta d)\), 40 iterazioni con i valori del programma; senza cache, dove anche i token nuovi di ogni iterazione stanno nel termine quadratico, il calcolo analogo è \(2(\phi + \omega y)/d\), 5 iterazioni, contro i 32 che la finestra consente. Dentro la finestra, a quel prezzo, il costo è fatto soprattutto dei termini lineari; in una finestra dieci volte più grande il quadrato torna a dominare.
Rompe la cache tutto ciò che cambia un token prima della fine del prefisso già visto: un’informazione variabile in testa (l’ora, un identificativo), che porta \(\chi_t\) a zero o quasi; uno strumento aggiunto, tolto o riordinato, perché le descrizioni degli strumenti stanno in testa; la compattazione; un’attesa più lunga della durata della cache; e la cronologia modificata, come nella leva della permanenza della sezione sugli strumenti, che accorcia l’esito vecchio di uno strumento. Quella leva risparmia token che costavano \(\eta\) e fa rileggere a prezzo pieno tutti quelli che seguono la voce cambiata: in spesa conviene solo quando \(\eta\) per i token tolti, sommati su tutte le chiamate che seguono, supera \((1 - \eta)\) per i token riletti, che si pagano una volta a ogni modifica. Fatta a ogni passo, la rilettura torna a ogni chiamata e il conto pareggia soltanto con decine di voci già accorciate; accorciando a blocchi, ogni tante iterazioni, la si paga una volta per blocco.
La regola di progetto, fuori da questi tagli, è il log in sola aggiunta: si accodano voci e non se ne modificano, le correzioni sono voci nuove, le informazioni variabili stanno nell’ultima, la serializzazione è deterministica, come per il giornale dell’agente della sezione sull’osservabilità.
Con la cache un taglio costa la scrittura del riassunto al prezzo \(\omega\) e la sua lettura fresca alla chiamata dopo, e risparmia una rilettura che costava già \(\eta\) a token. Il costo di ogni strategia è affine in \(\eta\), con pendenza pari ai token letti dalla cache; da qui la soglia del programma: sotto \(\eta \approx 0{,}07\) la compattazione all’ottanta per cento, che taglia due volte, costa meno di quella al cinquanta, che taglia quattro.
La ripartenza ha meno token in ogni colonna e costa meno a qualunque prezzo, con l’ipotesi a suo favore del registro scritto dentro l’uscita dell’ultima iterazione. La frequenza del taglio, che senza cache fissava il costo, con la cache pesa molto meno, e la compattazione si giustifica con la finestra e con il calo di qualità sui contesti lunghi più che con la spesa.
Ogni risparmio ha un contro-costo#
Ogni leva del conto sposta una parte del costo altrove, e il risparmio che si vede subito non è quello che resta. Ad esempio, la compattazione accorcia il contesto, ma riscrive la cache, e i file che ha tolto, se servono ancora, si rileggono con una chiamata in più; gli agenti secondari tengono pulito il contesto dell’agente principale, ma ciascuno rilegge le istruzioni e i file comuni, e quello che uno ha già capito l’altro lo ricapisce; un modello economico costa meno a passo, ma un suo passo sbagliato può aggiungerne molti dopo.
Il risparmio netto è il lordo meno il contro-costo, e i due si misurano sugli stessi compiti, sulle traiettorie intere: misurato sul solo passo che la leva tocca, il lordo è sempre positivo.
Il costo per compito risolto \(c(H)/s(H)\), la grandezza con cui si fa il bilancio, va contato con cura. Al numeratore va la spesa di tutti i tentativi, falliti compresi, e di ogni controllo; al denominatore i compiti il cui risultato consegnato è davvero giusto, uno per compito, giudicati dai test del banco di prova e non dal verificatore dell’harness, che sbaglia.
Contare i tentativi riusciti renderebbe gratis quelli di troppo. Ad esempio, con tentativi da 1 che riescono una volta su due, chi ne fa sempre dieci spende 10 a compito e ne risolve quasi tutti, circa 10 per compito risolto, ma conta cinque tentativi riusciti a compito e figura a 2, come chi ne fa uno solo. E chi lavora deve saper scegliere da sé quale tentativo consegnare: se sceglie con i test nascosti del banco di prova, usa un controllo che nessuno ha pagato.
Il rapporto, poi, non è definito se nessun compito riesce, e non dice quali compiti sono cambiati. Un programma confronta due harness sugli stessi cento compiti, con gli esiti appaiati.
from math import comb

# Due harness sugli stessi cento compiti, un'esecuzione per compito, esiti
# appaiati: numeri tondi, non una misura. B affida una parte dei passi a un
# modello più economico; A li lascia tutti al modello forte.
ENTRAMBI, SOLO_A, SOLO_B, NESSUNO = 70, 12, 6, 12
COMPITI = ENTRAMBI + SOLO_A + SOLO_B + NESSUNO
SPESA = {"A": 180, "B": 114}     # su tutti i compiti, fallimenti compresi
RIUSCITI = {"A": ENTRAMBI + SOLO_A, "B": ENTRAMBI + SOLO_B}

def it(x, cifre=2):
    return f"{x:.{cifre}f}".replace(".", ",")

for h in "AB":
    s = RIUSCITI[h]
    print(f"{h}: riusciti {s} su {COMPITI}, per tentativo "
          f"{it(SPESA[h] / COMPITI)}, per successo {it(SPESA[h] / s)}")

# McNemar esatto: contano solo i compiti su cui i due esiti differiscono.
n, k = SOLO_A + SOLO_B, min(SOLO_A, SOLO_B)
p = min(1, 2 * sum(comb(n, i) for i in range(k + 1)) / 2 ** n)
print(f"discordanti: {SOLO_A} riusciti solo ad A, {SOLO_B} solo a B, "
      f"p = {it(p)}")
netti = RIUSCITI["A"] - RIUSCITI["B"]
print(f"A spende {SPESA['A'] - SPESA['B']} in più per {netti} successi netti, "
      f"{it((SPESA['A'] - SPESA['B']) / netti)} l'uno")
A: riusciti 82 su 100, per tentativo 1,80, per successo 2,20
B: riusciti 76 su 100, per tentativo 1,14, per successo 1,50
discordanti: 12 riusciti solo ad A, 6 solo a B, p = 0,24
A spende 66 in più per 6 successi netti, 11,00 l'uno
B costa 1,50 per successo e A 2,20: sul rapporto vince B. Ma B risolve 76 compiti e A 82, e se il servizio chiede l’ottanta per cento di successi B ne resta fuori, con il rapporto migliore.
Gli esiti appaiati dicono di più: B perde dodici compiti che A risolveva e ne guadagna sei, e dodici contro sei, sui diciotto compiti in cui i due differiscono, è uno squilibrio che il caso produce spesso, come dodici teste su diciotto lanci di moneta. Il test di McNemar della sezione sugli ensemble, che guarda proprio quei compiti, dà \(p = 0{,}24\) (uno squilibrio così, fra due harness equivalenti, uscirebbe circa una volta su quattro): con cento compiti non si sa nemmeno se B sia peggiore.
Per saperlo servono più compiti, e per sapere dove bisogna aprire i dodici: se sono quelli in cui il modello economico ha sbagliato un passo da cui dipendeva il resto, il risparmio di B viene in parte dall’aver rinunciato a quei compiti. In definitiva, i successi netti danno la domanda giusta: A spende 66 in più per sei successi netti, 11 ciascuno, e conviene se un compito riuscito vale più di 11.
Chi chiamare, e quando smettere#
Scegliere a quale modello mandare una richiesta, l’instradamento che il capitolo su MLOps tratterà dal lato del servizio, dentro un agente si fa passo per passo, e la domanda diventa se un intervento (il modello più forte su questo passo, un tentativo in più, un lavoratore in più) alzi abbastanza la probabilità che il compito intero riesca da valere il suo prezzo. Un passo difficile su cui anche il modello forte sbaglia non merita il modello forte; un passo che sembra facile, ma su cui il modello economico sbaglia abbastanza spesso e da cui dipende tutto il resto, sì.
Si può scegliere prima di chiamare, dai tratti del passo (un router); provare il modello economico e passare al forte quando un controllo lo respinge (una cascata); o guardare anche la traiettoria fin lì e il budget che resta. Nel conto vanno il selettore, i tentativi respinti e il lavoro di recupero.
Valutare una regola così è difficile. La tentazione è prendere una traiettoria registrata con il modello forte, sostituire la sua risposta a un passo con quella del modello economico, e giudicare; ma in una traiettoria vera un’azione diversa produce osservazioni diverse, e da lì tutto il resto.
Ashritha Gonuguntla ha biforcato esecuzioni vere di un agente su SWE-bench Verified, facendole proseguire una volta con l’altro modello e una volta con lo stesso: con il cambio l’agente rifaceva diversamente la gran parte delle mosse successive, e un valutatore che ricostruiva l’esito dalle tracce registrate ha sbagliato proprio gli esiti che contavano [Gon26]. È uno studio piccolo, e l’autrice ne rivendica soltanto la conclusione, che il rigioco sbaglia; il meccanismo però non dipende dalla misura, e chiede di giudicare una regola facendola girare nell’ambiente fino alla fine.
Accanto alla scelta del modello c’è il limite. Un tetto per compito si mette su più grandezze insieme (spesa, chiamate al modello, tempo degli strumenti, tentativi per passo), come il tetto ai tentativi del ciclo, e si affianca a criteri d’arresto che guardano il progresso invece del consumo: il verificatore passa; nessun test nuovo superato da un certo numero di passi; lo stesso errore che ritorna. Quando il tetto scatta, il compito non si abbandona: si scrive nel registro dove si è arrivati, e si consegna.
Un caso a parte è il ragionamento. Un modello che ragiona prima di rispondere, come quelli della sezione sul post-addestramento, dentro un ciclo d’agente può pensare ancora sullo stato che ha, o agire e leggere che cosa risponde l’ambiente. Alejandro Cuadron e colleghi hanno chiamato overthinking la preferenza per il primo, e ne hanno descritto tre forme su agenti di programmazione: pianificare senza mai provare, lanciare azioni in fila senza guardarne l’esito, abbandonare il compito.
Un modello giudice, che non vedeva l’esito, ha dato a ogni traiettoria un punteggio di overthinking, e su SWE-bench Verified punteggi più alti andavano con meno problemi risolti [CLM+25].
Si noti che il difetto non sta nella lunghezza del ragionamento: lo stesso modello, con più ragionamento concesso, aveva punteggi più bassi e risolveva di più, il 29,1% dei problemi contro il 21,0%; con poco ragionamento, generare due soluzioni e tenere quella con il punteggio più basso ha dato il 27,3%, con una spesa riportata di 800 dollari contro 1.400.
Per ogni lavorazione di un mobile il capobottega decide chi chiamare: l’apprendista, un artigiano alle prime armi che costa poco, o il maestro, che costa dieci monete in più a lavorazione; sono il modello economico e quello forte. Più che alla difficoltà della lavorazione, il capobottega guarda a quanto il maestro cambia la probabilità che il mobile venga bene, e a quanto vale il mobile. Un incastro regge una sedia da cinquanta monete: su dieci sedie l’apprendista ne fa venire bene sei, il maestro nove, cioè tre sedie e centocinquanta monete in più contro cento monete di maestro, e conviene. Su un taglio dritto l’apprendista ne fa bene novantacinque su cento e il maestro novantotto: centocinquanta monete contro mille, e non conviene. Su un intarsio che nemmeno il maestro sa fare, chiamarlo non sposta niente.
Nel conto entra anche quello che viene dopo: un incastro storto fa rifare le lavorazioni che ci poggiano sopra, e un maestro chiamato a metà lavoro rilegge da capo tutti i fogli, perché il taccuino era dell’apprendista.
Si può anche far provare prima l’apprendista, mettere il suo incastro sulla dima e chiamare il maestro solo se non passa. L’apprendista si paga sempre, il maestro solo quando serve. Funziona finché la dima è buona: se respinge un incastro buono, il maestro si paga per niente; se ne lascia passare uno storto, nessuno chiama il maestro, e il resto del mobile si costruisce sopra quell’incastro.
Come si capisce se la regola del capobottega è buona? La tentazione è prendere dal raccoglitore i fogli di viaggio di ieri, scritti mentre lavorava il maestro, e chiedersi come sarebbe andata se alla terza lavorazione ci fosse stato l’apprendista. Ma quei fogli raccontano una giornata che con l’apprendista non ci sarebbe stata: lui avrebbe tagliato la terza un poco storta, la quarta andava adattata, la dima avrebbe respinto la quinta, e la giornata sarebbe finita più tardi o con un mobile diverso. Sui fogli, dopo la terza lavorazione, ci sono le mosse del maestro su un taglio dritto, che con l’apprendista nessuno avrebbe fatto. La sola prova onesta è far lavorare davvero l’apprendista, su mobili veri e per giornate intere, e confrontarle con quelle del maestro sugli stessi ordini.
Un pomeriggio una cassettiera non viene: da dieci lavorazioni nessun cassetto nuovo passa la dima, e torna sempre la stessa crepa. Il capobottega la ferma, e chi ci lavorava scrive sul registro dov’è arrivato e la consegna com’è. La ferma anche quando ha speso quanto previsto per un mobile, un limite che si fissa sui fogli di viaggio dei mobili riusciti: se quasi tutti sono costati meno di trenta monete, e solo cinque su cento di più, lo si mette a sessanta.
Si fermano così soprattutto i lavori che girano a vuoto, ma si perde anche qualche mobile che sarebbe riuscito poco dopo; fermarsi sul segno che il lavoro non avanza, come per la cassettiera, ne perde meno, se il segno è affidabile.
E c’è l’artigiano che decide senza guardare il legno: uno progetta il taglio invece di provarlo, uno fa tre tagli di fila senza guardarne nessuno, uno lascia perdere a metà. Tutti e tre lavorano sull’idea che si sono fatti del legno invece che sul legno, e i loro mobili vengono peggio.
Il guaio non è pensare a lungo: l’artigiano che ha più tempo per pensare prima di ogni taglio ci cade meno, e lavora meglio. Due prove con poco tempo, tenendo quella in cui ha guardato di più il legno, sono venute bene quasi quanto una con tutto il tempo, a minor prezzo; ma a scegliere fra le due c’era un’altra persona, e anche lei va pagata.
Siano \(s\) la probabilità che il compito riesca e \(c\) il suo costo, grandezze della traiettoria intera. Un intervento al passo \(t\) cambia la distribuzione delle traiettorie da lì in poi; se \(v\) è il valore di un compito riuscito, nella stessa unità del costo, conviene quando
con \(\Delta s\) e \(\Delta c\) le differenze, con e senza l’intervento, della probabilità di successo e del costo atteso della traiettoria intera dallo stato del passo \(t\). \(\Delta c\) comprende, oltre alla differenza di prezzo fra due chiamate, la rilettura fresca del contesto che ogni cambio di modello impone, perché la cache è per modello, e con il segno opposto i passi in più che un’azione debole provoca dopo: per questo può essere negativa.
La difficoltà del passo è un criterio più debole di \(\Delta s\): dove la probabilità di successo è vicina a zero o a uno con qualunque modello, l’intervento non sposta niente. Nel confronto appaiato del programma \(\Delta c/\Delta s = 11\) per compito riuscito in più, e A conviene su B se \(v > 11\); ma sono stime su cento compiti, e il rapporto eredita l’incertezza di \(\Delta s\), che il test di McNemar non distingue da zero.
La cascata a due modelli con un verificatore \(V\) paga sempre la chiamata economica, e quella forte solo dopo un rifiuto; il suo costo atteso, nella forma di FrugalGPT, sta nella sezione sul gateway del capitolo su MLOps, accanto al router appreso di RouteLLM [CZZ24b, OAW+25]. Dentro un agente i due tassi d’errore del verificatore, \(\alpha\) e \(\beta\) della sezione sul collaudo, pesano in modo diverso: un falso rifiuto (\(\beta\)) paga il modello forte senza bisogno; una falsa approvazione (\(\alpha\)) lascia costruire il resto della traiettoria sopra un passo sbagliato, ed entra in \(\Delta s\) e in \(\Delta c\) attraverso tutti i passi che seguono.
\(\Delta s\) e \(\Delta c\) sono definite sulla distribuzione delle traiettorie che la politica di instradamento \(\pi\) genera: stimarle da tracce di un’altra politica \(\pi_0\) è una valutazione off-policy, nel senso dei metodi Monte Carlo, e la sostituzione in un trascritto fisso non è nemmeno quella, perché tiene le osservazioni \(o_{t+1}, o_{t+2}, \dots\) generate dopo l’azione di \(\pi_0\) e le attribuisce a un’azione diversa.
L’importance sampling pesa ogni traiettoria con \(\prod_i \pi(a_i \mid \text{storia}_i) / \pi_0(a_i \mid \text{storia}_i)\), e chiede che \(\pi_0\) dia probabilità positiva a ogni azione che \(\pi\) può scegliere, cosa che una decodifica a temperatura zero non fa; e anche dove vale, con azioni di centinaia di token il prodotto esplode o si annulla, la fragilità che quella sezione mostra. Resta quindi la valutazione on-policy.
Gonuguntla biforca le esecuzioni al 30% e al 70% della traiettoria, circa novecento in tutto, con due modelli aperti della stessa famiglia di taglia e quantizzazione diverse: il cambio riscrive fra il 61 e il 94% delle azioni successive, i cinque esiti ribaltati stanno tutti nelle biforcazioni con il cambio e nessuno fra i 359 controlli, e il valutatore che ricuce le tracce sbaglia tutte e cinque le previsioni che decidono (tre riuscite non viste, due inventate), che non coincidono con i ribaltamenti [Gon26]. Con tassi di riuscita fra lo 0 e il 3%, l’autrice ne rivendica soltanto il segno.
Un tetto \(c_{\max}\) sul costo tronca la distribuzione: il costo di un’esecuzione diventa \(\min(c, c_{\max})\) più, quando il tetto scatta, il riassunto di consegna; la spesa attesa scende di \(\mathbb{E}\big[(c - c_{\max})^{+}\big]\) meno il costo del riassunto per \(P(c > c_{\max})\), e il successo perde \(P(\text{riuscita},\ c > c_{\max})\). Il tetto conviene se il primo termine supera \(v\) volte il secondo. Si può fissare dalle tracce, per esempio al doppio del quantile 0,95 del costo dei compiti riusciti: una regola senza fonte, che vale come esempio e va ricontrollata quando cambiano il modello o la batteria.
I criteri d’arresto sul progresso possono tagliare la stessa coda perdendo meno riuscite, se distinguono davvero la traiettoria che gira a vuoto da quella lenta; quanto ci riescano si misura sulle tracce, come il tetto.
Il budget di ragionamento è un caso della stessa decisione, interno al passo: più token di pensiero alzano \(c\), e quanto alzino \(s\) va misurato. Il punteggio di Cuadron e colleghi misura un’altra cosa, un comportamento (ragionare invece di agire e osservare), assegnato da un modello giudice e confrontato con quattro annotatori su venti tracce, su un solo tipo di agente; e nello stesso lavoro la configurazione con più ragionamento ha punteggi più bassi [CLM+25]. La selezione fra due campioni usa il punteggio come selettore: il giudice è una chiamata in più, da mettere al numeratore di \(c(H)/s(H)\), e il lavoro non dice se la spesa riportata la comprenda.
Il tempo di un agente#
Il conto in token misura la spesa; chi aspetta la risposta misura il tempo, e le due grandezze non vanno sempre insieme. In un agente che lavora in serie il tempo di un compito è la somma dei suoi passi, e ogni passo ha i suoi pezzi: l’attesa in coda presso il fornitore, la lettura del contesto, la scrittura della risposta e del ragionamento, l’esecuzione dello strumento, il lavoro dell’harness fra una chiamata e l’altra. Quando alcune azioni non dipendono l’una dall’altra, l’harness può lanciarle insieme, e il tempo diventa quello del cammino critico, la catena più lunga di azioni che devono aspettarsi a vicenda, come nel riassunto ad albero della sezione sul context engineering.
Sehoon Kim e colleghi hanno costruito un sistema che lo sfrutta da solo: un modello pianificatore scrive le chiamate di strumento come un grafo, una mappa di chiamate con le frecce che dicono chi aspetta il risultato di chi, e un esecutore lancia ogni chiamata appena le sue dipendenze sono risolte. Su cinquecento domande che chiedono quale fra quattro film somigli di più ad altri quattro, cioè otto ricerche indipendenti, il confronto con un agente che fa una chiamata per passo (alla ReAct), sullo stesso modello (GPT-3.5, 2023), dava un’attesa 3,7 volte più breve, una spesa 6,7 volte più bassa e quasi cinque punti di risposte giuste in più [KMT+24]: raggruppare le chiamate indipendenti in un passo toglie insieme attesa e riletture.
Dove la chiamata dopo dipende da ciò che il modello sta ancora pensando, il parallelo non c’è, e resta un’altra leva, presa in prestito dalla decodifica speculativa: indovinare. Nelle azioni speculative di Naimeng Ye e colleghi un modello più rapido prova a prevedere la prossima azione mentre il modello principale sta ancora pensando, e la lancia subito; se l’azione che il modello principale chiede coincide con una delle previste, il suo risultato è già pronto o in arrivo, altrimenti la previsione si butta, e il risultato finale resta quello che il modello principale avrebbe ottenuto da solo, se nel frattempo l’esito dello strumento non è cambiato [YAL+26].
La condizione è che l’azione prevista non cambi niente, o si possa disfare: una lettura, una ricerca non lasciano tracce; una scrittura, un ordine, un messaggio mandato a qualcuno chiedono una copia dello stato da cui ripartire, o non si speculano.
Un programma mette in fila le tre forme sullo stesso lavoro, tre letture indipendenti e una risposta, con tempi a numeri tondi.
# Lo stesso lavoro in tre modi, a numeri tondi e non misurati: tre letture che
# non dipendono l'una dall'altra, poi la risposta. Il modello pensa PENSA
# secondi prima di ogni chiamata, ogni lettura dura LEGGI, il modello rapido
# che prova a indovinare la chiamata dopo ne impiega INDOVINA.
PENSA, LEGGI, INDOVINA = 4, 3, 1
LETTURE = {"A": True, "B": False, "C": True}   # previsione giusta o sbagliata

def passo(giusta):
    """Il modello pensa e chiede una lettura. Se la previsione era giusta, la
    lettura è partita appena il modello rapido ha finito di indovinarla."""
    return max(PENSA, INDOVINA + LEGGI) if giusta else PENSA + LEGGI

in_serie = len(LETTURE) * (PENSA + LEGGI) + PENSA
in_parallelo = PENSA + LEGGI + PENSA     # tre letture in un passo solo
speculativo = sum(passo(g) for g in LETTURE.values()) + PENSA
sbagliate = sum(not g for g in LETTURE.values())
print(f"in serie: {in_serie} s, {len(LETTURE) + 1} chiamate al modello")
print(f"in parallelo: {in_parallelo} s, 2 chiamate al modello")
print(f"speculativo: {speculativo} s, {len(LETTURE) + 1} chiamate al modello, "
      f"{len(LETTURE)} previsioni, {sbagliate} lettura buttata")

for q in (0.25, 0.5, 0.75, 1):
    medio = q * passo(True) + (1 - q) * passo(False)
    print(f"previsione giusta con probabilità {q}: passo medio {medio} s, "
          f"invece di {PENSA + LEGGI}".replace(".", ","))
in serie: 25 s, 4 chiamate al modello
in parallelo: 11 s, 2 chiamate al modello
speculativo: 19 s, 4 chiamate al modello, 3 previsioni, 1 lettura buttata
previsione giusta con probabilità 0,25: passo medio 6,25 s, invece di 7
previsione giusta con probabilità 0,5: passo medio 5,5 s, invece di 7
previsione giusta con probabilità 0,75: passo medio 4,75 s, invece di 7
previsione giusta con probabilità 1: passo medio 4 s, invece di 7
In serie il lavoro dura 25 secondi e chiede quattro chiamate al modello; raggruppando le letture ne dura 11 e ne chiede due, la strada giusta quando le letture non dipendono l’una dall’altra.
La speculazione, invece, lascia il lavoro in serie e ne recupera una parte: 19 secondi, con le stesse quattro chiamate, tre previsioni in più e una lettura buttata. Con previsioni giuste una volta su quattro il passo medio scende da 7 a 6,25 secondi; con previsioni sempre giuste arriva a 4, la durata del pensiero, e indovinando soltanto l’azione dopo non scende oltre, perché la lettura si nasconde dietro il pensiero ma il pensiero resta. La Fig. 22.6 mostra le tre corsie mentre avanzano.
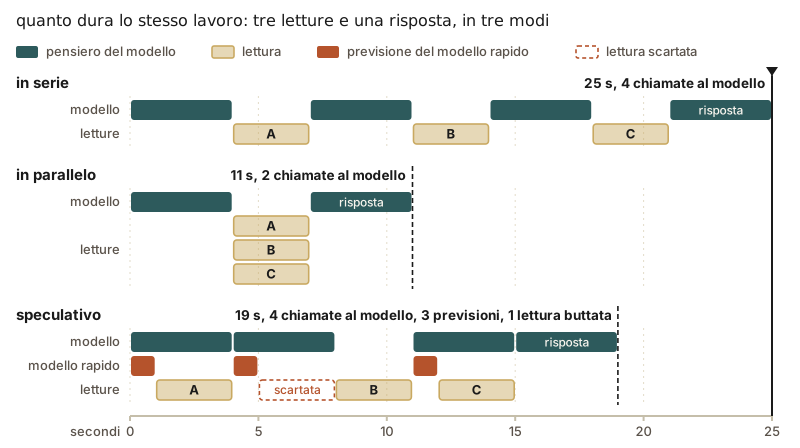
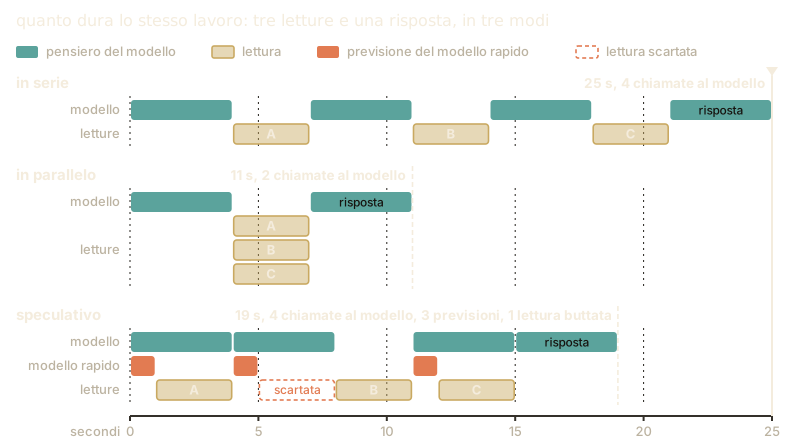
Fig. 22.6 Lo stesso lavoro, tre letture indipendenti e una risposta, in tre modi: in serie, con le letture raggruppate in un passo, e con le azioni speculative. Ogni corsia finisce quando finisce la sua catena più lunga; la speculazione accorcia la serie soltanto dove la previsione è giusta.#
Un mobile ha bisogno di tre cose dal magazzino: le viti, la colla, una cerniera. L’artigiano che lavora in serie pensa a che cosa gli serve, scrive il biglietto per le viti e aspetta che il capobottega torni dallo sportello con il foglio del magazziniere; ci ripensa, scrive quello per la colla, aspetta; ci ripensa, scrive quello per la cerniera. Se invece scrive i tre biglietti in una volta, il capobottega li porta allo sportello insieme, dietro lo sportello le tre ricerche si fanno nello stesso momento, e l’artigiano aspetta quanto la più lunga.
La giornata dura quanto la fila più lunga di cose che si aspettano l’una con l’altra: la vernice aspetta che la colla asciughi, e nessuna mano in più la fa asciugare prima; le tre gambe, invece, si carteggiano insieme.
Tre biglietti insieme costano meno di tre uno dopo l’altro: l’artigiano fa una mossa sola invece di tre, e rilegge il tavolo una volta sola. Costa di più far lavorare tre artigiani insieme su tre parti del mobile: ognuno legge il cartello e il foglio dell’ordine, e alla fine qualcuno rimette insieme i pezzi; si finisce prima e si paga di più. E l’apprendista, che costa meno a mossa, a volte di mosse ne fa tante da finire dopo il maestro.
Quando le cose non si possono chiedere insieme, perché la seconda dipende da come è andata la prima, resta un trucco. Mentre il maestro pensa a quale biglietto scrivere, l’apprendista prova a indovinarlo e lo porta lui allo sportello. Se il maestro scrive proprio quello, il foglio del magazziniere è già pronto, o sta arrivando; se ne scrive un altro, il foglio dell’apprendista si butta e il capobottega porta il biglietto giusto, e si è perso soltanto quel viaggio. Il mobile è lo stesso che il maestro avrebbe fatto da solo, perché sul tavolo arriva soltanto la risposta al biglietto che lui ha scritto, purché in magazzino, nel frattempo, non sia cambiato niente.
Il trucco si fa con le richieste che in magazzino non cambiano niente, come farsi dire quante viti ci sono o farsi leggere un disegno. Non si fa tagliare in anticipo il legno buono sperando che il maestro voglia proprio quel taglio; se proprio si vuole anticiparlo, lo si prova su un pezzo di scarto preparato apposta, che si prepara anche quando la previsione è giusta.
Quanto si risparmia ha un tetto. Se il maestro pensa quattro minuti e la risposta del magazziniere ne chiede tre, con il biglietto indovinato il passo dura i quattro minuti del pensiero invece di sette: l’attesa allo sportello si nasconde dietro il pensiero, ma il pensiero resta. Se l’apprendista indovina una volta su due, si risparmiano in media un minuto e mezzo a passo, metà dei tre. E indovinando soltanto il biglietto dopo non si va oltre metà del passo: nel caso migliore pensiero e attesa durano uguale, tre minuti e tre, l’apprendista indovina sempre e all’istante, e il passo scende da sei minuti a tre.
Il conto va tenuto in due colonne. L’apprendista che indovina si paga anche quando sbaglia, e un viaggio buttato è un viaggio pagato. Una bottega che consegna in un’ora invece che in un’ora e un quarto, ma spende tre decimi in più fra apprendista e viaggi buttati, ha pagato la velocità, e non ha risparmiato niente: può essere la scelta giusta, se il cliente aspetta alla porta, ma va scritta per quello che è.
Il lavoro di un compito è un grafo aciclico orientato \(\mathcal{G}\) i cui nodi \(a\) sono azioni (una chiamata al modello, uno strumento) di durata \(\ell_a\), e in cui un arco da \(a\) ad \(a'\) dice che \(a'\) ha bisogno del risultato di \(a\). Eseguito in serie dura \(\sum_a \ell_a\); con risorse illimitate e senza costi di coordinamento dura quanto il cammino critico,
il massimo preso su tutti i cammini del grafo. Nessuna esecuzione che aspetti i risultati di cui ha bisogno dura meno di \(\ell_{\text{crit}}\); per scendere sotto bisogna indovinarli prima che arrivino, ed è la speculazione. Il rapporto \(\sum_a \ell_a / \ell_{\text{crit}}\) è il parallelismo disponibile.
Raggruppare \(n\) chiamate di strumento indipendenti in un passo porta da \(n + 1\) a \(2\) le chiamate al modello che le circondano e toglie le riletture del contesto di quelle in mezzo, come nella misura di LLMCompiler.
Affidare rami indipendenti a più sottoagenti accorcia il cammino critico e alza il costo: ciascuno rilegge il proprio prefisso, lanciati insieme possono non trovare in cache nemmeno la parte comune, che il primo sta ancora calcolando, e la fusione dei risultati è un nodo in più. E un modello che costa meno a passo ma ha bisogno di più passi allunga i cammini, e può finire dopo anche quando costa meno in tutto.
Per l’azione speculativa si guarda un passo: il modello genera per un tempo \(\ell_{\text{m}}\) prima di emettere la chiamata, lo strumento dura \(\ell_{\text{s}}\), il predittore impiega \(\ell_{\text{p}} \le \ell_{\text{m}}\) e indovina la chiamata (strumento e argomenti) con probabilità \(q\). Con una previsione giusta lo strumento parte a \(\ell_{\text{p}}\) e il passo finisce a \(\max(\ell_{\text{m}},\, \ell_{\text{p}} + \ell_{\text{s}})\); con una sbagliata, a \(\ell_{\text{m}} + \ell_{\text{s}}\), come senza speculazione. Quindi
se l’esecuzione speculativa non rallenta quella vera contendendole lo stesso strumento o lo stesso limite di richieste. La frazione risparmiata è al più \(q \min(\ell_{\text{s}}, \ell_{\text{m}}) / (\ell_{\text{m}} + \ell_{\text{s}}) \le q/2\), con l’uguaglianza per \(\ell_{\text{p}} = 0\) e \(\ell_{\text{s}} = \ell_{\text{m}}\): speculare sulla sola azione successiva può al massimo dimezzare un passo.
Ye e colleghi ottengono lo stesso tetto in un modello diverso, una catena di chiamate con latenze esponenziali e una previsione di un passo, e mostrano che prevedere più passi in avanti lo alza. Su τ-bench speculano invece sull’attesa del cliente simulato che scrive: il predittore indovina il suo prossimo messaggio e le chiamate per rispondergli, e ne azzecca fra il 22 e il 38%, secondo il modello usato come predittore [YAL+26].
Il costo atteso in più, per passo, è
con \(c_{\text{p}}\) il costo fisso della speculazione, che si paga sempre (il predittore, che legge il contesto con la sua cache e non con quella del modello principale, e per una scrittura la copia dello stato da cui ripartire), \(c_{\text{s}}\) quello dell’esecuzione buttata e \(c_{\text{r}}\) quello di disfarla: nullo per un’azione in sola lettura, il ritorno alla copia per una scrittura, senza un valore finito per un’azione che esce dal sistema e non si richiama, che quindi non si specula.
L’idempotenza non basta: rende innocua una seconda esecuzione della stessa azione, non la prima esecuzione di un’azione sbagliata. Inoltre, il risultato resta quello del modello principale solo se l’azione speculata si conferma quando coincide con la sua (un confronto esatto, o un controllo di equivalenza), se l’esito dello strumento non è cambiato fra il lancio anticipato e la richiesta vera, e se la lettura non ha effetti propri, come una quota consumata o un messaggio segnato come letto.
Tempo e costo restano due grandezze: se \(v_\ell\) è il valore di un’unità di tempo d’attesa, la speculazione conviene quando \(v_\ell\, q \min(\ell_{\text{s}}, \ell_{\text{m}} - \ell_{\text{p}}) > \Delta c\), e sotto un vincolo di latenza, per esempio sul quantile 0,95 del tempo di risposta, si minimizza il costo fra le politiche che lo rispettano. Una politica più veloce del 20% e più cara del 30% non domina quella di partenza, sta in un altro punto del fronte di Pareto: ha scambiato spesa con tempo, e i due esiti si riportano separati.
Il fronte di Pareto dell’apertura ha ora tre assi, non due: quanti compiti si risolvono, quanto costano, quanto si aspetta.
Da ricordare
Un sistema si giudica da quanti problemi risolve e da quanto è costato: riprovare con lo stesso modello a volte fa bene quanto un agente elaborato, a una frazione del prezzo.
Il conto di un lavoro si moltiplica: quante volte il cliente chiede, quante mosse per ogni richiesta, quanti fogli a mossa, quanto costa un foglio; e comprende anche chi controlla e chi riassume.
Il taccuino, la cache, fa costare un decimo i fogli già letti finché sono uguali dall’inizio, in fila: l’ora in cima, un attrezzo spostato, un foglio vecchio corretto o accorciato fanno rileggere a prezzo pieno tutto quello che segue. I fogli nuovi vanno in fondo.
Con il taccuino la pila costa meno ma cresce ancora, e sgomberare spesso risparmia poco: ogni riassunto si scrive e si rilegge senza sconto.
Ogni risparmio ha un rovescio, misurato sugli stessi lavori e per intero; il costo per lavoro riuscito conta i lavori riusciti davvero, uno per lavoro.
Il maestro si chiama dove cambia davvero la riuscita di un mobile che vale abbastanza, e la regola si prova facendola lavorare: i fogli di viaggio di ieri raccontano una giornata che con un altro artigiano non ci sarebbe stata.
Un lavoro si ferma quando passa la dima, non avanza, ripete lo stesso errore o ha speso quanto previsto, e si scrive sul registro dov’è arrivato. Chi decide senza guardare il legno fa mobili peggiori; chi ha più tempo per pensare, e poi guarda, ci cade di meno.
La giornata dura quanto la fila più lunga di cose che si aspettano; le cose indipendenti si chiedono insieme. Indovinare il biglietto dopo fa risparmiare al più metà di un passo, solo con richieste che si possono disfare, e velocità e spesa si scrivono in due colonne.
Da ricordare
Accuratezza e costo si riportano insieme, sul fronte di Pareto e contro linee di base semplici [KSS+24].
\(c = \text{richieste} \times \text{passi}/\text{richiesta} \times \text{token}/\text{passo} \times \text{prezzo}/\text{token}\); la contabilità comprende tutte le chiamate, con token in cache, freschi e scritti separati, e una contabilità di progetto a parte.
\(c_t = \eta\, \chi_t + (\mathrm{tok}(C_t) - \chi_t) + \omega\, y_t\): l’attenzione causale permette il riuso esatto del prefisso e chiede l’identità token per token, e la cache è per modello. La somma resta \(\Theta(T^2)\) con coefficiente \(\eta d/2\), e il quadrato raggiunge i lineari verso \(T \approx 2(d + \eta\phi + \omega y)/(\eta d)\).
Rompono la cache un contenuto variabile in testa, gli strumenti riordinati, la cronologia modificata (anche accorciando esiti vecchi), la compattazione, la scadenza: log in sola aggiunta. Con la cache la frequenza del taglio pesa molto meno.
\(c(H)/s(H)\) con tutti i tentativi e i controlli al numeratore e i compiti davvero risolti al denominatore, letto con gli esiti appaiati e i requisiti minimi; il risparmio netto si misura sulle traiettorie intere.
Un intervento conviene se \(v\,\Delta s - \Delta c > 0\), con \(\Delta c\) che include i passi a valle e la cache persa; si valuta on-policy, perché sostituire risposte in tracce fisse stima una quantità che nessuna politica produce [Gon26].
Un tetto tronca la coda del costo e perde le riuscite oltre il tetto. L’overthinking, ragionare invece di agire e osservare, va con meno successo, e più ragionamento concesso lo riduce [CLM+25].
Se si aspettano i risultati, il tempo è il cammino critico. La speculazione dà \(\mathbb{E}[\ell_{\text{passo}}] = \ell_{\text{m}} + \ell_{\text{s}} - q \min(\ell_{\text{s}}, \ell_{\text{m}} - \ell_{\text{p}})\), al più metà passo indovinando la sola azione dopo, costa \(c_{\text{p}} + (1-q) (c_{\text{s}} + c_{\text{r}})\) e chiede azioni senza effetti o reversibili [YAL+26], perché l’idempotenza non basta; latenza e costo si riportano separati.
Il cammino critico ha preso il grafo delle azioni così com’era, con le frecce già tracciate. In un lavoro che dura qualcuno deve tracciarle, il codice dell’harness o il modello, e il lavoro deve potersi riprendere quando si interrompe: è il disegno del grafo.