



Lavorare a turni: il passaggio di consegne#
Per descrivere il problema che voleva risolvere, Young usa un’immagine sola: un progetto portato avanti da ingegneri che lavorano a turni, in cui ogni nuovo ingegnere arriva senza alcun ricordo di quello che è successo nel turno prima [You25]. È la condizione di un agente su un compito lungo. La sessione finisce quando la finestra di contesto è piena, o quando il lavoro di quel turno è concluso, e la sessione dopo riparte con la finestra vuota. In mezzo passa soltanto ciò che è stato scritto, e il modo in cui lo si scrive decide se il turno successivo comincia a lavorare o comincia a indovinare.
Il primo turno ha preparato le carte: l’ambiente che parte, l’elenco delle funzionalità tutte da fare, il registro aperto, il primo salvataggio. I turni che vengono dopo si somigliano tutti, e una scelta li riguarda tutti: che cosa fare quando la finestra si riempie, se riassumere e continuare o fermarsi e ripartire da capo.
La routine del turno#
Nell’harness di Young ogni sessione comincia con gli stessi gesti, scritti nelle sue istruzioni. Controlla in quale cartella si trova, perché l’ambiente in cui gira le permette di modificare soltanto i file di quella cartella, un recinto che la tiene lontana dal resto della macchina. Legge la storia recente del repository e il file di avanzamento, per sapere su che cosa si è lavorato di recente. Legge l’elenco delle funzionalità, che il primo turno ha scritto in ordine di priorità, e sceglie la prima fra quelle non ancora riuscite. Poi, prima di toccare qualunque cosa, avvia l’applicazione con lo script del primo turno e fa una prova di base da utente; nel codice d’esempio di Anthropic riprova anche una o due funzionalità già segnate come riuscite, le più centrali [Anthropic25a].
Se il turno prima ha lasciato qualcosa di rotto, quella funzionalità torna fra le non riuscite e va riparata adesso, prima di aggiungere altro sopra. Solo allora la sessione lavora, e su una funzionalità sola.
La fine del turno è altrettanto fissa. Il lavoro si salva nella storia di git con un messaggio che dice che cosa è cambiato, il file di avanzamento si aggiorna, e il codice va lasciato in uno stato pulito, quello che Young descrive come adatto a essere integrato nel ramo principale, cioè nella versione del codice che tutti considerano buona: senza difetti gravi, in ordine, documentato, tale che il turno dopo possa partire subito con una funzionalità nuova senza dover prima mettere a posto il disordine di quello precedente.
La storia serve anche all’indietro: con i salvataggi e i loro messaggi, osserva Young, il modello poteva annullare le modifiche sbagliate e tornare a uno stato del codice che funzionava.
Una funzionalità per turno è la difesa contro il primo dei guasti che Young aveva visto, il lavoro tentato tutto in un colpo. Ad esempio, una sessione che porta avanti cinque fronti insieme, se la finestra finisce prima, lascia cinque lavori a metà, nessuno dei quali si può provare. Una sessione che ne apre uno solo, invece, lo porta fino alla prova, lo salva e lo annota: se la finestra finisce prima resta aperto quello solo, e il registro dice quale.
Perché la difesa funzioni, la funzionalità deve stare in una sessione, che è la misura chiesta all’elenco dal primo turno. Il lavoro diventa così una sequenza di unità che si chiudono, e un’unità chiusa non ha bisogno di essere ricordata: basta leggerne il risultato.
Ogni mattina l’artigiano nuovo fa sempre le stesse cose, nello stesso ordine. Guarda dove si trova e quale banco è il suo: gli attrezzi degli altri banchi non li tocca. Legge le ultime pagine del registro: ieri lo scaffale numero dodici è stato finito; il tredici non ha passato la dima, perché la colla non teneva, ed è stato rimesso com’era la mattina. Prende il foglio dell’ordine, dove i pezzi sono scritti dal più urgente al meno urgente, e sceglie il primo non spuntato. Poi, prima di cominciare, accende la macchina e taglia un listello di prova: se ieri qualcuno ha spostato la guida della sega, se ne accorge adesso.
Riprova poi sulla dima uno o due mobili già spuntati, quelli su cui poggia il resto, perché montare un pezzo nuovo accanto a uno vecchio può averlo spinto fuori squadra. Se uno non passa più, gli toglie la spunta e lo ripara per primo.
Poi fa un pezzo, uno solo, fino in fondo, compresa la prova sulla dima. Il pezzo dev’essere della misura di una giornata: se non lo è, a sera resta a metà comunque lo si organizzi.
La sera, se il pezzo ha passato la dima, lo mette in fila con gli altri, spunta la casella e scatta la fotografia della bottega in ordine; se non l’ha passata, rimette il banco com’era la mattina, e la fotografia buona resta quella di ieri. In tutti e due i casi scrive sul registro che cosa ha fatto e che cosa non è riuscito, pulisce il banco e rimette gli attrezzi ai loro ganci. L’artigiano di domani deve poter cominciare subito, senza passare la prima ora a togliere i trucioli di oggi.
Chi invece comincia cinque pezzi insieme e a sera non ha finito, lascia cinque pezzi a metà. Il registro dice «lavorato su cinque cose», che non serve a nessuno, e domattina il nuovo artigiano deve capire, pezzo per pezzo, a che punto è ciascuno. Chi li fa uno dopo l’altro, a sera ne ha al più uno a metà, e sa dire quale.
Tre cose, però, la routine da sola non le garantisce. Che il banco sia davvero pulito lo dice l’artigiano stesso, la sera, quando ha fretta di andare a casa: se nessun altro lo guarda, resta la sua parola. Rimettere il banco com’era rimette a posto i pezzi di legno, non la colla aperta lasciata ad asciugare o la macchina regolata in un altro modo. E due artigiani a due banchi diversi non si pestano i piedi sui pezzi, ma possono prendere dal foglio lo stesso pezzo, se nessuno ci scrive sopra il proprio nome prima di cominciare.
La routine si legge come un protocollo con precondizioni e postcondizioni. Nella notazione dell’anatomia dell’harness, la sessione \(k \ge 1\) legge \(M_k = (F, \mathbf{p}_{k-1}, R_{k-1}, c_{k-1})\), cioè l’elenco, il vettore degli esiti, il registro e il commit lasciati dalla sessione \(k - 1\), e lascia \(M_{k+1} = (F, \mathbf{p}_k, R_k, c_k)\). La sessione:
verifica le precondizioni su \(c_{k-1}\): l’ambiente si ricostruisce da
init.she una prova minima passa; per un sottoinsieme \(J\) delle voci con \(p_{k-1,j} = 1\) riesegue i collaudi \(V_j\) e porta a \(0\) le voci che falliscono (nel codice d’esempio \(|J|\) vale uno o due); se qualcosa fallisce, la riparazione è la voce della sessione;altrimenti sceglie \(i = \min\{\, j : p_{k-1,j} = 0 \,\}\), la prima voce aperta nell’ordine di \(F\);
lavora, producendo le modifiche \(D_k\), ed esegue \(V_i\), cioè i passi di prova di \(f_i\), sul codice modificato;
se \(V_i = 1\), salva \(c_k = c_{k-1} \oplus D_k\) con \(p_{k,i} = 1\); altrimenti riporta i file a \(c_k = c_{k-1}\), con \(p_{k,i} = 0\). In tutti e due i casi annota in \(R_k\) che cosa è successo e perché.
La postcondizione è l’invariante dello stato pulito: su \(c_k\) l’ambiente si ricostruisce, le \(V_j\) ripassate passano, e \(R_k\) descrive \(c_k\). Il protocollo di Young non ha uno stato per la voce che fallisce sempre: al passo 2 la stessa voce viene riscelta a ogni sessione, e un harness che lo prevede la marca come bloccata dopo un numero fissato di tentativi e la porta a una persona.
L’analogia con una transazione di un database [Gra81, HarderR83] regge a metà, e le sue riserve dicono che cosa manca al protocollo. Atomicità (entra nella storia un’unità verificata, o niente) e consistenza (ogni commit rispetta l’invariante) valgono soltanto se a rifiutare il commit che non le rispetta è un controllo esterno al modello: in un sistema di basi di dati le garantisce il sistema, qui il protocollo le chiede all’agente, e la clausola «\(R_k\) descrive \(c_k\)» non si verifica a macchina. Il ritorno a \(c_{k-1}\) ripristina i file, non lo stato dell’ambiente \(E\): un database di prova modificato, un pacchetto installato, un processo rimasto acceso sopravvivono al ritorno. La durabilità è quella della storia di git. L’isolamento non c’è: un worktree separato per sessione, come quello della loop engineering, separa i file e non le risorse, e due sessioni parallele che eseguono il passo 2 sullo stesso \(\mathbf{p}_{k-1}\) scelgono la stessa voce, perché la scelta è una lettura seguita da una scrittura, senza blocco.
Il limite di una voce per sessione (in gergo, un limite al lavoro in corso pari a uno) ha una prima giustificazione nel modo in cui una sessione si interrompe. Se la finestra si esaurisce prima della fine, con le voci lavorate una dopo l’altra ne resta aperta al più una, qualunque sia il numero di voci tentate; con le voci intrecciate restano aperte tutte. Una voce aperta non ha un esito, né \(V_i = 1\) né \(V_i = 0\), e il suo stato si trasmette solo a parole, che è proprio ciò che il protocollo vuole evitare. Il limite a uno esclude l’intreccio per costruzione, ma non basta se la singola voce eccede il budget della sessione: per questo la condizione va chiesta sul caso cattivo e non in media, ed è la granularità chiesta all’elenco. La seconda giustificazione è di costo, e viene dal conto dei token di una sessione.
Che cosa si scrive per chi viene dopo#
Il turno dopo riceve tre memorie diverse. L’elenco delle funzionalità dice che cosa è fatto e che cosa no. Il file di avanzamento dice dove si è arrivati e che cosa viene adesso: l’ultima funzionalità toccata, quello che si è rotto, quello che blocca, il prossimo passo. La storia di git dice come ci si è arrivati: ogni salvataggio con il suo messaggio, e la possibilità di tornare a uno stato in cui tutto funzionava.
Una quarta cosa si perde facilmente se nessuno la scrive, ed è il perché. Il codice sopravvive alla sessione, la ragione di una scelta no: se un’opzione è stata scartata per un buon motivo e il motivo non è annotato, la sessione dopo vede soltanto codice che le pare migliorabile, e lo «migliora» rifacendo l’errore che quella scelta evitava.
Il rimedio costa poco: un file delle decisioni, una riga per decisione con la ragione e l’alternativa scartata, che nello sviluppo del software si chiama architecture decision record [Nyg11]. Per esempio: «I prezzi si tengono in centesimi interi. Scartati gli euro con la virgola: le somme dei numeri con la virgola, nel computer, sbagliano di qualche centesimo.»
Il file di avanzamento ha un vantaggio preciso sul riassunto che, nel primo tentativo di Young, passava da una finestra all’altra. Tutti e due li scrive il modello, e tutti e due perdono qualcosa; cambiano il momento e la materia. Il riassunto si scrive quando la finestra è piena, in un punto qualunque del lavoro, su tutto ciò che c’è dentro, compresi i tentativi abbandonati, e il modello decide lì per lì che cosa tenere. Il file di avanzamento si scrive a un momento stabilito, la fine di un’unità di lavoro, su un lavoro appena verificato, secondo lo schema che le istruzioni chiedono. In sintesi, il primo è la compressione di una conversazione, il secondo è un passaggio di consegne.
La mattina il nuovo artigiano ha in mano tre cose. Il foglio dell’ordine, con le sue caselle, gli dice che cosa è fatto. Il registro gli dice dove si è arrivati: «il tredici non tiene con questa colla; domani si prova con le viti». La fila delle fotografie, una per sera, gli dice come la bottega è cambiata giorno per giorno, e gli permette di tornare a una sera in cui tutto andava.
In fondo al registro c’è anche una pagina a parte, quella delle decisioni: «i ripiani si fissano con le viti, non con la colla a caldo: la colla a caldo non regge trenta libri, provata e scartata il tre marzo». Senza quella riga, l’artigiano nuovo vede le viti, pensa che la colla a caldo farebbe prima e meglio, la usa, e la settimana dopo i ripiani cedono. Un mobile con le viti non dice perché ha le viti: dice soltanto che le ha.
Il registro, poi, si scrive la sera, con calma, dopo la dima, su un pezzo di cui si sa com’è andato. Il foglio di riassunto che si scrive a metà giornata, quando il tavolo è pieno, è un’altra cosa: si scrive di fretta, su tutto quello che c’è sul tavolo, anche le prove venute male, e decide lì per lì che cosa tenere. Li scrive tutti e due lo stesso artigiano; cambia il momento.
Le quattro memorie sono componenti dello stato persistente con funzioni distinte e una diversa ricostruibilità. \(F\) e \(\mathbf{p}\) dicono che cosa; \(R\) dice dove, in linguaggio naturale; la storia \(c_0, \dots, c_{k-1}\) dice come, e dà i punti a cui tornare; il file delle decisioni dice perché. Le prime tre si potrebbero in linea di principio ricostruire dal repository, a un costo: gli esiti rieseguendo i collaudi, lo stato del lavoro leggendo il codice e la storia. Il perché no: un’alternativa scartata, vista dal codice, è indistinguibile da un’alternativa mai considerata, e l’informazione che le separa esiste solo se qualcuno l’ha scritta. È per questo la memoria che si perde per prima.
Riassunto e registro sono entrambi compressioni con perdita del contesto,
scritte dal modello, e differiscono per tre parametri. Il momento: il
riassunto si scrive quando il contesto supera una soglia, cioè in un istante
che non coincide con nessun confine del lavoro; il registro al confine di
un’unità chiusa, dopo \(V_i\). L’ingresso: il riassunto comprime tutto il
contesto, compresi i tentativi abbandonati; il registro descrive \(D_k\) e
l’esito di \(V_i\). Lo schema: il riassunto segue un criterio implicito, il
registro quello imposto dalle istruzioni, che in Young resta testo libero (il
file è claude-progress.txt) e quindi, a differenza dell’elenco, non si
confronta a macchina.
Compattare o ripartire da capo#
Su un compito lungo la finestra si riempie, e un harness deve decidere che cosa fare prima che succeda. Le politiche sono due, e corrispondono a due delle operazioni del context engineering: comprimere ciò che resta, o scriverlo fuori e ripartire.
Compattare vuol dire tenere una sola sessione lunga e, quando il contesto supera una soglia, riassumere la cronologia dentro la sessione stessa e continuare: la continuità si conserva, i dettagli in parte si perdono, e non sempre si sa quali. Ripartire da capo vuol dire chiudere la sessione a un confine naturale, la fine di una funzionalità, e aprirne una nuova, con la finestra vuota, che legge il registro, l’elenco e la storia: si riparte puliti, a patto che quello che è stato scritto basti.
Le due si combinano: una sessione per funzionalità, con la compattazione come rete di sicurezza per la funzionalità che si allunga.
Prithvi Rajasekaran, che in Anthropic ha costruito harness per lavori di molte ore, riporta che la scelta dipende dal modello [Raj26]. Alcuni modelli, avvicinandosi a quello che ritengono il limite della propria finestra, tendono a chiudere il lavoro in fretta, e lui chiama questo comportamento context anxiety, ansia da contesto. Su un modello del settembre 2025 (Claude Sonnet 4.5) l’ha visto abbastanza forte da rendere indispensabile la ripartenza da capo: la compattazione, scrive, conserva la continuità ma non dà al modello una pagina pulita, e l’ansia può restare. Su un modello di due mesi dopo (Claude Opus 4.5) il comportamento era in gran parte sparito da sé, e Rajasekaran ha potuto togliere le ripartenze e far girare tutto il lavoro come una sola sessione continua, con la compattazione automatica a fare spazio quando serviva.
Sono osservazioni del suo lavoro, non misure, e il nome di un modello è un esempio di oggi; la lezione dura di più: la strategia per la memoria è un componente dell’harness, e come ogni componente dipende dal modello che serve.
C’è poi un conto che vale per qualunque modello, ed è quello dei token. Un modello linguistico non ricorda niente fra una chiamata e l’altra: a ogni iterazione del ciclo riceve di nuovo tutto il contesto, istruzioni e cronologia, e lo rilegge da capo. Se la cronologia cresce di una quantità fissa a ogni iterazione, ogni iterazione costa un po” più della precedente, e il costo di una sessione cresce con il quadrato della sua lunghezza: una sessione lunga il doppio legge quasi quattro volte tanto.
Un programma fa il conto su numeri tondi, scelti per far vedere la forma del conto e non misurati su un sistema vero: un compito di sessanta iterazioni, istruzioni fisse di cinquemila token, tremila token in più a ogni iterazione, una finestra di centomila. Confronta quattro strategie: nessuna; la compattazione quando il contesto supera l’ottanta per cento della finestra, e poi quando supera il cinquanta, con un riassunto di quattromila token e contando anche la chiamata che lo scrive; la ripartenza a ogni funzionalità finita, ogni quindici iterazioni, con duemila token da leggere all’inizio di ogni sessione. Per ciascuna stampa il picco, cioè il contesto più grande letto in una volta, e i token letti in tutto, sommati iterazione per iterazione; poi il costo di due funzionalità fatte nella stessa sessione.
import math

# Un modello a numeri tondi, non una misura: a ogni iterazione il modello
# rilegge tutto il contesto, e la cronologia cresce della sua risposta e
# dell'esito di uno strumento.
FINESTRA = 100_000      # token che il modello legge al massimo in una volta
FISSO = 5_000           # istruzioni e strumenti, riletti a ogni iterazione
CRESCITA = 3_000        # quanto cresce la cronologia a ogni iterazione
ITERAZIONI = 60         # la lunghezza del compito
RIASSUNTO = 4_000       # la cronologia compattata diventa un riassunto
REGISTRO = 2_000        # registro, voci aperte dell'elenco, storia recente
PER_SESSIONE = 15       # iterazioni di una sessione: una funzionalità

def senza_niente():
    letti, storia, contesti = 0, 0, []
    for t in range(ITERAZIONI):
        contesto = FISSO + storia
        if contesto > FINESTRA:          # non ci sta più: il lavoro si ferma
            break
        contesti.append(contesto)
        letti += contesto
        storia += CRESCITA
    return letti, contesti

def con_compattazione(soglia):
    letti, storia, contesti, volte, per_riassunti = 0, 0, [], 0, 0
    for t in range(ITERAZIONI):
        if FISSO + storia > soglia * FINESTRA:
            per_riassunti += FISSO + storia   # la chiamata che lo scrive
            storia, volte = RIASSUNTO, volte + 1
        contesto = FISSO + storia
        contesti.append(contesto)
        letti += contesto
        storia += CRESCITA
    return letti + per_riassunti, contesti, volte, per_riassunti

def con_ripartenza(iterazioni=ITERAZIONI, per_sessione=PER_SESSIONE):
    letti, contesti = 0, []
    for t in range(iterazioni):
        dentro = t % per_sessione        # iterazioni già fatte nella sessione
        contesto = FISSO + REGISTRO + dentro * CRESCITA
        contesti.append(contesto)
        letti += contesto
    return letti, contesti, math.ceil(iterazioni / per_sessione)

def it(n):                               # 1648000 -> 1.648.000
    return f"{n:,}".replace(",", ".")

a, ca = senza_niente()
b, cb, volte, _ = con_compattazione(0.8)
b5, cb5, volte5, scrivere5 = con_compattazione(0.5)
c, cc, sessioni = con_ripartenza()
meta = len(ca) // 2
print(f"senza niente: si ferma dopo {len(ca)} iterazioni "
      f"di {ITERAZIONI}, "
      f"letti {it(a)} ({it(sum(ca[:meta]))} nelle prime {meta})")
print(f"compattazione all'80%: {volte} riassunti, picco {it(max(cb))}, "
      f"letti {it(b)}")
print(f"compattazione al 50%: {volte5} riassunti, picco {it(max(cb5))}, "
      f"letti {it(b5)} ({it(scrivere5)} per scriverli)")
print(f"ripartenza: {sessioni} sessioni, picco {it(max(cc))}, letti {it(c)}")
print(f"letti per iterazione, in media: {it(b // ITERAZIONI)}, "
      f"{it(b5 // ITERAZIONI)}, {it(c // ITERAZIONI)}")

# Due voci nella stessa sessione, contro due sessioni da una voce.
insieme = con_ripartenza(2 * PER_SESSIONE, 2 * PER_SESSIONE)[0]
separate = con_ripartenza(2 * PER_SESSIONE, PER_SESSIONE)[0]
print(f"due voci: {it(insieme)} in una sessione, {it(separate)} in due")
senza niente: si ferma dopo 32 iterazioni di 60, letti 1.648.000 (440.000 nelle prime 16)
compattazione all'80%: 2 riassunti, picco 80.000, letti 2.538.000
compattazione al 50%: 4 riassunti, picco 50.000, letti 1.864.000 (206.000 per scriverli)
ripartenza: 4 sessioni, picco 49.000, letti 1.680.000
letti per iterazione, in media: 42.300, 31.066, 28.000
due voci: 1.515.000 in una sessione, 840.000 in due
Senza nessuna strategia il lavoro si ferma dopo trentadue iterazioni, perché la trentatreesima non entra più nella finestra, e a quel punto il modello ha già letto più di un milione e mezzo di token, quasi quattro volte quelli delle prime sedici iterazioni. La compattazione all’ottanta per cento arriva in fondo, ma lascia risalire il contesto fino alla soglia prima di ogni riassunto: legge in media più di quarantamila token per iterazione, con punte di ottantamila, e sui contesti lunghi la qualità cala, come la sezione sul contesto come interfaccia ha già mostrato. La ripartenza legge circa un terzo in meno e non supera la metà della finestra.
A decidere il confronto, però, è la frequenza del taglio più che la strategia: la compattazione al cinquanta per cento, che taglia più o meno ogni quindici iterazioni come la ripartenza, legge poco più di lei, e la differenza sta tutta nelle chiamate che scrivono i riassunti. Due funzionalità nella stessa sessione, infine, leggono quasi il doppio di due sessioni da una funzionalità, perché la seconda si fa su un contesto già pieno della prima: è la seconda ragione del limite di una funzionalità per turno.
Che cosa decida fra compattare e ripartire, allora, non sta in questi numeri: è la qualità di ciò che passa oltre il taglio, ed è il modello. La Fig. 22.3 mostra iterazione dopo iterazione tre delle strategie.
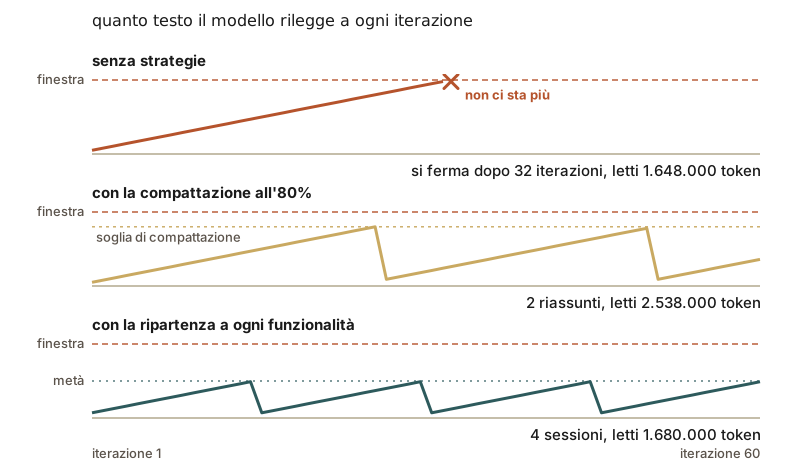
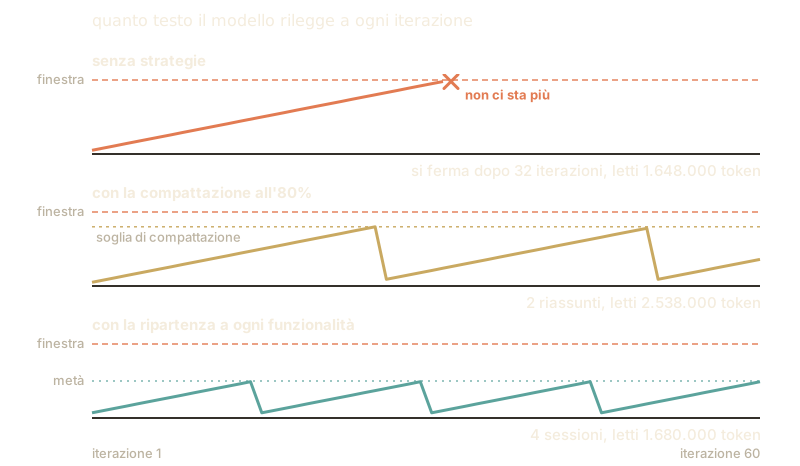
Fig. 22.3 L’occupazione della finestra a ogni iterazione, senza strategie, con la compattazione all’ottanta per cento e con la ripartenza a ogni funzionalità: la linea che sale dritta e si ferma, quella che risale fino alla soglia dopo ogni riassunto, e i denti di sega delle sessioni che ripartono dal registro.#
Il tavolo dell’artigiano è grande quanto è grande, e lui lavora in un modo strano: a ogni mossa rilegge da capo tutti i fogli che ci sono sopra, perché da una mossa all’altra non ricorda niente. Ogni ora sul tavolo arriva un foglio nuovo e niente se ne va, così ogni mossa costa un po” più della precedente, e una giornata lunga il doppio costa quasi quattro volte tanto. Prima o poi il tavolo è pieno, e il lavoro si ferma, se nessuno fa niente.
Una soluzione è sgomberare: quando il tavolo è quasi pieno, l’artigiano rilegge tutto un’ultima volta, scrive su un foglio un riassunto di quello che c’era, butta via il resto e continua. Funziona, ma il foglio l’ha scritto di fretta, nel mezzo del lavoro, e qualcosa che contava è finito nel cestino. L’altra è chiudere il pezzo e smontare: a ogni pezzo finito il tavolo si svuota, e il pezzo dopo comincia con il tavolo libero e il registro aperto, cioè con poche righe scritte con calma dopo la dima. Il rischio è tutto nel registro: se ieri qualcuno ha dimenticato di scrivere che la colla nuova non tiene, oggi nessuno lo sa.
Quale delle due costi meno dipende soprattutto da quanto spesso si sgombera. Chi aspetta che il tavolo sia pieno quasi del tutto lavora a lungo su un tavolo affollato, e a ogni mossa rilegge una montagna di fogli; chi sgombera quando è pieno a metà rilegge poco, quasi quanto chi smonta a ogni pezzo, più la rilettura di tutto che ogni riassunto richiede. Per la stessa ragione due pezzi nella stessa giornata costano più di due giornate da un pezzo: il secondo si fa su un tavolo già pieno delle carte del primo.
E la mattina conta anche quanto è lungo quello che si legge prima di cominciare. Se ogni giorno si rilegge tutto il foglio dell’ordine, duecento righe, e tutto il registro, che si allunga di giorno in giorno, ripartire smette di costare poco: conviene leggere solo le prime righe non spuntate, e ogni tanto riassumere le pagine vecchie del registro, con calma, a fine giornata. È uno sgombero anche quello, fatto al momento giusto.
E c’è artigiano e artigiano. Alcuni, quando vedono il tavolo che si riempie, si agitano e chiudono il lavoro in fretta, anche se di posto ce n’è ancora; con loro sgomberare non basta, perché un tavolo sgomberato non è un tavolo nuovo, e la fretta resta. Conviene farli ripartire da un tavolo vuoto, con un pezzo nuovo. Altri non ci fanno caso, e con loro basta sgomberare quando serve.
Un modello autoregressivo non conserva stato fra una chiamata e l’altra: il ciclo gli rimanda a ogni iterazione il contesto intero, e il costo di un’iterazione, in token letti, è la lunghezza di quel contesto. Sia \(\phi\) il contesto fisso (istruzioni, catalogo), \(d\) la crescita della cronologia per iterazione e \(W\) la finestra. Senza intervento il contesto all’iterazione \(t\), contato da zero, è \(C_t = \phi + t d\), e i token letti in \(T\) iterazioni sono
quadratici in \(T\); il lavoro si interrompe al primo \(t\) con \(\phi + t d > W\), cioè dopo \(\lfloor (W - \phi)/d \rfloor + 1\) iterazioni, che con i valori del programma sono \(32\).
Compattazione e ripartenza tagliano il contesto e ne portano oltre il taglio una versione compressa: la compattazione un riassunto di \(s\) token, quando il contesto supererebbe la frazione \(\sigma\) della finestra; la ripartenza un registro di \(r\) token, ogni \(g\) iterazioni. Su un ciclo fra due tagli il contesto medio è
Con \(\phi = 5000\), \(d = 3000\), \(r = 2000\) e \(g = 15\) la ripartenza dà \(\bar{C}_{\text{rip}} = 28.000\); con \(s = 4000\) la compattazione ha cicli di circa ventiquattro iterazioni per \(\sigma = 0{,}8\) e di circa quattordici per \(\sigma = 0{,}5\). A parità di lunghezza del ciclo le due formule differiscono soltanto per \(r - s\), e alla compattazione si aggiunge la chiamata che scrive il riassunto, che rilegge il contesto intero, circa \(\sigma W\) token per taglio: il costo lo fissa la frequenza del taglio, non il nome della strategia.
Il conto poggia sull’ipotesi che \(r\) sia costante. In realtà \(r\) è ciò che la sessione legge all’avvio, e cresce: il registro si allunga di sessione in sessione, e un elenco di duecento voci letto per intero vale decine di migliaia di token. Con \(r\) di quell’ordine la ripartenza costa per iterazione più della compattazione, e se \(r\) cresce linearmente con il numero di sessioni il termine quadratico ricompare, sulle sessioni invece che sulle iterazioni. Un avvio ben fatto legge dell’elenco soltanto le voci aperte in testa, e del registro una versione potata; e potare il registro è a sua volta una compattazione, fatta al confine di un’unità invece che a metà lavoro.
Lo stesso conto dà la seconda giustificazione del limite al lavoro in corso. Con \(L\) calcolata sul contesto fisso \(\phi + r\), \(m\) voci di \(g\) iterazioni in una sessione sola costano, rispetto a \(m\) sessioni da una voce,
token in più: con \(m = 2\) e i valori del programma, \(675.000\), cioè \(1.515.000\) contro \(840.000\).
Due variabili restano fuori dal conto, e sono quelle che decidono. La prima è la qualità di ciò che attraversa il taglio: riassunto e registro sono compressioni con perdita, che differiscono per il momento, l’ingresso e lo schema. La seconda è la dipendenza dal modello: un modello che anticipa la chiusura del lavoro quando il contesto si avvicina al limite rende la compattazione insufficiente, perché nell’osservazione di Rajasekaran il riassunto conserva la continuità ma non dà una pagina pulita [Raj26]. La cache del prefisso, che la sezione sul context engineering descrive, abbassa il prezzo dei token riletti e cambia i pesi del conto, perché ogni taglio rende nuovo tutto ciò che segue il prefisso fisso; non cambia la finestra né il calo di qualità sui contesti lunghi. Il conto di un compito rifà il calcolo con la cache e i prezzi.
Il turno, la sua routine e il modo di passare le consegne funzionano solo se il segno di «fatto» sull’elenco vuol dire davvero fatto. Che cosa lo rende vero, quando a dichiararlo è lo stesso modello che ha fatto il lavoro, e che tende a giudicarlo con indulgenza, è la domanda del collaudo.
Da ricordare
Ogni turno comincia allo stesso modo: dove sono, che cosa dice il registro, qual è il primo pezzo non spuntato, e una prova che la macchina vada e che i mobili già fatti passino ancora la dima. Se qualcosa si è rotto, si ripara prima.
Un pezzo per turno, fino in fondo, e della misura di una giornata: cinque pezzi intrecciati, a sera, sono cinque pezzi a metà; fatti uno dopo l’altro, al più uno.
La sera: se il pezzo passa la dima si spunta la casella e si scatta la fotografia, se no si rimette il banco com’era; in tutti e due i casi si scrive il registro e si pulisce il banco.
Chi viene dopo riceve il foglio dell’ordine (che cosa), il registro (dove), le fotografie (come) e la pagina delle decisioni (perché). Il perché è la cosa che si perde per prima, perché il mobile non lo dice.
Il registro scritto la sera, con calma, dopo la dima, vale più di un riassunto scritto di fretta a metà giornata.
Sgomberare il tavolo o ripartire da un tavolo vuoto costano più o meno lo stesso, se si sgombera altrettanto spesso. Decidono che cosa passa da un tavolo all’altro, quanto è lungo quello che si rilegge la mattina, e l’artigiano.
Da ricordare
Protocollo: la sessione \(k\) legge \(M_k = (F, \mathbf{p}_{k-1}, R_{k-1}, c_{k-1})\); precondizioni (ambiente, prova minima, \(V_j\) ripassate su un sottoinsieme delle voci riuscite), una sola voce, verifica, poi \(c_k = c_{k-1} \oplus D_k\) se \(V_i = 1\), altrimenti \(c_k = c_{k-1}\). La postcondizione è lo stato pulito che Young chiede al modello [You25].
Come transazione: atomicità e consistenza solo con un controllo esterno al modello; il ritorno ripristina i file, non l’ambiente; durabilità dalla storia; nessun isolamento fra sessioni parallele.
Una voce per sessione: a finestra esaurita resta aperta al più una voce, e \(m\) voci insieme costano \(d g^2 m(m-1)/2\) token in più di \(m\) sessioni.
Quattro memorie: elenco ed esiti (che cosa), registro (dove), storia (come), decisioni (perché, l’unica che non si ricostruisce dal codice).
\(L(T) = T\phi + dT(T-1)/2\); il contesto medio è \(\phi + s + d(n-1)/2\) con la compattazione e \(\phi + r + d(g-1)/2\) con la ripartenza: il costo lo fissa la frequenza del taglio, nell’ipotesi di \(r\) costante, che l’elenco letto per intero e il registro che cresce violano. Quale strategia regga dipende dal modello [Raj26].