



Quando nessuno guarda: osservabilità ed entropia#
Nel progetto di OpenAI scritto da un agente, per un certo periodo la squadra ha dedicato ogni venerdì, un giorno su cinque della settimana, a ripulire il codice da quello che Lopopolo chiama, senza giri di parole, «AI slop»: la roba approssimativa che un agente produce quando nessuno lo corregge [Lop26].
Il motivo era strutturale, perché un agente imita i modi di fare che trova nel repository, compresi quelli storti, e con il tempo il codice deriva. Ma la pulizia del venerdì non ha retto la crescita del progetto, quindi la squadra l’ha sostituita con regole scritte e con compiti di pulizia che girano da soli, a cadenza regolare.
È il problema di qualunque sistema che lavora quando nessuno guarda, e ha due facce. La prima è vedere. Un agente che lavora per ore, di notte, su un’applicazione vera, ha bisogno di vedere che cosa fa l’applicazione, e chi lo sorveglia ha bisogno di vedere che cosa ha fatto l’agente. La seconda è tenere in ordine. Anche quando ogni singola modifica passa i controlli, la somma di migliaia di modifiche tende al disordine, e il disordine si copia.
Dare occhi all’agente#
Lo stesso gruppo di OpenAI, a un certo punto, ha scoperto che il collo di bottiglia non era più scrivere codice ma controllarlo: la capacità delle persone di provare quello che l’agente produceva. La risposta è stata rendere l’applicazione leggibile all’agente stesso.
In concreto, più agenti lavoravano insieme, ciascuno sulla propria copia di lavoro del progetto (il worktree del loop engineering), e ogni copia poteva avviare una sua istanza dell’applicazione, cioè una copia in funzione tutta sua, che l’agente guidava da solo dentro un browser, fotografando le pagine e leggendone la struttura.
Accanto a ogni istanza girava un impianto di osservazione tutto suo, che comprendeva i log, cioè le righe che il programma scrive man mano che lavora, le metriche, cioè i numeri che misura su di sé (quanto ci mette a partire, quante richieste serve al secondo), e le tracce, cioè la storia di ogni singola richiesta attraverso i pezzi del sistema, divisa in intervalli (span), uno per passaggio.
L’agente interrogava log e metriche con i loro linguaggi di interrogazione, come si interroga un database, e a fine compito tutto veniva smontato, così che il compito dopo partisse da un impianto pulito [Lop26].
Con quegli occhi, richieste che prima non si potevano fare diventano trattabili, ad esempio «l’avvio del servizio deve completarsi in meno di 800 millisecondi» e «nessun intervallo dei quattro percorsi critici di un utente deve superare i due secondi» (per un negozio, percorsi come cercare un prodotto o pagare). Sono frasi che un agente può verificare da sé, interrogando le metriche e le tracce. Lopopolo racconta di singole esecuzioni dell’agente che lavorano a un compito per più di sei ore, spesso mentre le persone dormono.
Seguire una richiesta da capo a fondo#
L’altra faccia è vedere che cosa succede dentro il sistema che l’agente costruisce o mantiene, quando qualcosa va storto senza fare rumore. I guasti peggiori di un sistema che risponde con un modello non sono gli errori, che fermano tutto e si notano, ma le risposte plausibili e sbagliate.
Un archivio di documenti interrogato per somiglianza, come quello del RAG, ne offre un esempio classico. I documenti sono stati trasformati mesi fa da un codificatore in vettori, cioè in liste di numeri tutte della stessa lunghezza, e una domanda trova i documenti i cui vettori somigliano al suo, confrontandoli numero per numero; il confronto, però, ha senso solo fra liste della stessa lunghezza.
Un giorno il codificatore delle domande viene aggiornato a una versione che produce liste di un’altra lunghezza, e da quel momento nessuna domanda trova più niente. Se il codice di ricerca, per non bloccarsi su un documento malformato, salta in silenzio i vettori che non si possono confrontare, il servizio non si rompe, e risponde gentilmente che non ha trovato documenti pertinenti.
Lo smaschera un giornale degli eventi, che non va confuso con il registro di avanzamento delle sessioni, perché lo scrive il programma, a ogni fase, e non il modello.
Servono due condizioni. Gli eventi devono essere strutturati, scritti con campi fissi e non come frasi libere, così che un programma (o un agente) li possa filtrare e contare; e siccome nel giornale finiscono, mescolati, gli eventi di tutte le richieste, ogni evento deve portare l’identificativo della richiesta a cui appartiene, così che se ne possa seguire una da capo a fondo attraverso le fasi.
Un programma costruisce il guasto in miniatura, con una domanda sui resi e un archivio di mille documenti, e stampa prima la risposta che vede l’utente, poi il giornale di quella richiesta.
import itertools
import json

contatore = itertools.count(1)
eventi = []                                   # il giornale degli eventi

def registra(richiesta, fase, **campi):
    """Un evento per fase, sempre con l'identificativo della richiesta."""
    eventi.append({"richiesta": richiesta, "fase": fase, **campi})

# L'archivio dei documenti, codificati mesi fa in vettori da 8 numeri.
archivio = {f"doc{i}": [1.0] * 8 for i in range(1000)}

def codifica(testo):
    """Il codificatore, aggiornato ieri: ora produce vettori da 4."""
    return [0.5] * 4

def cerca(richiesta, domanda):
    q = codifica(domanda)
    registra(richiesta, "codifica", lunghezza=len(q))
    candidati, scartate = [], set()           # lunghezze dei vettori scartati
    for nome, v in archivio.items():
        if len(v) != len(q):                  # «prudente»: salta in silenzio
            scartate.add(len(v))
            continue
        candidati.append(nome)
    registra(richiesta, "recupero", visti=len(archivio),
             compatibili=len(candidati), scartate=sorted(scartate))
    return candidati

def rispondi(domanda):
    richiesta = f"r{next(contatore)}"         # lega fra loro gli eventi
    documenti = cerca(richiesta, domanda)
    registra(richiesta, "risposta", documenti=len(documenti))
    if not documenti:
        return "Non ho trovato documenti pertinenti."
    return f"Ecco {len(documenti)} documenti."

# Quello che vede chi usa il servizio: una risposta plausibile.
print(rispondi("Come si restituisce un prodotto difettoso?"))

# Quello che dice il giornale, seguendo la richiesta da capo a fondo.
traccia = [e for e in eventi if e["richiesta"] == "r1"]
for e in traccia:
    print(json.dumps(e, ensure_ascii=False))

dove = next(e for e in traccia if e.get("compatibili") == 0)
print(f"si azzera in «{dove['fase']}»: domanda da {traccia[0]['lunghezza']} "
      f"numeri, archivio da {dove['scartate'][0]}")
Non ho trovato documenti pertinenti.
{"richiesta": "r1", "fase": "codifica", "lunghezza": 4}
{"richiesta": "r1", "fase": "recupero", "visti": 1000, "compatibili": 0, "scartate": [8]}
{"richiesta": "r1", "fase": "risposta", "documenti": 0}
si azzera in «recupero»: domanda da 4 numeri, archivio da 8
Chi legge la sola risposta non ha niente da obiettare, perché può darsi davvero
che nell’archivio non ci sia niente sui resi. Chi segue la richiesta r1 nel
giornale vede invece che mille documenti sono stati esaminati e nessuno era
confrontabile, e che il motivo sta nella fase di recupero, dove la domanda è un
vettore di quattro numeri e i documenti scartati sono vettori di otto.
Due scelte rendono possibile la diagnosi, e stanno tutte e due nel codice che circonda il modello. La prima è che il giornale lo scrive il codice a ogni fase, che qualcuno se ne ricordi o no, e registra quanto entra e quanto esce, il che trova il punto in cui il conteggio va a zero qualunque sia la causa; il campo con le lunghezze ne dà anche il perché. La seconda è che i campi sono quelli di un formato fisso, che un agente può interrogare con la stessa facilità di una persona.
Il caso più insidioso, due codificatori diversi che producono vettori della stessa lunghezza, questo giornale non lo vedrebbe, e lo vede solo un giornale che registra anche quale versione del codificatore ha prodotto ciascun vettore.
Ogni ordine che attraversa la bottega, una cassa con i suoi dodici ripiani, porta con sé un foglio di viaggio. Ogni banco su cui passa ci aggiunge una riga, sempre nelle stesse colonne: il banco, quanti pezzi sono arrivati, quanti ne sono usciti, e perché quelli mancanti mancano. Al taglio: arrivati 12, usciti 12. Alla foratura: arrivati 12, usciti 12. All’incollaggio: arrivati 12, usciti 0, perché i ripiani non entravano nelle casse.
Senza foglio, il cliente riceve una cassa senza ripiani e un biglietto gentile: «spiacenti, oggi niente ripiani». Sembra un caso. Con il foglio, il proprietario segue l’ordine da un banco all’altro e vede in un minuto dove il conteggio è andato a zero: all’incollaggio. Lì scopre che qualcuno ha cambiato le misure dei ripiani nuovi, mentre le casse, fatte mesi fa, sono rimaste quelle di prima; e il banco, per non fermarsi su un pezzo storto, ha messo da parte in silenzio tutti quelli che non combaciavano.
A fine giornata i fogli non restano appesi agli ordini: finiscono tutti nello stesso raccoglitore, mescolati, e a tenere insieme le righe di un ordine è il numero d’ordine scritto in cima a ciascuna. Un banco che lavora in due tempi, prima la pressa e poi il morsetto, scrive due righe rientrate sotto la sua: il foglio è un piccolo albero, e se il conteggio va a zero dentro un banco si vede anche in quale dei suoi passaggi.
Le righe non le scrive l’artigiano quando gli viene in mente: su ogni banco c’è un contapezzi che conta da solo i pezzi che entrano e quelli che escono, e stampa la riga. Così sono annotate anche le cose che nessuno pensava di dover annotare, ed è da quelle che si capisce un guasto che nessuno aveva previsto.
Si stampa a inchiostro: nessuno cancella la riga di un altro banco, e la sera si può ripercorrere il viaggio dell’ordine banco per banco, com’è andato davvero. Il raccoglitore non lo legge solo il proprietario: lo legge anche l’artigiano di domani, prima di mettere le mani su un ordine che si è fermato.
Dare occhi agli artigiani vuol dire anche un’altra cosa. Ognuno ha un banco di prova tutto suo, dove monta il mobile appena fatto e lo usa come lo userebbe il cliente, con un termometro sulla pentola della colla e un orologio sulla pressa; la sera il banco di prova si smonta, e domani si riparte da uno pulito. Così «la colla a sessanta gradi per dieci minuti» diventa una cosa che chiunque può controllare leggendo due numeri, invece di una sensazione; e siccome un termometro oscilla, la si controlla su più letture, non su una sola.
Una traccia, nel senso dei sistemi distribuiti, è un albero di intervalli (span): ogni intervallo ha un identificativo di traccia comune, un proprio identificativo, quello del genitore, un nome, un inizio, una fine e degli attributi. Il modello è quello di Dapper, il sistema di tracciamento di Google [SBB+10], reso poi standard da progetti aperti come OpenTelemetry.
Per un agente la corrispondenza è diretta. Una sessione è una traccia, un passo
del ciclo è un intervallo, una chiamata a uno strumento o al modello è un
intervallo figlio, con attributi come i token letti e scritti, l’esito, la
durata. La traccia di un agente ReAct, la successione di pensieri, azioni e
osservazioni del capitolo sugli agenti, è il caso di un albero con un solo ramo. Nel
giornale della richiesta r1 l’identificativo è la traccia nella sua forma
minima, e le fasi sono gli intervalli, senza tempi né gerarchia.
Con questa rappresentazione «dove si è perso il segnale» diventa un’interrogazione. Si cerca il primo intervallo il cui attributo (qui il numero di candidati compatibili) cade a zero, e lo si confronta con il proprio ingresso e con l’intervallo che gli ha passato i dati. In altri termini, è l’operazione che una persona farebbe a occhio, resa eseguibile da un programma, e quindi da un agente che diagnostica un fallimento sulle tracce, come chiede l’attribuzione dei fallimenti dell’anatomia dell’harness.
Per il giornale dell’agente valgono due condizioni. La prima riguarda la posizione. L’harness sta sull’unico canale fra il modello e il mondo, la sequenza dei contesti montati, delle azioni e delle osservazioni \((C_{k,t}, a_{k,t}, o_{k,t})\), per cui un giornale scritto lì è completo per costruzione rispetto a ciò che l’agente ha visto e fatto, mentre uno scritto dal modello contiene ciò che il modello ha scelto di annotare. Ed è indipendente da chi viene osservato, come il metro della sezione sul collaudo. Per il codice dell’applicazione, come il servizio dell’esempio, la stessa completezza si ottiene imponendo eventi strutturati con un controllo statico, che è ciò che fa la squadra di Lopopolo.
La seconda condizione è che il giornale sia accodato e non riscritto, una sequenza di tuple \((k, t, C_{k,t}, a_{k,t}, o_{k,t})\) in cui ogni passo aggiunge senza modificare. Permette di ripercorrere a posteriori che cosa il modello ha visto a ogni passo, a patto di registrare il contesto davvero montato, cioè dopo un’eventuale compattazione; non permette di rigiocare, perché \(a \sim P_\theta\) è un campionamento, a meno di registrare anche le uscite del modello e di rieseguire soltanto il resto.
Le metriche esposte all’agente trasformano un requisito di prestazione in un predicato, con una cautela. Una latenza è una variabile aleatoria, quindi «avvio in meno di 800 millisecondi» va posto su un quantile, stimato su \(n\) prove a carico noto, del tipo \(q_{0{,}95} < 0{,}8\ \text{s}\); «nessun intervallo oltre i due secondi» è un massimo, la statistica più sensibile al rumore. Lopopolo le presenta come richieste che diventano trattabili per l’agente, non come cancelli, e dichiara di tenere al minimo i cancelli che bloccano l’integrazione: le prove instabili si rilanciano, invece di fermare tutto.
L’entropia, e la pulizia che non finisce#
Il disordine che cresce da solo, quando nessuno lo contrasta, ha un nome preso dalla fisica, entropia, e Lopopolo lo usa in questo senso largo. Che serva pulire vale per qualunque codice scritto da un agente.
Infatti un agente impara dal contesto, e il contesto è il repository, quindi quando scrive codice nuovo imita i modi di fare che vede intorno, quelli buoni e quelli cattivi. Una scorciatoia lasciata una volta diventa un esempio, l’esempio diventa un’abitudine, e l’abitudine si moltiplica a ogni sessione. Lopopolo lo chiama deriva [Lop26].
La risposta della sua squadra ha due parti. La prima è scrivere nel repository dei «principi d’oro», regole meccaniche e perentorie: preferire le librerie di funzioni condivise a quelle che ogni agente si scrive a mano, così che una regola stia in un posto solo; non indovinare la forma dei dati, ma controllarla nel punto in cui entrano, o usare librerie che dichiarano i tipi, così che l’agente non possa costruire per sbaglio su una forma supposta.
La seconda è la pulizia continua: a cadenza regolare dei compiti in sottofondo, eseguiti da agenti, cercano gli scostamenti dai principi, aggiornano un documento che dà un voto di qualità a ogni parte del prodotto, e aprono richieste di modifica piccole e mirate, che per lo più si rivedono in meno di un minuto e si integrano da sole.
Il debito tecnico, scrive Lopopolo, è come un prestito a interesse alto: conviene quasi sempre ripagarlo un poco alla volta, di continuo, invece di lasciarlo crescere e affrontarlo a ondate dolorose; e così gli schemi storti si trovano e si correggono ogni giorno, invece di lasciarli diffondere per giorni o settimane.
Un modello a numeri tondi fa vedere che cosa conta. Calcola la frazione del codice che segue uno schema storto, sessione dopo sessione, in due mondi: uno in cui una scorciatoia si copia in proporzione a quanto è diffusa, e uno in cui si copia più volentieri, per contagio.
La pulizia corregge a ogni passaggio una parte del codice storto, e la sua forza si misura con la permanenza, cioè quante sessioni resta in media uno schema storto prima di essere corretto. Il programma stampa il disordine medio per quattro permanenze, poi confronta, a permanenza dieci, la pulizia continua con una a ondate che passa ogni cinque sessioni, e infine guarda che cosa succede senza pulizia.
# Un modello a numeri tondi, non una misura: b è la frazione del codice che
# segue uno schema storto. A ogni sessione si riscrive una parte del codice,
# e il codice nuovo copia gli schemi che trova.
RISCRITTO = 0.2         # frazione del codice riscritta a ogni sessione
ERRORE = 0.1            # probabilità di sbagliare copiando uno schema sano
CONTAGIO = 0.4          # quanto più volentieri si copia una scorciatoia
ONDA = 5                # la pulizia a ondate passa ogni cinque sessioni
SESSIONI, REGIME = 600, 300          # le medie si prendono sulle ultime 300

def copia(b, contagio):
    """Probabilità di copiare uno schema storto, se lo è la frazione b."""
    return b + contagio * b * (1 - b)

def deriva(contagio, permanenza=None, a_ondate=False, sessioni=SESSIONI):
    """La frazione storta sessione per sessione. La pulizia corregge ogni
    volta una quota del codice storto, scelta perché uno schema storto resti
    in media `permanenza` sessioni prima di essere corretto."""
    if permanenza is None:
        quota = 0.0
    elif a_ondate:      # in media si aspetta (ONDA - 1) / 2 la prima ondata
        quota = ONDA / (permanenza + (ONDA - 1) / 2)
    else:
        quota = 1 / permanenza
    b, storia = 0.0, []
    for k in range(1, sessioni + 1):
        c = copia(b, contagio)
        nuovo = c + ERRORE * (1 - c)     # il codice riscritto è storto
        tolta = quota if (k % ONDA == 0 or not a_ondate) else 0.0
        b = (1 - RISCRITTO) * b + RISCRITTO * nuovo - tolta * b
        storia.append(b)
    return storia

def media(storia):
    return sum(storia[-REGIME:]) / REGIME

def it(x):                               # 0.167 -> 0,167
    return f"{x:.3f}".replace(".", ",")

print("permanenza   in proporzione   con contagio")
for p in (2, 5, 10, 20):
    print(f"{p:>2} sessioni {it(media(deriva(0, p))):>16} "
          f"{it(media(deriva(CONTAGIO, p))):>14}")
for contagio, nome in [(0, "in proporzione"), (CONTAGIO, "con contagio")]:
    onde = deriva(contagio, 10, a_ondate=True)[-REGIME:]
    print(f"a ondate, permanenza 10, {nome}: media {it(media(onde))}, "
          f"picco {it(max(onde))}")
print(f"senza pulizia, dopo {SESSIONI} sessioni: "
      f"{it(deriva(0)[-1])} e {it(deriva(CONTAGIO)[-1])}")
permanenza   in proporzione   con contagio
 2 sessioni            0,038          0,044
 5 sessioni            0,091          0,127
10 sessioni            0,167          0,290
20 sessioni            0,286          0,541
a ondate, permanenza 10, in proporzione: media 0,167, picco 0,200
a ondate, permanenza 10, con contagio: media 0,289, picco 0,347
senza pulizia, dopo 600 sessioni: 1,000 e 1,000
Con la copia in proporzione il disordine cresce più o meno come la permanenza; con il contagio cresce più in fretta, e a permanenza venti supera la metà del codice, perché uno schema che resta più a lungo viene anche copiato più a lungo.
A parità di permanenza la pulizia a ondate lascia quasi lo stesso disordine medio della continua, ma a dente di sega, con picchi più alti. Senza pulizia, in tutti e due i mondi, il codice finisce storto per intero. La Fig. 22.5 mostra le due pulizie sessione dopo sessione.
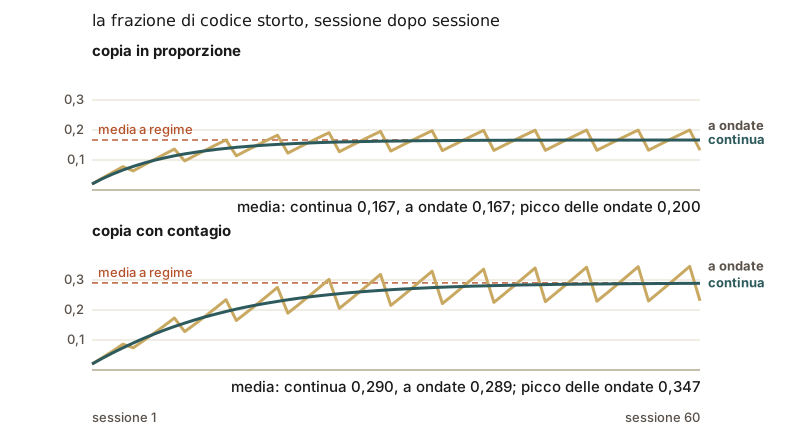
Fig. 22.5 La frazione di codice storto sessione dopo sessione, con la stessa permanenza media: la pulizia continua si assesta su un valore, quella a ondate sale fra un passaggio e l’altro e ricade. Con il contagio tutto il disegno sale.#
In bottega gli artigiani si copiano, e non lo fanno apposta: è il modo più naturale di imparare il mestiere di quella bottega. Se un giorno qualcuno fa un incastro alla svelta, con due chiodi invece della coda di rondine, e lo lascia lì, l’artigiano di domani lo vede e pensa che qui si fa così.
Se nessuno copiasse, i chiodi sarebbero soltanto quelli delle giornate storte, pochi e sparsi; con la copia, un incastro con i chiodi non sparisce più, e ogni giornata storta ne aggiunge altri. E i chiodi si copiano anche più volentieri degli incastri buoni, perché fanno prima: dopo un mese sono dappertutto.
Per un po” il proprietario passa il venerdì a togliere chiodi e rifare incastri. Ma la bottega lavora di più ogni settimana, e in un giorno solo non ce la fa più. Allora cambia metodo, con due mosse che lavorano su due cose diverse. Scrive sul cartello due regole d’oro, «gli incastri si fanno con le sagome della bottega, mai a occhio» e «si misura il legno prima di tagliarlo, mai dopo», e così di chiodi ne nascono meno.
E assume un artigiano notturno che ogni notte gira per la bottega con le regole in mano: non fa in tempo a rifarli tutti, ma ogni notte ne trova e ne rifà una parte, piccolo lavoro per piccolo lavoro, e per ognuno lascia un biglietto. I lavori sono così piccoli che passano da soli; il proprietario, se vuole, la mattina li guarda, un minuto ciascuno.
I chiodi non arrivano mai a zero, perché ogni giorno qualcuno ne pianta di nuovi: il loro numero si ferma dove quelli rifatti ogni notte pareggiano quelli nuovi. Se ne nasce uno al giorno e l’artigiano ne rifà uno su dieci, si ferma intorno a dieci, perché un chiodo resta lì in media dieci giorni. È questa la misura che conta: quanti chiodi ci sono dipende da quanti ne nascono e da quanto a lungo ciascuno resta prima di essere rifatto. E finché resta, chi passa lo copia: un chiodo che resta il doppio non lascia il doppio dei chiodi, ne lascia di più, perché nel frattempo ha fatto figli.
Una pulizia del venerdì che lasciasse ogni chiodo, in media, altrettanto a lungo darebbe più o meno lo stesso disordine, ma tutto concentrato a fine settimana: il giovedì la bottega è piena di chiodi e chi arriva ne trova di più da copiare, e il venerdì il proprietario ha davanti cento incastri rifatti tutti insieme, troppi per guardarli bene. Con l’artigiano notturno il disordine resta basso ogni giorno, e ogni biglietto si guarda in un minuto.
Il modello del programma è a campo medio. Sia \(b_k\) la frazione del codice che segue uno schema storto dopo la sessione \(k\). A ogni sessione una frazione \(\lambda\) del codice viene riscritta; il codice nuovo copia uno schema storto con probabilità \(h(b_k)\) e, dove copia uno schema sano, sbaglia con probabilità \(\varepsilon\); la pulizia corregge la frazione \(\gamma\) del codice storto. Allora
Con la copia in proporzione, \(h(b) = b\), la ricorrenza è lineare, \(b_{k+1} = b_k + \lambda\varepsilon(1 - b_k) - \gamma b_k\), e converge geometricamente, con ragione \(1 - \lambda\varepsilon - \gamma\), al punto fisso
che con i valori del programma (\(\lambda = 0{,}2\), \(\varepsilon = 0{,}1\), \(\gamma = 0{,}1\)) vale \(0{,}02/0{,}12 \approx 0{,}167\). L’imitazione si vede per differenza: senza di essa il codice riscritto devierebbe solo con probabilità \(\varepsilon\), e la frazione si fermerebbe a \(\lambda\varepsilon/(\lambda + \gamma)\), che senza pulizia vale \(\varepsilon\); con l’imitazione e senza pulizia tende a uno, perché lo schema copiato non si diluisce e ogni sessione ne aggiunge.
Si noti però che la copia in proporzione non moltiplica, perché con \(\varepsilon = 0\) un seme di deviazione resta com’è. Il «si moltiplica» chiede una copia che amplifica, come \(h(b) = b + \kappa\, b(1 - b)\) con \(\kappa > 0\), la scorciatoia copiata più spesso di quanto sia frequente; allora, con \(\varepsilon = 0\) e linearizzando in \(b = 0\), \(b_{k+1} \approx (1 + \lambda\kappa - \gamma)\, b_k\), e il seme invade se \(\lambda\kappa > \gamma\).
Per confrontare le pulizie serve la legge di Little: a regime la frazione media è il prodotto del tasso \(A\) a cui nascono le deviazioni e della loro permanenza media \(\bar{W}\),
La pulizia continua dà \(\bar{W} = 1/\gamma\), e con \(A = \lambda\varepsilon(1 - b)\) la legge ritrova \(b^{*}\); una pulizia a ondate che ogni \(P\) sessioni corregge la frazione \(\Gamma\) dà \(\bar{W} \approx P/\Gamma - P/2\), perché ogni deviazione aspetta in media mezzo periodo la prima ondata (nel programma, che corregge alla fine del periodo, \(P/\Gamma - (P - 1)/2\)).
Con la copia in proporzione \(A\) non dipende da quanto le deviazioni restano, e \(\bar{b}\) cresce come \(\bar{W}\) finché \(b\) è piccolo. Con il contagio \(A\) cresce con \(b\), perché ogni sessione di permanenza è anche una sessione in cui la deviazione viene copiata: \(\bar{b}\) cresce più in fretta di \(\bar{W}\), e per \(\bar{W} > 1/(\lambda\kappa)\) il disordine invade anche senza errori nuovi. A parità di \(\bar{W}\) le due pulizie danno quasi la stessa media, esattamente la stessa nel caso lineare, e le ondate un dente di sega con picchi sopra la media.
È la forma del compound con cui Lopopolo descrive il debito tecnico: a contare è la permanenza, e una squadra di capacità fissa la allunga man mano che il codice cresce, che è come falliva la pulizia del venerdì. I principi scritti abbassano \(\varepsilon\), e \(\kappa\) se rendono la scorciatoia meno facile da copiare; la pulizia in sottofondo accorcia \(\bar{W}\). Resta però un modello, con parametri non misurati, che assume codice riscritto a caso, copia che pesca da tutto il repository, dimensioni e parametri costanti e correzioni perfette.
Anche l’harness, a sua volta, accumula. Ogni componente aggiunto per riparare un guasto resta lì quando il guasto non c’è più, e l’anatomia dell’harness ha già detto come si pota: togliendo un componente e guardando che cosa succede (in gergo, un’ablazione), a ogni cambio di modello e con le cautele del caso.
Rajasekaran, nel suo harness a tre agenti (uno che pianifica il progetto, uno che lo costruisce, uno che lo valuta), ci è arrivato per tentativi quando è uscito un modello più recente. Il primo taglio, radicale e fatto tutto insieme, non riproduceva i risultati, e non lasciava capire quali pezzi reggessero il resto; allora ha tolto un componente alla volta, guardando l’esito di una costruzione per volta, senza ripetizioni. Ha tolto la divisione del lavoro in tappe, ha tenuto il pianificatore, senza il quale il costruttore faceva un prodotto più povero di quello chiesto, e ha spostato il valutatore a un solo controllo finale [Raj26].
Un harness che nessuno pota diventa un altro deposito di regole scadute, come il manuale unico che la sezione sul repository come memoria sconsiglia.
Le tracce servono anche a fare i conti: sommando ciò che i loro intervalli registrano, i token letti e scritti e le attese degli strumenti, si ottiene quanto è costato e quanto è durato un compito, ed è da lì che comincia il conto di un compito.
Da ricordare
Un agente che lavora da solo per ore ha bisogno di occhi: vedere che cosa fa l’applicazione (le righe che scrive, i numeri che misura su di sé, il percorso di ogni richiesta). Così «partire in meno di otto decimi di secondo» diventa una cosa che si controlla, su più letture.
I guasti peggiori non fanno rumore: una cosa cambia e un’altra no, un pezzo viene messo da parte senza dirlo, e il sistema risponde gentilmente e sbaglia. Li trova chi segue una richiesta da capo a fondo, con un foglio di viaggio in cui ogni banco scrive sempre nelle stesse colonne.
Il foglio lo riempie il contapezzi a ogni banco, non l’artigiano quando se ne ricorda, e a inchiostro: così si possono ripercorrere anche i guasti che nessuno aveva previsto.
Gli agenti copiano quello che trovano, anche gli errori, e una scorciatoia si copia più volentieri. Le regole d’oro scritte ne fanno nascere meno, la pulizia di ogni notte toglie una parte di quelle nate.
Quanto disordine c’è dipende da quanto ne nasce e da quanto a lungo resta: pulire poco ma ogni giorno lo fa restare poco, e intanto non lo lascia copiare.
Anche l’harness si sporca: le precauzioni che non servono più vanno tolte, una alla volta, guardando che cosa succede.
Da ricordare
Esporre all’agente log, metriche e tracce di un’istanza per copia di lavoro rende trattabili i requisiti di prestazione, da porre su quantili [Lop26].
Una traccia è un albero di intervalli con identificativi comuni [SBB+10]; con eventi strutturati e un identificativo di correlazione, «dove si è perso il segnale» diventa un’interrogazione.
Il giornale dell’agente sta sul canale \((C_{k,t}, a_{k,t}, o_{k,t})\): scritto dall’harness è completo per costruzione, accodato si ripercorre, e si rigioca solo registrando anche le uscite del modello.
Deriva: \(b_{k+1} = (1 - \lambda) b_k + \lambda[h(b_k) + \varepsilon(1 - h(b_k))] - \gamma b_k\). Con copia proporzionale \(b^{*} = \lambda\varepsilon / (\lambda\varepsilon + \gamma)\) e \(b \to 1\) senza pulizia; con contagio il seme invade se \(\lambda\kappa > \gamma\).
Legge di Little, \(\bar{b} = A(\bar{b})\,\bar{W}\): conta la permanenza, e con il contagio il disordine cresce più in fretta di lei; a parità di permanenza le ondate hanno quasi la stessa media e picchi più alti.
L’harness si pota togliendo un componente alla volta e guardando l’esito, a ogni cambio di modello [Raj26].