


Prima il progetto, poi il suono#
Prima di prendere la chitarra, chi scrive una canzone di solito prende un foglio. Ci mette lo schema (strofa, ritornello, seconda strofa, ritornello, ponte, ritornello finale), il tempo, magari la tonalità, e a margine le parole di cui è sicuro. Nessuna nota è ancora stata suonata, e la seconda strofa può essere vuota. Eppure da quel foglio povero dipende ciò che nessuna rifinitura recupera: se il ritornello arriva quando deve, se la canzone dura quanto doveva durare, se a metà strada non ricomincia da capo.
Il testo di una canzone non dice dove cade ciascuna sillaba nel tempo, e ogni sistema ha risposto a modo suo. Per Vocaloid e DiffSinger lo fissa la partitura (la voce che canta); in Jukebox lo impara un’attenzione, e in YuE lo scrive la struttura, sezione per sezione (la canzone come linguaggio); DiffRhythm scrive i fonemi nel frame in cui la frase comincia (tutta la canzone insieme). ACE-Step 1.5 [GSZ+26] risponde con un progetto in anticipo. Un modello di linguaggio, lo stesso tipo di rete che in un chatbot scrive una parola dopo l’altra, stende lo schizzo della canzone; un transformer di diffusione, cioè una pila di strati di attenzione che parte dal rumore e lo toglie da tutta la canzone insieme, ci mette il suono.
Sono due oggetti con due mestieri. Il pianificatore lavora su pochissima informazione e in fila, un elemento dopo l’altro; il renderer lavora su moltissima e su tutta la canzone insieme. Il percorso comincia dal renderer, che è la parte che cambia di più rispetto alla prima versione, passa al pianificatore e a ciò che li rende veloci e fedeli alla richiesta (la distillazione e il rinforzo), e arriva a come si misura una canzone e a ciò che nessuna misura ancora garantisce.
Il renderer cambia pelle: dal mel all’onda#
Nella prima versione di ACE-Step, quella della sezione sulla diffusione su tutta la canzone, il transformer di diffusione lavorava su un mel-spettrogramma compresso, la fotografia del suono con il tempo in orizzontale e le altezze in verticale, e un vocoder, la rete che dalla fotografia ricava l’onda, riportava il risultato al suono. Gli autori indicano proprio nel mel il limite della fedeltà acustica della prima versione [GSZ+26]: nella 1.5 spariscono il mel e il vocoder, e cambia anche l’attenzione del transformer.
La rappresentazione è un autoencoder variazionale monodimensionale che lavora direttamente sull’onda: prende audio stereo a 48 kHz e lo comprime in un latente di 64 canali a 25 frame al secondo [GSZ+26]. Il latente è la versione compressa da cui il decoder dell’autoencoder ricostruisce il suono, e ogni suo frame è una colonna di 64 numeri per un venticinquesimo di secondo. Il paper parla di una compressione di 1920 volte, e il numero è giusto per il passo nel tempo: i fattori di sottocampionamento della configurazione sono 2, 4, 4, 6 e 10, e il loro prodotto è 1920, quindi 48.000 campioni al secondo diventano 25 frame. I numeri si riducono però molto meno: 96.000 al secondo per i due canali contro \(64 \cdot 25 = 1600\), cioè 60 volte meno.
Cambia poi l’attenzione, il meccanismo con cui ogni posizione della sequenza guarda le altre e decide quanto contano per lei. Nella prima versione l’auto-attenzione era lineare, con un costo che cresce in proporzione alla durata; nella 1.5 torna quella classica, con la softmax, il cui costo cresce con il quadrato della durata, e per contenerlo gli strati si alternano [GSZ+26]. Metà degli strati guarda soltanto un intorno di ogni posizione, una finestra scorrevole, per cogliere i dettagli locali come l’attacco di una nota; l’altra metà guarda la canzone intera, per tenere insieme ritmo e melodia dall’inizio alla fine. Le condizioni, cioè la descrizione, il timbro e il testo, entrano come nella prima versione per cross-attention, l’attenzione con cui la canzone guarda una sequenza diversa da sé.
# Dal brano ai numeri che la rete vede: quattro minuti di canzone
D = 240                                   # durata in secondi

onda = 48000 * 2 * D                      # onda stereo a 48 kHz
latente = 64 * 25 * D                     # 64 canali a 25 frame al secondo
token_dit = int(12.5 * D)                 # dopo la patch di 2 frame: 12,5 al secondo
codici = 5 * D                            # i codici del pianificatore, 5 al secondo

print("onda stereo 48 kHz          ", f"{onda:>11,}".replace(",", "."))
print("latente 64 x 25 Hz          ", f"{latente:>11,}".replace(",", "."),
      f"  ({onda / latente:.0f}x meno numeri)")
print("passo nel tempo              ", f"{48000 // 25}x  (48000 campioni / 25 frame)")
print("token del DiT               ", f"{token_dit:>11,}".replace(",", "."))
print("codici del pianificatore    ", f"{codici:>11,}".replace(",", "."))

# Attenzione a finestra contro attenzione globale, in coppie token-token.
# Nel codice la finestra e' bidirezionale, |i-j| <= w: ogni token ne vede
# w prima e w dopo, salvo ai bordi della canzone.
n, w = token_dit, 128
globali = n * n
a_finestra = n * (2 * w + 1) - w * (w + 1)
print()
print(f"{'coppie in uno strato globale':<32}{globali:>11,}".replace(",", "."))
print(f"{'coppie in uno strato a finestra':<32}{a_finestra:>11,}".replace(",", "."))
print(f"{'rapporto':<32}{globali / a_finestra:>11.1f}")
print(f"{'finestra per parte, in secondi':<32}{w / 12.5:>11.2f}")

# Dieci minuti, la durata massima dichiarata: negli strati globali
# le coppie crescono con il quadrato della durata
n10 = int(12.5 * 600)
coppie10 = f"{n10 * n10:>11,}".replace(",", ".")
print(f"{'coppie globali a dieci minuti':<32}{coppie10}")

# GQA: 16 teste di query, 8 di chiavi e valori
print("teste di chiavi e valori / teste di query:", 8 / 16)
onda stereo 48 kHz            23.040.000
latente 64 x 25 Hz               384.000   (60x meno numeri)
passo nel tempo               1920x  (48000 campioni / 25 frame)
token del DiT                      3.000
codici del pianificatore           1.200

coppie in uno strato globale      9.000.000
coppie in uno strato a finestra     754.488
rapporto                               11.9
finestra per parte, in secondi        10.24
coppie globali a dieci minuti    56.250.000
teste di chiavi e valori / teste di query: 0.5
Quattro minuti sono 3.000 token del transformer: un token riunisce due frame del latente, quindi i token sono 12,5 al secondo. Uno strato globale confronta fra loro tutte le coppie di token, nove milioni. Nel codice pubblicato la finestra è simmetrica: ogni token guarda i 128 che lo precedono e i 128 che lo seguono, quindi uno strato a finestra confronta 754.488 coppie, quasi dodici volte meno, e la finestra copre 10,24 secondi da una parte e 10,24 dall’altra. Quello che sta più lontano lo collegano gli strati globali, che però restano cari: a dieci minuti, la durata massima dichiarata dagli autori, le coppie di uno strato globale sono più di cinquantasei milioni.
Chi rifinisce la canzone è un’arrangiatrice, e il suo mestiere è togliere la nebbia: riceve una registrazione coperta di rumore e la ripulisce con più passate, ciascuna su tutta la canzone insieme. Nella prima versione lavorava su una fotografia del suono, e alla fine qualcun altro doveva ritradurre la fotografia in musica, indovinando quello che la fotografia non mostrava. Adesso lavora sulla registrazione stessa, chiusa in una busta sessanta volte più leggera, e dalla busta il suono esce senza che nessuno debba tradurlo.
A ogni passata, poi, ascolta in due modi, a turno. Da vicino, confronta ogni istante soltanto con i dieci secondi prima e i dieci dopo: bastano per sentire se un colpo di batteria è netto o se una consonante cade al suo posto. Da lontano, confronta ogni istante con tutta la canzone, e così si accorge se il ritornello finale ha lo stesso passo del primo.
L’ascolto da vicino costa poco, perché per ogni istante i confronti sono duecentocinquanta circa invece di tremila. Quello da lontano costa quanto prima, e cresce in fretta con la durata: una canzone di dieci minuti chiede più di sei volte i confronti di una di quattro.
Il renderer genera il latente \(\mathbf{x}\) del VAE, 64 canali a 25 Hz, e il decoder lo riporta all’onda senza passare dal mel. È un DiT di 24 strati, con larghezza 2048 e 16 teste da 128. Il paper parla di circa due miliardi di parametri [GSZ+26]; nei pesi pubblicati del modello turbo sono 1,575 miliardi nel transformer e 0,608 negli encoder delle condizioni, quindi la cifra torna contando anche questi.
Tutti gli strati usano la grouped query attention (GQA), con 16 teste di query e 8 di chiavi e valori: ogni coppia di teste di query condivide le stesse chiavi e gli stessi valori. Gli strati dispari, contando da uno, sono a finestra scorrevole, quelli pari globali. Nel codice pubblicato la finestra è bidirezionale: il token \(i\) guarda il token \(j\) se e solo se \(|i-j| \le w\), con \(w = 128\). Su \(n\) token uno strato globale valuta \(n^2\) coppie, uno a finestra
cioè \(2w+1\) coppie per token meno quelle che ai bordi cadono fuori dalla sequenza: il token in posizione \(i < w\), contando da zero, ne perde \(w - i\) a sinistra, e lo stesso succede a destra, quindi mancano \(w(w+1)/2\) coppie per lato. La formula vale per \(n \ge 2w\), e con \(n = 3000\) dà le 754.488 coppie del calcolo.
L’attenzione costa quindi \(O(n^2 d)\) negli strati globali e \(O(nwd)\) in quelli a finestra, con \(d\) la larghezza del modello. Poiché i globali sono metà della pila, il costo resta quadratico in \(n\): per dieci minuti, la durata massima dichiarata, \(n\) sale a 7.500 e uno strato globale valuta 56.250.000 coppie. La GQA non alleggerisce una cache dell’auto-attenzione, che in un DiT non c’è, perché a ogni passo di diffusione la sequenza cambia per intero: dimezza le chiavi e i valori che ogni strato calcola e tiene in memoria (il rapporto 0,5 del calcolo), in auto-attenzione come in cross-attention. Nella cross-attention, anzi, il codice calcola chiavi e valori una volta sola e li riusa a ogni passo, perché le condizioni non cambiano.
L’ingresso del DiT ha \(3 \cdot 64 = 192\) canali per frame: il latente rumoroso \(\mathbf{x}_t\), il latente sorgente e una maschera, concatenati sui canali. Una convoluzione con passo 2, il patchify, porta due frame in un token, e la sequenza scende a 12,5 token al secondo. Le condizioni sono le righe di una matrice \(\mathbf{C}\), che concatena lungo la sequenza la didascalia codificata da un piccolo modello Qwen3 da 0,6 miliardi di parametri, i testi codificati da un encoder di 8 strati e il timbro da uno di 4; il DiT legge \(\mathbf{C}\) per cross-attention [GSZ+26].
Il pianificatore: un modello di linguaggio che scrive lo schizzo#
La terza novità decide la forma della canzone. A scrivere il progetto è un modello di linguaggio basato su Qwen, che gli autori addestrano a fare da «Composer Agent»: prima dei codici audio scrive dei metadati in YAML, un formato di testo fatto di campi e valori, fra cui il tempo in battiti al minuto, la tonalità, la durata e la struttura [GSZ+26]. Lo stesso modello sa fare anche il cammino inverso, dai codici a una didascalia e ai testi, e la ricompensa del rinforzo si appoggia proprio a questa capacità.
I codici sono il ponte con il renderer. Un tokenizzatore riassume ogni finestra di 5 frame del latente in un solo vettore, con uno strato di attenzione (attention pooling), e lo arrotonda a un codice discreto con una quantizzazione scalare finita (FSQ): così i 25 frame al secondo diventano 5 codici [GSZ+26]. Ogni codice è una combinazione di sei valori, con 8, 8, 8, 5, 5 e 5 livelli, quindi il repertorio dei codici conta \(8^3 \cdot 5^3 = 64\,000\) segni. Il pianificatore scrive questi codici, e prima di arrivare al renderer un piccolo detokenizzatore li riporta alla grana del latente, cinque frame per codice: è il latente sorgente, lo schizzo che il renderer riceve accanto al rumore. Fig. 34.6 mostra i due oggetti e la loro frequenza.
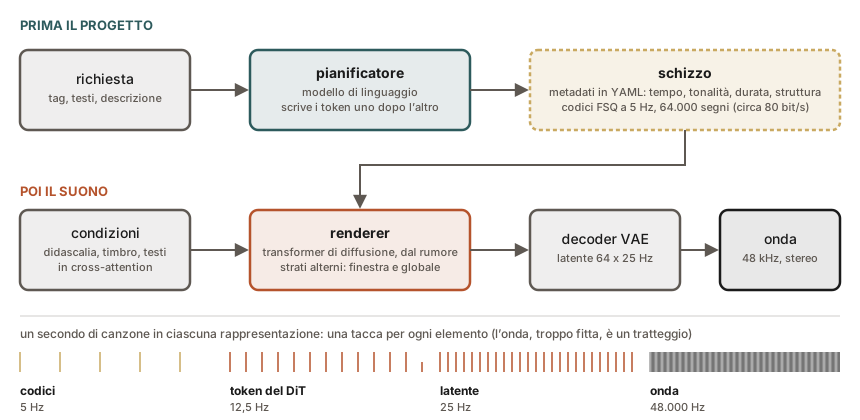
Fig. 34.6 Il progetto prima, il suono poi. Il pianificatore scrive pochi codici in fila; il renderer, condizionato dai codici e dalla richiesta, li trasforma in latente, e il decoder in onda.#
L’ingresso del renderer contiene, oltre al latente rumoroso, il latente sorgente e una maschera che dice quali tratti rifare: cambiare l’uno e l’altra cambia il compito. Lo stesso modello fa così il testo-musica, la cover (si rifà il timbro conservando lo scheletro melodico, che passa attraverso i latenti quantizzati), il repaint, l’estrazione di una traccia, il layering (aggiungere strumenti a una traccia esistente) e il completamento (costruire l’arrangiamento intero attorno a un solo motivo) [GSZ+26]. Nell’addestramento di base la sorgente è silenzio: generare da zero è il caso in cui non c’è niente da conservare. È l’addestramento con le maschere che la prima versione indicava fra i lavori futuri; là il repaint era un artificio della generazione, descritto nella sezione sulla diffusione su tutta la canzone.
import math

# Quanta informazione al secondo porta ogni rappresentazione discreta
def bit_s(livelli, segni, hz):
    return livelli * math.log2(segni) * hz

segni_fsq = math.prod([8, 8, 8, 5, 5, 5])   # combinazioni dei sei valori FSQ
righe = [
    ("token semantici di AudioLM (25 Hz)", bit_s(1, 1024, 25)),
    ("MusicGen, 4 livelli da 2048 (50 Hz)", bit_s(4, 2048, 50)),
    ("X-Codec, 8 livelli da 1024 (50 Hz)", bit_s(8, 1024, 50)),
    (f"codici FSQ, 1 livello da {segni_fsq} (5 Hz)", bit_s(1, segni_fsq, 5)),
]
for nome, b in righe:
    print(f"{nome:<42}{b:>7.1f} bit/s")
print("bit per codice FSQ:", round(math.log2(segni_fsq), 2),
      "  (con 16 bit:", 2**16, "combinazioni)")
print("X-Codec / codici FSQ:", round(righe[2][1] / righe[3][1]))

# Passi in fila per una canzone di tre minuti
D = 180
print()
print("YuE, stadio 1 (voce e accompagnamento):", 50 * 2 * D)
print("MusicGen, con il delay pattern:         ", 50 * D + 4 - 1)
print("pianificatore, codici a 5 Hz:           ", 5 * D)
token semantici di AudioLM (25 Hz)          250.0 bit/s
MusicGen, 4 livelli da 2048 (50 Hz)        2200.0 bit/s
X-Codec, 8 livelli da 1024 (50 Hz)         4000.0 bit/s
codici FSQ, 1 livello da 64000 (5 Hz)        79.8 bit/s
bit per codice FSQ: 15.97   (con 16 bit: 65536 combinazioni)
X-Codec / codici FSQ: 50

YuE, stadio 1 (voce e accompagnamento): 18000
MusicGen, con il delay pattern:          9003
pianificatore, codici a 5 Hz:            900
Lo schizzo porta circa 80 bit al secondo. Un bit è la risposta a una domanda con due possibilità, e 16 bit distinguono \(2^{16} = 65.536\) combinazioni: i 64.000 segni del repertorio sono poco meno, quindi ogni codice vale 15,97 bit, e cinque codici al secondo fanno 79,8 bit. Un codec fatto per essere ascoltato, come X-Codec in YuE, ne porta cinquanta volte di più, e perfino i token semantici di AudioLM, che nella sezione sui token audio fanno già da schizzo, ne portano il triplo. Per una canzone di tre minuti i codici sono 900, da scrivere in fila, contro i 18.000 passi in fila di YuE e i 9.003 di MusicGen, che però scrivono anche il suono, e per questo non si confrontano uno a uno con il pianificatore.
Una cantautrice ha un foglio, e sul foglio non c’è la canzone. Ci sono l’ordine delle parti, il tempo, la tonalità e una fila di segni, uno per ogni quinto di secondo di musica: cinque segni al secondo. È pochissimo. Ogni segno si sceglie come la combinazione di un lucchetto a sei rotelle, tre da otto posizioni e tre da cinque, e le combinazioni possibili sono 8 × 8 × 8 × 5 × 5 × 5 = 64.000. Da quei segni nessuno può suonare niente, ma chiunque li legga sa dove arriva il ritornello e quando la canzone finisce.
Il repertorio è chiuso, e non ci sono segni a metà fra due segni: o è l’uno o è l’altro. Ogni segno poi si scrive guardando quelli già scritti, e per questo il foglio si riempie in fila, un segno dopo l’altro: per tre minuti sono novecento segni, senza poterne scrivere due insieme.
Il foglio passa poi all’arrangiatrice. Lei lavora a venticinque colonne al secondo e il foglio ne ha cinque, così per prima cosa lo ricopia alla sua grana: ogni segno diventa cinque colonne, ritoccate un poco secondo il posto che occupano. Poi toglie la nebbia, passata dopo passata, con il foglio e la richiesta originale sotto gli occhi, cioè le parole, lo stile e la voce da usare: dove il foglio dice ritornello, la pulizia tira verso un ritornello.
Quando imparava il mestiere si è esercitata con un foglio bianco e la sola richiesta, il caso in cui non c’è niente da rispettare, e con fogli ricavati dalle stesse registrazioni su cui lavorava. Quelli della cantautrice li vede soltanto al lavoro, e le servono nella misura in cui somigliano ai fogli ricavati dalle registrazioni. Nessun contratto la obbliga a rispettare il foglio, e di solito lo rispetta perché a ogni passata ce l’ha sotto gli occhi.
Il guaio sta in ciò che il foglio non dice. Cinque segni al secondo sono uno ogni due decimi di secondo, e il foglio fissa dove cade il ritornello ma non su quale battito cade la terza sillaba del primo verso. Quello lo decide l’arrangiatrice da sola, e se sbaglia la parola esce un po” prima o un po” dopo del suo posto.
Il pianificatore è un modello di linguaggio autoregressivo su una sequenza di codici \(\mathbf{z} = (z_1, \dots, z_{n_z})\), con \(n_z = r_z D\) e \(r_z = 5\) Hz; il renderer è un modello di diffusione sul latente \(\mathbf{x}\) (64 canali a 25 Hz), condizionato dai codici e dalla richiesta \(\mathcal{R}\) (tag, testi, timbro). Omessi i metadati YAML che precedono i codici, la cascata fattorizza
dove ogni \(z_i\) prende valori in un insieme finito di 64.000 elementi e la somma corre su tutte le sequenze possibili. In generazione non si somma: si estrae prima \(\mathbf{z}\), poi \(\mathbf{x}\) condizionato a quella sequenza. Il paper descrive quattro modi del modello di linguaggio, tutti nel formato di conversazione ChatML: Planner (dalla richiesta allo schema e ai codici), Listener (dai codici a didascalia e testi), Co-Pilot (da una richiesta a una struttura di canzone) e Refiner (normalizza l’ingresso del renderer).
La scala è fissata dal quantizzatore. Un codice FSQ è una combinazione di sei valori scalari con \((8, 8, 8, 5, 5, 5)\) livelli, quindi \(8^3 \cdot 5^3 = 64\,000\) valori possibili e \(\log_2 64\,000 \approx 15{,}97\) bit; a \(r_z = 5\) Hz fanno circa 80 bit al secondo, cioè un ordine di grandezza e più sotto un codec fatto per l’ascolto. Poiché la griglia è fissa e non c’è un codebook da apprendere, manca anche il collasso del codebook, con segni che restano inutilizzati, il difetto tipico della quantizzazione vettoriale [MMAT24]. Il vincolo che si paga è la fila: la generazione dei codici richiede \(n_z\) passi sequenziali, 900 per tre minuti, lineari nella durata \(D\) e ciascuno poco costoso, a differenza dei passi di diffusione che lavorano su tutta la canzone.
I due modelli si addestrano per scopi diversi: il primo a prevedere il token successivo, il secondo a togliere il rumore dal latente condizionato. Il paper nomina il flow matching solo a proposito della distillazione; il codice pubblicato addestra il renderer con la perdita del flow matching, in cui la rete \(\mathbf{v}_\theta\) impara a stimare il campo \(\mathbf{u} = \boldsymbol{\epsilon} - \mathbf{x}_0\), con \(\mathbf{x}_t = (1-t)\,\mathbf{x}_0 + t\,\boldsymbol{\epsilon}\) e \(t\) estratto da una logit-normale [GSZ+26].
Fra i due modelli c’è un passaggio che la cascata scritta così nasconde: i codici sono 5 al secondo, il latente ha 25 frame. Nel codice pubblicato ogni \(z_i\), riportato al suo vettore della griglia FSQ, passa per un detokenizzatore: il vettore si ripete cinque volte, a ogni copia si somma un vettore appreso che ne indica la posizione nella finestra, due strati di Transformer lavorano sulle cinque copie (ogni codice per conto suo, senza guardare i vicini) e una proiezione lineare le porta a 64 canali. Ne esce il latente sorgente a 25 Hz, che entra nel renderer accanto a \(\mathbf{x}_t\) e alla maschera. In addestramento la sorgente cambia con la fase. Nella fase di base è silenzio, e il renderer impara a generare dalla sola richiesta [GSZ+26]; quando invece è fatta di codici, nella perdita del codice pubblicato questi si ricavano da audio vero, passando il latente sorgente dell’esempio di addestramento per il tokenizzatore e poi per il detokenizzatore. In uso li scrive il pianificatore. Il renderer impara dunque su codici estratti da canzoni vere e li riceve da un modello che li genera: l’impianto regge nella misura in cui i codici del pianificatore somigliano a quelli che il tokenizzatore ricaverebbe da una canzone.
Una garanzia in senso proprio non c’è. Che il progetto fissi la struttura è la ragione con cui gli autori motivano l’impianto, e la rendono plausibile due fatti: gli strati globali del renderer vedono la canzone intera, quindi il progetto li condiziona ovunque, e il latente sorgente è a grana grossa, cioè porta la struttura e lo scheletro melodico, non il dettaglio del suono. Il punto di rottura è l’allineamento fine delle sillabe nel tempo. Un codice ogni 0,2 secondi è una griglia larga per le sillabe, e il paper elenca «precise lyric alignment» fra i lavori futuri [GSZ+26]: è coerente con un progetto che decide dove arriva il ritornello e lascia al renderer il battito di ogni sillaba.
Distillare il renderer, rinforzare i due modelli#
Il renderer di base genera in 50 passi, e a ogni passo applica la guida senza classificatore: la stessa rete viene valutata due volte, con la richiesta e senza, e il passo va oltre la stima con la richiesta, nella direzione in cui la richiesta la sposta. La versione turbo fa otto passi e senza guida [GSZ+26], e ci arriva per distillazione: un secondo modello, lo studente, impara a ottenere in pochi passi ciò che il modello di partenza, il maestro, ottiene in molti, come nella sezione sulla distillazione a pochi passi. Allo studente non si chiede di ripercorrere i passi del maestro, ma di produrre canzoni distribuite come quelle che il maestro giudica plausibili; un discriminatore, una seconda rete che impara a riconoscere i risultati dello studente, lo costringe intanto a renderli meno riconoscibili.
Gli autori scrivono che lo studente supera il maestro, e ne danno due ragioni: errori di discretizzazione più piccoli e il discriminatore, che rende più nitide le tessiture [GSZ+26]. La prima si capisce guardando che cosa imita lo studente: non le canzoni che il maestro produce in 50 passi, ciascuno dei quali aggiunge un piccolo errore, ma la direzione in cui il maestro, in ogni punto, renderebbe il suono più plausibile. Così lo studente non eredita l’errore che si accumula nei 50 passi.
# Il renderer: passi di diffusione, ciascuno su tutta la canzone
base_passi, turbo_passi = 50, 8
base_valutazioni = base_passi * 2      # con la guida: con e senza richiesta
turbo_valutazioni = turbo_passi * 1    # senza guida: una sola
print("DiT base: ", base_passi, "passi,", base_valutazioni, "valutazioni della rete")
print("DiT turbo:", turbo_passi, "passi,", turbo_valutazioni, "valutazioni della rete")
print("valutazioni in meno:", base_valutazioni / turbo_valutazioni, "volte")
DiT base:  50 passi, 100 valutazioni della rete
DiT turbo: 8 passi, 8 valutazioni della rete
valutazioni in meno: 12.5 volte
Con la guida 50 passi fanno 100 valutazioni della rete, mentre otto passi senza guida ne fanno otto: dodici volte e mezzo in meno. Il conto è delle valutazioni e non dei secondi, che dipendono dalla macchina.
Il rinforzo ha un altro compito: non rende i modelli più veloci, li rende più fedeli alla richiesta, e usa ricompense che si ricavano dai modelli stessi, senza giudici esterni. Sul transformer di diffusione si applica DiffusionNFT [ZCY+26], e la ricompensa è l’Attention Alignment Score, calcolato sulle mappe di cross-attention fra i token del testo e i frame. Il punteggio mette insieme tre proprietà: la copertura (ogni token del testo riceve attenzione), la monotonia (i token vengono letti nell’ordine in cui sono scritti) e la confidenza del cammino che il dynamic time warping (DTW) traccia sulla mappa [GSZ+26]. Un esempio in miniatura ne calcola le prime due su una mappa di sei token e ventiquattro frame; è un giocattolo e non il punteggio del paper, che passa per la DTW e aggiunge la terza proprietà.
import numpy as np

# Una mappa di cross-attention in miniatura: 6 token del testo, 24 frame.
# Ogni frame distribuisce la propria attenzione sui token (softmax sui token).
n_tok, n_fr = 6, 24
frame = np.arange(n_fr)

def mappa(centri, spento=None):
    logit = -((frame[None, :] - np.asarray(centri)[:, None]) ** 2) / (2 * 2.0**2)
    if spento is not None:
        logit[spento] = -50.0              # nessun frame guarda questo token
    e = np.exp(logit - logit.max(axis=0))
    return e / e.sum(axis=0)

def punteggi(A):
    massa = A.sum(axis=1)                          # attenzione totale ricevuta da ogni token
    copertura = np.mean(massa >= 0.5)              # quota di token davvero letti
    centroidi = (A * frame).sum(axis=1) / massa
    monotonia = np.mean(np.diff(centroidi) > 0)    # quota di coppie in ordine
    return copertura, monotonia

ordinati = np.array([2, 6, 10, 14, 18, 22])
casi = {
    "ordinata": mappa(ordinati),
    "un token saltato": mappa(ordinati, spento=3),
    "due token scambiati": mappa(ordinati[[0, 3, 2, 1, 4, 5]]),
}
print(f"{'mappa':<22}{'copertura':>10}{'monotonia':>11}")
for nome, A in casi.items():
    c, m = punteggi(A)
    print(f"{nome:<22}{c:>10.2f}{m:>11.2f}")
mappa                  copertura  monotonia
ordinata                    1.00       1.00
un token saltato            0.83       1.00
due token scambiati         1.00       0.60
Una mappa ordinata ha copertura e monotonia a 1. Un token che nessun frame guarda abbassa la copertura (5 token su 6), e due token scambiati abbassano la monotonia (3 coppie su 5 in ordine): sono due dei modi in cui un testo cantato si perde, una parola saltata e due parole fuori posto.
Sul modello di linguaggio si applica invece GRPO [SWZ+24], con una ricompensa costruita sull’informazione mutua puntuale (PMI) fra i codici e la didascalia. Lo stesso modello, usato al contrario come ascoltatore, prova a ricostruire la didascalia dai codici che ha scritto, e la ricompensa è alta quando i codici rendono la didascalia molto più probabile di quanto sarebbe senza di loro. Una didascalia generica, probabile comunque, guadagna poco; una specifica di quei codici guadagna molto. La ricompensa finale è una somma pesata, che gli autori dicono dinamica, con il 50% sull’atmosfera di stile, il 30% sul testo e il 20% sui metadati [GSZ+26]. La Tabella 1 del paper valuta la configurazione senza rinforzo, quindi l’effetto del rinforzo non compare nei numeri che riporta.
L’arrangiatrice di prima, la maestra, faceva cinquanta passate di pulizia, e a ogni passata ascoltava due volte: una con la richiesta davanti e una senza. Poi spingeva il suono un po” oltre il primo ascolto, nella direzione in cui la richiesta lo cambiava. Cento ascolti per canzone. La sua allieva impara a fare otto passate con un solo ascolto ciascuna: la spinta in più non la ricalcola, perché l’ha assorbita nel gesto.
Come si insegna una cosa così? Non facendole copiare passata per passata, e nemmeno facendole copiare i lavori finiti della maestra: ogni passata della maestra lascia una piccola sbavatura, e cinquanta passate ne lasciano cinquanta. Alla maestra si chiede soltanto, davanti a un lavoro dell’allieva, da che parte lo renderebbe più credibile, e l’allieva si corregge in quella direzione. Un esaminatore, intanto, si allena a riconoscere i lavori dell’allieva, e lei impara a non farsi riconoscere. Per questo può capitare che l’allieva faccia meglio della maestra: le sbavature delle cinquanta passate non le eredita, e l’esaminatore le affina il suono.
Il rischio sta nello stesso modo di correggere: a un’allieva giudicata soltanto su quanto i suoi lavori somigliano a quelli della maestra non costa niente tralasciare le versioni più rare, purché quelle che presenta sembrino tutte della maestra. La scuola tiene comunque tutte e due: chi ha tempo per cinquanta passate continua a chiamare la maestra.
Poi arrivano i voti, e nessun giurato esterno li dà: li danno controlli fatti sul lavoro stesso. All’arrangiatrice si chiede se ha letto tutte le parole del testo, se le ha lette nell’ordine in cui sono scritte e con quanta sicurezza ha tenuto il filo. Alla cantautrice si chiede un’altra cosa: che rileggendo il proprio foglio come se non l’avesse scritto lei sappia ricostruire la descrizione che le era stata data, «ballata malinconica», meglio di quanto la indovinerebbe senza foglio. Una descrizione generica si indovina anche senza leggere niente, e un foglio che la rispetta guadagna poco. Lo stile e l’atmosfera contano metà del voto, il testo tre decimi, e l’ordine delle parti, il tempo e la tonalità scritti in testa al foglio i due decimi che restano. E il voto è relativo: per ogni richiesta si fanno più prove, e ciascuna conta per quanto è meglio o peggio delle altre.
Un controllo meccanico però si può imbrogliare: chi impara a farlo passare fa salire il voto senza migliorare la canzone. E i risultati che la scuola ha pubblicato vengono da una cantautrice e da un’allieva che quei voti non li hanno mai ricevuti.
Il renderer di base integra l’equazione del flusso in 50 passi con la guida senza classificatore, che a ogni passo combina due valutazioni della stessa rete,
dove \(\mathbf{v}_{\mathcal{R}}\) e \(\mathbf{v}_{\varnothing}\) sono la rete \(\mathbf{v}_\theta\) valutata in \((\mathbf{x}_t, t)\) con la richiesta e senza, e \(\omega > 1\) è la scala della guida (la \(w\) della sezione sulla guida, rinominata per non confonderla con la finestra dell’attenzione). Costa due valutazioni per passo, 100 in tutto. Il modello turbo ne fa 8 senza guida, una per passo: lo studente deve quindi incorporare nel proprio campo l’effetto che il maestro ottiene combinando le due valutazioni, ed è il vincolo dell’impianto, oltre alla scala dei passi. Il calendario dei passi è deformato dallo shift \(\kappa\), \(t \mapsto \kappa t / \big(1 + (\kappa - 1)\,t\big)\), che con \(\kappa > 1\) addensa i passi vicino a \(t = 1\), cioè al rumore; in addestramento \(\kappa\) si estrae fra 1, 2 e 3, in inferenza vale 3 [GSZ+26].
Il metodo, che gli autori chiamano Decoupled DMD2, parte dal DMD2 [YGP+24]: lo studente minimizza la KL inversa fra la propria distribuzione e quella del maestro, diffuse allo stesso livello di rumore, con un gradiente che passa per la differenza dei due punteggi. Decoupled DMD [LGL+25] scompone quel gradiente, quando il maestro usa la guida, in due termini: un’amplificazione della guida (CFG augmentation), che secondo i suoi autori è il vero motore della distillazione a pochi passi, e la corrispondenza delle distribuzioni, che fa da regolarizzatore; ai due assegna calendari di rumore separati. In questa lettura è il primo termine a portare dentro lo studente l’effetto della guida. ACE-Step vi aggiunge una perdita avversaria nel latente, con un discriminatore a base ConvNeXt [GSZ+26].
Che lo studente superi il maestro non discende dall’obiettivo da solo: uno studente che ne eguagliasse esattamente la distribuzione sarebbe il maestro. Conta quale distribuzione fa da bersaglio. Nel DMD è quella definita dal punteggio del maestro, valutato sulle versioni rumorose dei campioni dello studente, e non quella che il campionatore del maestro (il solutore che integra il flusso un passo alla volta) produce in 50 passi, con l’errore di discretizzazione dell’integrazione. È la prima ragione degli autori; la seconda è il discriminatore, che secondo loro rende più nitide le tessiture [GSZ+26], e che nel DMD2 confronta i campioni dello studente con dati veri, così che lo studente impari anche dai dati e non solo dal punteggio, imperfetto, del maestro [YGP+24]. Il paper di ACE-Step non dice con quali campioni il suo discriminatore li confronti. Una garanzia non c’è: il confronto fra studente e maestro è empirico.
Può contribuire anche la ricerca della moda della KL inversa, che gli autori non nominano: concentra i campioni dove il maestro mette più massa, e così favorisce la qualità del singolo campione a scapito della copertura delle modalità. È il rischio che la famiglia DMD si porta dietro, e per un generatore musicale vorrebbe dire canzoni più simili fra loro; per ACE-Step è un rischio del metodo, che il paper non misura. Il modello turbo, poi, non rimpiazza gli altri: il modello base e quello sft, messo a punto con supervisione, restano a 50 passi con guida.
Il rinforzo si applica ai due oggetti con due ricompense. Sul renderer l’algoritmo è DiffusionNFT, che lavora sul processo in avanti con l’obiettivo del flow matching: contrappone le generazioni riuscite a quelle mancate per ricavarne una direzione di miglioramento, senza stimare verosimiglianze e senza guida [ZCY+26]. La ricompensa è l’Attention Alignment Score, calcolato sulle mappe di cross-attention fra i token del testo e i frame, di cui misura anche l’accordo fra le due direzioni, dal token al frame e dal frame al token; gli autori partono dall’ipotesi che una generazione scadente vada insieme a mappe ad alta entropia [GSZ+26]. Detto \(\alpha_{i,j}\) il peso con cui il frame \(i\) guarda il token \(j\) del testo, il centroide del token è
La copertura è la quota di token con un picco di attenzione significativo, la monotonia penalizza i centroidi che non avanzano al crescere di \(j\), e la confidenza del cammino è l’energia media della mappa lungo il cammino che la DTW vi traccia; il punteggio aggrega le tre proprietà lungo quel cammino. Si massimizza: è una ricompensa, e più alta è meglio. Nell’esempio in miniatura la copertura conta i token con \(\sum_i \alpha_{i,j} \ge 0{,}5\), e la monotonia le coppie consecutive di centroidi in ordine; la soglia di 0,5 e i quattro frame per token sono scelte dell’esempio, perché il paper parla soltanto di picchi significativi.
Sul modello di linguaggio la ricompensa si appoggia all’informazione mutua puntuale fra i codici \(\mathbf{z}\) e la didascalia \(y\),
dove le due forme coincidono per la regola di Bayes. La seconda è quella che il paper commenta: il modello fa anche da ascoltatore, dai codici alla didascalia, e una didascalia generica, già probabile senza codici, guadagna poco, mentre ne guadagna una specifica dei codici generati. Il primo termine è ciò che il modo ascoltatore produce, la probabilità della didascalia dati i codici. Il secondo è il difficile: \(p(y) = \sum_{\mathbf{z}} p(y \mid \mathbf{z})\,p(\mathbf{z})\) è una somma su tutte le sequenze di codici, lo stesso insieme sterminato della cascata, e non si calcola; il paper non dice come lo stima. Con GRPO il vantaggio di ogni sequenza è la sua ricompensa standardizzata nel gruppo delle risposte alla stessa richiesta, come nella sezione sul post-training. Se la didascalia fosse la stessa per tutto il gruppo, \(\log p(y)\) sarebbe una costante e la standardizzazione la cancellerebbe: il termine pesa quando le didascalie cambiano da una risposta all’altra, come succede quando è il modello stesso a scriverle, insieme ai metadati, prima dei codici. La ricompensa finale è una somma pesata, 0,5 sull’atmosfera di stile, 0,3 sul testo e 0,2 sui metadati.
Il punto di rottura è quello di ogni ricompensa: il modello può imparare a farla salire invece di migliorare, il difetto che la sezione sul post-training discute con la legge di Goodhart. Qui si aggiunge che la configurazione valutata nel paper è senza rinforzo, quindi il beneficio non è misurato nei numeri riportati.
Abbozzare a patch alterne, suonare in tempo reale#
Il progetto in anticipo non è l’unico modo di dare una forma alla canzone, e due lavori mostrano che cosa si fa quando non si può o non si vuole.
SongBloom [YWC+25] non scrive lo schizzo di tutta la canzone prima del suono: li alterna. Abbozzo e suono si tagliano in tratti della stessa lunghezza, 0,64 secondi, e si generano a turno: l’abbozzo di un tratto vede il suono già reso, e il suono di un tratto vede l’abbozzo fino a lì. L’abbozzo è fatto di codici discreti a 25 Hz, ricavati da un modello audio auto-supervisionato, MuQ [ZZC+25]; il suono, dei latenti continui di un VAE. Un modello autoregressivo scrive l’abbozzo, e la stessa architettura, usata come transformer di diffusione, rende il suono. ACE-Step 1.5 dichiara di essersi ispirato a SongBloom per il proprio VAE [GSZ+26], e con lui condivide l’idea di uno schizzo discreto accanto al suono continuo; differisce nel momento in cui lo schizzo si scrive.
Magenta RealTime [LyriaTeamCM+25] rinuncia del tutto al progetto in anticipo, perché genera mentre qualcuno suona. Un live music model deve produrre audio a una velocità pari o superiore al tempo reale, in streaming causale e con controlli che reagiscono. La velocità è il fattore di tempo reale (RTF), che nel paper è il rapporto fra secondi di audio e secondi di calcolo; il paper stesso avverte che altrove si usa il rapporto inverso. Il suono si genera a blocchi di 2 secondi, ciascuno predetto dai 5 blocchi precedenti, cioè dagli ultimi 10 secondi. A scriverlo sono i token di SpectroStream, un codec a quantizzazione residua come quelli della sezione sui codec neurali, che lavora a 25 frame al secondo con 64 livelli da 1024 segni; per il tempo reale si generano soltanto i primi 16 [LyriaTeamCM+25].
import math

# SpectroStream, il codec di Magenta RealTime: 25 frame al secondo,
# livelli da 1024 segni; in tempo reale si generano solo i primi 16
hz, segni = 25, 1024
for livelli in (64, 16):
    token = livelli * hz
    bit = token * math.log2(segni)
    print(f"{livelli} livelli: {token} token/s, {bit:.0f} bit/s")
64 livelli: 1600 token/s, 16000 bit/s
16 livelli: 400 token/s, 4000 bit/s
Con i primi 16 livelli sono 400 token e 4.000 bit al secondo, quanti ne porta X-Codec in YuE e un quarto del codec completo. La dimensione del blocco è un limite inferiore al ritardo con cui un controllo si fa sentire: chi cambia lo stile può aspettare due secondi o più prima di sentirlo.
Il vincolo di fondo è quello del video che scorre, descritto nella sezione sul tempo reale nel video: si genera in avanti, senza conoscere il seguito. Gli autori lo dichiarano fra i limiti: con dieci secondi di contesto il modello non può riferirsi a ciò che ha suonato prima, e questo basta per melodie, ritmi e giri di accordi, ma non per costruire da solo la struttura lunga di una canzone [LyriaTeamCM+25].
Misurare una canzone#
Una canzone generata non ha un modello «vero» con cui confrontarla, e nessuna misura da sola risponde a tutte le domande che interessano: se suona come un brano reale, se somiglia alla descrizione, se le parole si capiscono, se piace. Si usano quindi misure diverse, ciascuna con un verso (se il valore buono è il più alto o il più basso) e con un modo suo di sbagliare.
La FAD (Fréchet Audio Distance) [KZRS19] confronta due insiemi di brani, quelli generati e quelli di un insieme di riferimento, attraverso i loro embedding, cioè i vettori di numeri che una rete addestrata a riconoscere suoni assegna a ogni brano, come nella sezione sui codec neurali. È una distanza e si minimizza, e dice qualcosa dell’insieme, mai del singolo brano.
Il punteggio CLAP usa CLAP (Contrastive Language-Audio Pretraining), che la sezione sulla generazione di audio e musica nomina di passaggio come guida di AudioLDM. CLAP impara per contrasto a portare audio e testo nello stesso spazio di vettori: in addestramento avvicina i vettori di una coppia vera audio-testo e allontana quelli delle coppie sbagliate. Alla fine il coseno fra il vettore di una descrizione e quello di un brano, che vale 1 quando i due vettori puntano nella stessa direzione e 0 quando sono perpendicolari, misura quanto i due si corrispondono. Per addestrare LAION-CLAP [WCZ+23] gli autori hanno raccolto LAION-Audio-630K, 633.526 coppie audio-testo. Un esempio in miniatura calcola coseni e perdita su quattro coppie inventate, già portate nello stesso spazio, e la stessa perdita con quattro didascalie estratte a caso, senza legame con i brani.
import numpy as np

rng = np.random.default_rng(0)

# Quattro canzoni e le loro quattro didascalie, già portate nello stesso spazio
# a 8 dimensioni: ogni coppia condivide una direzione, più un po' di rumore.
n, d = 4, 8
base = rng.normal(size=(n, d))
audio = base + 0.5 * rng.normal(size=(n, d))
testo = base + 0.5 * rng.normal(size=(n, d))

def unitari(x):
    return x / np.linalg.norm(x, axis=1, keepdims=True)

def perdita(testi, brani, tau=0.1):
    # la perdita contrastiva dal testo all'audio: log-softmax della coppia vera
    S = unitari(testi) @ unitari(brani).T
    logp = S / tau - np.log(np.exp(S / tau).sum(axis=1, keepdims=True))
    return float(-np.diag(logp).mean())

S = unitari(testo) @ unitari(audio).T          # coseno di ogni testo con ogni audio
print("coseno testo-audio (righe: testi, colonne: brani)")
print(np.round(S, 2))
print("coppie vere (diagonale), media:", round(float(np.diag(S).mean()), 2))
fuori = S[~np.eye(n, dtype=bool)]
print("coppie sbagliate, media:       ", round(float(fuori.mean()), 2),
      f"(da {fuori.min():.2f} a {fuori.max():.2f})")

# la stessa perdita con quattro didascalie a caso, senza legame con i brani
a_caso = rng.normal(size=(n, d))
print("perdita contrastiva, didascalie vere:  ", round(perdita(testo, audio), 3))
print("perdita contrastiva, didascalie a caso:", round(perdita(a_caso, audio), 3))
print("tirare a indovinare fra 4, log 4:      ", round(float(np.log(n)), 3))
coseno testo-audio (righe: testi, colonne: brani)
[[ 0.81  0.08 -0.17 -0.49]
 [ 0.06  0.77  0.22  0.15]
 [ 0.38  0.41  0.71 -0.4 ]
 [-0.2   0.16  0.25  0.66]]
coppie vere (diagonale), media: 0.74
coppie sbagliate, media:        0.04 (da -0.49 a 0.41)
perdita contrastiva, didascalie vere:   0.029
perdita contrastiva, didascalie a caso: 3.486
tirare a indovinare fra 4, log 4:       1.386
Le coppie vere hanno un coseno medio di 0,74, quelle sbagliate di 0,04 in media, pur spaziando da \(-0{,}49\) a \(0{,}41\): il punteggio CLAP di un brano è il coseno con la sua descrizione, e più alto è meglio. La perdita contrastiva serve invece ad addestrare. Con le didascalie vere vale 0,029, con quelle estratte a caso 3,486, più di \(\log 4 \approx 1{,}386\), che è la perdita di chi, non sapendo niente, dà la stessa probabilità a tutti e quattro i brani. Con una temperatura bassa le didascalie a caso non restano incerte: puntano con sicurezza su un brano, e quando il brano è sbagliato la coppia vera riceve una probabilità quasi nulla, che la perdita fa pagare cara. L’addestramento porta dalla seconda situazione verso la prima, avvicinando le coppie vere e allontanando le altre.
L’intelligibilità del testo cantato si misura con un riconoscitore vocale, come il WER (word error rate, la quota di parole sbagliate rispetto al testo) del riconoscimento vocale, ma con varianti pensate per le canzoni; SongEval [YMX+25], infine, raccoglie giudizi umani su canzoni intere.
Un concorso canoro ha bisogno di più giudici, perché ciascuno guarda una cosa diversa. Il primo ha in mano il foglio con le parole e conta quante ne sente sbagliate: meno errori, meglio la canzone. Ma se la band suona forte sente parole che non ci sono, e non per colpa della cantante. Prima della gara lo stesso giudice ascolta una canzone vera dal vivo e poi dal registratore della serata: le parole che sbaglia in più le ha perse il registratore. Un suo collega segue invece le parole col dito mentre la canzone va, e dice quanto è sicuro del punto in cui si trova: più è sicuro, meglio è. Con una chitarra sola ci riesce meglio che con un’orchestra, e così premia senza volerlo le canzoni spoglie.
Il secondo non ascolta una canzone sola: confronta l’intera serata con una serata di cantanti veri e dice quanto le due si somigliano. Più si somigliano, meglio è; di una singola esibizione non sa dire niente.
Il terzo ha in mano il cartello dell’annuncio, «ballata malinconica», e decide quanto l’esibizione ci entra: più ci entra, meglio è. Ha però ascoltato poca musica in vita sua, e il concorrente che per lui c’entra meno può essere quello che il pubblico ama.
Poi c’è una giuria di musicisti, che vota su cinque cose: se la canzone sta in piedi, se si ricorda, se la voce respira e fraseggia, se la forma si capisce, se è musica. Un apprendista ha imparato a votare guardando i loro voti, e ci va molto vicino; ma ha imparato su esibizioni quasi tutte di cantanti artificiali, un terzo delle quali uscite dalla sua stessa scuola, e il suo gusto potrebbe essere il gusto di quella scuola.
Le misure, una per una, con il verso e il loro limite.
FAD: la distanza fra due insiemi di embedding, trattati come due gaussiane. Più bassa è meglio. Giudica l’insieme e non dice niente del singolo brano.
Punteggio CLAP: il coseno fra testo e audio nello spazio comune. Più alto è meglio. Un CLAP non specifico per la musica può non cogliere ciò che conta.
PER e WER: fonemi o parole di un riconoscitore contro il testo. Più bassi sono, meglio è. L’accompagnamento disturba il riconoscitore.
\(\Delta\)WER: quanto cresce il WER dopo la tokenizzazione. Più basso è meglio. Misura il codec, non il modello.
Confidenza dell’allineamento forzato: la media delle confidenze di un allineamento fra testo e audio. Più alta è meglio. Favorisce i generi con strumentazione rada.
SongEval: il voto di un predittore addestrato su giudizi umani di cinque dimensioni, per canzone. Più alto è meglio. Il predittore è appreso sulle uscite degli stessi sistemi che classifica.
Il punteggio CLAP è il coseno fra i vettori che due encoder, uno per il testo e uno per l’audio, producono nello spazio comune. Gli encoder si addestrano per contrasto: su un lotto di \(B\) coppie, detto \(s_{ij} = \cos(\mathbf{e}^{\text{testo}}_i, \mathbf{e}^{\text{audio}}_j)\) il coseno fra la didascalia \(i\) e il brano \(j\), LAION-CLAP minimizza
con \(\tau\) una temperatura appresa [WCZ+23]. Qui la lettera è una
temperatura, e non il tempo in secondi che indica nella sezione sulla voce che canta. Ogni riga e ogni colonna
della matrice dei coseni diventano una classificazione fra \(B\) candidati, in cui
la classe giusta è la coppia vera. L’esempio delle quattro coppie calcola il
primo dei due termini, dal testo all’audio, con una \(\tau = 0{,}1\) fissa, che
nel codice si chiama tau.
YuE, che ha il CLAP più basso fra i sistemi che confronta (0,118), scrive che metriche tradizionali come il CLAP score non si allineano alle preferenze umane [YLG+25]; ACE-Step nella prima versione lo affianca a MuLan, perché CLAP non è specifico per la musica [GZW+25]. Il PER si calcola come il WER, cioè sostituzioni, cancellazioni e inserzioni divise per la lunghezza del riferimento, ma sui fonemi, perché un riconoscitore può percepire il canto come parole diverse con una pronuncia coerente [NCJ+25]; e si misura sul mix, quindi con l’accompagnamento che disturba. Il \(\Delta\)WER di YuE è \(\mathrm{WER}_{\text{ric}} - \mathrm{WER}_{\text{ori}}\), la differenza fra il WER sull’audio ricostruito dal codec e quello sull’originale, misurati con un Whisper messo a punto sulle canzoni; cresce dall’hip-hop al pop e al metal [YLG+25]. La confidenza dell’allineamento forzato, che ACE-Step usa nella prima versione [GZW+25], traccia con la programmazione dinamica un cammino sulle mappe di cross-attention di Whisper, un riconoscitore esterno, fra i token del testo e l’audio. Nella 1.5 la stessa tecnica diventa una ricompensa, ma le mappe sono quelle del DiT stesso: misura l’allineamento che il generatore ha usato per produrre il brano, non quello che un riconoscitore ritrova nel brano finito.
SongEval raccoglie 2.399 canzoni, per oltre 140 ore, valutate da 16 annotatori con formazione musicale su cinque dimensioni: coerenza complessiva, memorabilità, naturalezza di respiri e fraseggio, chiarezza della struttura e musicalità [YMX+25]. I predittori addestrati sul dataset arrivano a una correlazione lineare di circa 0,91 con il giudizio umano per singola canzone: è una correlazione e non una percentuale di accordo, come invece la presenta la prima versione di ACE-Step con il suo «oltre il 90%» [GZW+25]. Le due cautele sono che le canzoni sono quasi tutte generate, un terzo (32,1%) da DiffRhythm, e che il dataset viene dallo stesso gruppo di DiffRhythm. Anche i punteggi di Audiobox Aesthetics [TWG+25], che la prima versione di ACE-Step usa per filtrare i dati e la 1.5 per valutare, sono stime: nella valutazione di SongEval i suoi quattro assi correlano in media con il giudizio umano fra 0,41 e 0,66, contro lo 0,91 del predittore addestrato sul dataset [YMX+25].
Le velocità di generazione si confrontano con una cautela in più, perché il fattore di tempo reale si scrive in due versi. DiffSinger e DiffRhythm dividono il tempo di calcolo per la durata dell’audio, e più basso è meglio; ACE-Step e Magenta RealTime dividono la durata per il tempo, e più alto è meglio. Chi confronta numeri di paper diversi guarda prima il verso.
Quando una valutazione automatica manca, si ascolta: durante l’addestramento della prima versione di ACE-Step gli autori ascoltavano le canzoni generate ogni 2.000 passi, perché non ne avevano una [GZW+25].
Che cosa resta aperto#
I limiti che gli autori dichiarano per la prima versione sono elencati nella sezione sulla diffusione su tutta la canzone: la lotteria dei tentativi, che scrive il report, e le note della model card, cioè le giunzioni del repaint, il canto grossolano e la struttura che oltre i cinque minuti può perdersi, già fuori dai quattro minuti (2584 frame del latente) del contesto massimo di addestramento. Per la 1.5 scrivono che le capacità restano limitate dal numero di parametri, tenuto basso perché il modello giri su hardware di consumo, e mettono fra i lavori futuri la ricchezza acustica, le lingue e gli stili, la conoscenza del mondo nelle didascalie e l’allineamento preciso dei testi [GSZ+26]. Dei sistemi commerciali chiusi, come Suno e Udio, non risulta una descrizione tecnica pubblicata, e quindi non se ne può dire il meccanismo.
Del copyright e del consenso sui dati di addestramento si occupa la sezione sulla generazione di audio e musica, nella parte sui limiti aperti; delle filigrane, quella sul marchiare il sintetico. Per la copia vale la misura di YuE, nella sezione sulla canzone a token: un riconoscitore di cover confronta i brani di addestramento con quelli generati, e la somiglianza resta nettamente sotto quella delle cover vere e moderata anche rispetto alle canzoni dello stesso genere [YLG+25]. È una misura e non un verdetto: dice quanto il generato somiglia, non se viola un diritto. Restano un meccanismo nuovo e una dichiarazione.
Il meccanismo nuovo sta in AudioSeal [SRFDefossez+24], in cui un generatore e un rilevatore si addestrano insieme. Il generatore produce una filigrana additiva, un segnale che si somma all’audio, e il rilevatore dà una probabilità per ogni campione, con una risoluzione di un sedicimillesimo di secondo. La novità è la localizzazione, cioè dire quali campioni sono sintetici in un audio in parte vero. Il sistema è addestrato sul parlato a 16 kHz; il paper lo prova anche sulla musica generata da MusicGen, dove la rilevazione va come sul parlato, mentre la localizzazione è misurata soltanto sul parlato. La dichiarazione viene dai progetti aperti: quelli come ACE-Step ammettono nei loro README il rischio di una violazione involontaria per somiglianza di stile, e chiedono di dichiarare l’uso dell’AI.
Da ricordare
Una canzone si pianifica prima di suonarla. ACE-Step 1.5 divide il lavoro in due: un modello di linguaggio, la cantautrice, scrive il foglio con l’ordine delle parti, il tempo, la tonalità e cinque segni al secondo; un secondo modello, l’arrangiatrice, ne ricava il suono togliendo la nebbia.
L’arrangiatrice lavora sulla registrazione stessa, chiusa in una busta sessanta volte più leggera, e ascolta a turno da vicino, dieci secondi per parte, e da lontano, la canzone intera.
Il foglio è povero apposta: ogni segno è una delle 64.000 combinazioni di un lucchetto a sei rotelle. Basta a decidere dove arriva il ritornello, ma non su quale battito cade ogni sillaba.
L’allieva fa otto passate invece di cinquanta, con un ascolto invece di due, e può fare meglio della maestra perché non ne eredita le sbavature; ma la maestra resta a disposizione, e un’allieva giudicata solo sulla somiglianza rischia di tralasciare le versioni più rare.
A premiare questi modelli sono controlli fatti sul loro stesso lavoro: tutte le parole lette, nell’ordine giusto, e un foglio da cui si ricostruisce proprio quella descrizione. Si possono imbrogliare.
Misurare una canzone vuol dire usare più giudici: per le parole, per l’insieme, per la descrizione, e una giuria di musicisti per il resto. Di ognuno bisogna sapere se il voto buono è alto o basso, e dove sbaglia.
Da ricordare
ACE-Step 1.5 [GSZ+26] separa il progetto dal suono: un modello di linguaggio scrive metadati in YAML e codici FSQ a 5 Hz (64.000 valori, circa 80 bit/s), e un detokenizzatore li riporta a 25 Hz come latente sorgente del renderer. In addestramento la sorgente è silenzio o codici ricavati da audio vero; in uso i codici li scrive il pianificatore.
Il renderer è un DiT che usa la GQA in tutti gli strati (16 teste di query, 8 di chiavi e valori), con i dispari a finestra bidirezionale di 128 token per parte e i pari globali, sul latente di un VAE sull’onda (64 canali a 25 Hz, 48 kHz stereo). I 1920 del paper sono il passo nel tempo, mentre i numeri si riducono di 60. Il costo resta quadratico negli strati globali.
Il renderer turbo fa 8 passi senza guida contro i 50 con guida del base: 8 valutazioni della rete invece di 100. Il metodo unisce il DMD2 alla lettura di Decoupled DMD, per cui il motore della distillazione è l’amplificazione della guida, più una perdita avversaria. Lo studente può superare il maestro perché il bersaglio è il punteggio del maestro, non i campioni del suo campionatore a 50 passi con il loro errore di discretizzazione, e per il discriminatore; resta il rischio di diversità ridotta della famiglia DMD, che il paper non misura.
Il rinforzo ha due ricompense dal modello stesso: l’Attention Alignment Score sul renderer, con DiffusionNFT (copertura, monotonia, confidenza del cammino), e la PMI fra codici e didascalia sul pianificatore, con GRPO e pesi 0,5, 0,3 e 0,2; il termine \(\log p(y)\) non si calcola esattamente, e il paper non dice come lo stima. I numeri valutati nel paper sono senza rinforzo.
Ogni misura ha un verso e un punto di rottura: FAD, PER, WER e \(\Delta\)WER si minimizzano; CLAP, la confidenza dell’allineamento e SongEval si massimizzano. Il valore 0,91 di SongEval è una correlazione, e il dataset viene dallo stesso gruppo di uno dei sistemi che serve a classificare. L’RTF si scrive in due versi.
Il progetto non è l’unica forma: SongBloom alterna abbozzo e suono a tratti di 0,64 s; Magenta RealTime genera a blocchi di 2 s, rinuncia a pianificare e con 10 s di contesto non costruisce da sé la struttura lunga. Restano aperti l’allineamento fine dei testi e la copia; AudioSeal localizza la filigrana, ma è addestrato sul parlato, e la localizzazione è provata solo lì.
Strofa, ritornello e ponte sono una forma che il modello deve pianificare o indovinare, e che in una canzone ha almeno il vantaggio di stare in fila, un secondo dopo l’altro. Altri dati portano la loro forma scritta insieme ai valori, e non stanno in fila. Chi ha suonato con chi nei dischi di una scena musicale è uno di questi: se un batterista ha inciso con tre chitarristi, in qualunque ordine si mettano i quattro in fila almeno uno dei tre finisce lontano dal batterista, e il legame che li univa non si vede più. Dati così sono grafi, e li trattano le reti neurali su grafo.