


Generare mentre il video scorre: tempo reale e mondi#
Premi la freccia a destra e il personaggio deve fare un passo. Su una console il fotogramma che lo mostra arriva subito, senza che tu avverta un’attesa. Un generatore di video con l’attenzione tridimensionale piena ti darebbe il passo dopo il clip intero: ripulisce insieme tutti i fotogrammi, e non ne mostra nessuno finché non sono pronti tutti. Nel lavoro che ha introdotto CausVid un generatore di questo tipo impiega 219 secondi per 128 fotogrammi, e una sua versione che li produce uno dopo l’altro comincia a mostrarli dopo 1,3 secondi [YZZ+25]. Per guardare un video, aspettare il clip intero va bene. Per giocarci dentro no, perché il fotogramma dopo dipende da un tasto che non hai ancora premuto.
Perché il video esca fotogramma dopo fotogramma bisogna cambiare l’ordine in cui il modello genera, il modo di addestrarlo, il numero di passi e la memoria che si porta dietro. Con in più i comandi di chi gioca, il risultato è il mondo interattivo che la sezione su Genie e sui mondi da giocare ha già raccontato; qui interessa che cosa lo rende possibile a ogni fotogramma.
Il fotogramma prima del clip: la fattorizzazione causale#
In un generatore bidirezionale tutti gli \(F'\) fotogrammi latenti, cioè i fotogrammi compressi dall’autoencoder video, si ripuliscono insieme. A ogni passo di diffusione ogni token (un pezzo di fotogramma latente, l’unità che il Transformer di diffusione elabora) guarda tutti gli altri, del passato e del futuro, e nessun fotogramma è definitivo finché i passi non sono finiti su tutta la sequenza. Per generare un solo fotogramma il modello deve elaborare l’intera sequenza, futuro compreso [YZZ+25].
Per mostrare il fotogramma \(i\) appena è pronto si scrive la probabilità del video intero come un prodotto di probabilità condizionate, una per fotogramma, ciascuna dato il passato. È la regola della catena, la stessa con cui un modello linguistico genera una parola dopo l’altra:
dove \(\mathbf{x}^{i}\) è il fotogramma latente \(i\) e \(\mathbf{x}^{<i}\) sono quelli che lo precedono. Ogni fattore è a sua volta un processo di diffusione: il fotogramma \(i\) parte da rumore e in \(T\) passi si ripulisce, condizionato sul passato già generato [HLH+25]. Spesso il fattore non è un fotogramma solo ma un blocco di \(k\) fotogrammi latenti, dentro il quale l’attenzione resta bidirezionale mentre fra un blocco e l’altro è causale; lo schema prende il nome di attenzione causale a blocchi. CausVid usa blocchi di cinque fotogrammi latenti, quanti il suo autoencoder ne decodifica insieme [YZZ+25]; Self Forcing ne prova di tre e di uno [HLH+25].
Il blocchetto animato, quello che si sfoglia col pollice per vedere un disegno muoversi, si può riempire in due modi. Il primo è quello dei generatori bidirezionali: tutte le pagine stanno sul tavolo insieme, coperte di macchie, e il disegnatore le ripassa tutte a turno, cinquanta volte. A ogni ripassata guarda ogni pagina insieme alle altre, anche a quelle che vengono dopo, e per questo il blocchetto finito è coerente da cima a fondo. Finché però non ha dato l’ultima ripassata all’ultima pagina, sul tavolo non c’è nessuna pagina pulita da mostrare. Per un film va bene. Per un gioco no: la pagina successiva dipende da un tasto che il giocatore non ha ancora premuto, e non può già stare sul tavolo.
Il secondo modo è quello di chi disegna davvero un blocchetto. Parte dalla prima pagina e procede per blocchi di poche pagine: un blocco alla volta, da macchie a disegno con poche ripassate, finché è pulito e può essere mostrato. Guarda soltanto i blocchi già finiti, mai quelli che verranno; dentro il blocco che sta disegnando, invece, le pagine si guardano fra loro, perché stanno ancora sul tavolo insieme. Per non rileggere tutto da capo a ogni blocco nuovo, tiene accanto un taccuino (la KV cache, quella dei modelli linguistici), in cui di ogni pagina finita ha annotato ciò che serve a consultarla. Per annotare una pagina appena finita la rilegge una volta, pulita, e la scrive nel taccuino.
Il prezzo si vede subito. Il pubblico vede un blocco solo quando è pulito, quindi la prima immagine arriva dopo il primo blocco intero, e tanto più tardi quanto più il blocco è grande. E chi disegna guardando solo il passato non può correggere una pagina guardando quella dopo, che è il vantaggio del tavolo con tutte le pagine: a parità di allenamento i blocchetti vengono un po” peggio, e una pagina venuta storta resta nel taccuino, sotto gli occhi di quelle che seguono.
Nell’attenzione bidirezionale ogni token vede tutti gli \(N = F'S\) token della sequenza, e la latenza prima del primo fotogramma coincide con il tempo del clip intero, cioè di \(T\) passi della rete sull’intera sequenza. L’attenzione causale a blocchi di CausVid restringe i collegamenti con una maschera additiva \(\mathbf{M}\), sommata ai punteggi prima della softmax come la maschera causale dei modelli linguistici:
dove \(i\) e \(j\), contati da zero, sono gli indici dei fotogrammi latenti di chi guarda e di chi è guardato (ogni elemento vale per tutti gli \(S\) token del fotogramma) e \(k\) è il numero di fotogrammi latenti di un blocco. Lo zero lascia passare il punteggio, \(-\infty\) lo annulla dopo la softmax; il paper scrive la stessa maschera come indicatore, con 1 dove il collegamento è lecito e 0 dove è vietato [YZZ+25]. Dentro un blocco l’attenzione resta bidirezionale; fra blocchi è causale.
In inferenza, per ogni blocco si eseguono i \(T\) passi di denoising con le query del blocco corrente e le chiavi e i valori dei blocchi precedenti letti dalla cache; poi una passata a \(t = 0\) sul blocco ormai pulito ne scrive chiavi e valori nella cache [YZZ+25]. La cache contiene quindi solo chiavi e valori calcolati su fotogrammi puliti, come nella KV cache dei modelli linguistici.
Restano due limiti. La latenza ha un pavimento, perché i fotogrammi di un blocco si ripuliscono insieme e quindi nessun pixel esce prima che sia finito il primo blocco; in CausVid il vincolo viene anche dal VAE, che decodifica a blocchi di cinque fotogrammi latenti, sedici di video. Il paper lo scrive così, sedici fotogrammi in cinque latenti, ed è un rapporto che la regola \(F' = 1 + (F-1)/c_t\) del VAE causale non dà per nessun \(c_t\) intero: con \(F' = 5\) la regola dà \(F = 1 + 4c_t\), che è dispari. E la restrizione al passato riduce la qualità, perché i modelli di diffusione causali in generale rendono meno dei bidirezionali e l’errore di un blocco entra nel contesto dei successivi [YZZ+25].
Il tempo reale chiede due numeri, la latenza del primo fotogramma e il numero di fotogrammi al secondo che si sostiene dopo, e i due tirano in versi opposti. Raggruppare i fotogrammi in blocchi alza la frequenza, perché la rete fa meno passate, ciascuna su più token che la GPU elabora in parallelo, e allunga l’attesa del primo, perché prima che esca qualcosa bisogna finire un blocco. Self Forcing misura le due varianti sulla stessa GPU H100, e ottiene 17,0 fotogrammi al secondo e 0,69 secondi di latenza con blocchi di tre fotogrammi latenti, 8,9 fotogrammi al secondo e 0,45 secondi con un fotogramma per volta [HLH+25]. Poiché il modello di Self Forcing produce video a 16 fotogrammi al secondo, solo la prima variante li genera più in fretta di come si guardano. Con lo stesso criterio CausVid, che sostiene 9,4 fotogrammi al secondo su video a 12, resta sotto il tempo reale, e i suoi autori lo dichiarano: la loro implementazione arriva a circa 10 fotogrammi al secondo, e ottimizzazioni d’ingegneria (compilazione, quantizzazione, parallelismo) potrebbero portarla al tempo reale [YZZ+25].
Imparare dal proprio passato: exposure bias e tre regimi di addestramento#
Un modello causale va addestrato a continuare un video. Il modo più semplice gli dà come passato il video vero: per ogni fotogramma, il contesto sono i fotogrammi precedenti presi dai dati. In uso, però, il contesto è quello che il modello ha generato, con i suoi piccoli errori, e l’errore di un fotogramma diventa ingresso del successivo. È lo scarto fra addestramento e uso che la sezione sulla traduzione automatica ha chiamato exposure bias; lì l’errore era una parola, qui è un fotogramma intero. Oltre l’orizzonte di addestramento, scrivono Chen e colleghi, i piccoli errori fra un fotogramma e l’altro si accumulano e il modello diverge [CMMD+24].
Il meccanismo si vede senza nessun modello di diffusione. Un «video» è un’onda che si ripete ogni 60 fotogrammi; il modello la continua con la ricorrenza \(x_{i+1} = 2\cos(\omega)\,x_i - x_{i-1}\), che per una sinusoide di frequenza \(\omega\) è esatta, ma con \(\omega\) stimata il 2% troppo alta:
import numpy as np

# Un "video" è un'onda. Il modello continua con la ricorrenza
# x[i+1] = 2 cos(w) x[i] - x[i-1], con una frequenza stimata il 2% troppo alta.
n = 300
omega = 2 * np.pi / 60
c = 2 * np.cos(1.02 * omega)                       # il modello
c_vero = 2 * np.cos(omega)                         # la dinamica vera
x = np.sin(omega * np.arange(n))                   # il video vero

# addestramento: ogni passo parte dal passato vero
errore_vero = np.abs(c * x[1:-1] - x[:-2] - x[2:]).mean()

# uso: ogni passo parte dai fotogrammi che il modello ha già prodotto
y = list(x[:2])
for i in range(2, n):
    y.append(c * y[-1] - y[-2])
y = np.array(y)
# lo sbaglio di ogni passo, quando il passato è quello del modello
sbagli = np.abs((c - c_vero) * y[1:-1])
distanza = np.abs(y - x)

print(f"errore di un passo, passato vero:    {errore_vero:.5f}")
print(f"errore di un passo, passato proprio: {sbagli.mean():.5f}")
for i in (10, 50, 100, 200, 299):
    print(f"distanza dal video vero al fotogramma {i:3d}: {distanza[i]:.5f}")
somma = sbagli.sum()
rapporto = distanza[299] / errore_vero
print(f"distanza finale / errore di un passo: {rapporto:.0f}")
print(f"somma degli sbagli di un passo fino al 299: {somma:.5f}")
print(f"distanza finale / somma degli sbagli: {distanza[299] / somma:.1f}")
errore di un passo, passato vero:    0.00028
errore di un passo, passato proprio: 0.00027
distanza dal video vero al fotogramma  10: 0.00684
distanza dal video vero al fotogramma  50: 0.07281
distanza dal video vero al fotogramma 100: 0.06645
distanza dal video vero al fotogramma 200: 0.28972
distanza dal video vero al fotogramma 299: 0.59298
distanza finale / errore di un passo: 2095
somma degli sbagli di un passo fino al 299: 0.08162
distanza finale / somma degli sbagli: 7.3
Se ogni passo parte dal passato vero, il modello sbaglia in media di 0,00028 e sembra eccellente. Lasciato continuare dai propri fotogrammi, al fotogramma 299 dista 0,59 dal video vero, più di duemila volte tanto (la distanza sale oscillando con l’onda, per questo al fotogramma 100 è più piccola che al 50). Eppure lo sbaglio del singolo passo è rimasto lo stesso, 0,00027 sul passato proprio, e nemmeno la somma degli sbagli spiega la distanza: fino al fotogramma 299 gli sbagli di un passo sommano 0,082, e la distanza è 7,3 volte tanto. Lo sbaglio di un passo, infatti, non resta dov’è. Il fotogramma un po” sbagliato diventa il passato del successivo, e la ricorrenza lo porta avanti con l’onda: il modello continua con un’onda appena più veloce di quella vera, che a ogni fotogramma guadagna un po” di fase e non la restituisce più, e lo sfasamento cresce con il tempo. In un modello vero c’è anche di peggio, perché un passato mai visto in addestramento fa sbagliare di più anche il passo singolo; la ricorrenza dell’esempio è lineare e questo non lo mostra, quindi dice come l’errore si propaga e non quanto cresce in un modello vero.
Sono tre i modi di costruire il contesto durante l’addestramento, e la Fig. 33.4 li mette in fila. Nel teacher forcing il contesto è il video vero e pulito. In Diffusion Forcing [CMMD+24] è ancora il video vero, ma ogni fotogramma porta un livello di rumore indipendente dagli altri. In Self Forcing [HLH+25] il contesto lo ha generato il modello stesso, con la cache, esattamente come accadrà in uso, e il video intero si confronta con quelli di un modello bidirezionale già addestrato, il maestro, invece che con video registrati.
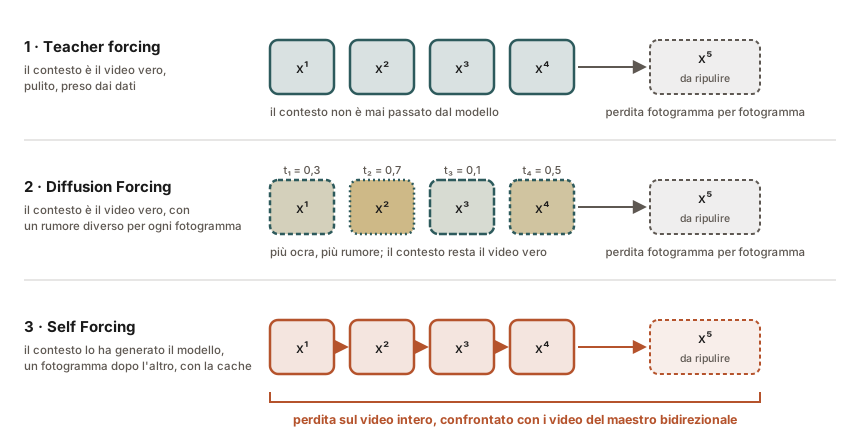
Fig. 33.4 Che cosa vede il modello come passato mentre impara a ripulire un fotogramma, nei tre regimi: video vero e pulito, video vero con rumore indipendente per fotogramma, video generato dal modello stesso.#
Il disegnatore di blocchetti impara da un insegnante con un metodo preciso. L’insegnante gli mostra un film vero, pagina per pagina: per ogni pagina da disegnare gli lascia sotto gli occhi la precedente, quella vera, e lui disegna la successiva. È il metodo a cui nessuno vuole rinunciare, perché l’insegnante conosce in anticipo tutte le domande (il passato sta già scritto nel film) e può farle tutte insieme sul tavolo. È il teacher forcing della traduzione automatica: il passato lo impone l’insegnante.
Poi il disegnatore va in scena, e nessuno gli passa pagine vere: continua dalle proprie. Una linea un po” storta alla pagina 4 diventa il punto di partenza della 5, e il disegnatore, che a lezione non ha mai visto una pagina così, disegna una 5 storta di suo e per ciò che ha ereditato. Il blocchetto prende una piega, e più va avanti più la piega cresce. A lezione ha visto solo passati perfetti, e il passato storto, quando arriva, è un territorio nuovo: è lo scarto che si chiama exposure bias.
Il primo rimedio è Diffusion Forcing. Durante le lezioni l’insegnante sporca le pagine vere con macchie di intensità diversa, una diversa per ogni pagina: una quasi pulita accanto a una quasi illeggibile. Il disegnatore impara a continuare da un passato di qualità mista, e a non fidarsi ciecamente della pagina precedente. In scena, poi, può guardare le proprie pagine finite attraverso un velo leggero di macchie, così i loro piccoli difetti pesano meno e il blocchetto regge più a lungo. Le pagine finite restano come sono; davanti a sé, però, può tenere più pagine nuove ancora sporche e ripassarle insieme, la prossima già quasi pulita e le seguenti via via più macchiate, ciascuna guardando solo quelle che la precedono: del futuro prossimo si è più sicuri che del futuro lontano. Ma il passato su cui impara resta quello vero, soltanto macchiato: non è ancora la sua mano.
Il secondo rimedio, Self Forcing, lo fa esercitare come andrà in scena. Il disegnatore compone un blocchetto intero dalla prima pagina, con le proprie pagine come passato e il taccuino aperto accanto. Solo alla fine un giudice guarda i suoi blocchetti finiti, con le loro pieghe, e dice quanto, tutti insieme, somigliano a quelli di un maestro: un disegnatore lento e bravo, che lavora con tutte le pagine sul tavolo. A queste lezioni non serve nessun film vero, perché il metro sono i blocchetti del maestro.
A ogni blocchetto si estrae a sorte quante ripassate dare alle pagine, da una a quattro. Quando il giudice ha parlato, il disegnatore corregge la mano soltanto su come ha dato l’ultima ripassata di ogni pagina, quella che l’ha resa pulita: le ripassate di prima, e le pagine già annotate nel taccuino, restano come sono, perché ripercorrere a ritroso tutta la catena richiederebbe troppa memoria.
Sembra un esercizio lento, perché ora le pagine si fanno in fila, mentre l’insegnante con le domande già pronte lavorava a un tavolo solo. Con quattro ripassate e la correzione sull’ultima soltanto, però, una lezione dura quanto una lezione col vecchio metodo. E nessun rimedio toglie del tutto le pieghe. Le lezioni si fanno su blocchetti di una lunghezza fissa; in uno molto più lungo le pieghe finiscono per tornare, e servono altri accorgimenti, come quelli sul taccuino.
Si indichi con \(\mathbf{x}^i_t = (1-t)\,\mathbf{x}^i_0 + t\,\boldsymbol{\epsilon}^i\) il fotogramma \(i\) al livello di rumore \(t\), nella convenzione del libro, e con \(\mathbf{v}_\theta\) la rete. Nel teacher forcing ogni fotogramma si ripulisce condizionato sul passato vero e pulito:
dove \(\mathbf{x}^{<i}_0\) sono i fotogrammi veri. Tutti i fattori si calcolano in parallelo, sul video intero, con una maschera d’attenzione costruita apposta [HLH+25]; il confronto però è fra distribuzioni fotogramma per fotogramma, con un passato che in uso il modello non avrà.
Diffusion Forcing [CMMD+24] assegna a ogni fotogramma un livello di rumore indipendente \(t_i\), estratto a caso, e il contesto è rumoroso a quei livelli:
Fra le sequenze di livelli ci sono i due estremi da cui Chen e colleghi partono. Il termine \(i\) del teacher forcing è la sequenza con \(t_j = 0\) per \(j < i\), una diversa per ogni termine e non una sola per tutta la perdita; il livello unico della diffusione su un clip intero è la sequenza con tutti i \(t_i\) uguali. Gli autori scrivono la perdita con la predizione del rumore e mostrano che ottimizza una riponderazione di un ELBO, e sotto condizioni un limite inferiore della verosimiglianza per ogni sequenza di livelli. In campionamento, un contesto con rumore leggero (\(0 < t \ll 1\)) stabilizza i rollout oltre l’orizzonte di addestramento, e una matrice dei livelli per riga di passo e colonna di fotogramma permette lo zig-zag: il futuro vicino più ripulito del lontano.
Self Forcing [HLH+25] toglie il contesto vero. Per ogni campione genera il video con un rollout autoregressivo e la cache, con il modello a \(T\) passi,
dove \(G_\theta\) compone i \(T\) passi di denoising (ognuno stima il fotogramma pulito e lo riporta, con rumore nuovo, al livello successivo) e il contesto \(\hat{\mathbf{x}}^{<i}\) viene dalla cache dei fotogrammi già generati. Per ogni sequenza si estrae a caso quanti passi fare, da 1 a \(T\), e il gradiente attraversa soltanto l’ultimo passo di ogni fotogramma; la cache è staccata dal grafo, quindi il gradiente non risale ai fotogrammi precedenti. La perdita confronta le distribuzioni del video intero,
dove \(p_\theta\) è la distribuzione dei video generati, \(p_{\mathrm{maestro}}\) quella di un modello bidirezionale già addestrato e \(\mathrm{Div}\) una divergenza, che può essere la KL inversa di DMD, la divergenza di Fisher di SiD (score identity distillation) o la Jensen-Shannon approssimata da una GAN, calcolate fra le due distribuzioni diffuse a uno stesso livello \(t\). Il paper scrive il secondo termine come la distribuzione dei dati, ma nessuna delle tre varianti usa video registrati. Con DMD e SiD a rappresentarla è il punteggio di un modello bidirezionale (Wan 2.1 da 14 miliardi di parametri per DMD; per SiD il Wan 2.1 da 1,3 miliardi da cui parte il modello causale), e l’addestramento non usa nessun video; la GAN distingue i video generati da 70.000 video prodotti dal modello da 14 miliardi [HLH+25]. Il confronto sul video intero prende il posto di quello fotogramma per fotogramma di TF e DF. CausVid usa già DMD, ma la distribuzione che ottimizza passa per le uscite di Diffusion Forcing e si discosta da quella di inferenza [HLH+25].
Il rollout è sequenziale, mentre TF e DF elaborano il video intero in parallelo grazie alle maschere. Eppure un’iterazione di Self Forcing costa quanto una di TF o di DF, perché dentro ogni blocco i token si elaborano comunque in parallelo e le maschere speciali hanno un costo loro; con DMD la fase di Self Forcing, sul modello da 1,3 miliardi di parametri, converge in circa 1,5 ore su 64 H100 [HLH+25]. Gli autori si dicono ispirati alle tecniche delle reti ricorrenti che già srotolavano la generazione durante l’addestramento, fra cui MIXER di Ranzato e colleghi, che nella sezione sull’exposure bias ottimizza una metrica calcolata sulla frase generata dal modello stesso [HLH+25].
Nessuno dei tre regimi toglie l’accumulo sui video molto lunghi. Self Forcing confronta video della durata di addestramento, e oltre quella durata il modello prosegue senza un bersaglio: gli autori dichiarano che la qualità degrada su video molto più lunghi di quelli visti in addestramento, e che il gradiente troncato può limitare le dipendenze a lungo raggio [HLH+25]. CausVid, addestrato alla maniera di Diffusion Forcing, dichiara un degrado su durate molto lunghe [YZZ+25], e Krea, che parte da Self Forcing, mette ancora l’accumulo d’errore fra i problemi della generazione lunga [Mil25].
Dal maestro lento allo studente veloce: la distillazione asimmetrica#
Distillare un modello di diffusione vuol dire addestrarne uno veloce, lo studente, a produrre in pochi passi quello che un modello lento, il maestro, produce in molti. Un modello causale di solito rende meno di uno bidirezionale, e uno studente distillato da un maestro causale ne eredita i limiti: il maestro è più debole, e il suo accumulo d’errore passerebbe allo studente. CausVid ricorre quindi a una distillazione asimmetrica: il maestro è bidirezionale, lo studente è causale e lavora a pochi passi [YZZ+25]. A far combaciare le distribuzioni dei due è la DMD, la distillazione che confronta distribuzioni invece di traiettorie, presentata nella sezione sui modelli a pochi passi.
Il maestro è il disegnatore del tavolo pieno: tiene davanti tutte le pagine e dà cinquanta ripassate, ed è lento ma bravo, perché ogni pagina si corregge guardando tutte le altre. L’allievo disegna un blocco di pagine alla volta, guardando solo il passato, e con quattro ripassate. Come impara dal maestro? Non rifacendo le sue cinquanta ripassate. All’inizio gli si danno da copiare pagine finite dal maestro, a partire dalle stesse macchie, per fargli prendere la mano. Poi lo si giudica sull’insieme: gli si danno pagine vere macchiate, con una macchia diversa per ogni blocco, lui le ripulisce, e i blocchetti che ne escono, tutti insieme, devono somigliare a quelli del maestro. In queste lezioni non compone ancora il blocchetto da solo dalla prima pagina, come farà in scena: è proprio la cosa che Self Forcing cambia.
Il giudizio ha un’abitudine. Se l’allievo disegna una scena che il maestro non disegnerebbe mai, la punizione è severa; se invece dimentica un genere di scena che il maestro sa fare, la punizione è lieve. Così l’allievo tende a restare nei generi che gli riescono, e i suoi blocchetti si somigliano fra loro più di quanto si somiglino quelli del maestro. Ha guadagnato la velocità (il suo primo blocco è pronto in poco più di un secondo, mentre il maestro, per un video di 128 fotogrammi, impiega più di tre minuti e mezzo) e ha perso un po” di varietà.
Perché non avere come maestro un disegnatore che lavora già a blocchi, come l’allievo? Perché avrebbe le stesse pieghe, e l’allievo le imparerebbe come se fossero stile. E in fondo l’allievo, che disegna solo dal passato, con un blocchetto lunghissimo prende comunque la sua piega.
Lo studente è un denoiser causale a blocchi con \(T = 4\) passi, ai livelli di rumore 999, 748, 502 e 247 su una scala in cui 999 è rumore puro, contro i 50 passi del maestro. L’inizializzazione è una regressione su coppie rumore-fotogramma ottenute integrando la ODE del maestro; poi la DMD minimizza la divergenza di Kullback-Leibler inversa fra la distribuzione dello studente e quella del maestro, dove il gradiente è la differenza fra due punteggi: quello del maestro bidirezionale e quello di un modello ausiliario addestrato sui campioni dello studente [YGZ+24, YZZ+25]. In questa fase lo studente non genera in fila, ma riceve un video vero, rumoroso a un livello diverso per ogni blocco come in Diffusion Forcing, e ne stima in una passata i fotogrammi puliti; sono queste stime a entrare nel confronto fra le distribuzioni. Il contesto resta quello vero, ed è la scelta che Self Forcing sostituisce con il rollout. L’addestramento richiede circa due giorni su 64 H100; lo studente comincia a mostrare dopo 1,3 secondi e sostiene 9,4 fotogrammi al secondo su una H100, contro i 219 secondi del maestro per 128 fotogrammi [YZZ+25].
La KL inversa è mode-seeking: penalizza lo studente che mette massa dove il maestro non ne ha, e perdona quello che ignora una parte dei modi. CausVid ne dichiara la conseguenza, una diversità ridotta, tipica dei metodi di corrispondenza di distribuzione basati sulla KL inversa [YZZ+25]. Il blog di Krea, che distilla un modello più grande con la stessa famiglia di metodi, nomina lo stesso rischio come mode collapse e poca diversità [Mil25].
La finestra che scorre: la KV cache, la memoria e il primo fotogramma#
A ogni blocco la cache cresce di \(S\) token per ogni fotogramma del blocco, e a un certo punto bisogna decidere che cosa tenere. Il suo peso si calcola come per i modelli linguistici. Per ogni token e per ogni strato la cache conserva i due vettori che l’attenzione gli chiede: la chiave, con cui il token si fa trovare dalle query degli altri, e il valore, il contenuto che consegna a chi lo trova. In Wan ciascuno ha \(d\) numeri, e con due byte per numero (il formato bf16, la virgola mobile a 16 bit) sono \(2\,d\,L \cdot 2\) byte per token.
# KV cache di un DiT video: chiavi e valori di dimensione d, per strato, in bf16
modelli = {"Wan 1.3B": (1536, 30), "Wan 14B": (5120, 40)}   # (d, strati L)
byte = 2                                   # bf16
H, W, c_s, p = 480, 832, 8, 2              # 480p, VAE 8x spaziale, patch 2x2
S = (H // (c_s * p)) * (W // (c_s * p))    # token per fotogramma latente
GiB, GB = 2**30, 10**9                     # binario e decimale

print("token per fotogramma latente:", S)
for nome, (d, L) in modelli.items():
    per_token = 2 * d * byte * L           # K e V, in tutti gli strati
    per_fotogramma = S * per_token
    print(f"{nome}: {per_token} B per token, "
          f"{per_fotogramma / GiB:.2f} GiB per fotogramma latente")
    for n in (3, 6, 21):
        print(f"  {n:2d} fotogrammi latenti: "
              f"{n * per_fotogramma / GiB:6.2f} GiB = "
              f"{n * per_fotogramma / GB:6.2f} GB")
token per fotogramma latente: 1560
Wan 1.3B: 184320 B per token, 0.27 GiB per fotogramma latente
   3 fotogrammi latenti:   0.80 GiB =   0.86 GB
   6 fotogrammi latenti:   1.61 GiB =   1.73 GB
  21 fotogrammi latenti:   5.62 GiB =   6.04 GB
Wan 14B: 819200 B per token, 1.19 GiB per fotogramma latente
   3 fotogrammi latenti:   3.57 GiB =   3.83 GB
   6 fotogrammi latenti:   7.14 GiB =   7.67 GB
  21 fotogrammi latenti:  24.99 GiB =  26.84 GB
A 480p un fotogramma latente è di 1560 token. Per Wan 14B la cache di un solo fotogramma latente pesa 1,19 GiB, e 21 fotogrammi, cioè cinque secondi di video, ne pesano 24,99, che in miliardi di byte sono 26,84 GB. Il blog di Krea scrive che con Wan 2.1 14B la cache, in addestramento, arriva a 25 GB per GPU, senza dire la risoluzione né se i suoi GB siano miliardi di byte o GiB: l’accordo vale come controllo sull’ordine di grandezza. Krea Realtime 14B porta lo stesso meccanismo su quel modello, distillato con Self Forcing, e dichiara 11 fotogrammi al secondo con quattro passi su una sola GPU B200 e circa un secondo per il primo fotogramma [Mil25]. La fonte è il blog dell’azienda, senza revisione né misure ripetute da terzi, e non dice a quale frequenza vada guardato il video; se è quella del modello di partenza, 16 fotogrammi al secondo, anche Krea genera più lentamente di come si guarda.
Con una cache che cresce senza limite, ogni fotogramma nuovo costa più del precedente e la memoria non ha tetto. Self Forcing mette a confronto tre strategie per la generazione lunga, e le dichiara in ordine di grandezza per ogni fotogramma nuovo, con \(T\) passi di denoising e una finestra di \(w\) fotogrammi latenti [HLH+25]. Un modello bidirezionale a finestra scorrevole, che non può usare la cache, rifà l’attenzione sull’intera finestra a ogni passo, \(O(T w^2)\). Un modello causale con la cache, ma costretto a ricalcolarla quando la finestra si sposta, spende \(O(w^2 + T w)\). La cache che scorre scarta il fotogramma più vecchio e aggiunge il nuovo senza ricalcolare niente, e spende \(O(T w)\). Gli autori la riprendono dalla finestra scorrevole dei modelli linguistici, quella che StreamingLLM mostra fragile quando butta via i primi token del testo [XTC+24]. Le tre strategie si confrontano contando le coppie di fotogrammi che si guardano, senza le costanti, per \(T = 4\) e \(w = 6\) (la finestra di Matrix-Game 2.0, un mondo interattivo aperto); accanto c’è la cache che non scorre mai:
T, w = 4, 6          # passi di denoising, finestra in fotogrammi latenti
fps, c_t = 16, 4     # fotogrammi al secondo e compressione temporale di Wan
S, d, L, byte = 1560, 5120, 40, 2          # Wan 14B a 480p
GiB = 2**30
per_fotogramma = S * 2 * d * byte * L      # byte di cache per fotogramma

# costo di ogni nuovo fotogramma, in coppie di fotogrammi che si guardano
print("per nuovo fotogramma, con T = 4 e w = 6:")
print("  finestra bidirezionale, T w^2    :", T * w**2)
print("  causale con ricalcolo, w^2 + T w :", w**2 + T * w)
print("  cache che scorre, T w            :", T * w)

print()
print("durata  latenti  cache cresce  cache finestra  coppie cresce"
      "  coppie scorre")
for secondi in (5, 30, 60, 300):
    Fl = 1 + fps * secondi // c_t             # F' = 1 + (F - 1) / c_t
    cresce = sum(T * i for i in range(Fl))     # i guarda i precedenti
    scorre = sum(T * min(i, w) for i in range(Fl))
    print(f"{secondi:>4} s {Fl:>8} {Fl * per_fotogramma / GiB:>10.1f} GiB"
          f" {w * per_fotogramma / GiB:>10.2f} GiB {cresce:>14,} {scorre:>13,}")

print(f"\nuna finestra di {w} fotogrammi latenti copre {w * c_t / fps:.1f} s "
      "di video")
per nuovo fotogramma, con T = 4 e w = 6:
  finestra bidirezionale, T w^2    : 144
  causale con ricalcolo, w^2 + T w : 60
  cache che scorre, T w            : 24

durata  latenti  cache cresce  cache finestra  coppie cresce  coppie scorre
   5 s       21       25.0 GiB       7.14 GiB            840           420
  30 s      121      144.0 GiB       7.14 GiB         29,040         2,820
  60 s      241      286.8 GiB       7.14 GiB        115,680         5,700
 300 s     1201     1429.4 GiB       7.14 GiB      2,882,400        28,740

una finestra di 6 fotogrammi latenti copre 1.5 s di video
Il costo per fotogramma della cache che scorre non dipende dalla durata, e nemmeno la memoria: 7,14 GiB sia per cinque secondi sia per cinque minuti. Una cache che crescesse sempre, per cinque minuti, ne vorrebbe 1429, e le coppie di fotogrammi da confrontare sarebbero quasi tre milioni invece di 28.740, cento volte tanto. Il prezzo della finestra è la memoria del modello, perché sei fotogrammi latenti coprono un secondo e mezzo di video e il modello non vede più quello che ne è uscito.
La Fig. 33.5 mostra il processo in movimento, con blocchi di tre fotogrammi latenti e una finestra di due blocchi, cioè gli stessi \(w = 6\) del calcolo: i blocchi nascono da sinistra a destra, ciascuno ripulito in quattro passi, e la finestra della cache li segue scartando il più vecchio a ogni blocco nuovo.
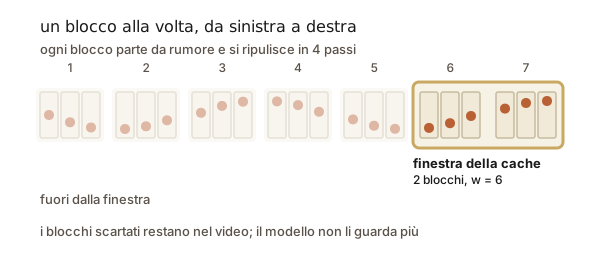
Fig. 33.5 Ogni blocco nasce dal rumore e si ripulisce in quattro passi; la finestra della cache, larga due blocchi (sei fotogrammi latenti), lo segue e scarta il più vecchio a ogni blocco nuovo.#
Un’altra disposizione degli stessi fotogrammi nel tempo è la coda a rumore crescente. Invece di finire un blocco prima di cominciare il successivo, il modello lavora su una fila di fotogrammi a livelli di rumore diversi, il più vecchio quasi pulito e il più nuovo ancora quasi tutto rumore. A ogni passo tutti si ripuliscono un po”; quando il primo è pulito esce dalla fila, e in fondo entra un fotogramma di rumore. È lo zig-zag di Diffusion Forcing, con il futuro vicino più pulito del lontano, usato per generare un flusso senza fine, ed è lo schema dello Streamer di Wan e di MAGI-1 [SandAITJ+25, WanTeamWA+25].
Per un mondo interattivo la coda ha un rovescio: i fotogrammi che seguono sono già in parte generati quando si mostra quello corrente, e un comando arrivato in quel momento li raggiunge solo in parte [HLH+25].
Il taccuino si allunga a ogni pagina, e ogni pagina ha le sue 1560 annotazioni. Il disegnatore lo accorcia con una regola semplice: nel taccuino tiene soltanto le annotazioni delle ultime sei pagine, e quando ne arriva una nuova quelle della più vecchia escono. Così il lavoro per ogni pagina non cresce con la lunghezza del blocchetto, e nemmeno lo spazio che il taccuino occupa. Nel modello vero ogni pagina riassume quattro fotogrammi del video, quindi sei pagine valgono un secondo e mezzo, e ciò che è uscito dal taccuino per lui non esiste più: il gatto che esce di scena per più di un secondo e mezzo può tornare diverso, o non tornare.
La prima pagina di ogni blocchetto è speciale: riassume un fotogramma solo invece di quattro, e ha un altro tratto. Il disegnatore, mentre si esercitava, l’ha sempre avuta in cima al taccuino; quando esce dalla finestra, il taccuino gli pare di un altro autore, e lui, che non l’ha mai visto senza quella pagina, si confonde: le immagini sfarfallano. Un primo rimedio è l’esercizio: nell’ultimo blocco di pagine, a lezione, il disegnatore non può guardare la prima, e si abitua a farne a meno. Un altro è tenere la prima pagina sempre, ma allora il blocchetto non può allontanarsi troppo da come è cominciato.
Un terzo rimedio costa più fatica, ed è quello che adotta chi vuole un blocchetto lungo e stabile. A ogni pagina nuova il disegnatore non si limita a cancellare le righe vecchie: rifà le annotazioni delle pagine rimaste, rileggendole pulite, perché erano state scritte quando accanto c’erano pagine che ora non ci sono più, e ne portavano le tracce. E la più vecchia delle pagine rimaste la ridisegna come una prima pagina, da un fotogramma solo, col tratto a cui è abituato.
Restano due regolazioni. Per non ripetere sempre lo stesso gesto, gli si suggerisce di dar meno retta alle pagine vecchie. E si sceglie quanto tenere lungo il taccuino: meno pagine tiene, meno errori si trascina dietro, ma anche meno movimento complesso sa disegnare, perché non vede abbastanza indietro.
La cache ha una dimensione fissa: \(w\,S \cdot 2\,d\,L \cdot b\) byte, con \(b\) il numero di byte per elemento, che per Wan 14B a 480p con \(w = 6\) vale 7,14 GiB. Il costo di un fotogramma nuovo è \(O(T w)\), quello della cache che scorre di Self Forcing; il prezzo è che la memoria del modello è la finestra stessa, \(w\,c_t\) fotogrammi di video, e a 16 fotogrammi al secondo con \(c_t = 4\) sei fotogrammi latenti sono 24 fotogrammi, cioè 1,5 secondi (21 fotogrammi finché la finestra contiene il primo latente, che ne vale uno solo).
Il fattore \(2\,d\) per strato vale per Wan, dove ogni testa di query ha chiavi e valori suoi: la tabella del modello dà 12 teste alla versione da 1,3 miliardi e 40 a quella da 14, e il codice pubblicato proietta chiavi e valori sull’intera larghezza \(d\), senza le condivisioni di GQA e MQA della sezione sull’attenzione in pratica. Il testo, che entra con la cross-attention, è un termine costante nella durata e non si conta.
Il primo fotogramma latente ha statistiche diverse dagli altri: è l’unico che codifica un’immagine sola, senza compressione temporale (la convoluzione causale del VAE video). Il modello l’ha sempre visto in cima alla finestra in addestramento, e quando esce dalla finestra la distribuzione cambia: sfarfallio. Self Forcing lo risolve in addestramento, limitando l’attenzione in modo che l’ultimo blocco non veda il primo, cioè simulando la condizione della generazione lunga [HLH+25]. L’alternativa ovvia è non scartare mai il primo fotogramma, come StreamingLLM non scarta mai i primi token di un testo [XTC+24]: Krea la prova, e riferisce che riduce gli artefatti ma limita quanto il video può allontanarsi dall’inizio [Mil25].
Krea individua nella cache anche una seconda fonte di accumulo. Le chiavi e i valori dei fotogrammi nella finestra hanno un campo ricettivo maggiore di \(w\): sono stati calcolati quando i fotogrammi già scartati erano ancora visibili, e ne propagano l’informazione negli strati profondi. La cura è ricalcolare la cache a ogni scarto, passando i soli fotogrammi puliti della finestra con la maschera causale a blocchi, e ricodificare come latente a fotogramma singolo il primo fotogramma RGB della finestra, che torna a essere un’immagine come in addestramento. Con \(S\) token per fotogramma, il costo di ogni scarto passa da \(O(S^2 w)\), la scrittura nella cache del solo fotogramma nuovo, a \(O\big(S^2\,w(w+1)/2\big)\), il ricalcolo della finestra intera. È il termine in \(w^2\) della strategia con ricalcolo, che Self Forcing scarta perché su video di 10 secondi scende a 4,6 fotogrammi al secondo, contro i 16,1 della cache che scorre [HLH+25].
Krea accetta il prezzo e accorcia la finestra a tre fotogrammi latenti (12 fotogrammi RGB, o 9 con la ricodifica), un compromesso fra coerenza e velocità scelto perché l’attenzione è la maggior fonte di latenza; aggiunge poi un bias negativo sui punteggi d’attenzione verso i fotogrammi passati, che riduce l’accumulo e il moto ripetitivo. Una finestra più corta riduce l’accumulo ma limita il movimento complesso, perché il modello non vede abbastanza indietro [Mil25].
Nella coda a rumore crescente lo Streamer di Wan si addestra su sequenze lunghe il doppio della finestra, con la prima metà di solo riscaldamento, e fa rientrare i fotogrammi usciti a livello di rumore zero, per la continuità [WanTeamWA+25]. MAGI-1 la applica a blocchi di 24 fotogrammi, un secondo a 24 fotogrammi al secondo: un blocco comincia quando il precedente ha raggiunto un certo livello di pulizia, fino a quattro in parallelo, con un costo di picco costante, e il rumore che cresce lungo i blocchi lo usa anche in addestramento [SandAITJ+25].
Dal video al mondo: i comandi come condizione#
Un mondo interattivo è un video autoregressivo con una condizione in più a ogni fotogramma: il comando di chi gioca. La fattorizzazione diventa
dove \(\mathbf{a}^i\) è il comando, il vettore dei tasti premuti e del movimento del mouse, dato prima di vedere il fotogramma \(i\). Genie ricava i comandi dal video senza etichette e GameNGen li osserva dalle partite registrate: la sezione sui mondi da giocare ne ha descritto il modello di azioni latenti, e qui non si ripete. Un esempio aperto, con i pesi e il codice pubblici, è Matrix-Game 2.0 [HPL+25].
Prima di ogni blocco di pagine il disegnatore riceve dal giocatore i bigliettini con i tasti premuti, uno per pagina (sinistra, avanti, la direzione dello sguardo), e li appoggia accanto alle pagine da disegnare. Ogni pagina mostra l’effetto dei bigliettini del suo blocco e di quelli arrivati prima, mai di quelli dei blocchi futuri, perché il disegnatore guarda soltanto il passato: un bigliettino non cambia le pagine già finite. Il ritmo lo detta il gioco: il disegnatore deve finire le pagine almeno alla velocità con cui il giocatore le sfoglia. Per imparare ha sfogliato una grande raccolta di blocchetti, con accanto i bigliettini dei comandi dati mentre quelle pagine venivano registrate.
Ne vengono due conseguenze. La prima: le pagine di un blocco si disegnano insieme sul tavolo, quindi un tasto premuto mentre il blocco è in lavorazione conta dal blocco dopo, e fra il tasto e la pagina che ne mostra l’effetto passa almeno il tempo di disegnare un blocco intero. La seconda: il taccuino è corto. Se il giocatore torna nel punto da cui è partito dopo pochi secondi, il disegnatore non ha più quella parte del mondo nel taccuino: la ridisegna, e può venire diversa dall’originale. E le pieghe si sommano, come in ogni blocchetto.
In Matrix-Game 2.0 [HPL+25] un modulo d’azione, aggiunto in ogni strato del DiT (1,8 miliardi di parametri in tutto), inietta tastiera e mouse fotogramma per fotogramma; il movimento del mouse si concatena al latente, i tasti entrano con una cross-attention. I dati del modello principale sono circa 800 ore di video a 360p annotati con le azioni, da Minecraft e da scene prodotte con Unreal Engine, più 85 ore di video reali; altre due raccolte, da due videogiochi, servono a provare il metodo su scene diverse. La distillazione segue la filiera di Self Forcing, con circa 40.000 coppie della ODE del maestro e poi Self Forcing con DMD, a blocchi di tre fotogrammi latenti e con una finestra locale di sei; con una finestra di nove gli artefatti compaiono prima. Il modello arriva a 25 fotogrammi al secondo su una singola H100 riducendo i passi da quattro a tre e tenendo i moduli d’azione nella sola prima metà degli strati.
La causalità è ciò che rende possibile la condizione. Con l’attenzione bidirezionale ogni fotogramma dipenderebbe anche dai comandi futuri, che al momento di mostrarlo non sono ancora arrivati. Con la maschera a blocchi la fattorizzazione vale blocco per blocco, con \(\mathbf{x}^i\) il blocco \(i\) e \(\mathbf{a}^i\) i comandi dei suoi fotogrammi, e un comando raggiunge il proprio blocco e i successivi, mai i precedenti. Dentro un blocco l’attenzione è bidirezionale, quindi i comandi di tutti i suoi fotogrammi devono essere noti prima di ripulirlo. Ne segue che un comando arrivato durante la generazione di un blocco agisce dal blocco dopo, e che la reattività è limitata dalla durata del blocco. Restano poi i due limiti della cache che scorre: la finestra di \(w\) fotogrammi è l’unica memoria del modello, e l’errore si accumula.
Genie 3 affronta lo stesso problema in un sistema chiuso, e il suo blog lo descrive con parole proprie [PHF25]. Genera mondi che si attraversano in tempo reale a 24 fotogrammi al secondo, a 720p, coerenti per qualche minuto, con una memoria visiva che arriva fino a un minuto prima. Le difficoltà che dichiara sono quelle della cache e dell’accumulo d’errore. A ogni fotogramma il modello deve tener conto della traiettoria generata fino a quel momento, che cresce con il tempo, e deve farlo più volte al secondo, in risposta ai comandi appena arrivati. E generare un ambiente in modo autoregressivo è in generale più difficile che generare un video intero, perché le imprecisioni si accumulano. La coerenza è presentata come una capacità emergente, e non come l’effetto di una rappresentazione tridimensionale esplicita.
Il blog non dichiara l’architettura, i parametri, il latente, se si usi la diffusione, come sia fatta la memoria, su quale hardware giri e con quali dati. Il calcolo della cache offre solo un termine di paragone. Una memoria di un minuto tenuta come finestra di cache costerebbe 286,8 GiB per Wan 14B a 480p, una risoluzione più bassa di quella di Genie 3. È il prezzo di questo meccanismo, e non dice niente su come Genie 3 ottenga la sua memoria.
Da ricordare
Un generatore che ripulisce tutto il clip insieme non mostra niente finché non ha finito. Per giocarci dentro il disegnatore deve invece procedere a blocchi di poche pagine, guardando solo quelle già finite e tenendo un taccuino per non rileggere tutto: il pubblico vede un blocco quando è pulito, e a parità di allenamento i blocchetti vengono un po” peggio.
A lezione ha visto solo passati perfetti, e in scena continua dalle proprie pagine, con le loro sbavature: è l’exposure bias. L’insegnante può sporcare le pagine vere con macchie diverse (Diffusion Forcing), oppure far esercitare il disegnatore sul proprio blocchetto e farlo giudicare intero, accanto a quelli di un maestro lento e bravo (Self Forcing). Con nessuno dei due la piega sparisce per sempre.
Un allievo a quattro ripassate impara da un maestro a cinquanta: lo si giudica sull’insieme, e tende a restare nei generi che gli riescono, quindi varia meno del maestro.
Il taccuino tiene solo le ultime pagine, e quello che ne esce non esiste più: in sei pagine di blocchetto entra un secondo e mezzo di video. La prima pagina, che riassume un fotogramma solo, ha un tratto diverso e fa sfarfallare il blocchetto quando esce; rifare le annotazioni a ogni pagina nuova costa più fatica ma ripulisce le tracce delle pagine cancellate.
In un mondo da giocare i bigliettini del giocatore arrivano prima di ogni blocco, e contano solo da lì in poi. Genie 3, un sistema chiuso, dichiara di ricordare fino a un minuto prima, ma non dice come.
Da ricordare
La fattorizzazione \(p(\mathbf{x}^{1:F'}) = \prod_i p(\mathbf{x}^i \mid \mathbf{x}^{<i})\) con la maschera causale a blocchi, bidirezionale dentro un blocco di \(k\) fotogrammi latenti, e la KV cache scritta con una passata a \(t = 0\) sul blocco pulito, permette di mostrare i fotogrammi mentre si generano. Nessun pixel esce prima che il primo blocco sia finito (in CausVid lo impone anche il VAE), e il modello causale rende meno del bidirezionale.
Exposure bias: il teacher forcing ottimizza una perdita per fotogramma su un passato vero. Diffusion Forcing dà a ogni fotogramma un livello \(t_i\) indipendente, e ogni termine del TF è una delle sue sequenze di livelli (\(t_j = 0\) per \(j < i\)). Self Forcing addestra sul rollout con la cache, con gradiente troncato, e una perdita di distribuzione sul video intero (DMD, SiD, GAN) verso un maestro bidirezionale, senza video registrati; oltre la durata di addestramento non ha bersaglio, e l’accumulo resta.
La distillazione di CausVid è asimmetrica (maestro bidirezionale, studente causale a \(T = 4\)) e con la DMD paga con la diversità: la KL inversa è mode-seeking.
Per ogni fotogramma nuovo, con \(T\) passi e finestra \(w\): \(O(T w^2)\) per la finestra bidirezionale, \(O(w^2 + T w)\) per la cache con ricalcolo, \(O(T w)\) per la cache che scorre. La memoria della cache è \(w\,S \cdot 2\,d\,L \cdot b\) byte (7,14 GiB per Wan 14B a 480p con \(w = 6\)) e la memoria del modello è la finestra: 1,5 secondi a 16 fotogrammi al secondo.
Il primo fotogramma latente ha statistiche diverse: Self Forcing ne toglie la vista all’ultimo blocco in addestramento, Krea ricalcola la cache e ricodifica il primo fotogramma a ogni scarto, con un costo \(O(S^2 w(w+1)/2)\).
Un mondo interattivo condiziona ogni fotogramma sui comandi, \(\mathbf{a}^{\le i}\), oltre che sul passato: con la maschera a blocchi un comando raggiunge solo il proprio blocco e i successivi, e la durata del blocco limita la reattività. Genie 3 dichiara una memoria visiva fino a un minuto e non dice come la ottenga.
Un mondo generato così è fatto di immagini e di comandi. Il suono ha un orologio suo, e tenerlo allineato a quello dei fotogrammi è il problema della sezione sul suono delle immagini.