


Il suono delle immagini#
Una porta sbatte. Se il colpo arriva un attimo dopo che la vedi chiudersi, te ne accorgi anche senza saper dire di quanto. Si può avvertire uno sfasamento fra immagine e suono di appena 25 millisecondi [CIH+25], meno della durata di un fotogramma a 24 al secondo, che è di 41,7 millisecondi. Un video senza suono sembra finto, e uno con il suono fuori tempo si riconosce subito.
Un generatore che modella soltanto i fotogrammi produce un filmato muto. Per dargli il suono non basta affiancargli un secondo generatore che lavori per conto suo. L’audio ha un proprio latente, cioè una propria versione compressa su cui il generatore lavora, ottenuta da un proprio autoencoder e con un proprio passo nel tempo; la sua corrispondenza con le immagini si giudica in millisecondi, mentre il passo del latente video si conta in centinaia di millisecondi. La domanda di progetto è come far parlare fra loro due flussi con due orologi diversi, e i sistemi che descrivono la propria architettura rispondono in tre modi.
Due orologi e un orecchio esigente#
Il latente di un video ha \(F'\) fotogrammi, con \(F' = 1 + (F-1)/c_t\) per un autoencoder video che comprime il tempo di un fattore \(c_t\) e codifica da solo il primo fotogramma. Il latente ha quindi \(r_v\) fotogrammi al secondo, la frequenza del video divisa per \(c_t\) (6 per un video a 24 fotogrammi al secondo con \(c_t = 4\)). Dove non c’è un autoencoder, \(r_v\) è la frequenza dei token visivi, cioè dei vettori che l’encoder visivo produce: in MMAudio sono 8 al secondo, uno per fotogramma analizzato da un encoder di tipo CLIP, una rete addestrata ad accostare immagini e didascalie. Il latente audio nasce da un altro autoencoder, che lavora sulla forma d’onda o su uno spettrogramma mel (la mappa di quanta energia c’è in ogni banda di frequenza, istante per istante), ed è anch’esso una fila di token, \(r_a\) al secondo. Il fotogramma latente \(i\) cade all’incirca all’istante \(i/r_v\), e il token audio \(j\) all’istante \(j/r_a\).
Il conto dei due orologi mette la soglia di 25 millisecondi accanto al passo di quattro sistemi. Per LTX-2, il cui report non dichiara quanto l’autoencoder video comprima il tempo, il conto assume il fattore 8 di LTX-Video [HCB+24], che il report indica come punto di partenza. L’ultima parte del conto prende il caso di Ovi, dove 121 fotogrammi a 24 al secondo (5,04 secondi) devono incontrarsi con l’audio a 16 kHz, cioè sedicimila campioni al secondo [LWK25], e rifà lo stesso calcolo su clip più lunghi.
# Due orologi: frequenza dei token video (r_v) e audio (r_a), al secondo
soglia_ms = 25.0    # sfasamento che si puo' avvertire (MMAudio)
fotogramma_ms = 1000 / 24
print(f"un fotogramma a 24 fps dura {fotogramma_ms:.1f} ms; "
      f"la soglia e' {soglia_ms / fotogramma_ms:.2f} fotogrammi")

sistemi = {                           # nome: (r_v, r_a)
    "MMAudio": (8.0, 31.25),          # CLIP a 8 fps; latente audio a 31,25/s
    "Ovi": (24 / 4, 16000 / 512),     # VAE video 4x nel tempo; audio 16 kHz/512
    "LTX-2": (24 / 8, 25.0),          # 8x nel tempo: ipotesi, da LTX-Video
    "MiniMax H3": (24 / 4, 40.0),     # VAE video 4x; audio 40 token/s a canale
}
print(f"{'':11s}{'r_v':>6s}{'r_a':>7s}{'passo v':>10s}{'passo a':>9s}"
      f"{'25 ms in v':>12s}{'r_a/r_v':>9s}")
for nome, (rv, ra) in sistemi.items():
    print(f"{nome:11s}{rv:6.2f}{ra:7.2f}{1000 / rv:8.0f} ms{1000 / ra:6.0f} ms"
          f"{soglia_ms * rv / 1000:12.2f}{ra / rv:9.2f}")

# Ovi: 121 fotogrammi (5,04 s); il primo fotogramma latente sta da solo
rv, ra = sistemi["Ovi"]
lat_video = 1 + (121 - 1) // 4
tok_audio = -(-16000 * 5 // 512)      # 16 kHz x 5 s / 512 = 156,25, cioe' 157
s_conteggi = lat_video / tok_audio    # la scala che Ovi adotta
s_tassi = rv / ra                     # la scala dei soli tassi
print(f"Ovi: {lat_video} latenti video, {tok_audio} token audio "
      f"({tok_audio / lat_video:.2f} per latente)")
print(f"scala {lat_video}/{tok_audio} = {s_conteggi:.4f}, r_v/r_a = "
      f"{s_tassi:.4f}, scarto relativo {s_conteggi / s_tassi - 1:.1%}")
j = tok_audio - 1                     # indice dell'ultimo token audio
scarto_ms = j * (s_conteggi - s_tassi) / rv * 1000
print(f"token {j}: posizione video {j * s_conteggi:.2f} contro "
      f"{j * s_tassi:.2f}, cioe' {scarto_ms:.0f} ms")

# la stessa regola su clip piu' lunghi, con la scala ricalcolata su ciascuno
print(f"un latente video dura {1000 / rv:.0f} ms")
for durata in (5, 10, 20, 60):
    n_lat = 1 + (24 * durata) // 4    # 24 x durata + 1 fotogrammi
    n_tok = -(-16000 * durata // 512)
    scala = n_lat / n_tok
    scarto_ms = (n_tok - 1) * (scala - s_tassi) / rv * 1000
    print(f"{durata:3d} s: {n_lat:3d} latenti, {n_tok:4d} token, scarto "
          f"relativo {scala / s_tassi - 1:5.1%}, in fondo {scarto_ms:.0f} ms")

# MMAudio: le frequenze del flusso visivo scalate di 31,25/8
s = 31.25 / 8
print("MMAudio: scala", round(s, 3), "-> posizioni",
      [round(k * s, 2) for k in range(4)])
un fotogramma a 24 fps dura 41.7 ms; la soglia e' 0.60 fotogrammi
              r_v    r_a   passo v  passo a  25 ms in v  r_a/r_v
MMAudio      8.00  31.25     125 ms    32 ms        0.20     3.91
Ovi          6.00  31.25     167 ms    32 ms        0.15     5.21
LTX-2        3.00  25.00     333 ms    40 ms        0.07     8.33
MiniMax H3   6.00  40.00     167 ms    25 ms        0.15     6.67
Ovi: 31 latenti video, 157 token audio (5.06 per latente)
scala 31/157 = 0.1975, r_v/r_a = 0.1920, scarto relativo 2.8%
token 156: posizione video 30.80 contro 29.95, cioe' 142 ms
un latente video dura 167 ms
  5 s:  31 latenti,  157 token, scarto relativo  2.8%, in fondo 142 ms
 10 s:  61 latenti,  313 token, scarto relativo  1.5%, in fondo 150 ms
 20 s: 121 latenti,  625 token, scarto relativo  0.8%, in fondo 166 ms
 60 s: 361 latenti, 1875 token, scarto relativo  0.3%, in fondo 167 ms
MMAudio: scala 3.906 -> posizioni [0.0, 3.91, 7.81, 11.72]
Per accordare le immagini e il suono, un montatore cinematografico ha due strisce di carta, una per il filmato e una per la colonna sonora. Su ciascuna ci sono delle tacche, e le due strisce non hanno lo stesso passo: su quella delle immagini c’è una tacca ogni terzo di secondo, su quella del suono venticinque tacche al secondo (numeri dell’ordine di quelli dei sistemi reali). La tacca 9 delle immagini e la tacca 75 del suono portano numeri diversi e cadono nello stesso istante, tre secondi dall’inizio. Il numero della tacca non basta quindi a dire dove si sta: serve un righello comune su cui appoggiare tutte e due le strisce, e il rapporto fra le due (otto tacche e un terzo di suono per ogni tacca di immagini) è il fattore con cui si passa dall’una all’altra.
Poi viene la parte difficile. L’orecchio può accorgersi di uno scarto anche di un quarantesimo di secondo, più breve di una tacca di suono (un venticinquesimo) e molto più breve di una tacca di immagini (un terzo). Far coincidere tacca con tacca non garantisce niente. Fra una tacca e la successiva il colpo della porta deve stare nel punto giusto, e il righello non lo può dire: lo dice solo ciò che la striscia porta scritto in quel tratto.
Il righello, poi, si può tracciare in due modi ragionevoli. Nel primo si usano i secondi: ogni tacca delle immagini vale un terzo di secondo, ogni tacca del suono un venticinquesimo. Nel secondo si stendono le due strisce in modo che comincino e finiscano insieme, e se ne divide la lunghezza in parti uguali. Finché tutte le tacche durano uguale i due modi coincidono. Ma la prima tacca delle immagini, come succede davvero, copre meno tempo delle altre, e il secondo modo la conta come intera. I due righelli allora si separano poco a poco: all’inizio coincidono, e in fondo alla striscia distano circa una tacca di immagini, un terzo di secondo, molto più di quanto l’orecchio tolleri. Su un filmato più lungo il distacco finale non cresce, perché la tacca contata in più è sempre una sola, e si spalma su tutta la striscia. Quale dei due modi dica il vero dipende da dove cade ciascuna immagine dentro il tempo che la sua tacca riassume, e chi ha preparato le strisce non lo dice.
Un latente video di \(F'\) fotogrammi e un latente audio di \(J\) token coprono lo stesso intervallo, di \(F'/r_v \approx J/r_a\) secondi. Il passaggio fra gli indici \(i\) e \(j\) avviene sull’asse comune del tempo, dove il fotogramma \(i\) sta a \(i/r_v\) secondi e il token \(j\) a \(j/r_a\), e il rapporto \(r_a/r_v\) è il numero di token audio per fotogramma latente (in MMAudio, per fotogramma di CLIP), che vale 3,91 per MMAudio, 5,21 per Ovi, 8,33 per LTX-2 (sotto l’ipotesi della compressione temporale 8×) e 6,67 per MiniMax H3.
Il confronto con la soglia di 25 ms dice che nessuna griglia è più fine dell’orecchio: il passo audio va da 25 a 40 ms, e nel caso migliore uguaglia la soglia; il passo video va da 125 a 333 ms, e 25 ms sono fra 0,07 e 0,20 fotogrammi latenti. Ne segue, come deduzione dal conto e non come risultato delle fonti, che la posizione nella griglia può fissare soltanto l’accoppiamento (quale token audio guarda quale fotogramma), e che la precisione sotto il passo deve stare nel contenuto dei latenti, cioè in ciò che ciascun token codifica dell’istante esatto dentro la sua finestra.
Il punto di rottura è la scala. Se la corrispondenza fra indice e tempo usa \(\hat r\) invece di \(r\), un token all’indice \(j\) cade fuori posto di \(j\,(1/\hat r - 1/r)\) secondi, una quantità proporzionale a \(j\), nulla all’inizio e massima in fondo al clip.
Ovi ne dà un caso concreto. Il paper scala le posizioni audio di \(31/157 = 0{,}1975\), il rapporto fra i conteggi, che fa occupare ai 157 token audio le stesse 31 posizioni dei fotogrammi latenti. Il rapporto fra le frequenze, \(r_v/r_a = 0{,}1920\), è più piccolo del 2,8%, soprattutto per il «+1» del primo fotogramma latente, che riassume un fotogramma solo invece di quattro. Sull’ultimo token audio, l’indice 156, le due scale danno le posizioni video 30,80 e 29,95, cioè 142 ms di disaccordo, più di cinque volte la soglia.
Il disaccordo ha la forma di un errore di scala, ma nasce da uno spostamento di un latente. I fotogrammi latenti sono uno in più di quanti ne darebbe la sola frequenza, \(F' \approx 1 + (r_v/r_a)\,J\), quindi la scala dei conteggi vale \(F'/J \approx r_v/r_a + 1/J\). Sull’ultimo token, all’indice \(J - 1\), il termine in più sposta la posizione di \((J-1)/J\), circa un fotogramma latente, cioè circa \(1/r_v\) secondi (167 ms in Ovi), qualunque sia \(J\). Se la regola dei conteggi si applicasse a clip più lunghi di quelli di Ovi, con la scala ricalcolata su ciascuno, lo scarto relativo calerebbe come \(1/J\), cioè come l’inverso della durata, e quello in fondo al clip resterebbe circa un latente: 142, 150, 166 e 167 ms a 5, 10, 20 e 60 s. Crescerebbe con la durata soltanto riusando su un clip lungo la scala calcolata su uno corto, uso che il paper non descrive.
Quale delle due scale rispecchi meglio il tempo dipende da dove si colloca ciascun latente dentro i fotogrammi che riassume, e il paper non lo discute; il conto mostra quanto pesa la scelta, non quale sia giusta.
Tre schemi per far parlare i due flussi#
Indichiamo con \(\mathbf{x}_{\text{v}}\) e \(\mathbf{x}_{\text{a}}\) il latente video e il latente audio. Video, audio e testo sono modalità diverse, cioè tipi diversi di dato, e il pedice dice di quale si parla. I sistemi che dichiarano il loro meccanismo si dividono in tre famiglie, secondo ciò che modellano e come i due flussi si parlano.
Nella cascata il video è già fatto e il generatore produce soltanto l’audio guardandolo, cioè si modella la condizionata \(p(\mathbf{x}_{\text{a}} \mid \mathbf{x}_{\text{v}})\). È lo schema di MMAudio [CIH+25] e di Movie Gen Audio [PZB+24].
Nei flussi accoppiati i due latenti si generano insieme, ciascuno con un proprio denoiser, la rete che a ogni passo della diffusione toglie una parte del rumore. Ogni denoiser è una pila di blocchi Transformer, detta torre, e a ogni blocco un’attenzione incrociata nei due versi fa guardare ciascuna torre nell’altra: i token di un flusso raccolgono informazione da quelli dell’altro, ciascuno in proporzione a quanto gli è pertinente. È lo schema di Ovi [LWK25] e di LTX-2 [HBC+26].
Nel flusso unico testo, video e audio sono impacchettati in una sola sequenza che attraversa un solo Transformer, con gli stessi parametri (i numeri che la rete impara) per tutte le modalità, come in MiniMax H3 [MiniMax26]. Le ultime due famiglie modellano la congiunta \(p(\mathbf{x}_{\text{v}}, \mathbf{x}_{\text{a}})\), e il video può cambiare in funzione dell’audio che gli si genera accanto.
Veo 3, un sistema chiuso, dichiara che la diffusione agisce congiuntamente sui latenti audio temporali e su quelli video spazio-temporali, ciascuno prodotto da un proprio autoencoder, con un denoiser basato su un Transformer [GoogleDeepMind25a, GoogleDeepMind25b]. La diffusione congiunta esclude la cascata; il report però non dice se i due latenti passino per due torri o per una sola, né quali siano i fattori di compressione dei due autoencoder, l’obiettivo d’addestramento e il numero di passi.
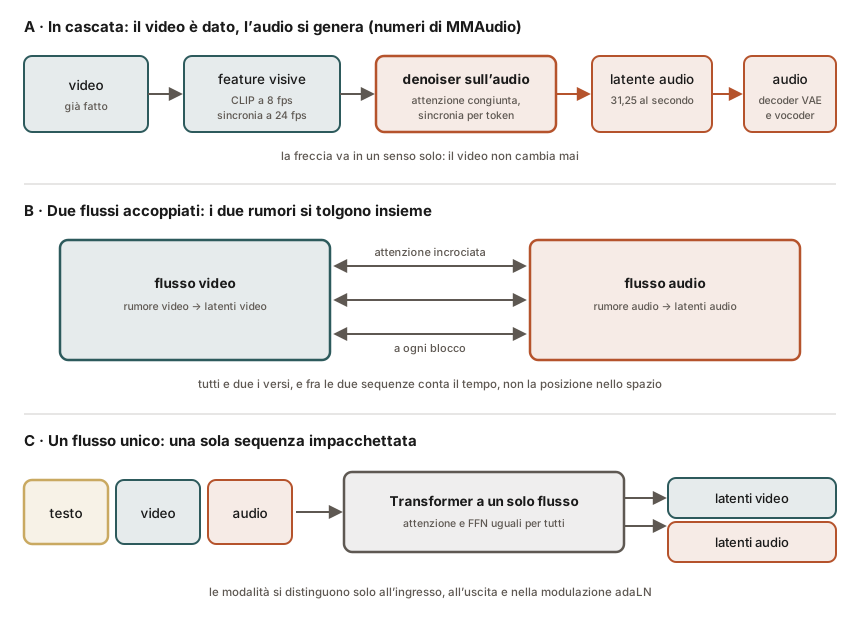
Fig. 33.6 I tre schemi: in cascata il video è un ingresso e non cambia (i numeri sono quelli di MMAudio); con due flussi accoppiati le due torri si guardano a ogni blocco; con un flusso unico tutte le modalità attraversano gli stessi parametri.#
Nella Fig. 33.6 contano due cose: in quale verso vanno le frecce e dove stanno i parametri. Nello schema A la freccia va dal video all’audio e mai indietro; nello schema B va nei due versi, ma ogni modalità ha il suo denoiser; nello schema C non ci sono più due denoiser, e le modalità si distinguono soltanto all’ingresso, all’uscita e nella modulazione.
Dal video al suono: la cascata#
In MMAudio il denoiser lavora sul solo latente audio, con tre sequenze in ingresso (le feature visive, il testo e il latente audio rumoroso). Movie Gen Audio fa lo stesso con un modello molto più grande e un modo diverso di passare il video. Il problema della sincronia si gioca in due punti: dove le due sequenze vengono allineate nel tempo, e come la feature visiva di un istante raggiunge il token audio di quell’istante.
Un rumorista guarda un film già girato e gli costruisce i suoni, i passi, la porta, il vento. Il film non lo può cambiare, e il suo mestiere è una conversazione a senso unico: guarda e risponde. Sul tavolo ha tre cose, il film, il copione con le descrizioni e i suoi appunti, e le legge tutte e tre insieme, non una dopo l’altra.
Perché i suoi appunti stiano al passo, li scrive su un nastro graduato in secondi, dove il secondo tre del film e il secondo tre degli appunti stanno nello stesso punto, anche se il film gli arriva riassunto a otto immagini al secondo e il nastro degli appunti ha più di trenta tacche al secondo (una scala di quasi quattro a uno).
Serve un altro accorgimento. Se il rumorista si facesse un’idea generale del film e poi inventasse i suoni, otterrebbe una media: sentirebbe che c’è una porta e non saprebbe quando sbatte. Gli serve invece un foglietto che, per ogni istante, dice che cosa succede in quell’istante nell’immagine. Ne arrivano ventiquattro al secondo, e lui li ricopia a uno per ogni tacca del suono, così da leggere quello giusto nel momento in cui scrive quel pezzo di rumore.
Per esercitarsi, il rumorista usa anche registrazioni con la sola descrizione, senza film. Dove il film manca, sul tavolo c’è un foglio bianco, e il mestiere di fare rumori si impara lo stesso. Un’altra bottega, più grande, lega i due in modo più semplice: scrive il contenuto di ogni immagine direttamente sul pezzo di suono che le corrisponde, immagine per immagine. Ha però un limite di bottega: effetti, ambienti e un sottofondo di strumenti sì, voci che parlano o che cantano no.
MMAudio [CIH+25] genera il latente audio (un VAE su mel più un vocoder; nel modello predefinito a 16 kHz, 31,25 token al secondo e 20 dimensioni) con il flow matching, condizionato dalle feature visive \(\mathbf{f}\) (CLIP, 8 fotogrammi al secondo, 1024 dimensioni), dal testo codificato \(\mathbf{c}\) (77 token di CLIP, una riga per token) e dalle feature di sincronia \(\mathbf{g}\) (24 fotogrammi al secondo, 768 dimensioni), prese da Synchformer, un encoder addestrato a riconoscere gli sfasamenti fra video e audio. Il paper scrive la convenzione opposta a quella del libro, con il dato in \(t = 1\) e velocità \(\mathbf{x}_1 - \mathbf{x}_0\); nella convenzione del libro il tempo è \(1 - t\), la velocità cambia segno e la rete impara \(\mathbf{v}_\theta(\mathbf{x}_t, t, \mathbf{c}, \mathbf{f}, \mathbf{g}) \approx \boldsymbol{\epsilon} - \mathbf{x}_0\), con \(\mathbf{x}_0\) il latente audio.
L’architettura è una pila di blocchi MM-DiT a tre rami (video, testo, audio) con un’attenzione congiunta sulle tre sequenze concatenate, seguiti da blocchi con il solo ramo audio; nei rami video e audio, al posto degli MLP, stanno convoluzioni 1D con kernel 3. La RoPE ruota ogni coppia di coordinate di query e chiave di un angolo proporzionale alla posizione, e il punteggio dipende soltanto dalla differenza fra le due posizioni. Qui è allineata: le frequenze del flusso visivo sono scalate di \(31{,}25/8 \approx 3{,}91\), quindi il fotogramma \(i\) ruota come se stesse alla posizione \(3{,}91\,i\), la posizione audio che gli compete nel tempo (la scala è nel conto dei due orologi). Non ci sono posizioni assolute, e questo permette di generalizzare a durate diverse. Gli autori notano però che la RoPE allineata aiuta la sincronia ma da sola non basta.
Il modulo di sincronia porta le feature \(\mathbf{g}\) alla frequenza dell’audio, ripetendo per ogni token audio la più vicina, le somma al condizionamento globale e le inietta per token con l’adaLN, nel solo flusso audio, così che la modulazione del token audio \(j\) dipende dalla feature della sua posizione, e non da un vettore unico per tutta la sequenza come nell’adaLN-zero e negli altri adaLN di MMAudio. Gli autori trovano che la sola attenzione aggrega con una distribuzione morbida, che pregiudica la precisione; la modulazione per token assegna a ogni token la feature della propria posizione, senza una media pesata di tutte. L’addestramento è congiunto con coppie testo-audio, molto più abbondanti (circa 180.000 video da 10 s di VGGSound contro 951.000 coppie testo-audio), con token visivi vuoti appresi dove il video manca. Il modello predefinito ha 157 milioni di parametri.
Synchformer serve anche a misurare la sincronia: la metrica DeSync del paper è lo sfasamento, in secondi, che Synchformer stima fra il video e l’audio generato, e va minimizzata; poiché anche questo giudice è un modello, il paper la affianca a un confronto fra gli istanti d’attacco dei suoni generati e quelli annotati in un insieme di video [CIH+25].
Movie Gen Audio [PZB+24] ha 13 miliardi di parametri e un latente di tipo DAC-VAE (un codec neurale senza il quantizzatore RVQ, addestrato come VAE) a 25 Hz e 128 canali. Le feature visive (MetaCLIP, per fotogramma) sono ricampionate al fotogramma video più vicino a ogni fotogramma audio, proiettate e sommate fotogramma per fotogramma al latente audio. Secondo il report, sommarle invece di concatenarle lungo il tempo dà una supervisione diretta dell’allineamento e lo migliora, mentre le feature di un autoencoder video davano risultati molto peggiori. Un contesto audio mascherato, concatenato sui canali, serve per estendere e riempire. Per dichiarazione del report genera effetti, ambienti e musica strumentale a 48 kHz, senza parlato né canto.
Due flussi che si guardano#
Nei flussi accoppiati ogni modalità ha una sua torre di blocchi, e a ogni blocco un’attenzione incrociata nei due versi lascia che i token video guardino i token audio e viceversa. Il problema della sincronia si sposta lì: l’attenzione incrociata deve confrontare due sequenze con orologi diversi, e le due torri devono accordarsi sul rumore che resta da togliere a ciascuna. Ovi [LWK25] le fa uguali; LTX-2 [HBC+26] le fa diverse.
Un pittore e un compositore lavorano allo stesso duetto, ciascuno partendo da una bozza piena di scarabocchi, e ripuliscono ognuno la propria. A ogni passata smettono un momento, guardano l’uno la bozza dell’altro e tornano a lavorare. Le botteghe che lavorano così sono due, e organizzano il duetto in modo diverso.
Nella prima i due studi sono identici, e i due procedono sempre alla stessa velocità di pulitura. Il pittore arriva con il mestiere già imparato altrove; il compositore, che ha uno studio uguale al suo, il mestiere se l’è fatto da solo prima del duetto, ascoltando moltissime voci. Quando cominciano a lavorare insieme non cambiano il modo di dipingere o di comporre: imparano soltanto dove guardare, nella propria bozza e in quella dell’altro. Mentre imparano, gli errori del quadro contano 85 su 100 e quelli del suono 15. E le misure devono tornare. Se il pittore ha trentuno tele e il compositore centocinquantasette battute, a ogni tela corrispondono poco più di cinque battute, e se la proporzione è sbagliata il compositore sbaglia di più man mano che il duetto procede.
Nella seconda bottega il pittore ha lo studio più grande, perché in un quadro c’è molto più da dire che in un suono. Per guardarsi, i due si incontrano a un tavolo comune, della stessa misura per tutti e due: ciascuno vi porta la propria bozza ridotta a quella misura, e riporta nel proprio studio ciò che ha visto, adattandolo alla grandezza del suo. Al tavolo confrontano il quando, e non il dove: il compositore controlla a che istante cade un gesto del pittore, e non in che punto del quadro.
L’ultimo accorgimento della seconda bottega è la fiducia. Ognuno decide quanto della propria bozza mostrare, e quanto stare a sentire, secondo il punto a cui è arrivato con la propria; e regola quanto credere all’altro in base a quanto è sporca l’altra bozza, perché una bozza ancora piena di scarabocchi dà un cenno che vale poco. Così le due ripuliture si aggiustano insieme anche quando una delle due è più avanti.
In Ovi [LWK25] le due torri sono identiche (larghezza 3072, FFN 14336, 24 teste, 30 blocchi), e in ogni blocco c’è un’attenzione incrociata nei due versi. Quella video è inizializzata da un modello video preaddestrato (Wan2.2 5B); quella audio ha la stessa architettura ed è addestrata da zero, prima da sola su centinaia di migliaia di ore di audio, soprattutto parlato, poi insieme all’altra. Il VAE audio è l’1D di MMAudio a 16 kHz, con il vocoder BigVGAN; un solo T5 congelato legge un prompt che unisce descrizione visiva e parlato.
Nell’addestramento congiunto gli FFN delle due torri restano congelati e si addestrano le attenzioni (5,7 miliardi di parametri su 11). I rumori sono indipendenti, il tempo \(t\) è lo stesso per le due modalità, la perdita è \(0{,}85\,\mathcal{L}_{\text{v}} + 0{,}15\,\mathcal{L}_{\text{a}}\) e un solo solutore di ODE serve per tutte e due. Per l’allineamento, con 31 fotogrammi latenti contro 157 token audio, la RoPE dell’audio è scalata di \(31/157 \approx 0{,}197\) (l’ispirazione dichiarata è MMAudio), quindi il punteggio fra il fotogramma \(i\) e il token \(j\) dipende da \(i - 0{,}197\,j\). La scala fa coincidere le lunghezze delle due sequenze, ed è una delle due scelte che il conto dei due orologi mette a confronto.
LTX-2 [HBC+26] è asimmetrico: 14 miliardi di parametri per il flusso video e 5 per quello audio, perché le due modalità hanno densità d’informazione molto diverse, con autoencoder separati (posizioni 3D per il video, 1D per l’audio). Ogni blocco compie in sequenza la self-attention nella propria modalità, l’attenzione incrociata al testo, quella audio-video e l’FFN. Nell’attenzione audio-video si usa la sola componente temporale della RoPE, perché la sincronia è nel tempo e non nell’allineamento spaziale. Il punteggio fra un token video e un token audio non dipende quindi dalla riga né dalla colonna del token video, ma soltanto dalla posizione nel tempo, che il report pone su un asse comune ai due flussi.
L’adaLN incrociato lega la modulazione dell’adaLN-zero (scala, spostamento e porta) ai tempi di diffusione dei due flussi, \(t_{\text{v}}\) e \(t_{\text{a}}\), che possono essere diversi (in Ovi coincidono). Il report lo descrive a parole, senza una formula. In schema, nella notazione dell’adaLN-zero, l’attenzione che porta l’audio nel flusso video è
dove \(\mathbf{h}_{\text{v}}\) e \(\mathbf{h}_{\text{a}}\) sono gli stati dei due flussi, con una riga per token e rispettivamente \(d_{\text{v}}\) e \(d_{\text{a}}\) colonne. Le proiezioni \(\mathbf{W}_Q \in \mathbb{R}^{d_{\text{v}} \times d_{\text{av}}}\) e \(\mathbf{W}_K, \mathbf{W}_V \in \mathbb{R}^{d_{\text{a}} \times d_{\text{av}}}\) portano le due torri, larghe in modo diverso, alla dimensione comune \(d_{\text{av}}\), e \(\mathbf{W}_O \in \mathbb{R}^{d_{\text{av}} \times d_{\text{v}}}\) riporta l’uscita dell’attenzione alla larghezza della torre che la riceve: senza, la somma con \(\mathbf{h}_{\text{v}}\) non si potrebbe fare. Il report descrive le proiezioni verso la dimensione comune e non quella d’uscita, quindi \(\mathbf{W}_O\) è una parte dello schema, con lo stesso ruolo della proiezione con cui l’attenzione a più teste ricompone le teste. La modulazione \(\mathrm{mod}_t(\mathbf{z}) = \big(1 + \boldsymbol{\gamma}(t)\big) \odot \mathbf{z} + \boldsymbol{\beta}(t)\) ha scala e spostamento di \(d_{\text{av}}\) componenti, calcolati dal tempo \(t\) e applicati a ogni riga; gli apici \(Q\) e \(KV\) distinguono le due modulazioni, che hanno parametri propri, e la porta \(\boldsymbol{\alpha}\) ha \(d_{\text{v}}\) componenti.
Le query sono modulate dal passo del flusso video, le chiavi e i valori dal passo del flusso audio, e così ciascuna modalità regola quanto della propria rappresentazione è ricettiva verso l’altra, o esposta all’altra. La RoPE temporale ruota query e chiavi prima del prodotto. L’uscita dell’attenzione, riportata da \(\mathbf{W}_O\) alla larghezza del flusso video, passa poi dalla porta \(\boldsymbol{\alpha}\), che dipende dal passo dell’altra modalità e dosa quanta informazione incrociata entra a quel punto della ripulitura. Per il flusso audio la formula si ottiene scambiando gli indici, con \(\mathbf{W}_O \in \mathbb{R}^{d_{\text{av}} \times d_{\text{a}}}\).
Nella presentazione generale dell’architettura il report dice anche che scala e spostamento di una modalità sono condizionati dagli stati dell’altra, soprattutto quando i passi di diffusione o le risoluzioni temporali dei due flussi differiscono; lo schema segue la descrizione del blocco, dove dall’altra modalità dipende la porta.
Un flusso solo#
Il terzo schema toglie la distinzione fra torri. Le rappresentazioni di tutte le modalità, ciascuna prodotta dal proprio encoder o dal proprio autoencoder, formano una sola sequenza, che un solo Transformer attraversa con gli stessi parametri per tutte. Le modalità si distinguono soltanto nei livelli d’ingresso e d’uscita e nella modulazione adaLN, la scala e lo spostamento che regolano ogni blocco: lì ciascuna ha parametri propri. L’esempio con l’architettura dichiarata è MiniMax H3 [MiniMax26], descritto soltanto nel README del suo repository, non in un lavoro sottoposto a revisione.
Nella terza bottega non ci sono un pittore e un compositore, ciascuno nel suo studio. C’è un solo artigiano, che lavora al quadro, alla musica e al copione sullo stesso banco, con le stesse mani e gli stessi attrezzi, senza pennelli da quadro né strumenti da musica. Non deve fermarsi a guardare il lavoro di un altro, perché tutti i pezzi gli stanno già davanti, uno accanto all’altro.
Ogni materiale arriva già compresso a modo suo, e alla porta un addetto, diverso per ciascun materiale, lo mette nel formato del banco; all’uscita un altro addetto lo riporta al suo. Fra la porta e l’uscita, l’unica cosa che cambia da un materiale all’altro è un foglio di istruzioni, uno per materiale, che dice all’artigiano come regolare la presa. Le istruzioni dei fogli, messe insieme, sono più di un terzo di tutto ciò che la bottega ha imparato. Però si possono preparare una volta per tutte e tenere in un cassetto, e per lavorare basta il cassetto, senza chi le ha scritte.
Di questa bottega si sa soltanto ciò che dice il cartello sulla porta. Non dice come l’artigiano abbia imparato il mestiere, né quante ripassate faccia su ogni lavoro, né su quali opere si sia esercitato.
MiniMax H3 [MiniMax26] è descritto soltanto nel README del suo repository, e quello che segue è ciò che il README dichiara. Il testo passa per un encoder di linguaggio e visione (Qwen3-VL-32B), gli ingressi visivi per lo stesso encoder e per un VAE visivo, l’audio per un VAE audio; le rappresentazioni sono organizzate in una sola sequenza multimodale impacchettata, con una RoPE tridimensionale sul tempo, sull’altezza e sulla larghezza. Un solo Transformer denso a flusso unico, da 33 miliardi di parametri, la attraversa e predice insieme i latenti video e audio.
Né l’attenzione né gli FFN hanno parti specifiche per modalità: i parametri propri di ciascuna stanno soltanto nei livelli d’ingresso e d’uscita e nei rami adaLN. Il README non dà formule. In schema, nella forma dell’adaLN-zero, ogni sottoblocco \(g_\theta\) (l’attenzione o l’FFN) aggiorna lo stato \(\mathbf{h}\) di un token video come
dove \(\theta\) è comune a tutte le modalità, \(\mathrm{LN}\) è la normalizzazione di strato, e scala \(\boldsymbol{\gamma}_{\text{v}}\), spostamento \(\boldsymbol{\beta}_{\text{v}}\) e porta \(\boldsymbol{\alpha}_{\text{v}}\) vengono dai rami adaLN del video; per un token audio o di testo la formula è la stessa, con lo stesso \(\theta\) e i rami della sua modalità. Nell’attenzione, \(g_\theta\) fa interagire tutti i token della sequenza impacchettata. Nell’MM-DiT, invece, anche le proiezioni dell’attenzione e l’FFN hanno parametri propri di ogni modalità, \(\theta_{\text{v}}\), \(\theta_{\text{a}}\) e così via, e le modalità si incontrano solo nell’attenzione congiunta. I rami adaLN contano da soli circa 13 miliardi di parametri, e il README dice che le loro uscite si possono precalcolare e conservare, così che per la sola inferenza quei parametri non vanno caricati. Che la modulazione dipenda soltanto dal passo \(t\) e dalla modalità, come nella formula, è un’ipotesi dello schema: il README non lo scrive, e la dichiarazione sulle uscite precalcolate è compatibile con essa.
Il VAE visivo comprime 16 volte lo spazio e 4 volte il tempo, con 24 canali, e la patch 1×2×2 porta a 32 la riduzione spaziale; quello audio usa lo stesso encoder per i due canali stereo e porta i 32 kHz a 40 token al secondo per canale. Nel conto dei due orologi H3 sta quindi a 6,67 token audio per fotogramma latente, contando un canale solo. Il README non dichiara l’obiettivo d’addestramento (diffusione o flow matching), il numero di passi né i dati.
La guida a due termini#
La guida senza classificatore [HS22] a una sola condizione, quella della sezione sulla guida, estrapola: parte dalla predizione senza condizione e va oltre quella con condizione, lungo la direzione che porta dall’una all’altra. Un sistema con due modalità ha due condizioni da guidare, il testo e l’altra modalità. LTX-2 le guida separatamente, con un termine per ciascuna.
Sia \(M(\mathbf{x}, \mathbf{c}, \mathbf{m})\) l’uscita del modello di un flusso (la velocità), dove \(\mathbf{x}\) è il latente di quel flusso, \(\mathbf{c}\) il testo codificato (una matrice con una riga per token) e \(\mathbf{m}\) le feature dell’altro flusso, e \(\varnothing\) indica una condizione tolta (il tempo di diffusione è sottinteso). La guida a due termini di LTX-2 è
dove \(s_T\) è il peso della guida sul testo e \(s_M\) quello della guida sull’altro flusso. Il report usa \(s_T = 3\) e \(s_M = 3\) per il flusso video, e \(s_T = 7\) e \(s_M = 3\) per quello audio [HBC+26]. Nella notazione del libro, dove \(w = 1\) dà la predizione condizionata, un solo termine dà \(w = 1 + s_T\). Il conto della guida a due termini controlla l’espansione in pesi, il caso con \(s_M = 0\) e la stessa combinazione su tre numeri scelti a mano.
import numpy as np

rng = np.random.default_rng(0)
d = 6
M = rng.normal(size=d)                   # uscita con testo e altra modalita'
M_senza_testo = rng.normal(size=d)       # testo tolto, altra modalita' presente
M_senza_altra = rng.normal(size=d)       # testo presente, altra modalita' tolta

def guida(s_T, s_M):
    """Guida a due termini: un'estrapolazione per ciascuna condizione tolta."""
    return M + s_T * (M - M_senza_testo) + s_M * (M - M_senza_altra)

for nome, (s_T, s_M) in {"video": (3, 3), "audio": (7, 3)}.items():
    esteso = (1 + s_T + s_M) * M - s_T * M_senza_testo - s_M * M_senza_altra
    print(f"{nome}: pesi {1 + s_T + s_M:+d} {-s_T:+d} {-s_M:+d}, somma "
          f"{(1 + s_T + s_M) - s_T - s_M}, le due scritture coincidono: "
          f"{np.allclose(guida(s_T, s_M), esteso)}")

# senza il secondo termine resta la guida di un solo termine, con w = 1 + s_T
w = 1 + 7
una_sola = M_senza_testo + w * (M - M_senza_testo)
print("con s_M = 0 resta la guida a un termine, w = 1 + s_T:",
      np.allclose(guida(7, 0), una_sola))

# le tre prove riassunte in un numero ciascuna (inventati), con s_T = 7, s_M = 3
completa, senza_testo, senza_altra = 10, 8, 9
spinte = completa + 7 * (completa - senza_testo) + 3 * (completa - senza_altra)
in_pesi = 11 * completa - 7 * senza_testo - 3 * senza_altra
print(f"tre numeri: {completa} + 7 x {completa - senza_testo} + 3 x "
      f"{completa - senza_altra} = {spinte}; in pesi: 11 x {completa} "
      f"- 7 x {senza_testo} - 3 x {senza_altra} = {in_pesi}")
video: pesi +7 -3 -3, somma 1, le due scritture coincidono: True
audio: pesi +11 -7 -3, somma 1, le due scritture coincidono: True
con s_M = 0 resta la guida a un termine, w = 1 + s_T: True
tre numeri: 10 + 7 x 2 + 3 x 1 = 27; in pesi: 11 x 10 - 7 x 8 - 3 x 9 = 27
Una fonica vuole che il suono di una scena sia più fedele al copione e più legato all’immagine, e per ottenerlo fa preparare al suo assistente tre prove. Nella prima l’assistente ha il copione e vede il film; nella seconda ignora il copione e guarda solo il film; nella terza tiene il copione e chiude gli occhi sul film.
Poi confronta. La differenza fra la prova completa e quella senza copione è ciò che il copione aggiunge; la differenza fra la completa e quella senza film è ciò che il film aggiunge. Di ciascuna differenza dà una spinta in più nella stessa direzione, di quanto vuole (per il suono di una scena, il copione sette volte e il film tre volte). La prova finale parte da quella completa e somma le due spinte.
Con tre numeri inventati il conto si fa a mano. Supponiamo che ogni prova si riassuma in un numero solo: 10 la completa, 8 quella senza copione, 9 quella senza film. Il copione aggiunge 2 e il film 1, e la finale vale 10 + 7 × 2 + 3 × 1 = 27. Lo stesso 27 si ottiene contando quante volte entra ciascuna prova. La completa entra una volta da sola, sette volte nella spinta del copione e tre in quella del film, cioè 1 + 7 + 3 = 11 volte; quella senza copione si toglie sette volte, quella senza film tre volte, e infatti 11 × 10 − 7 × 8 − 3 × 9 = 27. I tre numeri per cui si moltiplicano le prove, cioè i pesi 11, −7 e −3, sommano a uno. Per questo, se le tre prove fossero uguali, la finale sarebbe identica a loro, e la spinta nasce soltanto dalle differenze. E se la spinta del film è zero, resta quella di sempre, con il solo copione.
Il pericolo è esagerare. Ogni spinta va già oltre ciò che le tre prove, da sole, autorizzano. Un po” di spinta dà una scena più fedele, troppa una caricatura, che nessun attore potrebbe recitare.
La formula chiede tre uscite del modello per passo, quella completa e le due con una condizione tolta, contro le due della guida a un termine. Si riscrive in pesi sulle tre uscite,
Per il flusso video i pesi sono \(+7, -3, -3\) e per l’audio \(+11, -7, -3\), e la somma è 1, come stampa il conto della guida a due termini. La combinazione è quindi affine, e dove le tre uscite coincidono la guidata coincide con loro, perché la guida agisce soltanto sulle differenze. Con \(s_M = 0\) resta la guida a un termine con \(w = 1 + s_T\), nella convenzione dove \(w = 1\) dà la condizionata.
Ciascuna differenza, a meno di un fattore che dipende solo da \(t\) (sul percorso rettilineo la velocità è una funzione affine del punteggio), stima un gradiente della riga di Bayes: la prima \(\nabla_{\mathbf{x}}\log p(\mathbf{c}\mid\mathbf{x},\mathbf{m})\), la direzione che rende il testo più verosimile dato il latente e l’altra modalità; la seconda \(\nabla_{\mathbf{x}}\log p(\mathbf{m}\mid\mathbf{x},\mathbf{c})\), la direzione che rende più verosimile l’altra modalità dato il latente e il testo. Il termine con \(s_T\) spinge quindi l’uscita lontano da ciò che il modello produrrebbe ignorando il testo, quello con \(s_M\) lontano da ciò che produrrebbe ignorando l’altra modalità. Il report osserva, senza darne una misura, che aumentare \(s_M\) migliora la sincronia temporale e la coerenza semantica fra video e audio [HBC+26].
Valgono le riserve della guida a un termine. Con \(s_T > 0\) o \(s_M > 0\) si estrapola oltre il punto che il teorema di Bayes autorizza, e il risultato non campiona dalla distribuzione inclinata, per ciascuno dei due termini.
Dove la sincronia si rompe#
I clip che questi sistemi generano sono brevi: 5 secondi per Ovi [LWK25], da 4 a 15 per MiniMax H3 [MiniMax26], fino a 20 per LTX-2 [HBC+26], fino a 30 in un colpo per Movie Gen Audio, che oltre procede per estensione [PZB+24]. Il report di LTX-2 dichiara che oltre i 20 secondi circa possono comparire una deriva temporale e una sincronia degradata, e non ne indica la causa. Il disaccordo fra le due scale di Ovi misurato nel conto dei due orologi è un’altra cosa: con la scala ricalcolata su ciascun clip resta circa un fotogramma latente in fondo al clip, a qualunque durata, e non cresce con essa. C’è poi un limite di materia: Movie Gen Audio genera effetti, ambienti e musica strumentale, e dichiara di escludere parlato e canto.
Da ricordare
Il suono e le immagini hanno due orologi diversi, con poche tacche al secondo per le immagini e molte di più per il suono, e per accordarli serve un righello comune. Tracciato nei due modi ragionevoli, contando i secondi o facendo cominciare e finire insieme le due strisce, il righello dà due letture che si separano poco a poco, fino a circa una tacca di immagini in fondo alla striscia, a qualunque lunghezza del filmato.
L’orecchio può notare uno scarto più breve di una tacca di suono, quindi la precisione sta fra una tacca e l’altra, e il righello da solo non la garantisce.
Si può far guardare il suono al film già fatto (la cascata), far lavorare due torri che si guardano a ogni blocco (i flussi accoppiati) o far attraversare tutto a una sola torre, con gli stessi attrezzi per ogni materiale (il flusso unico). Nella cascata il film non cambia mai.
Per spingere il suono verso il copione e verso il film insieme si fanno tre prove (completa, senza copione, senza film) e si danno due spinte; i pesi delle tre prove, 11, −7 e −3 per il suono, sommano a uno.
I clip sono brevi, e in LTX-2 oltre una ventina di secondi la sincronia può derivare.
Da ricordare
Due orologi, \(r_v\) e \(r_a\), e una soglia di 25 ms che nessun passo supera in finezza: la griglia fissa l’accoppiamento, e la precisione, per deduzione, deve stare nel contenuto dei latenti. Un errore di scala cresce linearmente con l’indice. In Ovi la scala dei conteggi (\(31/157\)) e quella delle frequenze (\(r_v/r_a\)) si separano in fondo al clip di 142 ms; lo scarto nasce dal «+1» del primo latente, e con la scala ricalcolata su ogni clip resterebbe circa un latente a qualunque durata.
Tre schemi: cascata, \(p(\mathbf{x}_{\text{a}} \mid \mathbf{x}_{\text{v}})\), con RoPE allineata e modulazione per token (MMAudio, scala \(31{,}25/8\)) o somma per fotogramma (Movie Gen Audio); flussi accoppiati, con attenzione incrociata a ogni blocco e RoPE scalata (Ovi, \(31/157\)) o la sola componente temporale (LTX-2, 14B più 5B, adaLN incrociato); flusso unico, con parametri di attenzione e FFN comuni a tutte le modalità e rami adaLN propri di ciascuna (MiniMax H3, fonte non sottoposta a revisione).
La guida a due termini aggiunge alla predizione completa una differenza per il testo tolto, pesata da \(s_T\), e una per l’altra modalità tolta, pesata da \(s_M\). Servono tre uscite per passo, i pesi sommano a 1, e con \(s_M = 0\) resta la guida a un termine. Le riserve sull’estrapolazione restano.
Veo 3 dichiara la diffusione congiunta su audio e video e non dice se i due flussi abbiano due torri o una; oltre circa 20 s LTX-2 dichiara possibili deriva e sincronia degradata, senza indicarne la causa.
In tutti questi sistemi il suono ha accanto un’immagine con cui accordarsi, e quando la porta sbatte il colpo va lì. In una canzone nessuna immagine dice quando cade ciascuna parola del testo, ed è questa la domanda che attraversa il capitolo sulla generazione di musica.