


La voce che canta: dalla partitura al suono#
Una cantante arriva all’ultima parola di una canzone, «amore», e sull’ultima sillaba trova una nota lunga, che tiene la «e» di «re» per più di un secondo. La bocca non cambia forma e la vocale resta quella dall’inizio alla fine, ma la voce non sta ferma, e l’altezza sale e scende di poco, più volte, attorno alla nota scritta. Sulla sillaba prima, «mo», la «m» è partita un attimo in anticipo, perché la «o» doveva cadere esattamente sul battito.
Chi parla non ha niente di tutto questo da decidere. Dice «amore» con l’intonazione che gli viene, e ogni suono dura quanto serve. Chi canta ha davanti una partitura, che a ogni sillaba assegna una nota, cioè un’altezza e una durata, e la voce deve stare dentro quei due numeri senza smettere di sembrare una voce.
Una macchina che canta riceve perciò due fogli, il testo e la partitura. La sintesi vocale (il text-to-speech, TTS) parte dal solo testo e lascia al modello il ritmo e la melodia; qui la melodia e il ritmo sono dati. Con loro è data anche la risposta alla domanda da cui ogni canzone sintetica deve passare, cioè dove cada ciascuna sillaba nel tempo, che il testo da solo non dice. È la strada di Vocaloid 2, il motore di Yamaha del 2007 con cui è nata Hatsune Miku, che cuce campioni registrati, ed è la strada di DiffSinger e VISinger, che fanno lo stesso mestiere con una rete neurale. Da qui parte anche ACE Studio, un prodotto commerciale di cui si sa quel poco che è pubblico.
Perché cantare non è parlare#
Passando dal parlato al canto cambiano parecchie cose, e ogni sistema di sintesi del canto è costruito per accoglierle.
Altezza e durata, anzitutto, sono dati. La partitura, scrivono gli autori di DiffSinger, è fatta di testo, altezze e durate [LLR+22]. VISinger rappresenta la durata di una nota come numero di frame, i brevi intervalli di pochi millesimi di secondo in cui il suono viene diviso, e la sua altezza come numero MIDI, quello che lo standard dei programmi musicali assegna a ogni tasto del pianoforte [ZCX+22].
L’altezza, poi, si muove di più. La frequenza fondamentale \(f_0\), quella che l’orecchio sente come altezza, nel canto è più ricca di variazioni che nel parlato e mostra finezze come il vibrato; per gli autori di VISinger è una delle ragioni per cui il canto è più difficile da modellare [ZCX+22].
Le vocali si tengono a lungo, e la libreria di Vocaloid contiene vocali tenute registrate apposta, che il suo paper definisce essenziali nella sintesi del canto [KO07]. Conta infine dove cade la sillaba rispetto alla nota. Vocaloid dispone i campioni in modo che l’attacco della vocale cada esattamente sull’inizio della nota, quindi la consonante che la precede comincia prima del battito [KO07]. Nel complesso il canto altera i fonemi, cioè i singoli suoni della lingua, le loro durate e la prosodia (il ritmo, gli accenti e l’andamento della voce) in modi molto diversi dal parlato [YLG+25].
La nota scritta sull’ultima sillaba è un MI che dura 1,28 secondi. I programmi musicali numerano le note come i tasti di un pianoforte, bianchi e neri, uno dopo l’altro (è la numerazione MIDI), e a quel MI danno il numero 64, cinque tasti sotto il 69 del la a cui si accordano le orchestre. Il la fa 440 oscillazioni al secondo, e ogni tasto più in basso ne toglie poco meno del 6 per cento, cioè moltiplica il numero per 0,944: 440, 415, 392, 370, 349 e, al quinto tasto, circa 330, il MI. Dopo dodici tasti, cioè un’ottava, il numero è esattamente la metà. È l’altezza che la partitura prescrive, e una voce che tenesse per 1,28 secondi quella frequenza e nient’altro suonerebbe piatta.
La cantante infatti oscilla. Lo scarto si misura in cent, i centesimi della distanza fra due tasti vicini: la voce sale fino a cinquanta cent sopra la nota e scende fino a cinquanta sotto, e lo fa cinque volte e mezzo al secondo. Sono due numeri, l’ampiezza e la velocità di quello che si chiama vibrato, e bastano a disegnare l’ondeggiamento. Sul MI da 330 portano la voce fra circa 320 e 339 oscillazioni al secondo, e in 1,28 secondi, a cinque ondeggiamenti e mezzo al secondo, la voce ne compie sette completi.
Il tempo, invece, non lo decide la cantante. La nota dura quanto dice la partitura, e la vocale della sillaba la occupa quasi tutta. A cadere sul battito dev’essere la vocale, e per questo la consonante che la precede parte prima. Così la «m» di «mo» comincia qualche centesimo di secondo prima della sua nota e si prende la coda di quella che la precede.
I cinquanta cent e le cinque oscillazioni e mezzo sono valori scelti per l’esempio, non misure di una voce vera.
Una nota della partitura è una terna (altezza, inizio, durata) e porta una sillaba. L’altezza è il numero MIDI \(m\), un intero, e la frequenza che la partitura prescrive, in hertz, è
dove \(m = 69\) è il la a 440 Hz e ogni incremento unitario di \(m\) moltiplica \(f_m\) per \(2^{1/12}\) (un semitono), e dodici incrementi raddoppiano la frequenza. Gli scarti da una nota si misurano in cent, centesimi di semitono, e una frequenza \(f\) dista \(1200 \log_2 (f / f_m)\) cent dalla nota, su una scala logaritmica come quella dei numeri MIDI.
Il vibrato è una modulazione in cent della frequenza fondamentale (la \(F_0\) della sintesi vocale, qui in minuscolo come le altre frequenze) attorno a quella della nota:
dove \(f_0(\tau)\) è la frequenza fondamentale all’istante \(\tau\), misurato in secondi dall’inizio della nota (la lettera \(t\) resta al passo della diffusione), \(A\) la profondità in cent e \(f_v\) la frequenza del vibrato in hertz. L’escursione è simmetrica in cent, tra \(f_m \cdot 2^{-A/1200}\) e \(f_m \cdot 2^{A/1200}\), e solo quasi simmetrica in hertz: poiché \(2^{a} - 1 > 1 - 2^{-a}\) per ogni \(a > 0\), lo stesso scarto in cent vale più hertz sopra la nota che sotto. La formula assume \(A\) e \(f_v\) costanti per tutta la nota, che è la parametrizzazione più semplice, e i due valori usati nell’esempio (50 cent e 5,5 Hz) non sono misure.
La durata della nota \(j\) è un dato, il numero di frame \(b_j = r\,\delta_j\) (arrotondato), con \(\delta_j\) la durata in secondi e \(r\) la frequenza dei frame. Con la regola di Vocaloid i fonemi della sillaba si dispongono attorno all’inizio della nota: l’attacco della vocale cade sull’inizio della nota, e le consonanti che la precedono prendono i propri frame dalla coda della nota prima [KO07]. Quanti frame vadano a ciascun fonema, invece, la partitura non lo dice.
Il MI della nota lunga, tenuto per 1,28 s con un vibrato di 50 cent a 5,5 Hz, si calcola così, con il tempo \(\tau\) che avanza di un millisecondo alla volta.
import numpy as np

def frequenza(m):
    """Frequenza fondamentale (Hz) della nota MIDI m: la nota 69 e' 440 Hz."""
    return 440.0 * 2.0 ** ((m - 69) / 12)

# La nota scritta: il MI sopra il do centrale (numero MIDI 64), tenuta 1,28 s.
m, durata = 64, 1.28
fm = frequenza(m)
print(f"nota MIDI {m}: f_m = {fm:.2f} Hz")

# Dal la (69) al MI (64), un tasto alla volta: ognuno moltiplica per 2^(-1/12).
scala = [round(frequenza(n)) for n in range(69, m - 1, -1)]
print(f"dal la al MI: {scala}, fattore {2 ** (-1 / 12):.3f} a tasto")

# Cento cent fanno un semitono, 1200 cent un'ottava: la scala e' logaritmica.
ottava = frequenza(m + 12) / fm
cent = 1200 * np.log2(ottava)
print(f"dodici semitoni: rapporto {ottava:.1f}, {cent:.0f} cent")

# Vibrato: oscillazione in cent attorno alla nota (A e f_v: valori di esempio).
A, fv = 50.0, 5.5                     # profondita' (cent), frequenza (Hz)
tau = np.arange(0.0, durata, 0.001)   # tempo in secondi, un campione al ms
f0_tau = fm * 2.0 ** (A * np.sin(2 * np.pi * fv * tau) / 1200)

print(f"f0(tau) fra {f0_tau.min():.2f} e {f0_tau.max():.2f} Hz")
sopra, sotto = f0_tau.max() - fm, f0_tau.min() - fm
print(f"sopra la nota {sopra:+.2f} Hz, sotto {sotto:+.2f} Hz")
print(f"oscillazioni complete in {durata} s: {fv * durata:.1f}")

# Controllo: rimessa in cent, l'escursione massima torna A.
print(f"escursione massima in cent: {1200 * np.log2(f0_tau / fm).max():.1f}")
nota MIDI 64: f_m = 329.63 Hz
dal la al MI: [440, 415, 392, 370, 349, 330], fattore 0.944 a tasto
dodici semitoni: rapporto 2.0, 1200 cent
f0(tau) fra 320.24 e 339.29 Hz
sopra la nota +9.66 Hz, sotto -9.38 Hz
oscillazioni complete in 1.28 s: 7.0
escursione massima in cent: 50.0
La nota 64 sta a 329,63 Hz, cinque tasti sotto il la, con un fattore 0,944 a ogni tasto; dodici semitoni sono 1200 cent per un rapporto di 2. Il vibrato porta l’altezza fra 320,24 e 339,29 Hz, cioè 9,66 Hz sopra la nota e 9,38 sotto: lo scarto è lo stesso in cent, ma in hertz vale un po” di più sopra che sotto. In 1,28 s, a 5,5 oscillazioni al secondo, ne stanno sette, e rimessa in cent l’escursione massima torna ai 50 cent della profondità.
Cucire una voce: Vocaloid#
Vocaloid 2, il motore del 2007 su cui è nata Hatsune Miku, non impara niente [KO07]. È fatto di tre parti, un editor della partitura, una libreria di voce e un motore di sintesi, e la voce che produce viene dalle registrazioni di una persona vera, tagliate e ricucite.
Una cantante entra in studio e registra, su note diverse, ogni passaggio fra una consonante e una vocale, nei due versi, e fra due vocali: «ma», «mo», «am», «om», «ta», «at», «ao» e così via. Sono i difoni. Per l’inglese ne servono circa duemila per ogni altezza registrata, e la registrazione si ripete su più altezze (tre fasce, nella libreria che Yamaha ha usato per una sfida di canto sintetico).
Quando arriva un testo con la sua melodia, il programma non canta: ritaglia. Il testo lo scrive in suoni con un dizionario di pronuncia, e per «amore» prende i pezzi che servono e li dispone in fila. I ritagli però sono stati cantati su note diverse da quella richiesta e in contesti diversi, quindi non combaciano, e le giunture si sentirebbero. Il programma porta ogni pezzo all’altezza giusta (e più c’è da spostarlo, più lo si deve ritoccare) e livella il timbro attorno a ogni giuntura, perché il passaggio da un ritaglio all’altro si senta il meno possibile.
Le vocali lunghe sono un caso a parte, perché una «e» registrata per una sillaba breve non si può semplicemente stirare. La libreria ha perciò registrazioni di vocali tenute, e fra due campioni vicini il timbro si ottiene sfumando dall’uno all’altro. E ogni sillaba viene disposta in modo che la vocale cominci sul battito, con la consonante che parte prima.
Il programma sa solo scegliere, spostare e sfumare, e non inventa mai un pezzo che la cantante non abbia cantato. Una voce nuova vuol dire una nuova sessione di registrazione, e una combinazione di suoni che nessuno ha registrato non esiste.
La libreria del cantante è una base di dati di campioni, in prevalenza difoni, estratti dal canto di persone vere. Per l’inglese vi sono registrate tutte le combinazioni consonante-vocale, vocale-consonante e vocale-vocale, per circa 2000 campioni a ogni altezza; la libreria usata dagli autori per il brano presentato alla Synthesis of Singing Challenge ha campioni in tre fasce d’altezza. Nella libreria stanno anche le vocali tenute, usate per riprodurre il comportamento di una vocale prolungata, e il timbro di una vocale tenuta si ottiene interpolando gli inviluppi spettrali dei campioni vicini [KO07].
Il testo diventa una sequenza di simboli fonetici con un dizionario di pronuncia, e il motore di sintesi seleziona i campioni, li concatena e risolve due problemi, entrambi nel dominio della frequenza: convertire l’altezza di ciascun campione e uniformare il timbro attorno alla giuntura. Lo schema è FFT, marcatura dei picchi, scalatura, modifica delle ampiezze secondo l’inviluppo spettrale e trasformata inversa con finestre sovrapposte. Per cambiare altezza lo spettro di potenza si divide in regioni, ciascuna scalata secondo il rapporto \(R\) fra l’altezza richiesta e quella del campione, in modo da conservare la forma locale attorno a ogni armonica; il timbro si modifica cambiando l’ampiezza di ogni armonica. Nel cambio d’altezza va corretta anche la fase. Nell’ipotesi di armoniche perfette, cioè di frequenze esattamente multiple della fondamentale, alla fase dell’armonica di indice \(h\) si aggiunge a ogni frame
dove \(f_{\text{c}}\) è l’altezza originale del campione, \(R\) il rapporto fra l’altezza dopo la conversione e \(f_{\text{c}}\), \(\Delta\tau\) la durata di un frame, e le armoniche sono numerate da zero, così che quella di indice \(h\) sta a \((h+1)\,f_{\text{c}}\) [KO07]. Nel paper l’altezza del campione si chiama \(f_0\), il rapporto \(T\), l’indice \(i\) e la durata \(\Delta t\). I nomi cambiano perché qui \(f_0(\tau)\) è la fondamentale istantanea della voce, \(T\) il numero dei passi della diffusione, \(i\) l’indice dei fonemi e \(t\) il passo.
Il tempo lo dà la partitura, e il motore dispone i campioni in modo che l’attacco della vocale cada esattamente sul Note-On, anticipando la consonante. Dalla costruzione segue una proprietà: niente è appreso dai dati, e ogni suono prodotto viene da un campione registrato, spostato in altezza di un fattore \(R\), raccordato ai vicini e, per le vocali tenute, interpolato fra due campioni. Il limite è altrettanto strutturale: la copertura è quella della libreria, e quanto più \(R\) si allontana da 1 tanto più il campione va modificato per stare nella nota.
Dalla partitura al mel, con una rete#
Le reti neurali fanno lo stesso mestiere in un altro modo. Invece di conservare i pezzi di una voce, imparano da registrazioni di canto come una partitura diventa suono. Lo schema è quello del TTS in due stadi. Un modello acustico produce il mel-spettrogramma, la tabella che dice, frame per frame, quanta energia ha il suono in ciascuna banda di frequenza (come lo si calcola lo racconta la sezione dal suono alle feature); poi un vocoder, la rete che da quella tabella ricostruisce l’onda, ne fa il suono.
DiffSinger è un modello acustico di questo tipo. Dalla partitura disegna un mel a 80 bande, calcolato a 24 kHz su finestre di 512 campioni che da un frame al successivo si spostano di 128 (lo spostamento, o hop), e affida l’onda a un vocoder, Parallel WaveGAN [LLR+22]. Due frame consecutivi distano quindi \(128/24000\) s, circa 5,3 millisecondi, e la frequenza dei frame è \(r = 187{,}5\) al secondo.
Il canto cambia ciò che entra nel primo stadio. La sequenza dei fonemi viene dal solito dizionario di pronuncia, ma le durate delle note non sono più da indovinare, e all’ingresso si aggiunge l’altezza. Fig. 34.2 mette in fila ciò che entra e ciò che esce, per le tre note e le tre sillabe di «amore».
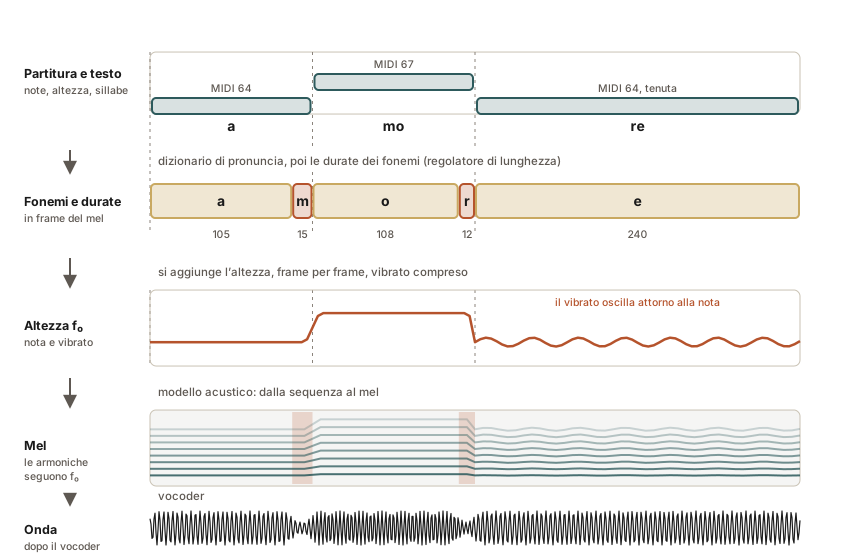
Fig. 34.2 Dalla partitura all’onda per «amore»: le note con le sillabe, i fonemi con le durate in frame, la curva di \(f_0\) con il vibrato sull’ultima nota, il mel, in cui la fondamentale e i suoi multipli (le armoniche) seguono quella curva, e l’onda del vocoder. Le linee tratteggiate sono gli attacchi delle note, su cui cadono le vocali.#
Sullo schermo di un karaoke il testo scorre e le sillabe si accendono a tempo, con sopra il rigo delle note. Sono il testo e la partitura già messi insieme, e il modello acustico fa qualcosa di molto simile. Quello che deve disegnare è il mel, la fotografia del suono: il tempo scorre in orizzontale, le altezze stanno in verticale, le gravi in basso e le acute in alto, e ogni colonna è un istante di pochi millesimi di secondo, un frame. Il modello scompone ogni sillaba nei suoi suoni, e questo lo fa un dizionario di pronuncia; poi lascia acceso ogni suono per tante colonne quante gliene spettano (il pezzo che lo fa si chiama regolatore di lunghezza). Per «amore», la «a» resta accesa 105 colonne e la «m» 15. A ogni colonna affianca l’altezza che la voce deve avere in quel momento, e da lì la rete disegna il mel.
La partitura, però, non dice tutto. Non dice quanto dura ogni suono dentro la sillaba (nel karaoke la sillaba resta accesa per tutta la nota, ma la cantante la divide fra consonante e vocale) e non dice come la voce scivola da una nota all’altra, perché il rigo è fatto di gradini. Nelle prove degli autori di DiffSinger queste cose le dava la registrazione vera, vibrato compreso, e il modello non doveva indovinarle. VISinger invece aggiunge due stimatori: uno indovina quanto dura ciascun suono, in frazione della sua nota, l’altro disegna la curva dell’altezza, colonna per colonna.
Resta il passaggio dal disegno all’onda. Il vocoder, che lo fa, ha imparato sui mel veri e in uso riceve quelli che il primo stadio ha fabbricato, un po’ diversi, come un copista che si è esercitato sugli originali e si trova a lavorare su copie imperfette; succede anche a DiffSinger. VISinger toglie di mezzo il disegno intermedio e scrive direttamente l’onda.
Il modello acustico di DiffSinger codifica la sequenza di fonemi con un Transformer, che dà un vettore \(\mathbf{e}_i\) per ogni fonema \(i\), e un regolatore di lunghezza espande quella sequenza alla lunghezza del mel secondo le durate, ripetendo \(\mathbf{e}_i\) per \(d_i\) frame, con \(\sum_i d_i = n\). Il meccanismo è quello del length regulator descritto per FastSpeech 2 [RHT+21], con una differenza: nel parlato un modello predice le \(d_i\), nel canto la partitura fissa la durata \(b_j\) di ogni nota e resta da stabilire quanti frame vadano a ciascun fonema. L’altezza entra come un indice, tradotto in un embedding che si somma alla sequenza espansa. Negli esperimenti degli autori, su 117 canzoni pop cinesi di una sola cantante, durate e altezza vengono dalla registrazione stessa: le durate dei fonemi da un allineatore forzato, l’altezza dalla \(f_0\) estratta dall’onda [LLR+22]. In quegli esperimenti il vibrato arriva al modello già dentro la \(f_0\), e il modello non lo genera.
VISinger [ZCX+22] parte invece dalle note e da un’osservazione sullo schema a due stadi: il vocoder si addestra sul mel vero e in uso riceve quello predetto, con una differenza di distribuzione fra addestramento e uso. Lo scarto riguarda anche DiffSinger, che usa un Parallel WaveGAN preaddestrato, cioè addestrato per conto suo, e in uso gli passa i mel del modello acustico [LLR+22]. VISinger prende quindi l’architettura end-to-end di VITS [KKS21] (un autoencoder variazionale condizionale con un encoder a posteriori che legge l’onda, un prior reso più flessibile da un normalizing flow e un decoder addestrato in modo avversario) e la adatta al canto in tre punti: la rete del prior lavora a livello di frame e non di fonema; un predittore di \(f_0\) guida la rete del prior; il predittore di durata stima, per il fonema \(i\), il rapporto
fra il suo numero di frame e quello della nota \(j(i)\) che porta la sua sillaba. La durata si ricava come \(\hat{d}_i = \hat{\rho}_i\, b_{j(i)}\), e la perdita confronta \(\hat{d}_i\) con la durata vera \(d_i\). Gli autori chiamano questa scelta normalizzazione per nota, e la motivano così: la durata della nota, scritta nella partitura, è un’informazione a priori sulla durata dei fonemi. La scala la dà la nota, e alla rete resta da stimare una frazione. Nel paper la durata della nota si chiama \(d_N\) e il rapporto \(r\), che qui è la frequenza dei frame.
Tre note con le sillabe «a», «mo», «re» bastano a far vedere le durate in frame, il regolatore di lunghezza che ripete ogni fonema per i suoi frame e la durata di ogni fonema come frazione della nota che porta la sua sillaba. Le consonanti seguono la regola di Vocaloid e anticipano la vocale; le loro durate (80 e 64 millisecondi) sono scelte per l’esempio.
import numpy as np

FPS = 24000 / 128          # frame al secondo del mel (24 kHz, hop 128)

# Tre note (inizio e durata in secondi) con le sillabe a-mo-re. Di ogni
# sillaba: i fonemi, e per le consonanti la durata in secondi.
note = [(0.00, 0.64), (0.64, 0.64), (1.28, 1.28)]
sillabe = [[("a", None)],
           [("m", 0.08), ("o", None)],
           [("r", 0.064), ("e", None)]]

# L'attacco della vocale cade sull'inizio della nota: la consonante parte
# prima e si prende la coda della nota precedente.
fonemi, confini = [], []
for (inizio, _), sillaba in zip(note, sillabe):
    istante = inizio - sum(d for _, d in sillaba if d)
    for nome, d in sillaba:
        fonemi.append(nome)
        confini.append(istante)
        istante += d or 0.0           # la vocale arriva al confine dopo
confini.append(note[-1][0] + note[-1][1])

frame = np.rint(np.array(confini) * FPS).astype(int)
durate = np.diff(frame)               # frame di ogni fonema
print(f"{FPS} frame al secondo")
for f, a, d in zip(fonemi, frame[:-1], durate):
    print(f"{f:>2}  dal frame {a:3d}  durata {d:3d} frame")

# Regolatore di lunghezza: ogni fonema si ripete per i suoi frame.
indici = np.repeat(np.arange(len(fonemi)), durate)
print("frame totali:", len(indici), "(la partitura dura", frame[-1], "frame)")

# Durata di ogni fonema come frazione della nota che porta la sillaba.
lunga = [int(round(d * FPS)) for _, d in note]
nota_di = [0, 1, 1, 2, 2]
rapporti = [round(float(d) / lunga[j], 3) for d, j in zip(durate, nota_di)]
print("fonema/nota:", rapporti)

# La somma dei rapporti, nota per nota (la consonante conta nella sua sillaba).
somme = [round(sum(r for r, j in zip(rapporti, nota_di) if j == k), 3)
         for k in range(len(note))]
print("somma per nota:", somme)
187.5 frame al secondo
 a  dal frame   0  durata 105 frame
 m  dal frame 105  durata  15 frame
 o  dal frame 120  durata 108 frame
 r  dal frame 228  durata  12 frame
 e  dal frame 240  durata 240 frame
frame totali: 480 (la partitura dura 480 frame)
fonema/nota: [0.875, 0.125, 0.9, 0.05, 1.0]
somma per nota: [0.875, 1.025, 1.05]
Le cinque durate sommano a 480 frame, 2,56 s, la lunghezza della partitura. La «a» dura 105 frame e non 120 perché la «m» di «mo» le ha tolto gli ultimi 15; la «o» ne ha 108, perché la «r» di «re» ne ha presi 12. I rapporti misurano ogni fonema sulla nota della sua sillaba. La «m» dura un ottavo della nota di «mo», la «r» un ventesimo di quella di «re», le vocali dall’87,5 al 100 per cento.
La convenzione dell’esempio è mista, e lo si vede dalle somme. Le consonanti prendono i frame dalla nota precedente, ma si misurano sulla nota della propria sillaba, quindi i rapporti dei fonemi di una stessa nota non sommano a 1: per «mo» fanno 0,125 + 0,9 = 1,025, per «re» 0,05 + 1 = 1,05, per «a» soltanto 0,875. VISinger misura ogni fonema sulla nota «corrispondente», e non dice come tratti una consonante che comincia nella nota prima [ZCX+22].
I rapporti non sono nemmeno indipendenti dal tempo. A un tempo due volte più lento le note raddoppiano, mentre le consonanti dell’esempio, che hanno una durata fissa in secondi, restano uguali, e il rapporto della «m» si dimezza. È la parte che il predittore di durata di VISinger deve imparare.
Partire da un mel sfocato: la diffusione poco profonda#
Una rete che disegna il mel si addestra confrontando il suo disegno con il mel vero, e la misura dell’errore, la funzione di perdita, decide che cosa impara. La stessa partitura, però, si può cantare in molti modi. Con le due misure più semplici, la differenza in valore assoluto (L1) e il suo quadrato (L2), alla rete conviene stare nel mezzo: impara un mel che sta fra quelli plausibili e non è nessuno di loro, e il risultato esce sfocato. Gli autori di DiffSinger lo attribuiscono al fatto che quelle perdite presuppongono una sola risposta giusta, l’ipotesi unimodale [LLR+22].
Le alternative hanno ciascuna il suo limite. Con una rete avversaria, in cui un generatore impara in gara con un discriminatore che cerca di riconoscere i falsi, i mel escono più nitidi ma l’addestramento è instabile [LLR+22]. La diffusione, che costruisce il mel togliendo rumore un passo alla volta, sa rappresentare anche molte risposte diverse e ugualmente buone (una distribuzione con più mode), ma richiede molti passi.
DiffSinger tiene la diffusione e ne accorcia il percorso. Il processo inverso, quello che toglie il rumore, non parte dal rumore puro, al passo \(T\), ma da un passo intermedio \(k < T\), ottenuto sporcando un mel sfocato. Gli autori la chiamano diffusione poco profonda.
Hai due fotografie di uno stesso volto: una nitida e una sfocata, che è la media di molte pose. Lasci cadere su tutte e due un velo di nebbia che si infittisce un passo alla volta, cento passi in tutto. Dopo pochi passi le distingui ancora; verso la metà la nebbia ha coperto i dettagli fini e la sfocata non si distingue più dalla nitida; alla fine non si vede più niente in nessuna delle due. Le due fotografie stanno per due mel, le fotografie del suono: la nitida per quello di una cantante vera, la sfocata per quello di una rete semplice, che mescola i tanti modi di cantare la stessa partitura come la fotografia sfocata mescola le pose.
Un restauratore, a cui si dice di chi è il volto, ha imparato a togliere la nebbia dalle fotografie nitide, passo dopo passo, ed è bravissimo. Per fargli generare un volto si potrebbe partire da una nebbia completa e fargli fare tutti i cento passi. DiffSinger fa diversamente. Una rete semplice prepara prima la fotografia sfocata, quella che sa dare; poi la si copre di nebbia fino al passo 54, non fino al 100, e il restauratore riparte da lì. Può farlo perché, a quel punto, la nebbia sopra la sfocata e quella sopra la nitida non si distinguono: lui non può sapere di ripulire la sfocata e non la nitida, e finisce per restituire una fotografia nitida. Risparmia quarantasei passi su cento.
Il passo da cui si riparte va scelto bene, e dipende da quanto la sfocata è lontana dalla nitida: più è lontana, più nebbia ci vuole per confonderle. Se la nebbia è troppo rada, i difetti della sfocata passano nel risultato; se è più fitta del necessario, il restauratore rifà un lavoro che non serviva.
Un modo di trovarlo è un confronto. Nemmeno la nebbia completa, da cui il restauratore partirebbe di solito, è identica a una fotografia velata per cento passi, perché lì del volto resta ancora una traccia, anche se l’occhio non la vede più; è uno scarto che lui sopporta già. Il passo giusto è allora il primo in cui le due fotografie velate differiscono fra loro non più di quanto la nebbia completa differisca da una fotografia velata per cento passi: da lì, partire dalla sfocata non è peggio che partire dalla nebbia completa.
Lo può trovare anche una seconda rete, che guarda le due fotografie sotto la nebbia e prova a dire qual è la sfocata: il passo giusto è il primo in cui non ci riesce più. Oppure lo si sceglie a mano, guardando i risultati su foto di prova. Fatta la scelta, il tempo scende quasi in proporzione ai passi che non si fanno.
Sia \(\mathbf{x}_0\) il mel vero, e \(\boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \mathbf{I})\). Il processo diretto è quello di DDPM [HJA20],
dove \(t\) è il passo intero, da 1 a \(T\), come nella sezione sul funzionamento della diffusione (non il \(t\) continuo fra 0 e 1 del flow matching, che indica anch’esso l’avanzamento verso il rumore), con \(\bar{\alpha}_t = \prod_{s \le t}(1-\beta_s)\), un calendario lineare di \(\beta_t\) da \(10^{-4}\) a \(0{,}06\) e \(T = 100\) [LLR+22]. Un decoder ausiliario, addestrato con la perdita L1, produce a partire dalla partitura un mel sfocato \(\tilde{\mathbf{x}}\). Con L2 il minimizzante è la media condizionata, con L1 la mediana (componente per componente), e quando \(p(\mathbf{x}_0 \mid \text{partitura})\) è multimodale tendono a cadere fra le mode, che è l’over-smoothing di cui parlano gli autori.
La diffusione poco profonda sporca \(\tilde{\mathbf{x}}\) con lo stesso processo diretto, ma solo fino a \(k < T\),
e fa partire da lì il processo inverso, con la rete \(\boldsymbol{\epsilon}_\theta\) condizionata dalla partitura, per \(k\) passi invece di \(T\); in addestramento la rete vede infatti soltanto i passi da 1 a \(k\). La sostituzione è lecita se la legge di partenza, \(q(\mathbf{x}_k \mid \tilde{\mathbf{x}})\), è vicina a quella che il processo inverso ha visto in addestramento; gli autori parlano di un’intersezione fra le traiettorie di diffusione del mel vero e di quello sfocato. Nell’appendice della versione arXiv la condizione diventa un numero, calcolato su una coppia di mel. Al passo \(t\) le due leggi \(q(\mathbf{x}_t \mid \mathbf{x}_0)\) e \(q(\mathbf{x}_t \mid \tilde{\mathbf{x}})\) sono gaussiane con la stessa covarianza \((1-\bar{\alpha}_t)\mathbf{I}\), e la divergenza di Kullback-Leibler che le separa vale
dove \(\mathrm{SNR}(t) = \bar{\alpha}_t/(1-\bar{\alpha}_t)\) è il rapporto segnale-rumore al passo \(t\), cioè la varianza del segnale sopravvissuto divisa per quella del rumore accumulato.
In uso, però, \(\mathbf{x}_0\) non è noto, e la legge che il processo inverso ha visto in addestramento, per una data partitura, è la marginale
con la media sui mel veri compatibili con quella partitura. La divergenza a coppie la tiene sotto controllo: per la convessità congiunta della divergenza di Kullback-Leibler (disuguaglianza di Jensen),
quindi una divergenza a coppie piccola in media basta a rendere vicine le due leggi di partenza.
La divergenza scende al crescere del passo, perché il rapporto segnale-rumore decresce, e l’intersezione si apre dove \(\mathrm{SNR}(t)\) è abbastanza piccolo da compensare la distanza fra i due mel. Dove cada il passo giusto dipende da quella distanza: la norma somma tutte le componenti, quindi cresce con la dimensione del mel e con lo scarto fra i due, e \(k\) va ritrovato per ogni coppia di decoder ausiliario e dati. Nell’appendice gli autori propongono il criterio più semplice: il più piccolo \(t\) in cui la divergenza, in media sui mel di validazione, non supera quella fra \(q(\mathbf{x}_T \mid \mathbf{x}_0)\) e la gaussiana standard \(\mathcal{N}(\mathbf{0}, \mathbf{I})\), cioè lo scarto che il processo completo accetta già quando parte dal rumore puro. Nel testo principale usano invece un predittore di confine, un classificatore addestrato a dire se un mel sporcato al passo \(t\) viene dal mel vero o da quello sfocato, e \(k\) è il passo da cui non li distingue più. Si può anche sceglierlo a mano sul validation set; nel loro esperimento vale \(k = 54\).
Il denoiser è una WaveNet non causale di 20 blocchi convoluzionali a 256 canali; nell’ablazione degli autori, togliere il meccanismo fa perdere 0,500 punti di CMOS, il punteggio di preferenza in un confronto appaiato [LLR+22]. La misura è presa con le durate dei fonemi e la \(f_0\) estratte dalle registrazioni (con il Montreal Forced Aligner e con Parselmouth), quindi con il vibrato dato al modello e non generato.
Il calcolo si fa su due colonne di mel d’esempio, una «vera» e la stessa sfocata con una media mobile, con il calendario lineare di DiffSinger (il rumore aggiunto a ogni passo cresce in linea retta). A ogni passo si guardano il rapporto segnale-rumore, cioè quanto resta del mel rispetto al rumore accumulato, e la divergenza di Kullback-Leibler fra le due colonne coperte di rumore, che vale zero solo quando le due leggi coincidono e qui si misura in nat, con il logaritmo naturale al posto di quello in base 2. Il primo passo utile si cerca con il criterio dell’appendice: il primo in cui la divergenza fra le due colonne non supera quella fra il mel vero alla fine del processo completo e il rumore puro.
import numpy as np

# Calendario lineare di DiffSinger: T = 100 passi, beta da 1e-4 a 0,06.
T, k = 100, 54
beta = np.linspace(1e-4, 0.06, T)
alfa_barra = np.cumprod(1.0 - beta)   # alfa_barra[t-1] e' \bar{alpha}_t
snr = alfa_barra / (1.0 - alfa_barra)

for t in (10, 30, k, T):
    print(f"t = {t:3d}   alfa_barra = {alfa_barra[t-1]:.4f}"
          f"   SNR = {snr[t-1]:.4f}")

# Una colonna di mel "vera" (80 bande) e la stessa colonna sfocata da una
# media mobile a tre punti. Sono dati di esempio; i bordi restano fuori.
bande = np.arange(80)
x0 = 0.5 * np.sin(bande / 3.0) + 0.3 * np.sin(bande * 1.3)
sfocata = np.convolve(x0, [0.25, 0.5, 0.25], mode="same")
x0, sfocata = x0[1:-1], sfocata[1:-1]
d2 = np.sum((x0 - sfocata) ** 2)
print(f"distanza al quadrato fra le due colonne: {d2:.3f}")

# Al passo t le due colonne diventano due gaussiane con la stessa varianza e
# medie che differiscono di sqrt(alfa_barra) * (x0 - sfocata): la loro KL vale
# 1/2 * SNR(t) * d2.
kl = 0.5 * snr * d2
for t in (10, 30, k, T):
    print(f"t = {t:3d}   KL = {kl[t-1]:.3f} nat")

# Criterio dell'appendice: il primo passo in cui la KL non supera quella fra
# q(x_T | x0) e N(0, I), che vale (a (|x0|^2 - dim) - dim log(1 - a)) / 2 con
# a = alfa_barra al passo T e dim componenti.
a, dim = alfa_barra[-1], len(x0)
soglia = 0.5 * (a * (np.sum(x0 ** 2) - dim) - dim * np.log(1.0 - a))
primo = int(np.argmax(kl <= soglia)) + 1
print(f"KL fra x_T e il rumore puro: {soglia:.3f} nat")
print(f"primo passo con KL non superiore: t = {primo}")
t =  10   alfa_barra = 0.9721   SNR = 34.8601
t =  30   alfa_barra = 0.7651   SNR = 3.2564
t =  54   alfa_barra = 0.4144   SNR = 0.7078
t = 100   alfa_barra = 0.0465   SNR = 0.0488
distanza al quadrato fra le due colonne: 0.481
t =  10   KL = 8.384 nat
t =  30   KL = 0.783 nat
t =  54   KL = 0.170 nat
t = 100   KL = 0.012 nat
KL fra x_T e il rumore puro: 0.351 nat
primo passo con KL non superiore: t = 42
Il rapporto segnale-rumore è 0,71 al passo 54 e 0,049 al passo 100, dove il segnale è quasi del tutto coperto. Nell’esempio la divergenza scende da 8,4 nat al passo 10 a 0,17 al passo 54 e a 0,012 al passo 100. La soglia del criterio, cioè la divergenza fra il mel vero dopo tutti i cento passi e il rumore puro, vale 0,351 nat, e la divergenza fra le due colonne non la supera più dal passo 42. Da lì in poi, nella lettura degli autori, partire dalla colonna sfocata non è peggio che partire dal rumore.
Con una distanza minore fra i due mel il passo sarebbe più basso, con una maggiore più alto. Nell’esperimento di DiffSinger, su dati veri e con il predittore di confine (un classificatore che prova a distinguere il mel vero da quello sfocato sotto il rumore), vale 54.
Resta il tempo di calcolo. Se il tempo sta nel ciclo dei passi, facendone \(k\) invece di \(T\) dovrebbe scendere nello stesso rapporto. Gli autori misurano il fattore di tempo reale, cioè i secondi di calcolo per ogni secondo di audio generato, e dichiarano 0,348 senza il meccanismo e 0,191 con esso. Sono misure prese con le durate e l’altezza estratte dalle registrazioni vere, quindi con il vibrato già dato al modello e non generato.
# Valori dichiarati dagli autori di DiffSinger: T = 100 passi, k = 54, e il
# fattore di tempo reale (secondi di calcolo per secondo di audio).
T, k = 100, 54
rtf_completo, rtf_poco_profonda = 0.348, 0.191

print(f"passi: {k}/{T} = {k / T:.3f}")
rapporto = rtf_poco_profonda / rtf_completo
print(f"tempo: {rtf_poco_profonda}/{rtf_completo} = {rapporto:.3f}")
print(f"risparmio di tempo: {1 - rapporto:.1%}")
passi: 54/100 = 0.540
tempo: 0.191/0.348 = 0.549
risparmio di tempo: 45.1%
I passi sono il 54 per cento, il tempo il 54,9, e il 45,1 per cento di tempo risparmiato è quasi quanto i quarantasei passi tolti su cento lasciavano prevedere. Il tempo resta di poco sopra la proporzione dei passi, com’è naturale se non tutto il calcolo sta nel ciclo (la versione poco profonda, per esempio, fa girare in più il decoder ausiliario, la rete semplice che prepara il mel sfocato); quanto pesi la parte che non dipende dai passi, però, due sole misure non bastano a dirlo.
ACE Studio: la partitura e il testo come ingresso#
ACE Studio, un prodotto della società TimeDomain, parte da una melodia in formato MIDI e da un testo e ne fa una voce cantata. Secondo il sito, l’utente controlla ogni frase, le inflessioni dell’altezza, il vibrato e le sfumature espressive: sono i due fogli di Vocaloid e di DiffSinger, e quei controlli agiscono sulla curva dell’altezza e sul suo vibrato. Il motore, dice ancora il sito, è addestrato su registrazioni concesse in licenza da cantanti veri.
La sua architettura, invece, non è pubblicata: nessun paper e nessun report la descrive, e non si può dire se sia a due stadi, end-to-end (dalla partitura all’onda in un passaggio solo, come VISinger) o a diffusione. Si può dire soltanto quale problema affronta, che è quello di DiffSinger e VISinger.
ACE Studio guida, insieme a StepFun, anche ACE-Step, il modello aperto che genera la canzone intera [GZW+25]. Ad ACE-Step si danno etichette di stile e un testo, senza spartito, e il modello produce insieme voce e accompagnamento; come ci riesce è argomento della diffusione sull’intera canzone.
Da ricordare
Chi canta ha una partitura: a ogni sillaba una nota, con la sua altezza e la sua durata. Per questo la domanda di ogni canzone, dove cade ciascuna sillaba nel tempo, qui ha già la risposta.
Il canto ha cose che il parlato non ha: le vocali che si tengono, l’altezza che ondeggia attorno alla nota (il vibrato) e la vocale che cade sul battito, con la consonante che parte prima.
Vocaloid 2, il motore del 2007, cuce pezzi di una cantante vera: porta ogni pezzo all’altezza della nota e livella le giunture. Non impara niente, e non inventa niente.
Una rete impara dalle registrazioni come una partitura diventa suono. Ogni suono resta acceso per le colonne del mel che gli spettano, e due stimatori guidano la durata dei suoni e la curva dell’altezza.
DiffSinger parte da un mel sfocato coperto di nebbia fino al passo 54, invece che dalla nebbia completa, e compie 54 passi invece di 100, con un tempo che cala quasi nella stessa proporzione.
ACE Studio, da una melodia in MIDI e da un testo, fa una voce cantata; il suo motore non è descritto in nessuna pubblicazione.
Da ricordare
Nel canto la partitura fissa il numero di frame \(b_j\) di ogni nota e il suo numero MIDI \(m\), con \(f_m = 440 \cdot 2^{(m-69)/12}\); il vibrato è \(f_0(\tau) = f_m \cdot 2^{A\sin(2\pi f_v\tau)/1200}\), escursione simmetrica in cent. L’attacco della vocale cade sull’inizio della nota e la consonante lo anticipa. Il canto altera fonemi, durate e prosodia rispetto al parlato.
Vocaloid 2, il motore del 2007 [KO07], concatena difoni (circa 2000 per altezza) e lavora in frequenza: conversione d’altezza per regioni dello spettro, correzione della fase, livellamento del timbro. Niente è appreso dai dati, e la copertura è quella della libreria.
DiffSinger codifica i fonemi, espande con il regolatore di lunghezza (\(\sum_i d_i = n\)), somma l’altezza e disegna un mel a 80 bande; nei suoi esperimenti durate e \(f_0\) vengono dalla registrazione, vibrato compreso. VISinger è end-to-end sul modello di VITS, parte dalle note e predice \(f_0\) e il rapporto \(\rho_i = d_i/b_{j(i)}\).
La diffusione poco profonda parte da \(\mathbf{x}_k\) ottenuto dal mel sfocato del decoder L1, e la rete inversa si addestra sui soli passi da 1 a \(k\). È lecita quando la divergenza a coppie \(D_{\mathrm{KL}}(k) = \tfrac12\mathrm{SNR}(k)\,\lVert\mathbf{x}_0-\tilde{\mathbf{x}}\rVert^2\) è piccola in media sui dati: per Jensen maggiora quella fra le marginali. Con \(k = 54\) su \(T = 100\) il tempo scende quasi nel rapporto dei passi (0,191 contro 0,348 secondi per secondo di audio).
ACE Studio (TimeDomain) porta MIDI e testo in voce cantata; il motore non è pubblicato. È co-promotore di ACE-Step insieme a StepFun [GZW+25].
Con la partitura in mano il posto di ogni sillaba è un dato, e il regolatore di lunghezza non fa che ricopiarlo nei frame. Una canzone generata da un testo questo dato non lo riceve, e il modello deve procurarselo da solo. È il problema da cui parte la canzone come sequenza di token.