


La canzone come linguaggio: voce e accompagnamento in fila#
Nel libretto di un disco i versi stanno uno sotto l’altro, con la loro punteggiatura e nient’altro. Chi non ha mai sentito il pezzo non sa quando cade ciascuna sillaba: un verso può passare in un respiro o stendersi su una vocale tenuta, e il ritornello, che nel disco torna più volte, sul libretto è spesso stampato una volta sola, o indicato con un semplice «chorus». Il libretto, cioè, non contiene l’allineamento fra testo e canto.
Per un cantante sintetico guidato da una partitura l’allineamento è dato: la voce che canta riceve note e durate già scritte, e al testo resta solo da adattarvisi. Un modello che genera la canzone intera parte invece dal testo, con al più qualche indicazione di stile, e l’allineamento deve procurarselo da sé.
Una strada è quella dei token, già percorsa da AudioLM e da MusicGen. Una rete come i codec neurali riduce il suono a una fila di token, cioè di numeri interi presi da un elenco finito, uno o più per ogni breve tratto di suono, detto frame; un modello di linguaggio li scrive poi uno dopo l’altro, come le parole di una frase. Su questa strada l’allineamento è arrivato in due passi. Jukebox [DJP+20] lascia che sia la rete a impararlo, dentro una finestra di testo scelta con una stima grossolana. YuE [YLG+25] lo scrive nella sequenza stessa, sezione per sezione, e intreccia voce e accompagnamento in una fila sola.
Imparare l’allineamento: Jukebox#
Jukebox chiama il compito lyrics-to-singing: dato il testo, produrre il canto. Il confronto con il text-to-speech spiega perché sia più difficile: il testo arriva senza tempi, e spesso con un rimando come «chorus» al posto delle parti ripetute [DJP+20].
Il modello della musica genera i suoi token a pezzi di circa 24 secondi, quanti ne vede in una volta sola (il suo contesto), e il testo intero non gli viene dato. In addestramento ogni pezzo riceve una finestra di caratteri centrata sul punto del testo in cui il pezzo dovrebbe cadere. All’inizio gli autori stimavano quel punto distribuendo i caratteri in modo uniforme sulla durata del brano; poiché la stima falliva nei generi con testi veloci, come l’hip-hop, sono passati a estrarre la voce con un separatore di sorgenti e ad allinearla al testo parola per parola con un allineatore forzato per il canto. La finestra è abbastanza larga da contenere quasi certamente i versi cantati.
Dentro la finestra, però, nessuno dice quale carattere cada in quale istante. Il testo passa per un encoder, una rete che ne fa una fila di vettori, e il modello della musica lo consulta con un’attenzione encoder-decoder: a ogni istante dà un peso a ciascun carattere della finestra, e quali pesare di più lo impara da sé. Gli autori ne pubblicano la mappa, cioè i pesi istante per istante e carattere per carattere, e quella mappa ricalca l’allineamento fra il testo e il canto. Senza testi, la voce che il modello genera è fatta per lo più di balbettio, anche su melodie convincenti.
Un cantante improvvisa la melodia di una canzone, ma deve pronunciare versi che non ha scelto. Il testo intero non lo vede mai: un assistente gli tiene sul leggio una striscia di carta con qualche verso, più o meno all’altezza del punto della canzone in cui si trova, abbastanza larga perché i versi giusti ci siano quasi sempre. Sulla striscia non ci sono note né durate, e nessun segno dice quando passare al verso dopo.
A ogni istante il cantante decide che suono emettere. Per deciderlo ascolta quello che ha già cantato e guarda la striscia, con un dito sulla sillaba che sta cantando, e quella sillaba entra nel suono che esce. Al confine fra due sillabe il dito sta a metà, un poco sull’una e un poco sull’altra, e un istante dopo passa del tutto alla seconda; se la vocale è tenuta a lungo il dito resta fermo, e cambia soltanto il suono. Nessuno gli ha mai insegnato dove metterlo: lo ha imparato perché, a dito sbagliato, la sillaba usciva nel posto sbagliato e la canzone non tornava. Il dito sulla striscia è ciò che si chiama attenzione.
Il dito potrebbe anche tornare indietro, ma la striscia va soltanto avanti. Al secondo ritornello i versi da cantare spesso non ci sono, perché chi l’ha scritta ha messo la parola «ritornello» al posto delle parole; e se anche li avesse scritti per esteso, una volta sola, potrebbero essere già usciti dalla striscia. Se poi l’assistente fa scorrere la striscia a velocità costante, nei pezzi rap, dove le parole corrono, la striscia e il canto si scollano e i versi giusti finiscono fuori dalla carta. Senza striscia, infine, il cantante canta sillabe che sembrano parole e non lo sono, come chi tiene una melodia imitando una lingua che non conosce.
Con la notazione dell’allineamento fra testo e tempo, \(\boldsymbol{\ell} = (\ell_1,\dots,\ell_L)\) è il testo, che per Jukebox è una fila di caratteri, e \(\mathbf{a} = (a_1,\dots,a_L)\) l’allineamento, con \(a_j\) il frame in cui comincia il carattere \(j\) (i frame si contano da 0). I token della musica \(c_0,\dots,c_{n-1}\) sono i codici del livello più alto del VQ-VAE di Jukebox, uno ogni 128 campioni dell’onda a 44,1 kHz, e il contesto ne contiene 8.192, circa 24 secondi. Il modello è autoregressivo, \(p(c_i \mid c_{<i}, \boldsymbol{\ell}_{\mathcal F})\), dove \(\boldsymbol{\ell}_{\mathcal F}\) sono i caratteri di una finestra \(\mathcal F \subset \{1,\dots,L\}\), e il testo entra in alcuni strati aggiuntivi del decoder con un’attenzione encoder-decoder:
dove \(\mathbf{q}_i\) è la query ricavata dallo stato del decoder al frame \(i\), cioè da \(c_{<i}\), \(\mathbf{k}_j\) e \(\mathbf{v}_j\) sono chiave e valore del carattere \(j\) prodotti dall’encoder del testo, \(d_k\) è la dimensione di query e chiavi e \(\mathbf{o}_i\) è il vettore che il decoder somma al proprio stato.
In addestramento \(\mathcal F\) si sceglie da una stima di \(\mathbf{a}\): prima lineare, con i caratteri distribuiti in modo uniforme sulla durata del brano, poi, poiché sui testi veloci la stima lineare sbagliava, da un allineamento parola per parola calcolato da NUS AutoLyricsAlign sulla voce separata con Spleeter. La finestra è centrata sul pezzo e abbastanza larga da contenere con alta probabilità i caratteri cantati. La stima serve soltanto a scegliere \(\mathcal F\): dentro la finestra \(\mathbf{a}\) resta una variabile nascosta. Un modello che ha imparato l’allineamento concentra \(\alpha_{i,\cdot}\) sul carattere cantato al frame \(i\), cioè sull’ultimo \(j\) con \(a_j \le i\), e la mappa \((i,j)\mapsto\alpha_{i,j}\) è ciò che mostra la Figura 3 di Jukebox.
Se ogni carattere è cantato una volta, nell’ordine in cui è scritto, il carattere cantato non torna mai indietro al crescere di \(i\), e resta fermo per molti frame dove una vocale è tenuta: è il vincolo \(a_1 < \dots < a_L\). Nulla nell’attenzione lo impone, perché i pesi \(\alpha_{i,j}\) possono cadere su qualunque carattere di \(\mathcal F\), anche già cantato; ad avanzare è la finestra. Il testo, poi, è impreciso: per gli autori indica spesso le parti ripetute con un rimando come «chorus», e alcuni tratti non corrispondono alla musica. Una ripetizione scritta così non ha le sue parole in \(\mathcal F\), e una scritta per esteso una volta sola, alla seconda esecuzione, può essere già uscita dalla finestra. In generazione la finestra avanza in modo lineare, e per hip-hop e rap gli autori riportano una probabilità più bassa di ottenere un canto plausibile. Senza testo, nei modelli condizionati soltanto su artista e genere, la voce che ne esce è fatta per lo più di balbettio.
Un esempio inventato rende concreto l’allineamento: la stessa riga di sei sillabe cantata in due modi, a \(r = 50\) frame al secondo, con i frame d’inizio \(a_j\) contati da 0, la sillaba che suona ogni quattro frame e l’errore della stima lineare; poi un testo con il ritornello scritto una volta sola.
import numpy as np

r = 50                                    # frame al secondo
sillabe = ["la", "lu", "na", "sul", "ma", "re"]
L = len(sillabe)
rng = np.random.default_rng(3)

veloce = rng.integers(8, 16, size=L)      # frame per sillaba
lenta = veloce.copy()
lenta[2] += 60                            # una vocale tenuta
lenta[5] += 90                            # e un'altra, in chiusura

for nome, d in [("veloce", veloce), ("vocali tenute", lenta)]:
    n = int(d.sum())                      # frame della riga
    a = np.concatenate(([0], np.cumsum(d)[:-1]))   # frame d'inizio a_j, da 0
    sillaba = np.repeat(np.arange(1, L + 1), d)       # sillaba di ogni frame
    lineare = np.arange(L) * n / L        # sillabe spalmate in modo uniforme
    errore = np.abs(lineare - a).max()
    print(f"{nome:14s} {n:3d} frame, {n / r:.2f} s, a = {a.tolist()}")
    print("  sillaba ogni 4 frame:", "".join(str(j) for j in sillaba[::4]))
    print(f"  stima lineare: errore massimo {errore:.1f} frame "
          f"({errore / r:.2f} s)")

# il testo scrive il ritornello una volta; il brano lo canta due volte
testo = ["strofa 1", "ritornello", "strofa 2"]
cantato = np.array([0, 1, 2, 1])          # indice della parte di testo
print("ordine cantato:", [testo[k] for k in cantato])
print("sempre in avanti nel testo?", bool(np.all(np.diff(cantato) > 0)))
veloce          63 frame, 1.26 s, a = [0, 14, 22, 31, 40, 49]
  sillaba ogni 4 frame: 1111223344555666
  stima lineare: errore massimo 3.5 frame (0.07 s)
vocali tenute  213 frame, 4.26 s, a = [0, 14, 22, 91, 100, 109]
  sillaba ogni 4 frame: 111122333333333333333334455566666666666666666666666666
  stima lineare: errore massimo 68.5 frame (1.37 s)
ordine cantato: ['strofa 1', 'ritornello', 'strofa 2', 'ritornello']
sempre in avanti nel testo? False
Le due esecuzioni hanno lo stesso testo e 63 contro 213 frame, e i frame d’inizio coincidono solo per le prime tre sillabe: nessuna regola fissa, come una sillaba ogni tanti frame, può fare da allineamento. Con le vocali tenute la stima lineare sbaglia fino a 68,5 frame, più di un secondo, ed è per questo che la finestra di Jukebox deve essere larga. E con il ritornello cantato due volte l’ordine delle parti torna indietro.
Voce e accompagnamento: due token per istante#
YuE non affida l’allineamento alla sola attenzione: lo affida alla forma della sequenza. Segue la cascata di AudioLM, con la coerenza a monte e la fedeltà a valle, divisa fra due modelli di linguaggio. Il codec di YuE rappresenta ogni frame con una pila di token: il primo livello fissa l’essenziale e i successivi aggiungono i dettagli, come nella quantizzazione residua. Il primo modello, il più grande, legge il testo e scrive soltanto il primo livello, un token per frame, che secondo gli autori porta già la melodia e le parole; il secondo, più piccolo, aggiunge a ogni frame i livelli che mancano, e da quelli il codec ricostruisce il suono [YLG+25].
Un solo token per frame su tutto il mix, però, deve riassumere insieme voce e strumenti, e dove gli strumenti coprono la voce una parte delle parole si perde già nella codifica. YuE separa quindi la canzone in due tracce, voce e accompagnamento, e nel primo stadio dà a ciascuna un token per frame, intrecciati in un’unica fila. Il meccanismo si chiama previsione disaccoppiata per traccia (track-decoupled next-token prediction).
Una persona deve continuare un quaderno di appunti musicali, scrivendo un segno per ogni istante, cinquanta al secondo. Ogni segno è ciò che si chiama token, e ogni istante è un frame. Il segno è un riassunto: dice la melodia e le parole di quell’istante, non tutto il suono. I dettagli li aggiunge dopo un aiutante, che ripassa il quaderno istante per istante e scrive accanto a ogni segno altri segni, più fini.
Se per ogni istante c’è una riga sola, in quella riga finisce tutto insieme, e nei punti dove la batteria copre la voce le parole si perdono. Lo si scopre prima ancora che qualcuno continui il quaderno: si ricopia in segni un disco vero, si rimettono i segni in suono e si fa trascrivere a qualcuno quello che si sente. Le parole che mancano, rispetto alla trascrizione del disco originale, le ha perse la scrittura in segni. Mancano di più in un pezzo metal che in un pezzo hip-hop, e di meno se nella riga c’è soltanto la voce.
Il rimedio è separare. Un programma divide il disco in due tracce, la voce da una parte e tutto il resto dall’altra. Lo si fa su quattro dischi su dieci; gli altri restano interi, su una riga sola, e chi scrive impara tutte e due le forme. Con i dischi separati il quaderno ha due righe per istante, alternate: prima quella della voce, poi quella del resto. Nel quaderno l’ordine conta. La riga del resto si scrive dopo aver letto la voce dello stesso istante, quindi la conosce; la riga della voce si regola su ciò che è successo prima, e non sa ancora che cosa fa il resto in quell’istante.
Il prezzo si vede subito: il quaderno diventa lungo il doppio, due segni per istante invece di uno. In cambio le due righe non si perdono mai di vista. Alternate istante per istante restano allineate da sole, mentre scriverne prima una intera e poi l’altra obbligherebbe a rimetterle d’accordo dopo.
YuE ha due modelli di linguaggio con l’architettura di LLaMA2. Il codec è X-Codec [YSL+25]: 50 frame al secondo e 12 livelli di quantizzazione residua, ciascuno con un codebook di 1024 segni, dei quali YuE usa i primi \(q = 8\). Nel suo spazio latente è fusa la rappresentazione di un modello della famiglia di HuBERT [HBT+21], e secondo gli autori il codebook 0 da solo porta già melodia e contenuto vocale; con i soli token acustici, scrivono, l’addestramento non convergeva in modo efficiente sui loro dati. Lo stadio 1, da 7 miliardi di parametri, modella il testo e i token del codebook 0. Lo stadio 2, da 1 miliardo, è addestrato su segmenti consecutivi di 6 secondi di una traccia sola, con un contesto di 8.192 token: prevede prima tutti i token del codebook 0 e poi, frame per frame, blocchi di 8 token (codebook da 0 a 7). In uso il codebook 0 arriva dallo stadio 1 ed è fissato, quindi i token da scegliere sono i sette residui. Un vocoder leggero porta infine l’audio da 16 a 44,1 kHz [YLG+25].
Sia \(c_i\) il token del codebook 0 al frame \(i\), con \(r = 50\) Hz e \(i = 0,\dots,n-1\). Sul mix c’è un flusso solo, \(c_{0:n-1}\), e ogni token deve rappresentare insieme voce e accompagnamento. Gli autori misurano la perdita di informazione linguistica che ne segue con una differenza di WER,
dove \(\mathrm{WER}_{\text{ori}}\) è l’errore di un Whisper [RKX+23] messo a punto sulle canzoni, calcolato sul brano originale, e \(\mathrm{WER}_{\text{ric}}\) quello sul brano ricostruito dai token. I due brani sono lo stesso audio vero, prima e dopo il passaggio per il codec: \(\Delta\mathrm{WER}\) misura quanto testo perde la tokenizzazione, non la qualità di un modello generativo. Su mille brani cresce passando dall’hip-hop al pop e al metal, ed è più basso sulle tracce di sola voce che sul mix.
Il rimedio separa le tracce. Nel compito di generazione musicale del pre-addestramento un ensemble di separatori (UVR) divide voce e accompagnamento sul 40% delle tracce; le altre restano sul mix, con un token per frame, e un’istruzione in testa alla sequenza distingue le due forme. Nelle tracce separate ciascuna traccia riceve il proprio token, \(c^{\mathrm V}_i\) e \(c^{\mathrm A}_i\). La sequenza diventa \(c^{\mathrm V}_0, c^{\mathrm A}_0, c^{\mathrm V}_1, c^{\mathrm A}_1,\dots\), di lunghezza \(2n\), e la probabilità si fattorizza così:
La regola del prodotto vale per qualunque ordine; YuE mette la voce per prima, per cui \(c^{\mathrm A}_i\) condiziona su \(c^{\mathrm V}_i\) e non viceversa, e il paper non motiva la scelta. Rispetto agli approcci che modellano le due tracce una dopo l’altra, o che modificano l’architettura, l’intreccio lascia intatto il modello di linguaggio e tiene le tracce allineate frame per frame. Il costo è una sequenza lunga il doppio: 100 token al secondo contro 50.
Un esempio con sei frame e token inventati mostra l’intreccio, la sua inversione, che cosa vede ciascun token quando viene previsto e quanti bit nominali porta al secondo il codebook 0 delle due tracce.
import numpy as np

n = 6                                          # frame
voce = np.array([512, 512, 87, 87, 301, 640])  # token inventati, traccia voce
acc = np.array([14, 933, 933, 21, 21, 77])     # traccia accompagnamento

fila = np.empty(2 * n, dtype=int)
fila[0::2] = voce                              # voce e acc., frame per frame
fila[1::2] = acc
print("fila intrecciata:", fila.tolist())

voce2, acc2 = fila[0::2], fila[1::2]           # la separazione inversa
print("separate di nuovo:", np.array_equal(voce2, voce),
      np.array_equal(acc2, acc))

# che cosa vede ogni token quando viene previsto: i posti che lo precedono
traccia = np.array(["V", "A"] * n)             # di chi è ogni posto della fila


def visti(posto):
    prima = traccia[:posto]
    return int(np.sum(prima == "V")), int(np.sum(prima == "A"))


print("frame | token voce vede (voce, acc) | token acc vede (voce, acc)")
for i in range(n):
    vv, va = visti(2 * i)                      # il posto della voce del frame
    av, aa = visti(2 * i + 1)                  # il posto dell'accompagnamento
    print(f"{i:5d} | {vv:12d} {va:5d}          | {av:12d} {aa:5d}")

bit = np.log2(1024)                            # codebook da 1024 segni
print(f"un token: {bit:.0f} bit; una traccia a 50 Hz: {bit * 50:.0f} bit/s; "
      f"due tracce: {2 * bit * 50:.0f} bit/s")
print(f"token semantici di AudioLM (1024 segni, 25 Hz): {bit * 25:.0f} bit/s")
fila intrecciata: [512, 14, 512, 933, 87, 933, 87, 21, 301, 21, 640, 77]
separate di nuovo: True True
frame | token voce vede (voce, acc) | token acc vede (voce, acc)
    0 |            0     0          |            1     0
    1 |            1     1          |            2     1
    2 |            2     2          |            3     2
    3 |            3     3          |            4     3
    4 |            4     4          |            5     4
    5 |            5     5          |            6     5
un token: 10 bit; una traccia a 50 Hz: 500 bit/s; due tracce: 1000 bit/s
token semantici di AudioLM (1024 segni, 25 Hz): 250 bit/s
L’intreccio non perde niente e si inverte con due fette. Al frame 2, il terzo, il token della voce ha davanti due token di ciascuna traccia, quello dell’accompagnamento anche la voce del frame stesso.
I bit dicono quanto spazio ha il primo stadio per decidere la canzone. Il secondo stadio parte soltanto dal codebook 0, quindi melodia, parole e struttura devono stare in quei 1.000 bit al secondo, che sono un tetto nominale: contano ogni segno del codebook come se fosse ugualmente probabile. I token semantici di AudioLM, il gradino della sua cascata che fissa la struttura, ne portano 250: il primo stadio di YuE ha quattro volte tanto spazio.
La struttura scritta sezione per sezione#
La finestra di Jukebox teneva il testo vicino al pezzo di musica che lo canta. Nel primo stadio di YuE testo e audio stanno nella stessa fila, e la soluzione più semplice è mettere tutto il testo in testa, prima dell’audio. Gli autori osservano che così il testo perde presa man mano che i token audio si allungano: il degrado comincia attorno ai 3.000 token e diventa fallimento oltre i 6.000, anche con contesti pre-addestrati da 16.000 token.
Fra le difficoltà principali gli autori indicano il decadimento a lungo raggio della RoPE (la codifica posizionale), la proprietà per cui la dipendenza fra due token, misurata dal punteggio d’attenzione, tende a calare con la distanza [SAL+24]. I rimedi diretti, però, non sono serviti, e ascoltando le prove gli autori hanno trovato un altro difetto: i modelli con il testo in testa tendevano ad aprire con lunghi preludi strumentali, e il canto cominciava troppo lontano dal testo.
Quanti secondi siano 3.000 token dipende dal numero di tracce.
r = 50                                         # frame al secondo del codec
for nome, tracce in [("mix", 1), ("due tracce", 2)]:
    tok_s = r * tracce
    righe = [f"{k} token = {k / tok_s:.1f} s"
             for k in (3000, 6000, 8192, 16384)]
    print(f"{nome} ({tok_s} token/s):")
    print("  " + "; ".join(righe[:2]))
    print("  " + "; ".join(righe[2:]))

D, sezioni = 180, 14                           # sezioni di uguale durata
tok = D * 2 * r                                # token a due tracce
sez = tok / sezioni
print(f"{D} s a due tracce: {tok} token")
print(f"una sezione: {D / sezioni:.1f} s, {sez:.0f} token")
print(f"solo testo in testa: l'ultimo token dista {tok} token dal testo")
print(f"  oltre 3000 token: {(tok - 3000) / tok:.1%} della canzone")
print(f"  oltre 6000 token: {(tok - 6000) / tok:.1%} della canzone")
print(f"testo di sezione: al più {sez:.0f} token di audio dal proprio testo")
mix (50 token/s):
  3000 token = 60.0 s; 6000 token = 120.0 s
  8192 token = 163.8 s; 16384 token = 327.7 s
due tracce (100 token/s):
  3000 token = 30.0 s; 6000 token = 60.0 s
  8192 token = 81.9 s; 16384 token = 163.8 s
180 s a due tracce: 18000 token
una sezione: 12.9 s, 1286 token
solo testo in testa: l'ultimo token dista 18000 token dal testo
  oltre 3000 token: 83.3% della canzone
  oltre 6000 token: 66.7% della canzone
testo di sezione: al più 1286 token di audio dal proprio testo
A due tracce i 3.000 token a cui il degrado comincia sono 30 secondi, e i 6.000 del fallimento 60. Il rimedio di YuE, il condizionamento progressivo, porta il testo a ridosso della musica che lo riguarda. Un modello che riconosce la struttura dei brani taglia la canzone in sezioni, in media 14 e quasi tutte sotto i 30 secondi, cioè sotto la soglia del degrado; ogni sezione porta con sé l’etichetta e il proprio testo prima del proprio audio.
Nel paper il condizionamento progressivo si chiama CoT, da Chain-of-Thought: il nome viene dalla catena di pensiero dei modelli di linguaggio [WWS+22], con cui condivide le istruzioni e i passi intermedi scritti nella sequenza per guidare quello che viene dopo; per come è costruito e per l’uso che se ne fa, precisano gli autori, è un metodo diverso. Fig. 34.3 mostra le due tracce intrecciate e le intestazioni di sezione dentro la fila.
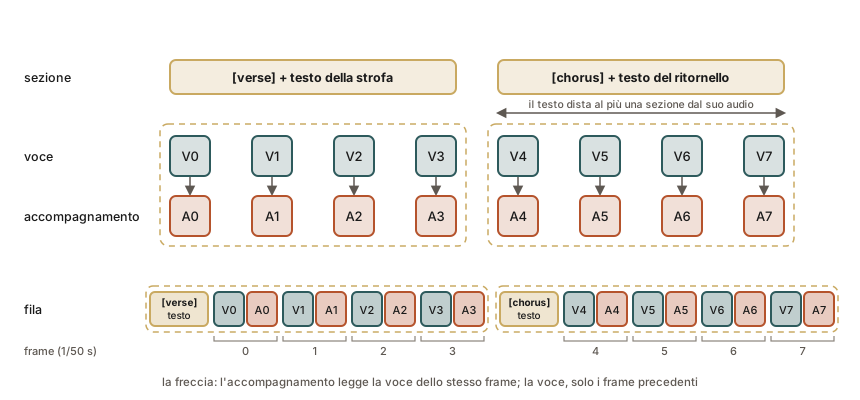
Fig. 34.3 Voce e accompagnamento, un token ciascuno per frame, in una fila sola; dentro la fila, ogni sezione porta in testa l’etichetta e il proprio testo.#
Prima del documento YuE può ricevere anche un frammento audio di un brano di riferimento, da cui prendere voce e stile: è l’apprendimento in contesto portato alla musica, come gli esempi che un modello di linguaggio segue quando li trova nel prompt. Gli autori misurano poi quanto il modello, in questa modalità, ricopi le canzoni su cui ha studiato.
Una cantante legge il testo da un unico foglio grande, appeso in cima al leggio. Per i primi secondi va benissimo; poi il foglio è lontano, e lei perde il segno e comincia a inventare sillabe. Scriverlo a caratteri più grandi o esercitarsi a leggere da sempre più lontano non basta: gli autori hanno provato, e non è servito. Ascoltando le prove, poi, si sente anche un altro guaio: lei lascia suonare la band a lungo prima di attaccare, e quando comincia a cantare il foglio è già lontano.
Funziona dividere la canzone in pagine. Il foglio grande resta in cima, con il genere richiesto e il testo intero; poi ogni pagina porta il nome della parte (intro, strofa, ritornello, ponte, finale), i suoi versi e la musica di quella parte. I versi stanno sempre sulla stessa pagina della musica che li canta, e una pagina dura quasi sempre meno di mezzo minuto. Su quale nota cada ogni sillaba, dentro la pagina, non lo segna nessuno: quello la cantante lo deve capire da sé.
Prima di cominciare la cantante può ascoltare mezzo minuto di un disco da prendere a modello, per la voce e lo stile, e le serve. Se però le si dà questa scorciatoia dal primo giorno di prove, impara a ricopiare il disco invece di comporre, e poi non se ne libera nemmeno quando il disco le viene tolto: per questo il disco le si fa ascoltare soltanto nelle ultime prove, quando sa già comporre.
Resta da sapere se, alla fine, copia. Ogni canzone che ha scritto partendo da un disco su cui ha studiato si mette accanto al disco stesso, e un programma che riconosce le cover misura quanto si somigliano. Anche le coppie più simili si somigliano molto meno di una canzone e la sua cover; ogni tanto ritorna qualche motivo breve e ripetuto, soprattutto un giro di batteria.
Con il solo testo in testa, la distanza fra un token audio e il testo cresce con la posizione del token nella canzone. Gli autori indicano fra le difficoltà principali il decadimento a lungo raggio della RoPE, per cui il limite superiore del punteggio d’attenzione fra due token cala al crescere della loro distanza [SAL+24]. Nell’ablazione con un modello da 0,5 miliardi di parametri, però, né la base della RoPE portata da 10.000 a 100.000, che rallenta le rotazioni e attenua il decadimento a parità di distanza, né un curriculum di durate crescenti (30, 60, 90 secondi e oltre) si avvicinano al condizionamento progressivo: fra 30 e 150 secondi il loro WER resta nettamente più alto. A un esame manuale, gli autori attribuiscono i fallimenti del testo in testa e del curriculum soprattutto a lunghi preludi strumentali, che portano l’inizio del canto lontano dal testo. La RoPE resta quindi una difficoltà indicata, non una causa dimostrata: il rimedio che ne attenua il decadimento non serve, e il difetto che si sente all’ascolto è un altro.
Il documento di addestramento è
dove \(\oplus\) è la concatenazione di sequenze, l’istruzione chiede di generare la musica dal testo sezione per sezione, i tag sono la stringa di stile (genere, strumenti, umore), \(\boldsymbol{\ell}\) è il testo intero, \(\texttt{<EOD>}\) chiude il documento e \(s_1, s_2, \dots\) sono i segmenti delle sezioni, nell’ordine della canzone, ciascuno della forma
con \(\texttt{[etichetta]}\) una fra \(\texttt{[intro]}\), \(\texttt{[verse]}\), \(\texttt{[chorus]}\), \(\texttt{[bridge]}\) e \(\texttt{[outro]}\), \(\boldsymbol{\ell}_{\text{sez}}\) il testo della sezione, \(\boldsymbol{\psi}\) i suoi token audio a due tracce intrecciate, e \(\texttt{<SOA>}\) ed \(\texttt{<EOA>}\) l’inizio e la fine dell’audio.
La distanza fra un token di \(\boldsymbol{\psi}\) e il suo \(\boldsymbol{\ell}_{\text{sez}}\) è limitata dalla lunghezza della sezione, e non dal punto in cui cade nella canzone: meno di 3.000 token per una sezione sotto i 30 secondi, 1.286 nel calcolo con 14 sezioni uguali su 180 secondi, mentre con il solo testo in testa l’83,3% della canzone starebbe oltre la soglia dei 3.000. La sezione dà così un allineamento grossolano, al livello della sezione e non della frase, che gli autori preferiscono anche perché chiede corrispondenze meno precise fra testo e audio, in dati dove i testi sono spesso imperfetti; dentro la sezione, quale sillaba cada in quale frame resta da imparare.
L’apprendimento in contesto per la musica antepone al documento un frammento di 20-40 secondi di una traccia di riferimento: voce, accompagnamento, mix o le due tracce intrecciate. Gli autori avvertono che, introdotto troppo presto, incoraggia una scorciatoia: il modello copia l’audio di riferimento invece di comporre, e togliere poi quei dati non basta a restituirgli la capacità di comporre. L’attivazione è quindi ritardata, con circa 10 miliardi di token di questo tipo solo nella fase finale.
Gli autori misurano la memorizzazione con ByteCover2, un modello che riconosce le cover, su due insiemi di 1.200 brani: quelli di addestramento e quelli che il modello genera da ciascuno, con 30 secondi del brano come riferimento e il suo testo. Guardano l’1% delle somiglianze più alte, e la distribuzione è nettamente più bassa di quella di Covers80, coppie di cover vere, e resta moderata anche nel confronto con GTZAN, brani diversi dello stesso genere. Motivi brevi e ripetuti, in particolare loop di percussioni, ricorrono ogni tanto.
Quanti passi in fila#
Il prezzo della strada a token è il numero di passi da fare uno dopo l’altro. Il primo modello di YuE produce due token per frame, e per tre minuti i passi sono questi.
r, D, q = 50, 180, 4                           # Hz, secondi, livelli MusicGen
n = r * D                                      # frame in tre minuti
yue = 2 * n                                    # YuE: due token per frame
musicgen = n + q - 1                           # MusicGen con il delay pattern
q_yue = 8                                      # i livelli di X-Codec in YuE
ritardo_yue = n + q_yue - 1                    # il ritardo su quegli 8 livelli
contesto = 16384                               # il contesto più lungo di YuE
print(f"frame in {D} s a {r} Hz: {n}")
print(f"YuE, stadio 1 (due token per frame): {yue} passi in fila")
print(f"MusicGen (delay, q = {q}): {musicgen} passi in fila")
print(f"rapporto: {yue / musicgen:.2f}")
print(f"ritardo con q = {q_yue}: {ritardo_yue} passi, {ritardo_yue - n} più "
      f"di un token per frame ({(ritardo_yue - n) / n:.2%})")
print(f"contesto di {contesto} token = {contesto / (2 * r):.1f} s a due tracce")
print(f"{D} s entrano nel contesto? {yue <= contesto}")

cinque = 5 * 60 * 2 * r                        # cinque minuti a due tracce
vista = contesto - 3000 - 1                    # meno i token nuovi, meno 1
print(f"cinque minuti a due tracce: {cinque} token")
print(f"ultimi token tenuti in inferenza: {vista} = {vista / (2 * r):.1f} s")
frame in 180 s a 50 Hz: 9000
YuE, stadio 1 (due token per frame): 18000 passi in fila
MusicGen (delay, q = 4): 9003 passi in fila
rapporto: 2.00
ritardo con q = 8: 9007 passi, 7 più di un token per frame (0.08%)
contesto di 16384 token = 163.8 s a due tracce
180 s entrano nel contesto? False
cinque minuti a due tracce: 30000 token
ultimi token tenuti in inferenza: 13383 = 133.8 s
Sono 18.000 passi contro i 9.003 di MusicGen con il suo ritardo, cioè il doppio. Il raddoppio viene dalle due tracce: con un token per frame il primo stadio ne farebbe 9.000. Gli autori scartano gli schemi a uno stadio come quello di MusicGen per due ragioni dette insieme: sui loro dati la decodifica parallela, con tutti i livelli di un frame nello stesso passo, non arriva a convergenza, e il ritardo dà sequenze più lunghe di quelle di un approccio a più stadi [YLG+25]. La seconda ragione, da sola, pesa poco: il ritardo sugli 8 livelli di YuE darebbe 9.007 passi, sette più di un token per frame, lo 0,08%.
I 18.000 passi, inoltre, sono del solo primo stadio: quelli di MusicGen producono tutti e quattro i livelli del codec, quelli di YuE il solo codebook 0, a cui il secondo modello aggiunge i sette livelli residui. E sono passi da fare uno dopo l’altro, non una misura del lavoro: con la KV cache, la memoria dei calcoli già fatti sui token precedenti, ogni passo fa i calcoli del solo token nuovo e riusa gli altri.
Tre minuti non entrano nemmeno nel contesto più lungo usato in addestramento, e gli autori dichiarano canzoni fino a cinque minuti, 30.000 token a due tracce. Il paper non dice come la generazione oltrepassi il contesto. Descrive una generazione sezione per sezione: il modello scrive audio finché non ne segna la fine, poi riceve l’intestazione della sezione dopo, con al più 3.000 token nuovi per volta, cioè 30 secondi. Il codice di inferenza pubblicato con il modello, quando la fila supera il contesto, ne tiene soltanto gli ultimi 13.383 token, cioè 133,8 secondi: quasi tutto il contesto, meno lo spazio per i 3.000 token da scrivere. L’inizio della canzone, istruzione e testo intero compresi, esce dalla vista, e ogni sezione conserva il proprio testo davanti al proprio audio.
Da ricordare
Il testo di una canzone non dice quando cade ciascuna sillaba. Jukebox [DJP+20] dà al modello una striscia di versi tenuta più o meno all’altezza giusta e lascia a lui il resto: il modello guarda la striscia con un dito che si sposta, a volte a metà fra due sillabe, e nessuno gli ha mai detto dove metterlo. Quel dito è l’attenzione. Nei pezzi rap la striscia e il canto si scollano.
YuE [YLG+25] scrive la canzone in un quaderno, un segno (un token) per istante, e lascia i dettagli del suono a un secondo passaggio. Il quaderno ha due righe per istante, una per la voce e una per il resto, separate da un programma: prima la voce, poi l’accompagnamento, che quindi conosce la voce dello stesso istante. Il quaderno diventa lungo il doppio.
Un foglio di testo appeso all’inizio si perde dopo una trentina di secondi di musica, e scriverlo più grande non basta. Il rimedio è una pagina per ogni parte della canzone, con in cima il nome della parte e i suoi versi; su quale nota cada ogni sillaba, il modello lo impara da sé.
Un disco da prendere a modello aiuta a comporre, ma dato troppo presto insegna a copiare, e il danno resta: lo si introduce solo alla fine. Alla prova, le canzoni somigliano ai loro dischi molto meno di una cover.
Scrivere la canzone un segno dopo l’altro vuol dire migliaia di passi in fila: per tre minuti a due tracce, il doppio di MusicGen.
Da ricordare
L’allineamento \(\mathbf{a}\) fra testo e frame non è dato. Jukebox [DJP+20] passa a ogni pezzo una finestra di caratteri \(\boldsymbol{\ell}_{\mathcal F}\), scelta da una stima grossolana di \(\mathbf{a}\) (lineare, poi da un allineatore forzato), e dentro la finestra lo recupera con un’attenzione encoder-decoder, la cui mappa \(\alpha_{i,j}\) corrisponde all’allineamento. La finestra lineare sbaglia sui testi veloci; senza testi la voce è per lo più balbettio.
YuE [YLG+25] ha due stadi su X-Codec: il primo prevede i token del codebook 0 in due tracce intrecciate, \(c^{\mathrm V}_0, c^{\mathrm A}_0, c^{\mathrm V}_1,\dots\), con \(p(c^{\mathrm V}_i\mid c^{\mathrm V}_{<i},c^{\mathrm A}_{<i})\, p(c^{\mathrm A}_i\mid c^{\mathrm V}_{\le i},c^{\mathrm A}_{<i})\); il secondo aggiunge i sette livelli residui. La diagnosi è \(\Delta\mathrm{WER}\), che misura quanto testo perde la tokenizzazione, più alto sul mix che sulla voce. La sequenza è lunga \(2n\), 100 token al secondo.
Il testo in testa al contesto perde presa attorno ai 3.000 token (30 s a due tracce) e fallisce oltre i 6.000. Gli autori indicano fra le difficoltà principali il decadimento a lungo raggio della RoPE, ma alzarne la base non serve, e all’ascolto i fallimenti vengono soprattutto da lunghi preludi strumentali. Ogni sezione porta \(\texttt{[etichetta]}\oplus\boldsymbol{\ell}_{\text{sez}}\) davanti al proprio audio: un allineamento a livello di sezione, con la distanza dal testo limitata dalla sezione.
L’apprendimento in contesto con un riferimento di 20-40 s si attiva tardi, perché introdotto presto insegna a copiare e il danno non si ripara. Con ByteCover2 la somiglianza fra generati e originali resta nettamente sotto quella delle cover e moderata anche rispetto a brani dello stesso genere.
Per tre minuti il primo stadio fa 18.000 passi in fila, contro i 9.003 di MusicGen con il delay pattern, che però producono tutti i livelli del codec. Gli autori scartano gli schemi a uno stadio perché sui loro dati la decodifica parallela non converge e il ritardo allunga la sequenza, qui di sole \(q-1\) posizioni. Il paper non dice come si oltrepassi il contesto di 16.384 token; il codice di inferenza, oltre il contesto, tiene solo gli ultimi token.
Jukebox e YuE dividono il lavoro allo stesso modo: da fuori arriva un allineamento grossolano, la finestra di testo o la sezione, e il modello impara il resto. Tutta la canzone insieme mette alla prova la stessa divisione su modelli che non scrivono la canzone un token alla volta.