


Generare musica#
Hatsune Miku è un programma. La Crypton Future Media, un’azienda giapponese, lo mette in commercio il 31 agosto 2007 e lo descrive come uno strumento con cui chiunque può generare una voce cantata scrivendo un testo e una melodia. La voce è quella di Saki Fujita, e a produrla è Vocaloid 2, il motore di Yamaha del 2007.
In Vocaloid 2 non c’è nessuna rete neurale: nessuna sua parte ha imparato a cantare ascoltando esempi. Una voce è una libreria di frammenti estratti dal canto di una persona vera, e per una voce inglese i frammenti sono circa duemila per ogni altezza [KO07]. Quando scrivi le note e le parole, il motore sceglie i frammenti giusti, li porta all’altezza richiesta e li cuce, smussando il timbro nei punti di giunzione. A cantare è sempre Saki Fujita, a pezzi.
All’epoca Yamaha non vendeva Vocaloid come prodotto proprio. Ne concedeva la tecnologia e il programma ad aziende terze, come la Crypton, che sviluppavano le proprie librerie di voci e le vendevano insieme al motore [KO07].
Un sistema così non decide niente della musica: la melodia e la durata di ogni sillaba le scrive chi lo usa, e quello che ne esce è soltanto la voce, senza strumenti intorno. Fra questo e i modelli che, dati un testo e qualche indicazione di stile, producono la canzone intera c’è il passaggio dal cucire frammenti al generare il suono.
La musica generata è già materia della sezione sulla generazione di suono e musica, che segue due strade. Nella prima un codec neurale riscrive il suono come una fila di simboli, i token, e da una fila di token sa rifare il suono; un modello scrive la fila un token dopo l’altro, come un modello di linguaggio scrive le parole. Così MusicGen compone un brano a partire da una descrizione, e Jukebox arriva a minuti di canzone con la voce. Nella seconda strada, la diffusione, si parte dal rumore e lo si ripulisce a piccoli passi fino a ottenere il suono.
Una canzone chiede in più il canto di un testo dato, un accompagnamento che sta nello stesso segnale della voce e una forma, fatta di strofe e ritornelli, che deve tenere per minuti.
Il guaio è il testo. Nella formulazione di Jukebox il compito di cantare un testo (lyrics-to-singing) parte dalle sole parole, senza informazioni sui tempi né su come vanno cantate; spesso le parti ripetute sono indicate soltanto da un rimando come «chorus», e alcuni pezzi del testo non corrispondono a ciò che si canta. Nelle registrazioni, poi, voce principale, cori e accompagnamento non sono separati. Per gli autori è questo a rendere il compito molto più difficile del corrispondente text-to-speech [DJP+20].
Anche il text-to-speech deve trovare il momento di ogni suono, e la sezione sulla sintesi vocale racconta come ci riesce. Un predittore di durate stima quanto dura ogni suono della frase, e le durate su cui impara si ricavano dalle registrazioni: con un allineatore esterno, oppure cercando durante l’addestramento l’allineamento più probabile fra quelli che avanzano nel testo senza mai tornare indietro (detti monotoni). Nel canto, però, le durate non vengono dalla lingua ma dalla musica, perché una sillaba dura quanto la nota che la porta, e il testo non lo dice. Dove cade ciascuna sillaba nel tempo è la domanda a cui ogni sistema di generazione di canzoni risponde a modo suo.
In questo capitolo seguiamo il passaggio dal cucire al generare. Si parte dalla partitura, con la voce che canta, che racconta Vocaloid, la sintesi neurale di DiffSinger e ACE Studio. Poi la canzone a token mette voce e accompagnamento in fila come le parole di un linguaggio (Jukebox, YuE), mentre tutta la canzone insieme la genera per diffusione, tutta in una volta e rifinita a ogni passo (DiffRhythm, ACE-Step). Infine prima il progetto aggiunge un pianificatore che decide la struttura prima del suono, e il modo di misurare una canzone.
Che cosa ha in più una canzone#
Per un computer un suono è una fila di numeri. Il segnale del microfono, che segue la pressione dell’aria, viene misurato a intervalli regolari, \(f_s\) volte al secondo (la frequenza di campionamento, 44.100 nella qualità di un CD), e ogni misura è un campione, come nella sezione dal suono alle feature. Una canzone di \(D\) secondi, stereo e campionata a \(f_s\) Hz, è quindi una sequenza di \(2 D f_s\) numeri, metà per il canale sinistro e metà per il destro.
Una rappresentazione compressa dello stesso suono taglia il tempo in fettine uguali, i frame, e riassume ciascuna con molti meno numeri di quelli dell’onda: nei token di un codec ogni frame diventa uno o pochi simboli, nel latente di un autoencoder (la versione ridotta del suono da cui l’autoencoder sa ricostruirlo) un piccolo gruppo di valori. Con \(r\) frame al secondo, una canzone ne ha \(n = rD\).
Indichiamo con \(\mathbf{x}\) la canzone (l’onda, o la sua rappresentazione a \(n\) frame) e con \(\boldsymbol{\ell}\) il testo che la descrive. Generare una canzone vuol dire estrarre \(\mathbf{x}\) dalla distribuzione condizionata \(p(\mathbf{x} \mid \boldsymbol{\ell})\), cioè produrre una delle tante canzoni che quel testo ammette, più spesso quelle più plausibili. Il testo occupa poche centinaia di caratteri, il suono milioni di numeri, e il modello deve scegliere da sé quasi tutto ciò che il testo non fissa. In una canzone, però, il testo va pronunciato parola per parola dentro la musica, mentre per un brano strumentale basta una descrizione da rispettare a grandi linee.
Ti consegnano il foglio con le parole di una canzone e ti chiedono di registrarla in un’unica traccia, voce e band insieme, senza spartito. Il foglio è una pagina, la registrazione sono quattro minuti di suono in cui ogni secondo è pieno di dettagli, e tutto quello che sul foglio manca lo devi mettere tu.
Manca, per cominciare, il tempo. Sul foglio non è scritto in che istante parte ciascun verso né quanto dura: hai solo l’ordine delle parole.
Poi ci sono le parole stesse. «Mare», detto in una frase, dura una frazione di secondo; cantato sulla nota lunga di un ritornello, la sua «a» può durare da sola più di un secondo, mentre la «m» e la «r» restano brevi. Le durate le decide la musica e non la parola, e se leggi il foglio come lo leggeresti ad alta voce ne esce una recita, non una canzone.
Conta anche il modo in cui hai imparato. Tutto quello che sai sul cantare l’hai preso dai dischi, e in un disco la band e la voce stanno sullo stesso nastro: nessuno ti ha mai fatto sentire la voce da sola. Le parole le hai sempre sentite sotto la batteria, le chitarre e i cori, mescolate a suoni che con il testo non hanno niente a che fare.
E c’è il ritornello. Sul foglio sta una volta, o al suo posto c’è soltanto la parola «ritornello», e nella canzone torna tre volte, l’ultima a minuti di distanza dalla prima, sempre riconoscibile. Se ti sfugge, la canzone perde il filo.
Il condizionamento \(\boldsymbol{\ell}\) è molto più piccolo del segnale \(\mathbf{x}\) da produrre, come già nel parlato e nella musica descritta a parole. Il confronto fra i numeri dell’onda e i caratteri del testo misura però le taglie, non l’informazione: gran parte dei \(2 D f_s\) numeri è ridondante, e le rappresentazioni compresse riscrivono gli stessi minuti con molti meno valori. Quello che conta è l’entropia condizionata \(H(\mathbf{x} \mid \boldsymbol{\ell})\), l’incertezza sul suono che resta dopo aver letto il testo, ed è grande: a uno stesso testo corrispondono moltissime canzoni, quindi \(p(\mathbf{x} \mid \boldsymbol{\ell})\) è una distribuzione molto larga. Il canto aggiunge quattro difficoltà, che Jukebox e YuE mettono in luce.
La prima è che \(\boldsymbol{\ell}\) non contiene istanti. Nel text-to-speech il modello stima la durata di ogni fonema a partire dal testo; nel lyrics-to-singing la durata è vincolata dalla musica, che il modello genera insieme alla voce, e il testo non la dice [DJP+20].
La seconda è che il canto altera fonemi, durate e prosodia in modo molto diverso dal parlato, e questo complica l’allineamento fra testo e melodia [YLG+25]. Una sillaba cantata ha l’altezza e la durata della nota che la porta, quindi le durate imparate sul parlato non dicono quanto dura una sillaba cantata.
La terza è che \(\mathbf{x}\) è un mix. Nelle registrazioni non c’è separazione fra voce principale, cori e accompagnamento [DJP+20]. La voce, che è la sola parte a pronunciare \(\boldsymbol{\ell}\), arriva sommata a strumenti e cori, e il modello impara la distribuzione della somma senza mai osservare gli addendi.
La quarta è che la corrispondenza fra \(\boldsymbol{\ell}\) e \(\mathbf{x}\) è a lungo raggio e non è uno a uno. Le parti ripetute compaiono nel testo una volta, o soltanto come rimando («chorus»), e si cantano più volte a minuti di distanza; alcune parti del testo non corrispondono a ciò che si canta [DJP+20]. YuE mette le dipendenze a lungo raggio, su strutture di diversi minuti, fra le difficoltà principali del compito [YLG+25].
Misuriamo la sproporzione su quattro minuti di canzone stereo a 44,1 kHz e sul testo di sei strofe di quattro versi.
# Quattro minuti di canzone stereo contro il testo che la descrive.
D = 240          # durata in secondi
fs = 44100       # frequenza di campionamento (Hz)
canali = 2       # stereo

numeri = D * fs * canali

strofa = """Sulla riva della notte
una luce piccola resta
e il mare ripete piano
il nome che non ti ho detto""".replace("\n", " ")
strofe = 6
caratteri = len(strofa) * strofe


def con_punti(x):
    return f"{x:,}".replace(",", ".")


print("numeri al secondo (stereo):", con_punti(fs * canali))
print("numeri nell'onda di 240 s: ", con_punti(numeri))
print("caratteri di", strofe, "strofe:     ", con_punti(caratteri))
print("numeri per ogni carattere: ", con_punti(numeri // caratteri))

# lo stesso rapporto per un testo corto e per uno lungo
for c in (200, 3000):
    print(f"con {con_punti(c):>5} caratteri:       ", con_punti(numeri // c))
numeri al secondo (stereo): 88.200
numeri nell'onda di 240 s:  21.168.000
caratteri di 6 strofe:      576
numeri per ogni carattere:  36.750
con   200 caratteri:        105.840
con 3.000 caratteri:        7.056
La strofa è inventata, e le sei strofe sono un’ipotesi su quanto sia lungo il testo di una canzone. Con questa ipotesi il testo fa 576 caratteri e l’onda 21.168.000 numeri, cioè 36.750 numeri per ogni carattere. Il rapporto cambia con il testo: con 200 caratteri sale a 105.840, con 3.000 scende a 7.056, quindi per un testo da qualche centinaio a qualche migliaio di caratteri sta fra qualche migliaio e qualche centinaio di migliaia di numeri per carattere. E cambia con il suono: una canzone più corta, o registrata su un canale solo, lo abbassa in proporzione. Il testo, oltre a essere piccolo, non contiene nessun istante: dice in che ordine vengono le sillabe, non quando.
L’allineamento fra testo e tempo#
Scriviamo il testo come la sequenza delle sue sillabe, \(\boldsymbol{\ell} = (\ell_1, \dots, \ell_L)\). Come nel riconoscimento vocale, si chiama allineamento la corrispondenza fra i pezzi del testo e i frame del suono. Qui, dati \(\boldsymbol{\ell}\) e una rappresentazione di \(n\) frame, un allineamento assegna a ogni sillaba il frame in cui comincia, \(\mathbf{a} = (a_1, \dots, a_L)\), con \(a_j \in \{0, \dots, n-1\}\) (i frame si contano da 0) e \(a_1 < a_2 < \dots < a_L\), perché le sillabe si cantano nell’ordine in cui sono scritte. Fig. 34.1 mostra la prima riga della strofa inventata, prima come fila di sillabe e poi distesa sul tempo di una melodia: ogni sillaba comincia su una nota, una vocale tenuta occupa una nota lunga, una pausa strumentale non porta nessuna sillaba. Dove cade ciascuna sillaba è un’informazione che il testo non contiene, e il modello deve procurarsela da qualche parte.
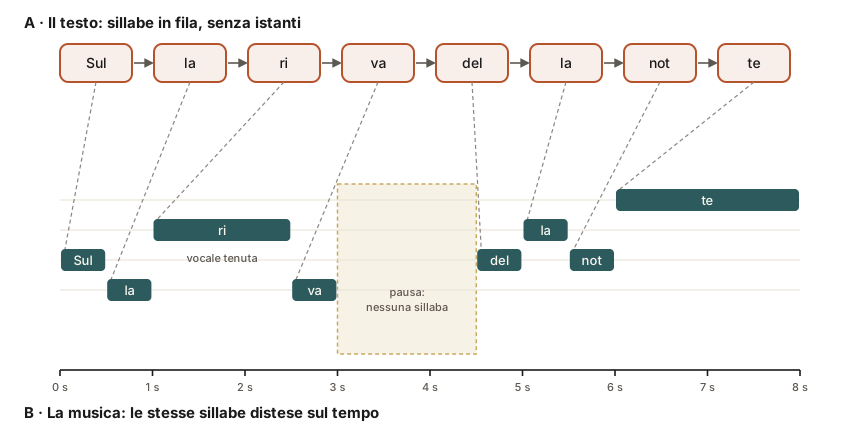
Fig. 34.1 Il testo è una fila di sillabe senza istanti; la musica le distende sull’asse dei secondi, qui una per nota, con vocali tenute e pause in cui nessuna sillaba cade. Ogni linea tratteggiata arriva all’inizio di una nota, l’istante in cui la sillaba comincia.#
Chi prepara i file del karaoke riceve il testo di una canzone come righe di sillabe, in ordine, e deve segnare l’istante in cui ciascuna comincia, perché l’evidenziatore sullo schermo salti da una sillaba alla successiva insieme al cantante. L’ordine non lo può toccare: la quinta sillaba non passa davanti alla quarta.
Quanti allineamenti possibili ha davanti? Con due sillabe e quattro istanti, i modi si contano a mano. Se la prima sillaba parte al primo istante, la seconda può partire al secondo, al terzo o al quarto; se la prima parte al secondo, la seconda al terzo o al quarto; se parte al terzo, la seconda al quarto. Sono sei modi, e crescono in fretta a ogni sillaba e a ogni istante in più. Per una sola riga di otto sillabe in otto secondi, come quella di Fig. 34.1, con cinquanta istanti possibili al secondo, sono circa quindici milioni di miliardi. Per una canzone intera di quattro minuti e duecentodieci sillabe il numero ha quattrocentocinquantotto cifre.
E il conto è basso, perché segna solo dove ogni sillaba comincia. Quanto dura ciascuna, anche quando si allunga su più note di fila, e se dopo c’è un secondo e mezzo in cui la band suona da sola, sono altre scelte, che moltiplicano ancora le possibilità.
Nessun allineamento è scritto sul foglio. Chi prepara il karaoke trova quello giusto ascoltando la registrazione. Un programma che deve inventare la canzone non ha niente da ascoltare, e l’allineamento lo deve scegliere da sé, insieme alla musica che lo rende giusto.
Se invece arriva un file con gli istanti già segnati, di allineamento ne resta uno solo e il lavoro diventa copiatura. È quello che fa uno spartito, che dice quando parte ogni nota. Se il file segna soltanto dove comincia ogni riga, le possibilità calano molto, ma dentro ogni riga resta da decidere.
Il conto, però, vale finché ogni sillaba scritta si canta una volta. Il ritornello sta sul foglio una volta e il cantante lo ripete tre volte, quindi le sillabe da disporre sono quelle cantate, più numerose di quelle scritte, e quante volte il ritornello torni, e dove, il foglio non lo dice. E vale per una voce sola: in un duetto le sillabe dei due cantanti possono partire nello stesso istante, e nel file del karaoke ciascun cantante ha i suoi istanti, da segnare per conto suo.
Le sequenze \(a_1 < \dots < a_L\) sono i sottoinsiemi di \(L\) frame scelti fra \(n\), quindi il loro numero è
Per \(L = 2\) sillabe in \(n = 4\) frame sono \(\binom{4}{2} = 6\). Il conteggio considera solo gli istanti d’inizio, e aggiungendo la durata di ogni sillaba e le pause le possibilità crescono ancora. Lo stesso allineamento si scrive anche al contrario, come la funzione non decrescente che a ogni frame assegna l’indice dell’ultima sillaba cominciata, zero prima della prima; gli \(a_j\) sono i frame in cui quella funzione sale di uno.
Quando l’allineamento non viene dato, diventa una variabile nascosta,
dove \(p(\mathbf{a} \mid \boldsymbol{\ell})\) dice quali allineamenti sono plausibili per quel testo, \(p(\mathbf{x} \mid \boldsymbol{\ell}, \mathbf{a})\) quale suono ne realizza uno, e la somma corre sui \(\binom{n}{L}\) allineamenti ammessi. Questa scrittura non viene dagli articoli citati: la usiamo per dare un nome all’incognita. Ha la struttura della CTC del riconoscimento vocale, che somma sugli allineamenti fra frame e lettere, con i ruoli di testo e suono scambiati; non descrive l’algoritmo di nessuno dei sistemi del capitolo.
Quando \(\mathbf{a}\) viene dato da fuori, come dalla partitura di un cantante sintetico, \(p(\mathbf{a} \mid \boldsymbol{\ell})\) si concentra su un solo valore e la somma ha un termine solo. Quando ne viene data una parte, come gli istanti d’inizio delle frasi, la somma resta, ristretta agli allineamenti in cui la prima sillaba di ogni frase cade nel frame indicato.
Il modello vale finché ogni sillaba scritta è cantata una volta sola. Con i ritornelli e le ripetizioni \(\mathbf{a}\) va definito sulle sillabe cantate, non su quelle scritte, e la sequenza cantata è un’espansione di \(\boldsymbol{\ell}\) che il testo non fornisce, ed è anch’essa un’incognita.
Vale inoltre per una voce sola. In un duetto, o in un coro che canta parole diverse da quelle della voce principale, due sillabe possono cominciare nello stesso frame, e una sola sequenza strettamente crescente non basta più: serve un allineamento per ciascuna voce. Il melisma, una sillaba distesa su più note, rientra invece nel modello, perché \(\mathbf{a}\) segna soltanto il frame in cui la sillaba comincia; quante note occupi dopo è una delle scelte di durata che il conteggio lascia fuori.
Contiamo gli allineamenti sulla strofa inventata, con i frame di un codec a cinquanta al secondo, la frequenza di quello di MusicGen. Le ipotesi sono tre: le strofe sono sei, ogni sillaba scritta si canta una volta, e le sillabe si contano una per una, senza fondere la vocale finale di una parola con quella iniziale della successiva (la sinalefe del verso italiano).
from itertools import combinations
from math import comb

# Le sillabe di una strofa, contate senza sinalefe.
strofa = ("Sul la ri va del la not te u na lu ce pic co la re sta "
          "e il ma re ri pe te pia no il no me che non ti ho det to")
sillabe = strofa.split()
strofe = 6
L = len(sillabe) * strofe     # sillabe dell'intera canzone

r = 50                        # frame al secondo
D = 240                       # secondi
n = r * D                     # frame della canzone


def con_punti(x):
    return f"{x:,}".replace(",", ".")


# il caso più piccolo: 2 sillabe in 4 istanti, contati da 0
coppie = list(combinations(range(4), 2))
print("modi di porre 2 sillabe in 4 istanti:", len(coppie))
print(coppie)

# la prima riga: otto sillabe distese su otto secondi
riga = sillabe[:8]
modi_riga = comb(r * 8, len(riga))
print("sillabe per strofa:", len(sillabe))
print("prima riga:", " ".join(riga))
print("modi di porre 8 sillabe in 8 s:", con_punti(modi_riga))

# la canzone intera: L istanti d'inizio crescenti fra n frame
modi = comb(n, L)
print("sillabe della canzone:", L, " frame:", con_punti(n))
print("cifre del numero di allineamenti:", len(str(modi)))
modi di porre 2 sillabe in 4 istanti: 6
[(0, 1), (0, 2), (0, 3), (1, 2), (1, 3), (2, 3)]
sillabe per strofa: 35
prima riga: Sul la ri va del la not te
modi di porre 8 sillabe in 8 s: 15.148.408.086.508.950
sillabe della canzone: 210  frame: 12.000
cifre del numero di allineamenti: 458
Con quattro istanti le due sillabe si dispongono in sei modi, tutti elencati. Con 400 frame a disposizione, la prima riga ha 15.148.408.086.508.950 allineamenti; la canzone da 210 sillabe in 12.000 frame ne ha un numero di 458 cifre. Il conteggio tiene solo gli istanti d’inizio, quindi sottostima il problema, ma basta a mostrare che l’allineamento non si indovina per tentativi.
Cinque risposte alla stessa domanda#
La prima risposta è la partitura, dove chi compone scrive l’allineamento insieme alle note: ogni nota dice quando comincia e quanto dura. Nella sintesi del canto da uno spartito, testo, altezza e durata di ogni nota sono dati in ingresso [LLR+22], e Vocaloid 2 fa cadere l’attacco della vocale di ogni sillaba sull’istante in cui la nota comincia [KO07]. La racconta la voce che canta.
La seconda è un’attenzione che impara dove guardare. L’attenzione è il meccanismo con cui una rete, a ogni passo, decide su quali parti dell’ingresso appoggiarsi. Qui l’ingresso è il testo, e ascoltando moltissime canzoni insieme alle loro parole il modello impara da solo a quale punto del testo corrisponde il suono che sta producendo.
Jukebox lo fa su pezzi di canzone di circa 24 secondi, ciascuno con il suo pezzo di testo, e in uno dei suoi strati i punti del testo su cui il modello si appoggia seguono le parole cantate [DJP+20]. ACE-Step v1 lo fa sull’intera canzone, senza ricevere nessun istante [GZW+25]. Raccontano le due strade la canzone a token e tutta la canzone insieme.
La terza è la struttura scritta sezione per sezione. In YuE un testo dato tutto all’inizio perde presa man mano che la canzone si allunga: secondo gli autori il modello comincia a seguirlo peggio dopo una trentina di secondi di canzone, e oltre il minuto lo perde del tutto. Per questo YuE scrive davanti a ogni sezione della canzone (strofa, ritornello, ponte) il suo nome e le sue parole, così che l’allineamento resti da trovare soltanto dentro la sezione, con il testo che serve sempre vicino [YLG+25].
La quarta è l’utente, frase per frase. Gli autori di DiffRhythm, dando al modello il testo senza istanti, non ottengono un canto comprensibile, né con un’attenzione né affiancando il testo direttamente al suono. Il loro modello chiede quindi in che istante comincia ogni frase, e da quell’istante i fonemi della frase vengono messi in fila, uno per frame [NCJ+25].
La quinta è un progetto scritto prima del suono. In ACE-Step 1.5 un modello di linguaggio scrive in anticipo i dati del brano (battiti al minuto, tonalità, durata, struttura) e poi uno schizzo della canzone, cinque simboli al secondo; da quello schizzo un modello di diffusione produce il suono. In addestramento, inoltre, il modello di diffusione viene premiato quando la sua attenzione scorre il testo sempre in avanti e senza saltarne pezzi [GSZ+26]. Ne parla prima il progetto.
Da ricordare
Con Vocaloid 2, il motore del 2007, Hatsune Miku canta cucendo frammenti registrati da una cantante vera, senza reti neurali e senza niente imparato da esempi: la melodia e la durata di ogni sillaba le scrive chi usa il programma.
Una canzone chiede più di un brano strumentale: una voce che pronuncia parole date, un accompagnamento mescolato alla voce e una forma che regge per minuti. Il testo che la descrive è un foglio, il suono sono milioni di numeri.
Il foglio non dice quando cade ciascuna sillaba, e gli allineamenti possibili sono moltissimi. Ogni sistema si procura quello giusto a modo suo: dalla partitura, da un’attenzione che lo impara, dalla struttura scritta sezione per sezione, dall’utente che segna l’inizio di ogni frase, da un progetto scritto prima del suono.
Il conto vale se ogni sillaba scritta si canta una volta e se canta una voce sola; il ritornello, scritto una volta e cantato più volte, allunga la fila delle sillabe, e quante volte torni il foglio non lo dice.
Da ricordare
Vocaloid 2, il motore del 2007, sintetizza per concatenazione di frammenti registrati (per lo più difoni), senza apprendimento: i frammenti scelti sono portati all’altezza richiesta e cuciti con il timbro smussato alle giunzioni [KO07].
Generare una canzone è estrarre da \(p(\mathbf{x} \mid \boldsymbol{\ell})\), con \(2 D f_s\) numeri nell’onda e \(n = rD\) frame in una rappresentazione compressa. Rispetto al parlato il canto aggiunge istanti assenti da \(\boldsymbol{\ell}\), fonemi e durate alterati, un mix non separato e una corrispondenza a lungo raggio e non uno a uno.
L’allineamento è \(\mathbf{a} = (a_1, \dots, a_L)\) con \(a_1 < \dots < a_L\): \(\binom{n}{L}\) possibilità sui soli istanti d’inizio, 458 cifre con \(n = 12\,000\) e \(L = 210\). Senza partitura è una variabile nascosta su cui \(p(\mathbf{x} \mid \boldsymbol{\ell})\) somma; la partitura riduce la somma a un termine, gli inizi delle frasi la restringono.
Le cinque risposte sono la partitura (Vocaloid 2, DiffSinger), l’attenzione che impara (Jukebox, ACE-Step v1), la struttura per sezioni (YuE), gli inizi delle frasi dati dall’utente (DiffRhythm) e il pianificatore di ACE-Step 1.5.
Il modello vale per sillabe cantate una volta sola e per una voce sola; con ritornelli e ripetizioni \(\mathbf{a}\) si definisce sulle sillabe cantate, e la sequenza cantata è un’altra incognita; voci sovrapposte chiedono un allineamento per voce.
La risposta più semplice è la partitura, perché lì l’allineamento è dato e resta da produrre soltanto la voce. Da qui parte la voce che canta: che cosa cambia nella sintesi quando la voce deve intonare e non solo parlare, e come si passa dal frammento cucito a una rete che produce lo spettrogramma, la fotografia del suono con il tempo in orizzontale e le altezze in verticale, da cui poi si ricava l’onda.