


Tutta la canzone insieme: la diffusione su un latente#
Nella sezione sulla canzone come linguaggio una canzone si scrive come una frase, un token dopo l’altro (un token è uno dei segni con cui un codec scrive il suono), e ogni token aspetta quello che lo precede. Così lavora YuE [YLG+25], che tiene il testo agganciato alla musica mettendo davanti a ogni sezione della canzone i suoi versi. Il prezzo è la fila: per tre minuti di musica i passi in fila sono migliaia.
La diffusione prende la strada opposta. La canzone intera è un solo blocco di numeri, il latente \(\mathbf{x}\), cioè una versione compressa del suono che un autoencoder sa riportare a suono. Il latente comincia come rumore, e a ogni passo una rete che vede nello stesso momento l’inizio e la fine lo rifà da capo in tutta la sua lunghezza. Il numero di passi non cresce con la durata, perché lo stabilisce il campionatore, la procedura che porta il rumore alla canzone un passo dopo l’altro: DiffRhythm ne usa 32 [NCJ+25], ACE-Step v1 27 o 60 nelle due impostazioni documentate dagli autori [GZW+25].
# Quanti passi in fila servono per tre minuti di canzone.
D = 180            # durata in secondi

# strada a token: un passo per token, in fila
yue = D * 50 * 2           # YuE: primo codebook a 50 Hz, due token per frame
n, q = D * 50, 4           # MusicGen: frame a 50 Hz, q livelli del codec
musicgen = n + q - 1       # schema a ritardo: n + q - 1 passi

# diffusione: ogni passo rifa tutta la canzone
passi = {"DiffRhythm": 32, "ACE-Step v1, 27 passi": 27, "ACE-Step v1, 60 passi": 60}

print(f"YuE, voce e accompagnamento   {yue:>6} passi in fila")
print(f"MusicGen, schema a ritardo    {musicgen:>6} passi in fila")
for nome, p in passi.items():
    print(f"{nome:<29} {p:>6} passi, ciascuno su tutta la canzone")
YuE, voce e accompagnamento    18000 passi in fila
MusicGen, schema a ritardo      9003 passi in fila
DiffRhythm                        32 passi, ciascuno su tutta la canzone
ACE-Step v1, 27 passi             27 passi, ciascuno su tutta la canzone
ACE-Step v1, 60 passi             60 passi, ciascuno su tutta la canzone
Il confronto riguarda i passi in fila, non il lavoro: un passo di diffusione tratta tutti i token insieme, e richiede molto più calcolo di un passo della fila a token, che riusa quanto già calcolato per i token precedenti (la KV cache). Cambia la forma dell’attesa. Nella fila a token la canzone nasce da sinistra a destra, e ogni pezzo è nitido e definitivo appena scritto. Nella diffusione l’intera canzone esiste fin dal primo passo come una macchia sfocata, e a ogni passo diventa più nitida su tutta la sua lunghezza. La Fig. 34.4 mette le due attese una sopra l’altra, sullo stesso orologio.
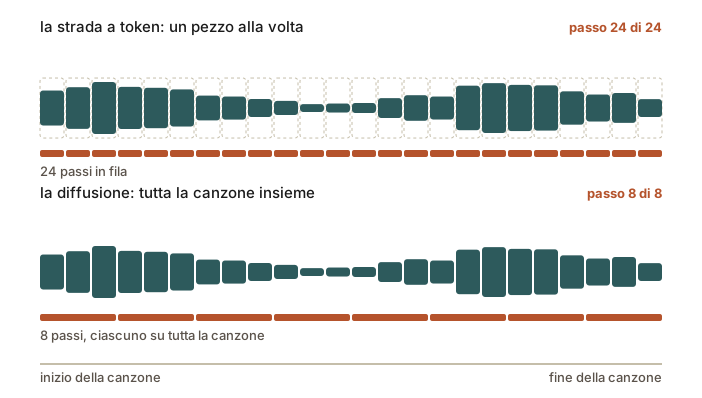
Fig. 34.4 Sullo stesso asse del tempo della canzone, la strada a token la scrive un pezzo alla volta, un passo per pezzo, mentre la diffusione la tiene intera fin dal primo passo e la rende nitida dappertutto insieme (ventiquattro pezzi e otto passi sono numeri scelti per il disegno).#
Resta da stabilire dove cade ciascuna sillaba. In un latente rifatto tutto insieme non c’è una fila che lo ricordi, e DiffRhythm e ACE-Step v1 rispondono in modo diverso: DiffRhythm lo chiede all’utente, frase per frase, mentre ACE-Step v1 lo fa imparare alla rete con una cross-attention, sostenuta durante l’addestramento da un allineamento delle rappresentazioni.
Il latente: comprimere la canzone e poi rifarla#
ACE-Step v1 [GZW+25] è un modello di diffusione che lavora su una versione compressa del mel-spettrogramma. Le condizioni arrivano da tre encoder, reti che trasformano ciascuna il proprio ingresso in una sequenza di vettori: uno per la descrizione dello stile (tag separati da virgole, come «pop, voce femminile», o una didascalia in prosa), uno per il testo della canzone e uno per una voce di riferimento. Le tre sequenze si concatenano nel tempo, e il transformer di diffusione (DiT) le legge in cross-attention, un’attenzione in cui il latente pone le domande e le condizioni danno le risposte (Fig. 34.5).
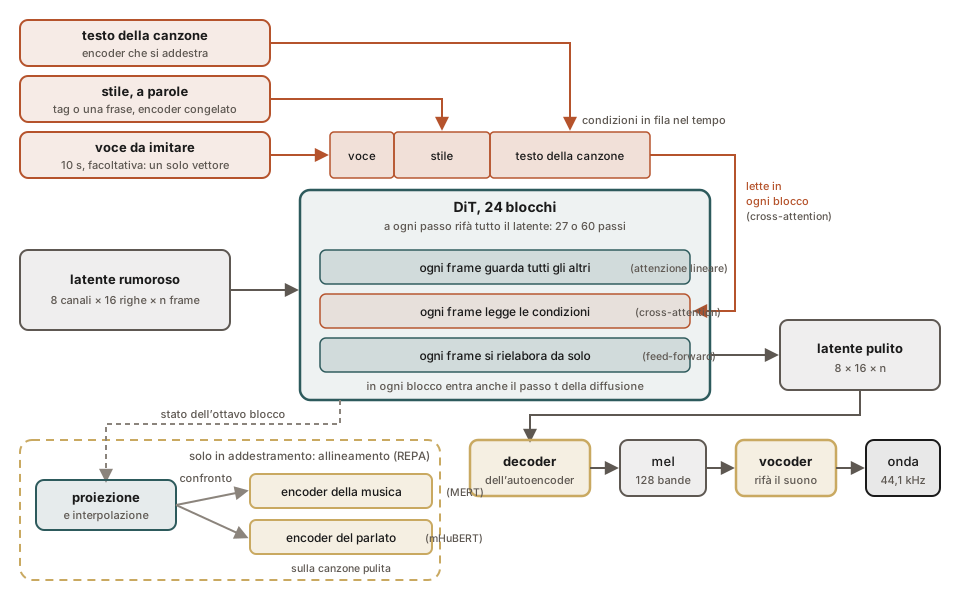
Fig. 34.5 ACE-Step v1: tre encoder in fila nel tempo, il DiT che rifà il latente a ogni passo, il decoder del Music-DCAE e il vocoder. In tratteggio l’allineamento con MERT e mHuBERT, che esiste solo in addestramento.#
Una canzone di \(D\) secondi a \(f_s = 44{,}1\) kHz in stereo sono \(2 f_s D\) numeri, ventuno milioni per quattro minuti, che il DiT non vede mai. ACE-Step li riduce in due tempi. Calcola il mel-spettrogramma di ciascun canale, con 128 bande e un frame (una colonna del mel, cioè un istante) ogni 512 campioni, e lo comprime con un autoencoder, la strozzatura che comprime e ricostruisce. Gli autori lo chiamano Music-DCAE: è il DC-AE (Deep Compression AutoEncoder), un autoencoder a forte compressione nato per le immagini, adattato alla musica. Al ritorno il decoder dell’autoencoder rifà il mel, e un vocoder lo riporta a onda. DiffRhythm salta il mel: comprime direttamente l’onda con l’autoencoder variazionale (VAE) di Stable Audio 2, che è monodimensionale, cioè lavora lungo il solo asse del tempo [EPC+24, NCJ+25].
# Dai numeri dell'onda ai numeri che il DiT vede, per quattro minuti.
D, fs = 240, 44100

onda = 2 * fs * D                  # stereo
mel_fps = fs / 512                 # frame del mel al secondo (hop 512)
mel = 2 * 128 * mel_fps * D        # due canali, 128 bande

lat_fps = fs / 512 / 8             # ACE-Step v1: tempo / 8
v1 = 8 * 16 * lat_fps * D          # 8 canali, 128 bande / 8 = 16 righe
dr_fps = fs / 2048                 # DiffRhythm: fattore 2048 nel tempo
dr = 64 * dr_fps * D               # 64 canali

print(f"onda stereo a 44100 Hz   {onda:>9.0f} numeri")
print(f"mel, due canali          {mel:>9.0f}   {onda/mel:.0f}x meno dell'onda")
print(f"latente ACE-Step v1      {v1:>9.0f}   {onda/v1:.0f}x meno dell'onda, {mel/v1:.0f}x meno del mel")
print(f"latente DiffRhythm       {dr:>9.0f}   {onda/dr:.0f}x meno dell'onda")
print(f"frame del latente v1     {lat_fps*D:>9.0f}   uno ogni {1000/lat_fps:.1f} ms")
print(f"frame del latente DiffR. {dr_fps*D:>9.0f}   uno ogni {1000/dr_fps:.1f} ms")
onda stereo a 44100 Hz    21168000 numeri
mel, due canali            5292000   4x meno dell'onda
latente ACE-Step v1         330750   64x meno dell'onda, 16x meno del mel
latente DiffRhythm          330750   64x meno dell'onda
frame del latente v1          2584   uno ogni 92.9 ms
frame del latente DiffR.      5168   uno ogni 46.4 ms
Due strade diverse, un mel compresso otto volte su due assi e un’onda compressa 2048 volte nel tempo, arrivano allo stesso numero di valori: 330.750 per quattro minuti. Il DiT di ACE-Step legge il latente come 2584 token, uno per frame.
La canzone di quattro minuti si può guardare come una fotografia del suono, il mel: il tempo corre in orizzontale e, in verticale, si legge quanto forte suona ogni altezza, dalle più gravi alle più acute. Una canzone stereo ne ha due, una per orecchio, lunghissime, e già così contengono quattro volte meno numeri della registrazione. La diffusione, però, parte da una nebbia e la toglie un poco alla volta, e il restauratore che la toglie, la rete chiamata DiT, dovrebbe ripassare le due fotografie quadratino per quadratino, decine di volte di fila. Prima vanno rimpicciolite e messe in una busta, che è il latente.
Rimpicciolire fa perdere qualcosa, e quanto si potesse perdere l’hanno deciso le prove. Gli autori hanno cominciato riducendo la fotografia di trentadue volte per lato, e la canzone che ne tornava era troppo rovinata per servire. Con otto volte per lato la fotografia si legge ancora. Ogni quadratino della copia riassume un blocco di otto per otto quadratini dell’originale e ci scrive otto numeri: le due fotografie, in quel blocco, ne avevano centoventotto. Nella busta finisce così una canzone sessantaquattro volte più leggera della registrazione: quattro volte per il passaggio alla fotografia, sedici per la busta.
Chi apre la busta, il decoder, deve rifare le fotografie a grandezza naturale. Ha imparato in due tempi: prima copiando e basta, poi sotto gli occhi di tre critici severi, ciascuno con il compito di scoprire se la copia è un falso, mentre chi chiude le buste, l’encoder, non cambiava più il suo modo di farlo. Resta l’ultimo passaggio, dalla fotografia al suono vero, e lo fa il vocoder, preso a prestito da un altro progetto: un lettore universale di fotografie del suono, che legge quella di un orecchio e poi quella dell’altro.
C’è anche un’altra strada, e l’ha scelta DiffRhythm: saltare la fotografia e rimpicciolire direttamente la registrazione. Per quattro minuti la sua busta contiene esattamente tanti numeri quanti quella di ACE-Step. Quale delle due convenga non è deciso. Gli autori di ACE-Step raccontano che, nelle loro prove, la strada diretta lasciava disturbi acuti nelle voci generate, forse per come l’avevano innestata nel loro addestramento, e ammettono che le loro buste non si riaprono meglio di quelle dirette. Quello che la fotografia non porta, il suono rifatto può soltanto indovinarlo, e infatti la qualità della fotografia e quella del vocoder compaiono fra i limiti che gli autori dichiarano.
Nella configurazione pubblicata il mel ha 128 bande fra 40 Hz e 16 kHz, finestra di 2048 campioni e spostamento (hop) di 512, e si calcola per ciascuno dei due canali. Il Music-DCAE segue l’architettura di DC-AE [CCC+25]: è un autoencoder a due dimensioni che riduce di 8 sia il tempo sia la frequenza (la configurazione chiamata f8c8, con 8 canali), da un mel \(2 \times 128 \times n_{\text{mel}}\), con \(n_{\text{mel}} = f_s D / 512\) frame, a un latente \(\mathbf{x} \in \mathbb{R}^{8 \times 16 \times n}\), con \(n = rD\) e \(r = f_s / (512 \cdot 8) \approx 10{,}77\) Hz. Lo stadio più profondo di encoder e decoder è un blocco con attenzione lineare [CLH+23].
La scala è una scelta dichiarata: una prima configurazione con compressione 32 su entrambi gli assi (f32c32, 32 canali) dava una degradazione della qualità giudicata inaccettabile, e si è ripiegato su 8. L’addestramento ha due fasi: solo errore quadratico sul mel, poi encoder congelato e decoder con errore quadratico più una perdita avversaria, con tre discriminatori. Il mel ricostruito passa al vocoder universale per la musica di Fish Audio [LWL+24], che il codice applica ai due canali uno alla volta; il report, fra i limiti, parla di un vocoder monofonico a 32 kHz, mentre la configurazione pubblicata è a 44,1 kHz.
DiffRhythm ha un VAE sull’onda: \(\mathbf{x} \in \mathbb{R}^{64 \times n}\) con fattore 2048 nel tempo, quindi \(r = f_s/2048 \approx 21{,}5\) Hz. Il decoder è riaddestrato con ingressi compressi in MP3 con probabilità \(2/3\) e il file senza perdita come bersaglio. Il rapporto fra l’onda stereo e il latente è lo stesso per le due strade,
e per ACE-Step si scompone in 4 dal passaggio al mel e 16 dall’autoencoder.
Il confronto fra le due rappresentazioni non è a favore del mel in ricostruzione: il report ammette che il Music-DCAE non supera il limite di ricostruzione dei VAE monodimensionali (Tabella 1). La scelta non si regge su una misura, ma su un’osservazione degli autori: con varianti monodimensionali simili a quelle di Stable Audio e di DiffRhythm le voci generate avevano artefatti persistenti ad alta frequenza, che gli autori stessi attribuiscono forse a un’integrazione poco riuscita con la loro ricetta di addestramento. La qualità dell’audio è limitata da due scelte a monte, il mel e il vocoder, ed è il primo dei limiti che il report dichiara.
Attenzione lineare sul tempo, testo per cross-attention#
A ogni passo ogni frame del latente deve tenere conto di tutti gli altri, perché l’attacco del ritornello dipende da come è finita la strofa, e deve leggere il testo. ACE-Step v1 fa le due cose in due modi diversi. Fra i frame usa un’attenzione lineare, che invece di confrontare i frame a due a due li riassume in una tabella di grandezza fissa, e il cui costo cresce quindi con la durata della canzone e non con il suo quadrato. Verso le condizioni usa la cross-attention ordinaria, con la softmax. Il blocco del DiT viene da Sana [XCC+24], un transformer di diffusione nato per le immagini ad alta risoluzione.
DiffRhythm ha un DiT più piccolo (sedici strati di larghezza 2048 con trentadue teste, per 1,1 miliardi di parametri) e non usa la cross-attention [NCJ+25]. Lo stile e il passo temporale, sommati in un unico vettore globale, si concatenano lungo i canali con i fonemi del testo e con il latente rumoroso, e il DiT legge tutto come un solo ingresso. Gli autori dichiarano che con la cross-attention, o con la concatenazione diretta dei sistemi di sintesi vocale che citano (il testo intero in testa, allungato con simboli di riempimento fino alla lunghezza del latente, senza nessun istante), non hanno ottenuto un canto intelligibile.
Il rimedio tiene la stessa concatenazione lungo i canali e cambia soltanto il posto dei fonemi, che scrive nel tempo. Si annota l’istante d’inizio \(\tau_g\) (in secondi) di ogni frase \(g\), e i fonemi \(\mathbf{p}_g\) della frase, \(L_g\) in tutto, si scrivono in una sequenza \(\tilde{\boldsymbol{\ell}}\) lunga quanto il latente:
dove \(\nu_g\) è il frame in cui la frase comincia (i frame si contano da 0), \(r\) la frequenza dei frame del latente, e \(\tilde{\boldsymbol{\ell}}[\nu_g : \nu_g + L_g]\) indica gli \(L_g\) posti a partire da \(\nu_g\); tutti gli altri posti contengono un simbolo di riempimento. La sequenza \(\tilde{\boldsymbol{\ell}}\) è il testo della canzone disteso sui frame. Una frase di venti fonemi occupa venti frame, circa un secondo, a partire dal suo inizio, e il resto fino alla frase successiva è riempimento: la durata dei singoli fonemi non è scritta da nessuna parte. In uso servono quindi i tempi d’inizio delle frasi, come in un testo sincronizzato per il karaoke. Senza questo allineamento l’intelligibilità crolla e peggiora anche la qualità del suono, mentre la struttura musicale di base resta (Tabella 2). Che cosa succeda quando una frase ha più fonemi dei frame che mancano all’inizio della successiva la formula non lo dice; nel codice pubblicato la frase dopo slitta in avanti fino alla fine di quella prima.
ACE-Step v1 non riceve i tempi delle frasi: la cross-attention di ogni blocco consulta tutta la fila delle condizioni, e dove cada ciascuna sillaba lo deve scoprire la rete.
# Costo dell'attenzione in un blocco del DiT: moltiplicazioni-somme per testa.
n, dk = 2584, 128                  # frame del latente (4 minuti), larghezza di una testa

softmax = 2 * n * n * dk           # QK^T poi A V: n x n punteggi
lineare = 2 * n * dk * dk          # stato S = somma v phi(k)^T, poi lettura
print(f"coppie di istanti (n x n)   {n*n:>11}")
print(f"auto-attenzione softmax     {softmax:>11}")
print(f"auto-attenzione lineare     {lineare:>11}   rapporto n/dk = {n/dk:.1f}")

# la cross-attention resta softmax: n istanti guardano nc token di condizione
for nc in (64, 512, 1 + 256 + 4096):   # l'ultimo e' il tetto: parlante, tag, testo
    cross = 2 * n * nc * dk
    print(f"cross-attention, nc = {nc:>4} {cross:>11}   {cross/softmax:.2f} volte la softmax su n")
coppie di istanti (n x n)       6677056
auto-attenzione softmax      1709326336
auto-attenzione lineare        84672512   rapporto n/dk = 20.2
cross-attention, nc =   64    42336256   0.02 volte la softmax su n
cross-attention, nc =  512   338690048   0.20 volte la softmax su n
cross-attention, nc = 4353  2879526912   1.68 volte la softmax su n
A ogni passo il restauratore ripulisce tutta la canzone insieme, e dentro di sé lavora come un’orchestra di quasi duemilaseicento musicisti, uno per ogni istante della canzone, cioè uno ogni decimo di secondo (tanti ne servono per quattro minuti, la canzone più lunga su cui l’orchestra ha provato). Prima di suonare ciascuno ascolta gli altri, perché l’attacco del ritornello deve sapere come è finita la strofa: questo ascolto si chiama attenzione. Se ognuno ascoltasse uno per uno tutti i colleghi, in sala si farebbero quasi sette milioni di ascolti, e con una canzone lunga il doppio sarebbero quattro volte tanti.
Il DiT evita le coppie con una lavagna. Ogni musicista porta due cartellini, uno da oratore e uno d’ascolto, scritti con numeri mai negativi: quelli che lo sarebbero diventano zero. Con due musicisti e cartellini di due numeri il gesto si vede per intero. Il contributo di Anna, quello che ha da far sentire, è un 10, e il suo cartellino da oratore dice 3 e 0; il contributo di Bruno è un 20, e il suo cartellino dice 1 e 2. La lavagna ha una colonna per ciascun numero dei cartellini. Anna scrive il suo 10 moltiplicato per 3 nella prima colonna e per 0 nella seconda, Bruno il suo 20 moltiplicato per 1 nella prima e per 2 nella seconda, e ogni colonna somma quello che riceve: 50 nella prima, 40 nella seconda. Su un secondo foglio si sommano i soli cartellini da oratore, 4 e 2.
Chi ascolta legge con il proprio cartellino d’ascolto, allo stesso modo. Con 1 e 0 guarda soltanto la prima colonna: trova 50 sulla lavagna e 4 sul foglio, e 50 diviso 4 fa 12,5, la media fra 10 e 20 in cui Anna conta tre volte Bruno. Con 0 e 1 guarda la seconda: 40 diviso 2 fa 20, e sente soltanto Bruno; con 1 e 1 li sente alla pari, e trova 15. Il cartellino d’ascolto decide quanto pesa ciascun collega senza che nessuno abbia ascoltato nessuno a coppie, e il risultato è sempre una media: per questo i cartellini non possono avere numeri negativi, perché in una media ogni voce conta con un peso positivo o nullo. Nella sala vera ciascuno ha da far sentire centoventotto numeri e i cartellini ne hanno centoventotto, quindi la lavagna ha centoventotto righe per centoventotto colonne, ma il gesto è lo stesso. Questa lavagna è l’attenzione lineare.
Ogni scrittura e ogni lettura costano più di un ascolto, perché toccano tutta la lavagna, ma se ne fanno tante quanti sono i musicisti, non quante le loro coppie: con quasi duemilaseicento musicisti il lavoro diventa una ventina di volte più piccolo. La lavagna, però, resta della stessa grandezza qualunque sia la durata della canzone: quello che vi si accumula si impasta, e con meno di centoventotto musicisti il guadagno sparisce.
Le parole non stanno in sala. Sul leggio ci sono tre fogli attaccati in fila: un foglietto con l’impronta della voce da imitare, se c’è, le indicazioni di stile e il testo cantato. Qui nessuno si accontenta di una lavagna: ogni musicista legge il leggio riga per riga e sceglie quanto dare retta a ciascuna, ed è questa lettura che si chiama cross-attention. Finché il leggio è più corto della sala costa meno dell’ascolto a coppie che la lavagna ha sostituito; con un testo lunghissimo, invece, può costare di più.
Il blocco riprende il Linear DiT di Sana [XCC+24], e il tempo \(t\) della diffusione entra modulando la normalizzazione con l’adaLN-single di PixArt-\(\alpha\) [CYG+23]. A differenza di adaLN-zero, che calcola la modulazione in ogni blocco, l’adaLN-single la calcola una volta per tutti, e ogni blocco vi somma soltanto una piccola tabella di parametri propria; il report la presenta come una modifica a Sana, ma il blocco di Sana, nel codice pubblicato, la usa già. Rispetto a Sana cambiano due cose. La rete feed-forward usa convoluzioni monodimensionali invece che bidimensionali, perché dopo il patchify il latente è una sequenza nel tempo; e la posizione entra con la RoPE, mentre Sana, alla risoluzione di base, fa a meno di ogni codifica di posizione. Le dimensioni sono 24 blocchi, larghezza 2560, venti teste di larghezza \(d_k = 128\), e una patch di \(16 \times 1\): ogni token prende tutte le sedici righe di frequenza di un frame, quindi c’è un token per frame.
Il report fissa a 2584 frame, cioè a quattro minuti, la lunghezza massima delle sequenze di latente in addestramento (Tabella 4). La RoPE è configurata fino a 32.768 posizioni e il codice accetta in generazione anche durate maggiori (soltanto l’extend, la funzione che allunga una canzone, lavora su una finestra di al più 240 secondi), ma oltre i quattro minuti la rete lavora su sequenze più lunghe di tutte quelle viste in addestramento. La model card avverte che oltre i cinque minuti la coerenza della struttura può perdersi, senza dire come abbia fissato la soglia.
L’auto-attenzione di ogni blocco è senza maschera, perché il latente si guarda tutto insieme, ed è lineare. Con la mappa di caratteristiche \(\phi(\mathbf{x}) = \max(0, \mathbf{x})\), la ReLU di Sana (nel trucco del kernel compare \(\operatorname{elu} + 1\)), applicata a query e chiavi dopo la rotazione della RoPE, l’uscita della testa nell’istante \(i\) è
dove \(\mathbf{q}_i, \mathbf{k}_j \in \mathbb{R}^{d_k}\) sono la query e la chiave, già ruotate dalla RoPE, \(\mathbf{v}_j \in \mathbb{R}^{d_k}\) il valore, e gli istanti \(i\) e \(j\) sono frame del latente, contati da 0. Poiché non c’è maschera, \(\mathbf{S}\) e \(\mathbf{z}\) si calcolano una volta per testa e li leggono tutti gli istanti. Il costo scende da \(O(n^2 d_k)\) a \(O(n\, d_k^2)\) e conviene se \(n > d_k\): qui \(n/d_k \approx 20\). Con la ReLU i pesi \(\phi(\mathbf{q}_i)^\top \phi(\mathbf{k}_j)\) non sono mai negativi, e l’uscita è una media pesata dei valori. Il denominatore però si annulla quando le componenti positive di \(\phi(\mathbf{q}_i)\) cadono tutte dove \(\mathbf{z}\) è nullo, per esempio quando la query non ha componenti positive, e il codice gli somma una costante di \(10^{-15}\). Lo stato ha taglia \(d_k \times d_k\) per testa qualunque sia \(n\): è il limite dell’accumulo.
La ReLU agisce dopo la rotazione, e con la rotazione non commuta. Se \(\mathbf{q}\) e \(\mathbf{k}\) sono la query e la chiave prima della RoPE e \(\mathbf{R}_i\) la rotazione della posizione \(i\), il peso \(\phi(\mathbf{R}_i\mathbf{q})^\top \phi(\mathbf{R}_j\mathbf{k})\) non si riduce a \(\mathbf{q}^\top \mathbf{R}_{j-i}\,\mathbf{k}\) e dipende dalle due posizioni separatamente. La proprietà per cui la RoPE fa vedere all’attenzione soltanto la distanza vale per il prodotto scalare delle due rotazioni, e qui cade; la posizione arriva comunque ai pesi. Due token bastano a verificare tutte e due le cose: che la lettura di \(\mathbf{S}\) e \(\mathbf{z}\) dia la media pesata delle coppie, e che con la ReLU dopo la rotazione il peso cambi con la posizione a distanza fissa.
import numpy as np

# 1) Due token, chiavi e query di due numeri gia' passate dalla ReLU.
v = np.array([10.0, 20.0])                    # i valori dei due token
phi_k = np.array([[3.0, 0.0], [1.0, 2.0]])    # phi(k_0), phi(k_1)
S = v @ phi_k                                 # stato: somma di v_j phi(k_j)
z = phi_k.sum(axis=0)                         # normalizzatore: somma di phi(k_j)
print("stato S:", S, "  normalizzatore z:", z)
for phi_q in ([1.0, 0.0], [0.0, 1.0], [1.0, 1.0]):
    phi_q = np.array(phi_q)
    lettura = (S @ phi_q) / (z @ phi_q)       # una sola lettura per query
    pesi = phi_k @ phi_q                      # i pesi delle coppie, per confronto
    media = pesi @ v / pesi.sum()
    print(f"phi(q) = {phi_q}: lettura {lettura:5.2f}, "
          f"media pesata a coppie {media:5.2f}, pesi {pesi}")

# 2) RoPE e poi ReLU: il peso dipende ancora dalla sola distanza?
def ruota(x, pos, base=1e6):                  # rope_theta di ACE-Step v1
    ang = pos * base ** (-np.arange(0, len(x), 2) / len(x))
    c, s = np.cos(ang), np.sin(ang)
    y = x.copy()
    y[0::2] = c * x[0::2] - s * x[1::2]
    y[1::2] = s * x[0::2] + c * x[1::2]
    return y

rng = np.random.default_rng(4)
q, k = rng.standard_normal(8), rng.standard_normal(8)
relu = lambda x: np.maximum(0, x)
print("posizioni   senza ReLU   ReLU dopo la rotazione")
for i in (0, 10, 100):
    j = i + 3                                 # sempre la stessa distanza
    nudo = ruota(q, i) @ ruota(k, j)
    con_relu = relu(ruota(q, i)) @ relu(ruota(k, j))
    print(f"{i:>3} e {j:>3}   {nudo:10.4f}   {con_relu:10.4f}")
stato S: [50. 40.]   normalizzatore z: [4. 2.]
phi(q) = [1. 0.]: lettura 12.50, media pesata a coppie 12.50, pesi [3. 1.]
phi(q) = [0. 1.]: lettura 20.00, media pesata a coppie 20.00, pesi [0. 2.]
phi(q) = [1. 1.]: lettura 15.00, media pesata a coppie 15.00, pesi [3. 3.]
posizioni   senza ReLU   ReLU dopo la rotazione
  0 e   3       1.0021       1.5249
 10 e  13       1.0021       2.0940
100 e 103       1.0021       0.3297
La lettura dello stato coincide con la media pesata calcolata a coppie, con i pesi \(\phi(\mathbf{q})^\top \phi(\mathbf{k}_j)\) stampati accanto. A distanza fissa, tre frame, il prodotto scalare delle due rotazioni vale 1,0021 a ogni posizione, mentre con la ReLU in mezzo il peso passa da 1,5249 a 2,0940 e a 0,3297.
La cross-attention resta softmax, \(\operatorname{softmax}(\mathbf{Q}\mathbf{K}_c^\top / \sqrt{d_k})\,\mathbf{V}_c\), con chiavi e valori proiettati dalla matrice delle condizioni \(\mathbf{C} = \mathbf{C}_{\text{parl}} \oplus \mathbf{C}_{\text{tag}} \oplus \mathbf{C}_{\text{testo}}\), concatenazione nel tempo delle tre, con \(n_c\) righe, una per token (il parlante ne occupa una). Richiede \(O(n\, n_c\, d_k)\), lineare in \(n\) a \(n_c\) fisso ma non trascurabile: finché il testo è più corto del latente costa meno dell’auto-attenzione softmax che la versione lineare ha sostituito (0,20 volte a 512 token), mentre al tetto dichiarato per l’addestramento, 4096 token di testo più 256 di tag e il token del parlante, ne costa 1,68 volte. Il calcolo è sul tetto, non su una canzone vera.
L’encoder dello stile è umT5 [CCG+23], congelato, e dà vettori di 768 dimensioni; il report scrive mT5-base, ma il riferimento che cita è UniMax e i file del modello sono quelli di umT5. L’encoder dei testi ha l’architettura di quello di SongGen [LDZ+25] e si addestra; usa il tokenizzatore XTTS VoiceBPE e porta le scritture non latine (cinese, giapponese, coreano) attraverso una conversione da grafema a fonema. La voce di riferimento è un vettore di 512 numeri, ricavato da 10 secondi di voce separata dall’accompagnamento, con dropout del 50% in addestramento e tolto del tutto nella messa a punto finale: peggiora la clonazione precisa della voce, ma affida più controllo alla descrizione testuale. Il file dei pesi del DiT conta 3,31 miliardi di parametri, di cui 87,8 milioni di proiettori che servono solo in addestramento; il report e il nome del repository dicono 3,5.
Poiché ogni passo di diffusione rifà tutto il latente, il tempo di generazione dovrebbe crescere con il numero dei passi. Il documento che accompagna i pesi pubblicati di ACE-Step v1, la model card, dichiara la velocità per le due impostazioni da 27 e 60 passi su tre schede grafiche, misurata in secondi di canzone prodotti per ogni secondo di calcolo: una velocità di 12 vuol dire dodici secondi di canzone in un secondo. Se tutto il tempo andasse con i passi, la velocità a 27 passi sarebbe \(60/27 \approx 2{,}22\) volte quella a 60. Scrivendo il tempo come una parte fissa più una parte per passo, le due velocità dichiarate bastano a fissare le due parti.
# Velocita' dichiarate nella model card di ACE-Step v1: secondi di audio
# prodotti per secondo di calcolo (RTF, piu' alto e' piu' veloce).
rtf = {"A100": (27.27, 12.27), "RTX 4090": (34.48, 15.63), "RTX 3090": (12.76, 6.48)}

print(f"rapporto fra i passi, 60 / 27: {60 / 27:.2f}")
print("scheda    rapporto fra   parte fissa, ms   frazione del tempo")
print("          le velocita'   per s di audio    coi passi, a 27")
for scheda, (r27, r60) in rtf.items():
    # tempo per secondo di audio = parte fissa + parte per passo * passi:
    # due velocita' fissano i due coefficienti, ma non controllano il modello
    per_passo = (1 / r60 - 1 / r27) / (60 - 27)
    fissa = 1 / r27 - 27 * per_passo      # secondi di calcolo per secondo di audio
    quota = 27 * per_passo * r27          # frazione del tempo che va coi passi
    print(f"{scheda:<9} {r27 / r60:12.2f}   {1000 * fissa:+15.2f}   {quota:17.0%}")
rapporto fra i passi, 60 / 27: 2.22
scheda    rapporto fra   parte fissa, ms   frazione del tempo
          le velocita'   per s di audio    coi passi, a 27
A100              2.22             -0.01                100%
RTX 4090          2.21             +0.38                 99%
RTX 3090          1.97            +16.23                 79%
I numeri sono dichiarati dagli autori, ciascuno con la sua scheda grafica, e servono soltanto per la proporzione. Due velocità fissano la retta, ma non possono controllare che il tempo stia davvero su una retta, e la parte fissa dell’A100 lo mostra: esce appena negativa, cosa impossibile per un tempo, e vuol dire soltanto che è nulla entro gli arrotondamenti delle cifre dichiarate. Letti così, sull’A100 e sulla RTX 4090 quasi tutto il tempo va con i passi, cioè con le valutazioni del DiT. Sulla RTX 3090 la stessa lettura dà una parte fissa di sedici millesimi di secondo per ogni secondo di canzone, e circa quattro quinti del tempo legati ai passi: è un’inferenza, che vale se il tempo è davvero una parte fissa più una parte per passo, e due soli punti non lo possono confermare.
Allineare le rappresentazioni: tenere il testo in rotta#
La cross-attention dà alla rete la possibilità di leggere il testo, non l’obbligo. Gli autori descrivono il rischio così: i modelli di diffusione tendono a imparare per prime le strutture larghe, che cambiano lentamente, come la melodia e la forma del brano, e solo dopo i dettagli fini, come le sfumature della voce; senza un riferimento semantico forte la rete potrebbe fissarsi troppo presto sui dettagli vocali e produrre testi non allineati o omessi. Il rimedio è un termine in più nella perdita, l’allineamento delle rappresentazioni o REPA [YKJ+25]: uno strato intermedio del DiT, che vede l’ingresso rumoroso, deve riprodurre attraverso una piccola rete le rappresentazioni che un encoder auto-supervisionato, addestrato senza etichette, calcola sul dato pulito.
In ACE-Step lo strato è l’ottavo su 24, secondo il report, e gli encoder auto-supervisionati sono due, uno per la musica e uno per la voce. MERT [LYZ+24a] è un modello per la musica della famiglia di HuBERT, addestrato a predire le parti mascherate dell’ingresso; mHuBERT-147 [ZBIL+24] è un HuBERT addestrato sul parlato di 147 lingue. Il primo tiene la rete attenta alla musica, il secondo alle parole. Che REPA serva è una dichiarazione degli autori (senza REPA l’allineamento si degrada, e togliere REPA solo in messa a punto peggiora il risultato); il report non stampa la tabella del confronto con e senza REPA.
Il restauratore parte da una nebbia e la toglie, passo dopo passo, fino a farne una canzone. Secondo chi l’ha costruito ha un difetto da principiante: le cose larghe, la linea della melodia e la forma del brano, le impara per prime, e poi rischia di innamorarsi dei dettagli. Prima di sapere con certezza che cosa si sta cantando si mette a rifinire il timbro di una vocale, e il risultato è una canzone nitida in cui la strofa dice altro, o salta una parola.
Per tenerlo in rotta, mentre si esercita, gli si mettono accanto due ascoltatori esperti. Uno ha passato la vita ad ascoltare musica, l’altro parole pronunciate in centoquarantasette lingue. Loro sentono la canzone vera, senza nebbia, e per ogni istante sanno scrivere che cosa ci sta succedendo. Il restauratore invece ha davanti la canzone ancora nella nebbia. Ogni volta che la ripulisce sale una torre di ventiquattro piani, e verso un terzo della salita si ferma e annota che cosa sta capendo, istante per istante; gli ascoltatori guardano gli appunti e dicono quanto somigliano ai propri.
Gli ascoltatori prendono appunti a ritmi propri, settantacinque e cinquanta al secondo, e il restauratore a undici. Perciò i suoi appunti passano prima da un traduttore, che li riscrive nella lingua di ciascun ascoltatore, e poi si stirano fino a combaciare con il ritmo dell’uno e dell’altro. Il voto è una distanza: zero se gli appunti dicono la stessa cosa, anche se sono scritti più in grande o più in piccolo, e via via di più quando se ne allontanano. Si somma al lavoro principale del restauratore, e all’inizio con lo stesso peso.
Verso la fine della messa a punto l’ascoltatore delle parole abbassa la voce a un centesimo: a forza di dare retta alle parole, il restauratore rischiava di spegnere gli strumenti. Gli ascoltatori danno solo un voto, non scrivono la canzone, e li si chiama soltanto mentre il restauratore si esercita: quando la canzone si genera non ci sono più. Gli autori sostengono che senza di loro il restauratore perdeva l’allineamento con il testo.
Nella convenzione del libro, con \(\mathbf{x}_t = (1-t)\,\mathbf{x}_0 + t\,\boldsymbol{\epsilon}\) e \(t = 1\) per il rumore puro, la perdita di flow matching è
con \(\mathbf{v}_\theta\) la rete, \(\mathbf{u}\) il campo bersaglio e \(\mathbf{C}\) la matrice delle condizioni. Il report la scrive in un’altra forma: la rete predice la velocità, se ne ricava una stima del dato, \(\hat{\mathbf{x}}_0 = \mathbf{x}_t - t\,\mathbf{v}_\theta\), e l’errore si misura sul dato. Sostituendo \(\mathbf{x}_t\) si trova \(\hat{\mathbf{x}}_0 - \mathbf{x}_0 = -t\,(\mathbf{v}_\theta - \mathbf{u})\): la perdita del report è la stessa perdita sulla velocità pesata con \(t^2\), che dà poco peso agli istanti vicini al dato pulito e peso pieno al rumore puro. Il passaggio vale per qualunque uscita della rete; il report non lo scrive, e lo si verifica numericamente su dati casuali. Qui \(t\) è il coefficiente del rumore, che il report chiama \(\sigma_t\); in addestramento lo si estrae da una logit-normale (media 0, deviazione 1) e lo si sposta verso il rumore con \(t \mapsto 3t/(1+2t)\).
Sia \(\mathbf{H} \in \mathbb{R}^{n \times 2560}\) lo stato all’uscita di un blocco intermedio, l’ottavo su 24 secondo il report (il codice lo prende dopo il blocco di indice 8 contando da zero, cioè dopo il nono). Per \(s \in \{\text{MERT}, \text{mHuBERT}\}\) sia \(\mathbf{Y}_s \in \mathbb{R}^{n_s \times d_s}\) la matrice delle caratteristiche dell’onda pulita, con righe \(\mathbf{y}_{s,i}\): \(d_s\) vale 1024 e 768, i frame sono 75 e 50 al secondo, e l’audio entra mono, ricampionato a 24 e 16 kHz. Un proiettore \(P_s\) (un MLP di tre strati con SiLU) porta ogni riga di \(\mathbf{H}\) a \(d_s\) dimensioni, e un’interpolazione lineare nel tempo porta le \(n\) righe a \(n_s\); siano \(\hat{\mathbf{y}}_{s,i}\) le righe del risultato. La perdita di allineamento e quella complessiva sono
dove il coseno è il prodotto scalare dei due vettori diviso per le loro norme, e quindi non dipende dalla loro lunghezza.
Il peso è \(\lambda_{\text{SSL}} = 1\), e la sola componente di mHuBERT scende a \(0{,}01\) negli ultimi 100.000 passi di messa a punto, per non sopprimere gli strumenti. Il report stampa la formula come media dei soli coseni, senza l’«uno meno», e come perdita da minimizzare allontanerebbe le rappresentazioni invece di avvicinarle; la frase che la introduce parla di \(1 - \cos\), e il codice usa \(1 - \cos\). Vale quindi la forma scritta qui, che con il coseno come similarità differisce dalla perdita del REPA originale, l’opposto della similarità media (eq. 8 di [YKJ+25]), solo per la costante additiva 1. I proiettori (87,8 milioni di parametri) servono solo in addestramento.
Due conti su dati casuali controllano l’identità fra la perdita sul dato e quella sulla velocità pesata con \(t^2\), e mostrano come si comporta \(1 - \cos\) quando gli stati del DiT, undici al secondo, vengono portati con un’interpolazione lineare alla frequenza dei frame di MERT.
import numpy as np

rng = np.random.default_rng(0)

# 1) La perdita del report, scritta sul dato pulito, e' la perdita sulla
#    velocita' pesata per t^2 (t = coefficiente del rumore).
x0 = rng.standard_normal((6, 40))        # dato pulito
eps = rng.standard_normal((6, 40))       # rumore
t = rng.uniform(0.05, 0.95, size=(6, 1))
v = rng.standard_normal((6, 40))         # una "predizione" qualunque della rete

xt = (1 - t) * x0 + t * eps              # convenzione del libro
u = eps - x0                             # bersaglio: la velocita'
x0_pred = xt - t * v                     # come nel report: v * (-t) + xt

perdita_dato = ((x0_pred - x0) ** 2).sum(axis=1)
perdita_vel = (t[:, 0] ** 2) * ((v - u) ** 2).sum(axis=1)
print("le due perdite coincidono:", np.allclose(perdita_dato, perdita_vel))

# 2) La perdita REPA: 1 - coseno, dopo aver portato gli stati del DiT
#    alla frequenza dei frame di MERT (interpolazione lineare).
r_dit, r_mert, finestra = 10.77, 75, 5.0     # frame al secondo; secondi
n_dit, n_mert = round(r_dit * finestra), round(r_mert * finestra)
print("frame del DiT e di MERT nella stessa finestra:", n_dit, n_mert)

tt = np.linspace(0, 1, n_mert)
y = np.stack([np.sin(2 * np.pi * f * tt + p)
              for f, p in [(1, 0.0), (2, 1.0), (3, 2.0), (1.5, 0.5)]], axis=1)

def porta_alla_frequenza(h, n_out):
    xs = np.linspace(0, 1, len(h))
    xo = np.linspace(0, 1, n_out)
    return np.stack([np.interp(xo, xs, h[:, c]) for c in range(h.shape[1])], axis=1)

def uno_meno_coseno(a, b):
    a = a / np.linalg.norm(a, axis=1, keepdims=True)
    b = b / np.linalg.norm(b, axis=1, keepdims=True)
    return (1 - (a * b).sum(axis=1)).mean()

h_buono = porta_alla_frequenza(y[np.linspace(0, n_mert - 1, n_dit).astype(int)], n_mert)
h_a_caso = porta_alla_frequenza(rng.standard_normal((n_dit, 4)), n_mert)
print(f"1 - coseno, stati coerenti     {uno_meno_coseno(h_buono, y):.4f}")
print(f"1 - coseno, stati a caso       {uno_meno_coseno(h_a_caso, y):.4f}")
print(f"solo il coseno, coerenti       {1 - uno_meno_coseno(h_buono, y):.4f}")
le due perdite coincidono: True
frame del DiT e di MERT nella stessa finestra: 54 375
1 - coseno, stati coerenti     0.0002
1 - coseno, stati a caso       0.9690
solo il coseno, coerenti       0.9998
Con stati coerenti la distanza \(1 - \cos\) è quasi zero, con stati a caso vicina a uno; la media dei soli coseni, la forma stampata nel report, vale invece 0,9998 sugli stati coerenti, e andrebbe massimizzata. Il segnale di prova cambia lentamente, poche oscillazioni in cinque secondi, e l’interpolazione da undici a settantacinque frame al secondo lo ricostruisce quasi per intero: un dettaglio più rapido di un frame del DiT, interpolando, non si recupera.
Modificare senza rigenerare: variazioni, repaint, FlowEdit#
Un modello di flow matching porta il rumore alla canzone seguendo, passo dopo passo, la direzione che la rete indica in ogni punto, cioè la velocità \(\mathbf{v}_\theta\): in termini tecnici integra un’equazione differenziale. Offre quindi tre punti dove intervenire: il rumore di partenza, il latente a ogni passo e la velocità stessa. ACE-Step v1 ne ricava tre funzioni di modifica [GZW+25]. Le variazioni cambiano il rumore di partenza; il repaint impone a ogni passo la parte di canzone che si vuole conservare; la modifica del testo con FlowEdit [KKHSM25] cambia le parole cantate lasciando melodia, voce e accompagnamento.
La canzone nasce da una nebbia, e la forma della nebbia decide come sarà. Se riparti dalla stessa nebbia e il restauratore non ne aggiunge di nuova lungo la strada, ottieni la stessa canzone. Per averne una variante mescoli la nebbia di partenza con un’altra, con una manopola che si gira di un quarto di giro: da un capo la nebbia vecchia, dall’altro quella nuova. La mescolanza ha però una regola. A metà corsa verrebbe da versare metà dell’una e metà dell’altra, ma le due nebbie sono indipendenti, e dove una si addensa l’altra spesso si dirada: messe insieme a metà, i loro grumi si compensano in parte, e la nebbia diventa più rada di entrambe, diversa da tutte quelle che il restauratore ha visto imparando. La manopola prende invece un po” di più di ciascuna, a metà corsa sette decimi dell’una e sette decimi dell’altra, quanto basta perché la nebbia resti spessa come prima: girandola cambia soltanto quanto somiglia alla vecchia.
Per rifare un pezzo solo, segni sulla canzone il tratto da rifare e tieni da parte l’originale. Annebbi tutto, tanto più quanto più vuoi cambiare quel tratto: la manopola è la stessa delle varianti. Da lì il restauratore ripulisce come al solito, tutta la canzone insieme, ma dopo ogni suo passo, fuori dal tratto segnato, cancelli quello che ha fatto e rimetti l’originale, annebbiato quanto lo è in quel momento tutto il resto e sempre con la stessa nebbia. Dentro il tratto il lavoro resta suo: lì inventa, e vede quello che sta intorno. Alla fine, fuori dal tratto, c’è l’originale com’era. Nessuno misura quanto il risultato si allontani da ciò che si vuole per correggerlo passo dopo passo, come fa la guida con una misura: la parte conosciuta si rimette e basta. Allungare una canzone è lo stesso gesto, con il tratto segnato oltre la fine o prima dell’inizio, dove non c’è un originale da rimettere. Il restauratore però non si è mai esercitato così, e la parte rimessa a ogni passo non sa niente di quella che lui sta inventando: le giunzioni possono sentirsi.
Per cambiare una parola del testo senza toccare melodia e voce, non si cerca la nebbia da cui la canzone sarebbe nata: si parte dalla canzone com’è, e se ne fa una copia da ritoccare un poco a ogni passo. A ogni passo si annebbiano allo stesso modo, con la stessa nebbia fresca, l’originale e la copia. Poi si chiedono al restauratore due cose: in che direzione ripulirebbe l’originale annebbiato, se il testo fosse quello vecchio, e in che direzione ripulirebbe la copia annebbiata con il testo nuovo. Dove le due risposte coincidono, e per una parola cambiata dovrebbero coincidere quasi dappertutto (la melodia, la voce, gli strumenti), la differenza è zero e la copia resta ferma; dove differiscono, sulle sillabe da cambiare, la copia si sposta di quel tanto, nella direzione che il testo nuovo chiede in più del vecchio. Così la copia si allontana dall’originale soltanto dove cambiano le parole. La nebbia è nuova a ogni passo, e si possono provare più nebbie e fare la media delle differenze. È pensato per piccoli ritocchi: per una riscrittura grossa se ne fanno diversi, uno dopo l’altro.
Variazioni. Con i campionatori deterministici della pipeline (Eulero e
Heun) l’integrazione è un’ODE, quindi lo stesso rumore di partenza
\(\boldsymbol{\epsilon}^{\text{src}}\) ridà sempre la stessa canzone; il
campionatore stocastico che la pipeline offre accanto a questi (pingpong)
rimette rumore nuovo a ogni passo, e lì il rumore di partenza da solo non fissa
il risultato. Per variare la canzone il rumore di partenza diventa
con \(\boldsymbol{\epsilon}^{\text{nuovo}}\) indipendente e \(\eta \in [0, 1]\) la
forza della variazione (nel codice retake_variance). Fra due gaussiane
standard indipendenti, componente per componente,
\(\operatorname{Var}(\boldsymbol{\epsilon}') = \cos^2\gamma + \sin^2\gamma = 1\)
e la correlazione con \(\boldsymbol{\epsilon}^{\text{src}}\) è \(\cos\gamma\):
\(\eta = 0\) ridà la canzone, \(\eta = 1\) ne sceglie un’altra. La media pesata
\((1-\eta)\,\boldsymbol{\epsilon}^{\text{src}} +
\eta\,\boldsymbol{\epsilon}^{\text{nuovo}}\) ha varianza \((1-\eta)^2 + \eta^2\),
che per \(\eta = 1/2\) vale \(1/2\): un rumore troppo piccolo, fuori da ciò che la
rete ha visto. La forma con seno e coseno è quella con cui TrigFlow interpola
fra dato e rumore,
\(\cos\gamma\,\mathbf{x}_0 + \sin\gamma\,\boldsymbol{\epsilon}\) con
\(\gamma \in [0, \pi/2]\) [LS25].
import numpy as np

rng = np.random.default_rng(7)
n = 200_000                          # numeri estratti per ogni rumore
eps_src = rng.standard_normal(n)     # il rumore con cui e' nata la canzone
eps_nuovo = rng.standard_normal(n)   # un rumore nuovo

print("forza  cos   sin   varianza  correlazione  varianza della media pesata")
for eta in (0.2, 0.5, 0.8):
    angolo = eta * np.pi / 2
    nuovo = np.cos(angolo) * eps_src + np.sin(angolo) * eps_nuovo
    ingenuo = (1 - eta) * eps_src + eta * eps_nuovo
    corr = np.corrcoef(eps_src, nuovo)[0, 1]
    print(f"{eta:5.1f}  {np.cos(angolo):.3f} {np.sin(angolo):.3f}"
          f"  {nuovo.var():8.3f}  {corr:12.3f}  {ingenuo.var():27.3f}")
forza  cos   sin   varianza  correlazione  varianza della media pesata
  0.2  0.951 0.309     0.998         0.951                        0.679
  0.5  0.707 0.707     0.997         0.707                        0.498
  0.8  0.309 0.951     0.997         0.309                        0.678
Con seno e coseno la varianza resta uno per ogni forza, e la correlazione col rumore di partenza vale \(\cos\gamma\) (0,951, 0,707, 0,309); con la media pesata la varianza scende, e a metà strada vale la metà. A metà corsa i due pesi valgono entrambi \(\cos(\pi/4) = \sin(\pi/4) \approx 0{,}707\).
Repaint. Si fissa una maschera sui frame del latente, uno ogni 92,9 ms. Sia \(\mathbf{x}^{\text{src}}_0\) il latente della canzone da ritoccare e \(\boldsymbol{\epsilon}\) un rumore estratto una volta sola e tenuto fisso per tutta la traiettoria (nel codice, dentro la maschera è il rumore \(\boldsymbol{\epsilon}'\) delle variazioni). Con forza \(\eta\) e \(N\) passi, il codice salta i primi \(\lfloor N(1-\eta) \rfloor\) e parte da \(\mathbf{x}^{\text{src}}_t = (1-t)\,\mathbf{x}^{\text{src}}_0 + t\,\boldsymbol{\epsilon}\) al livello di rumore di quel passo: con \(\eta = 1\) riparte dal rumore puro, con \(\eta\) piccolo da un originale poco annebbiato. A ogni passo, dopo il passo di Eulero, fuori dalla maschera il latente si rimpiazza con \(\mathbf{x}^{\text{src}}_t\) al livello di rumore corrente, sempre con lo stesso \(\boldsymbol{\epsilon}\); dentro, la rete genera vedendo il contesto. A \(t = 0\) fuori dalla maschera resta l’originale. Non è l’inpainting per guida: lì si deriva una misura rispetto alla stima del dato pulito e si spinge il campione col gradiente, qui non ci sono né misura né gradiente, e la parte nota si impone invece di essere inseguita. A parte il rumore tenuto fisso, che RePaint estrae di nuovo a ogni passo, è lo schema di RePaint [LDR+22], che sulle immagini ne ha descritto il difetto: la parte nota si rimette senza tener conto di quella generata, e il bordo non si armonizza mai del tutto, perché a ogni passo il problema si ripresenta. RePaint lo attenua riportando più volte il campione indietro, con rumore nuovo, e ripulendolo di nuovo prima di avanzare; la pipeline di ACE-Step non lo fa. L’extend è lo stesso meccanismo con la maschera oltre i bordi del brano. Né l’uno né l’altro sono addestrati con maschere (il report scrive che l’extend, per la continuazione come per l’inpainting, non è integrato nativamente nell’addestramento), e la model card segnala transizioni innaturali nelle giunzioni di repaint ed extend.
FlowEdit. Senza invertire il campionamento, cioè senza cercare il rumore da cui la canzone sorgente sarebbe nata, si integra un’ODE che porta direttamente da \(\mathbf{x}^{\text{src}}_0\) alla canzone col testo nuovo. Con \(\mathbf{x}^{\text{src}}_t = (1-t)\,\mathbf{x}^{\text{src}}_0 + t\,\boldsymbol{\epsilon}\) e \(\mathbf{x}^{\text{tar}}_t = \mathbf{x}^{\text{FE}}_t + \mathbf{x}^{\text{src}}_t - \mathbf{x}^{\text{src}}_0\), la traiettoria \(\mathbf{x}^{\text{FE}}\) parte da \(\mathbf{x}^{\text{FE}}_1 = \mathbf{x}^{\text{src}}_0\) e si muove, mentre \(t\) scende, secondo la differenza media fra le due velocità,
dove \(\mathbf{C}_{\text{vecchio}}\) e \(\mathbf{C}_{\text{nuovo}}\) sono le condizioni con il testo vecchio e con quello nuovo. Il valore atteso si stima a ogni passo con una o poche estrazioni nuove di \(\boldsymbol{\epsilon}\) (nel codice di ACE-Step una sola, per difetto), e l’arrivo \(\mathbf{x}^{\text{FE}}_0\) è la canzone modificata. Il report la dichiara ottimizzata per piccoli segmenti, e per modifiche grandi si concatenano ritocchi successivi.
Il report descrive anche altre funzioni costruite sullo stesso modello: due adattatori LoRA, Lyric2Vocal, addestrato sulla sola voce, e Text2Sample, addestrato su campioni strumentali; e due adattatori ControlNet, StemGen e Singing2Accompaniment, che nel rilascio della v1 non sono pubblicati.
Fra i limiti, gli autori dichiarano per prima la qualità, vincolata dall’autoencoder sul mel e dal vocoder. L’aderenza a stile e testo si può ancora migliorare, e il processo ha un aspetto da lotteria: i risultati migliori possono richiedere più tentativi. La model card aggiunge che oltre i cinque minuti, un minuto più in là della lunghezza massima vista in addestramento, la coerenza della struttura può perdersi, che il canto è grossolano e povero di sfumature, e che le prestazioni cambiano da una lingua all’altra.
Da ricordare
Una canzone si rifà tutta insieme: la busta, cioè il latente, parte come una nebbia, e a ogni passo il restauratore la rifà da capo per intero, in 27 o 60 passi per ACE-Step v1 e 32 per DiffRhythm, qualunque sia la durata.
La busta è sessantaquattro volte più leggera della registrazione, e quello che non porta il suono rifatto lo può soltanto indovinare.
I musicisti, uno per istante, non si ascoltano a coppie: scrivono su una lavagna comune e la leggono ciascuno con il proprio cartellino, e sulla lavagna i dettagli si impastano. Il testo sta su un leggio, letto per intero da ogni musicista.
Due ascoltatori esperti, uno di musica e uno di parole, secondo gli autori tengono il restauratore attento al testo, e solo durante l’addestramento.
Si può variare la canzone (mescolando la nebbia di partenza con un’altra, senza farla diradare), rifarne un pezzo (rimettendo a ogni passo l’originale annebbiato fuori dal tratto da rifare) e cambiare una parola (spostando la copia soltanto dove il testo nuovo chiede una direzione diversa dal vecchio). Il restauratore non si è mai esercitato con una parte imposta, e le giunzioni possono sentirsi.
Da ricordare
Il latente ha 330.750 valori per quattro minuti, per il mel compresso di ACE-Step v1 (\(8 \times 16 \times n\), \(r \approx 10{,}77\) Hz) come per il VAE sull’onda di DiffRhythm (\(64 \times n\), \(r \approx 21{,}5\) Hz). Il mel è un limite dichiarato dagli autori.
L’auto-attenzione di ACE-Step v1 è lineare, con \(\phi = \max(0, \cdot)\) applicata dopo la RoPE, che così non dà più pesi funzione della sola distanza, e costo \(O(n\,d_k^2)\); la cross-attention verso le condizioni resta softmax, come in Sana, con costo \(O(n\,n_c\,d_k)\). Le sequenze di addestramento arrivano a 2584 frame, quattro minuti. DiffRhythm scrive i fonemi della frase \(g\) a partire dal frame \(\nu_g = \lfloor \tau_g r \rfloor\).
\(\mathcal{L} = \mathcal{L}_{\text{FM}} + \lambda_{\text{SSL}}\mathcal{L}_{\text{SSL}}\), con \(\mathcal{L}_{\text{SSL}}\) la media della distanza \(1 - \cos\) fra lo stato di un blocco intermedio, proiettato e interpolato, e le caratteristiche di MERT e mHuBERT. Il peso di mHuBERT scende a 0,01 verso la fine.
Le variazioni usano \(\boldsymbol{\epsilon}' = \cos\gamma\,\boldsymbol{\epsilon}^{\text{src}} + \sin\gamma\,\boldsymbol{\epsilon}^{\text{nuovo}}\), con \(\gamma = \eta\pi/2\) e varianza 1; il repaint parte dall’originale annebbiato e sostituisce la parte nota a ogni passo, con un rumore fisso e senza gradiente, come RePaint ma senza ricampionare, e non è addestrato con maschere; FlowEdit muove il campione con la differenza media di due velocità.
In nessuna delle due strade un modello decide in anticipo dove cadrà ciascuna sillaba: DiffRhythm se lo fa dire dall’utente, ACE-Step v1 lo scopre mentre genera. Il gruppo di ACE-Step ha poi spostato quella decisione prima della diffusione, affidandola a un modello di linguaggio [GSZ+26]: è la strada del progetto che viene prima del suono.