


Generare video#
Nella tenuta di Palo Alto, in California, una mattina di giugno del 1878, a bordo pista c’è un capanno imbiancato a calce, e dentro il fotografo Eadweard Muybridge ha allineato dodici fotocamere. Dall’altra parte della pista c’è un fondale bianco inclinato, e attraverso la pista corrono dodici fili, uno per fotocamera. Passa un trottatore che tira un calesse leggero a due ruote, il sulky, e ogni volta che una ruota passa su un filo chiude un circuito elettrico e fa scattare la fotocamera collegata. Le dodici fotografie sono prese in meno di mezzo secondo, e in venti minuti Muybridge sviluppa le lastre e le mostra agli ospiti, giornalisti compresi.
Gli appassionati di cavalli del tempo si chiedevano se, al trotto o al galoppo, ci fosse un istante in cui tutti e quattro gli zoccoli fossero sollevati da terra. Leland Stanford, il padrone della tenuta, sosteneva di sì, e nel 1872 si era rivolto a Muybridge per chiudere la questione. Una fotografia istantanea, a differenza dell’occhio, può rispondere, e la risposta sta nelle lastre. Nelle sequenze del trottatore Abe Edgington, verso la metà di ogni falcata, tutti e quattro gli zoccoli si staccano insieme dal terreno [Les01]. La leggenda aggiunge una scommessa da venticinquemila dollari che Stanford avrebbe puntato sull’esito, ma quasi tutti gli storici seri che l’hanno cercata concludono che non ci fu [Les01].
Per rispondere bastava una lastra, quella giusta; la falcata intera, invece, sta nella fila, nell’ordine delle pose e nella distanza che le separa. Dodici fotografie scattate a intervalli ravvicinati sono già un video di dodici fotogrammi, e se le si rimescola restano dodici pose vere, ma la corsa sparisce. Una rete neurale che genera video, cioè un programma che ha imparato da molti esempi a produrne di nuovi, fa il lavoro rovesciato: non osserva la fila, la produce, e le pose che produce devono stare insieme come quelle di Muybridge.
In questo capitolo vediamo come si costruisce una rete che ci riesce. Si parte dalla taglia del problema e dal modo di ridurla con un autoencoder, la rete che comprime i dati in una forma compatta, detta latente, e poi li ricostruisce: la sezione su Stable Diffusion lo usa per le immagini, e per il video l’autoencoder comprime il tempo oltre che lo spazio. Segue l’attenzione nello spazio e nel tempo, che mette in relazione ogni porzione del video con le altre, nello stesso fotogramma e da un fotogramma all’altro; poi il modo di addestrare un generatore e misurarne il movimento; la generazione mentre il video scorre, in tempo reale e fino ai mondi in cui si può giocare; infine il suono che accompagna le immagini.
Un video è un tensore#
Per una rete neurale un video è un tensore, cioè una tabella di numeri a più indici: \(\mathbf{V} \in \mathbb{R}^{F \times H \times W \times 3}\), che si legge «\(\mathbf{V}\) è fatto di numeri reali disposti lungo quattro assi, lunghi \(F\), \(H\), \(W\) e 3». Contiene \(F\) fotogrammi (frame), ciascuno una griglia di \(H \times W\) pixel con tre canali di colore, campionati a una frequenza fissa che si misura in fotogrammi al secondo (fps); il fotogramma \(m\) è la fetta \(\mathbf{V}_m\) del tensore, di forma \(H \times W \times 3\). La durata è \(F\) divisa per quella frequenza, e un’immagine è il caso \(F = 1\). La Fig. 33.1 mostra la forma.
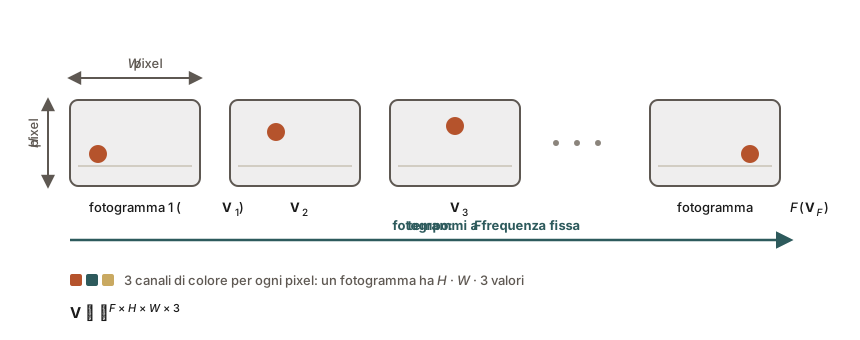
Fig. 33.1 Un video come tensore: \(F\) fotogrammi \(\mathbf{V}_1, \dots, \mathbf{V}_F\) di \(H \times W\) pixel, tre canali di colore per pixel, allineati lungo l’asse del tempo.#
Un generatore deve produrre tutti i \(3FHW\) valori del tensore. Consideriamo un clip di cinque secondi a 24 fps in 1280×720, una risoluzione comune, e contiamoli.
# Un video come tensore F x H x W x 3, contato in valori.
secondi, fps = 5, 24
F, H, W = secondi * fps, 720, 1280

per_fotogramma = H * W * 3
per_video = F * per_fotogramma
gib = per_video * 4 / 2**30          # un valore in float32 occupa 4 byte

print(f"fotogrammi F: {F}")
print(f"valori in un fotogramma: {per_fotogramma}")
print(f"valori in {secondi} s di video: {per_video}")
print(f"memoria in float32: {gib:.2f} GiB")
print(f"valori in un minuto: {60 * fps * per_fotogramma}")
print(f"pixel di un clip 1280x768 da 128 fotogrammi: {128 * 1280 * 768}")
fotogrammi F: 120
valori in un fotogramma: 2764800
valori in 5 s di video: 331776000
memoria in float32: 1.24 GiB
valori in un minuto: 3981312000
pixel di un clip 1280x768 da 128 fotogrammi: 125829120
Cinque secondi di video sono 331.776.000 valori, cioè 120 volte quelli di un’immagine della stessa risoluzione. In float32, il formato in cui ogni numero occupa 4 byte, sono 1,24 GiB (un GiB vale \(2^{30}\) byte, poco più di un miliardo), prima ancora che una rete ne tocchi uno. Il conto cresce in proporzione alla durata, e un minuto alla stessa risoluzione e frequenza fa quasi quattro miliardi di valori. Un minuto è la durata che il report su Sora dichiara alla portata del suo modello più grande [BPH+24]. Anche i modelli pubblicati lavorano su quantità di questo ordine; per esempio, l’uscita finale di Imagen Video, 128 fotogrammi di 1280×768, vale circa 126 milioni di pixel [HCS+22]. I video veri hanno centinaia o migliaia di fotogrammi, e per contenere il calcolo uno dei primi modelli di diffusione per video si addestrava su una piccola parte di ciascuno, per esempio 16 fotogrammi alla volta [HSG+22].
Sora comprime il tensore in un latente e lo taglia in tessere che si estendono anche nel tempo, cioè ciascuna copre una piccola zona per qualche fotogramma di seguito [BPH+24]. Sono le spacetime patches che la sezione sul Diffusion Transformer ha già descritto, e ogni tessera diventa un token, l’unità che il modello elabora come una parola in una frase.
Ma la taglia è metà del problema. I fotogrammi di un video devono stare insieme, e questo è un fatto di probabilità. Un modello generativo, come la rete che genera video, descrive una distribuzione di probabilità: dice quali dati sono plausibili, e quanto. Per un video la distribuzione si guarda a due livelli. Quella di un fotogramma preso da solo si chiama marginale, \(p(\mathbf{V}_m)\), e dice quali immagini sono plausibili in quel punto del video. La distribuzione congiunta \(p(\mathbf{V}_1, \dots, \mathbf{V}_F)\) assegna invece una probabilità a ogni sequenza di fotogrammi presa tutta insieme, e dice quindi anche quali file di fotogrammi sono plausibili. Che i fotogrammi stiano insieme lo decide la congiunta, e le marginali, che guardano un fotogramma alla volta, non lo vedono.
Una fotografia digitale è una griglia di puntini, i pixel, e ogni puntino porta tre numeri: quanto rosso, quanto verde, quanto blu. Le dodici lastre di Muybridge, rifatte oggi con una fotocamera digitale, sarebbero dodici griglie così, e dodici volte i numeri di una sola. Un video di cinque secondi a 24 fotogrammi al secondo è una fila di centoventi griglie, ciascuna con 720 righe di 1280 puntini, in tutto più di trecento milioni di numeri, e il doppio per dieci secondi.
Ora cambia gioco. Da un grande archivio di fotografie di cavalli al galoppo, scattate in giorni diversi, a cavalli diversi, su piste diverse, pesca dodici lastre a caso. Ogni lastra, da sola, è una fotografia credibilissima. Messe in fila non raccontano nessuna falcata: la zampa che in una lastra è a terra, nella successiva è già in aria dall’altra parte del corpo, e il mantello cambia colore a metà corsa. Ogni lastra va bene, e la fila no. È quello che si chiama una distribuzione con le marginali giuste, una lastra alla volta, e la congiunta sbagliata, la fila.
La fila di Muybridge funziona perché ogni lastra si capisce guardando quelle che la precedono. Da una certa posa, nell’istante successivo il cavallo può trovarsi solo in pochissime pose, tutte vicine a quella. Chi dovesse indovinare la lastra numero otto sa già moltissimo se ha visto le prime sette; se non le ha viste, sa soltanto che sarà un cavallo in corsa.
Quell’aiuto si conta in domande a risposta sì o no, come nella sezione sulla teoria dell’informazione. Supponiamo che le pose possibili siano 64. A chi non ha visto niente servono sei domande per trovare quella giusta, perché ognuna dimezza le possibilità e \(2^6 = 64\); se le lastre precedenti lasciano in gioco quattro pose, ne bastano due. Ogni lastra dopo la prima fa risparmiare quattro domande, cioè quattro bit, e sulle undici lastre il risparmio sommato è di 44 bit: è questa somma a dire quanto la fila stia insieme.
Il guaio dell’archivio non si ripara migliorando le fotografie. Anche se fossero tutte perfette, in una fila composta pescando le lastre una per una, senza guardare le altre, le precedenti non aiuterebbero mai a indovinare la successiva: servirebbero sempre sei domande, e il risparmio sommato varrebbe zero. In un video non basta che ogni fotogramma sia bello.
Definizione (video). Un video è un punto di \(\mathbb{R}^{3FHW}\), uno spazio la cui dimensione cresce linearmente con la durata, e un modello generativo ne descrive la distribuzione congiunta \(p(\mathbf{V}_{1:F}) = p(\mathbf{V}_1, \dots, \mathbf{V}_F)\). La marginale del fotogramma \(m\) si ottiene integrando via gli altri,
dove \(\mathbf{V}_{\setminus m}\) sono i fotogrammi diversi da \(m\).
Il prodotto delle marginali ha le stesse marginali della congiunta e in generale una congiunta diversa. Le due coincidono se e solo se i fotogrammi sono indipendenti, e lo scarto si misura con la multi-informazione, detta anche correlazione totale, che la sezione sulla diffusione discreta usa per i simboli scoperti insieme:
dove \(\mathbf{V}_{1:F}\) è la sequenza dei fotogrammi da \(1\) a \(F\), \(\mathbf{V}_{<m}\) sono quelli che precedono il fotogramma \(m\), \(D_{\mathrm{KL}}\) è la divergenza di Kullback–Leibler e \(I\) l’informazione mutua della sezione sulla teoria dell’informazione. La seconda uguaglianza segue dalla regola della catena,
il logaritmo del rapporto fra la congiunta e il prodotto delle marginali diventa la somma dei termini \(\log \bigl[p(\mathbf{V}_m \mid \mathbf{V}_{<m}) / p(\mathbf{V}_m)\bigr]\), e il valore atteso di ciascuno sotto \(p\) è per definizione \(I(\mathbf{V}_m; \mathbf{V}_{<m})\). Il termine con \(m = 1\) manca perché il primo fotogramma non ha passato. Ogni addendo misura quanto il passato dice sul fotogramma \(m\), ed è l’informazione fra un fotogramma e tutto il suo passato, non fra i fotogrammi presi a coppie; per \(F = 2\) la somma si riduce all’informazione mutua fra i due. L’identità vale per qualunque ordine dei fotogrammi, e i due membri possono valere \(+\infty\), come quando un fotogramma è funzione esatta dei precedenti.
Il punto di rottura è il generatore di immagini chiamato \(F\) volte. Anche se ogni marginale è esatta, la multi-informazione vale zero, e il video che ne esce è incoerente per costruzione, per quanto sia buono ogni fotogramma.
Perché non basta generare immagini una per una#
La prima idea è la più economica: prendere un generatore di immagini, come quello della sezione su Stable Diffusion, e chiamarlo \(F\) volte. Ogni chiamata produce un fotogramma dalla marginale \(p(\mathbf{V}_m)\) senza sapere niente delle altre, cioè estrae un campione indipendente. Poiché le probabilità di estrazioni indipendenti si moltiplicano, il video che ne esce viene dal prodotto delle marginali, \(\prod_{m} p(\mathbf{V}_m)\), dove il simbolo \(\prod\) sta per il prodotto come \(\sum\) sta per la somma: ogni fotogramma ha la distribuzione giusta, e i fotogrammi vanno d’accordo fra loro solo per caso. Gli autori di Video LDM, che trasformano un generatore di immagini in un generatore di video, scrivono che, usato così, il generatore fallisce perché non ha consapevolezza temporale (the model has no temporal awareness) [BRL+23].
Lo stesso lavoro trova una seconda fonte di instabilità nell’autoencoder del modello di immagini di partenza, come quello di Stable Diffusion, la rete che comprime ogni fotogramma in un latente e lo riporta in pixel. Addestrato solo su immagini, l’autoencoder tratta ogni fotogramma per conto suo, e così introduce piccole incoerenze da un fotogramma all’altro, che l’occhio vede come un tremolio e che prendono il nome di sfarfallio (flickering); compaiono anche quando gli si dà da comprimere e ricostruire una sequenza già coerente [BRL+23]. Il difetto sta dunque in due punti, nel generatore e nell’autoencoder, e il rimedio dovrà toccarli tutti e due.
Una misura semplice dello sfarfallio è la differenza media assoluta fra fotogrammi adiacenti. La usa VBench, una batteria di misure per valutare i generatori di video, che la calcola su scene statiche; una misura dello stesso tipo, la differenza \(L_1\) fra fotogrammi adiacenti, compare nell’articolo sul generatore CogVideoX [HHY+24, YTZ+25]:
dove \(\mathbf{V}_m\) è il fotogramma \(m\) e \(\lVert \cdot \rVert_1\) somma i valori assoluti delle differenze, pixel per pixel e canale per canale; la divisione per \((F-1)\,3HW\) fa la media sulle \(F-1\) coppie di fotogrammi adiacenti e sui \(3HW\) valori di ciascuna.
Per esempio, una riga di tre pixel in un solo canale (quindi tre valori per fotogramma al posto di \(3HW\)) passa da \((0, 1, 0)\) a \((0, 0, 1)\): un punto luminoso si è spostato di un pixel. Le differenze in valore assoluto sono 0, 1 e 1, e \(D = 2/3 \approx 0{,}67\); se il secondo fotogramma ripetesse il primo, \(D\) varrebbe 0.
Una scena in una sola dimensione basta per vedere la differenza. Il fotogramma è una riga di \(W = 64\) pixel con un solo canale, chiusa ad anello: dopo l’ultimo pixel viene di nuovo il primo, e un oggetto che esce da destra rientra da sinistra. Sulla riga c’è un picco luminoso largo qualche pixel, con il profilo a campana di una gaussiana di deviazione standard 3 pixel, e la sua posizione cambia da un fotogramma all’altro. Le tre sorgenti di video scelgono le posizioni in tre modi: indipendenti a ogni fotogramma; lungo una traiettoria che parte da un punto a caso e avanza di un pixel per fotogramma; ferme in un punto a caso. Guardato da solo, un fotogramma ha in tutte e tre il picco in un punto qualunque della riga, con la stessa probabilità ovunque (una distribuzione uniforme): le marginali sono le stesse, le congiunte no. Di ciascuna sorgente si estraggono 2000 video di \(F = 16\) fotogrammi.
import numpy as np

rng = np.random.default_rng(0)
# W pixel per riga, F fotogrammi, SIGMA deviazione standard del picco,
# PASSO pixel di spostamento per fotogramma
W, F, SIGMA, PASSO = 64, 16, 3.0, 1.0
asse = np.arange(W)

def fotogramma(pos):
    d = np.abs(asse - pos)
    d = np.minimum(d, W - d)                    # distanza sul cerchio
    return np.exp(-0.5 * (d / SIGMA) ** 2)

def video(posizioni):
    return np.stack([fotogramma(p) for p in posizioni])

n_video = 2000
# indipendente: ogni fotogramma ha la sua posizione a caso
indipendenti = np.array([video(rng.uniform(0, W, F)) for _ in range(n_video)])
# un secondo campione della stessa sorgente: misura il rumore della stima
altri = np.array([video(rng.uniform(0, W, F)) for _ in range(n_video)])
# coerente: parte da un punto a caso e avanza di PASSO a ogni fotogramma
coerenti = np.array([video((rng.uniform(0, W) + PASSO * np.arange(F)) % W)
                     for _ in range(n_video)])
# fermo: la stessa posizione a caso in tutti i fotogrammi
fermi = np.array([video(np.full(F, rng.uniform(0, W)))
                  for _ in range(n_video)])

def sfarfallio(v):
    # differenza media assoluta fra fotogrammi adiacenti, pixel per pixel
    return np.abs(np.diff(v, axis=1)).mean()

m = 7   # un fotogramma qualsiasi: l'ottavo, perche' Python conta da zero
for nome, v in [("altri indip.", altri), ("coerente", coerenti), ("fermo", fermi)]:
    scarto = np.abs(v[:, m].mean(axis=0) - indipendenti[:, m].mean(axis=0)).max()
    print(f"{nome:12} scarto massimo della media al fotogramma {m + 1}: {scarto:.3f}")
# il caso da solo: 200 confronti fra due campioni della stessa sorgente,
# ciascuno di n_video fotogrammi con il picco in un punto a caso
def media_a_caso():
    return fotogramma(rng.uniform(0, W, (n_video, 1))).mean(axis=0)
massimi = [np.abs(media_a_caso() - media_a_caso()).max() for _ in range(200)]
print(f"stessa sorgente, 200 confronti: mediana {np.median(massimi):.3f}, "
      f"massimo {np.max(massimi):.3f}")
for nome, v in [("indipendente", indipendenti), ("coerente", coerenti), ("fermo", fermi)]:
    print(f"sfarfallio {nome:12}: {sfarfallio(v):.4f}")
altri indip. scarto massimo della media al fotogramma 8: 0.011
coerente     scarto massimo della media al fotogramma 8: 0.018
fermo        scarto massimo della media al fotogramma 8: 0.011
stessa sorgente, 200 confronti: mediana 0.017, massimo 0.035
sfarfallio indipendente: 0.2004
sfarfallio coerente    : 0.0311
sfarfallio fermo       : 0.0000
La media per pixel di un fotogramma non distingue le tre sorgenti. Si prende il fotogramma 8, si calcola per ogni pixel la media sui 2000 video di una sorgente e la si confronta con quella delle posizioni indipendenti, nel pixel in cui le due medie differiscono di più. Lo scarto è 0,018 per la traiettoria e 0,011 per il picco fermo. Il termine di paragone è il caso: due campioni della stessa sorgente, che hanno la stessa distribuzione, differiscono già di 0,011, e su 200 confronti di questo tipo lo scarto ha una mediana di 0,017 e arriva fino a 0,035. Tutti e tre gli scarti hanno la taglia del caso, e sono il rumore della stima.
Lo sfarfallio invece separa le tre sorgenti, con 0,2004 per le posizioni indipendenti, 0,0311 per la traiettoria e zero per il picco fermo. La traiettoria non arriva a zero perché il picco si muove di un pixel per fotogramma: su una scena in moto la differenza fra fotogrammi contiene anche il moto, ed è per questo che VBench calcola lo sfarfallio su scene statiche.
Hai un disegnatore velocissimo che, se gli chiedi «una palla in una stanza», ti consegna in un secondo un disegno bellissimo. Gliene chiedi centoventi, uno per pagina, e li rileghi in un quaderno da sfogliare. Ogni pagina, da sola, è un disegno impeccabile; sfogliato, il quaderno è un pasticcio: la palla salta da un angolo all’altro, e la stanza cambia luce da una pagina alla successiva. Il disegnatore non ha sbagliato niente: non sapeva che le pagine fossero parte dello stesso quaderno.
Guardare i disegni uno per uno non basta per accorgersene, perché uno per uno sono tutti buoni. Mischia le pagine di questo quaderno con quelle di un secondo quaderno fatto bene, in cui la palla rimbalza piano da una pagina alla successiva, e guardale una alla volta: di nessuna sai dire da quale quaderno venga. La differenza si vede solo sfogliando, e si può contare misurando, da una pagina alla successiva, quanto cambia ciascun puntino, e facendo la media su tutto il quaderno. Nel quaderno fatto bene il risultato non è zero, perché la palla si muove, ma è piccolo; in quello a caso è più di sei volte tanto. È lo sfarfallio.
I disegnatori veri riparano questo difetto con il tavolo luminoso, un vetro illuminato da sotto su cui la pagina nuova si disegna sopra la trasparenza di quella prima. Al disegnatore velocissimo si insegna lo stesso gesto, senza fargli disimparare a disegnare, e ogni pagina si fa con le vicine in trasparenza invece che a occhi chiusi. Lo stesso vale per il copista, la seconda metà dell’autoencoder: come in Stable Diffusion, il disegnatore lavora su una scheda compatta, e la pagina finita la ridipinge il copista leggendo la sola scheda. Se ridipinge ogni pagina senza guardare le vicine, aggiunge un tremolio anche quando le schede vanno d’accordo, e anche lui deve lavorare sul tavolo luminoso.
Una cautela sul contatore. Un terzo quaderno, in cui la stessa pagina è copiata centoventi volte, dà zero e non è un film. Chi conta i cambi si accontenta di un quaderno fermo; per questo il contatore si usa su quaderni in cui non dovrebbe muoversi niente, dove ogni cambiamento è un tremolio, e per giudicare un film bisogna guardare anche che qualcosa si muova.
Poiché la chiamata \(m\) del generatore campiona dalla marginale \(p(\mathbf{V}_m)\) in modo indipendente dalle altre, il video ha distribuzione \(\prod_{m} p(\mathbf{V}_m)\): ogni marginale è esatta, e una misura che guarda i fotogrammi uno per uno, come il FID della sezione sull’addestramento avversario, non vede il difetto. Lo sfarfallio \(D\) dipende invece dalle congiunte delle coppie di fotogrammi adiacenti, \(p(\mathbf{V}_m, \mathbf{V}_{m+1})\), e due sorgenti con le stesse marginali possono avere \(D\) molto diverso. Le tre sorgenti della scena unidimensionale hanno per costruzione le stesse marginali, e nel fotogramma 8 la stessa media per pixel entro il rumore della stima su 2000 video; \(D\) vale 0,2004, 0,0311 e 0.
Il rimedio consiste nel modellare la congiunta. Video LDM intercala strati temporali agli strati spaziali di un modello di immagini congelato e addestra solo quelli; poi aggiunge strati temporali al decoder dell’autoencoder e lo affina su video con un discriminatore temporale, lasciando l’encoder com’era [BRL+23]. La sezione sull’attenzione nello spazio e nel tempo descrive la famiglia degli strati temporali.
Il rovescio è che \(D\) non misura la qualità. Un video fermo ha \(D = 0\), ed è la soluzione banale; su una scena in moto, invece, \(D\) comprende il moto, e il valore della traiettoria, 0,0311, viene tutto dal moto. Per questo VBench calcola lo sfarfallio solo su scene statiche, e lo affianca a un grado di dinamica che premia i video in cui qualcosa si muove [HHY+24]. Il compromesso fra le due misure lo riprende la sezione su addestrare e misurare.
Due difficoltà: la taglia e la dipendenza#
Il conto dei valori e la scena del picco che si sposta mostrano due difficoltà distinte. La prima è di taglia: centinaia di milioni di valori per pochi secondi di video. La seconda è di dipendenza: i fotogrammi vanno campionati insieme, dalla distribuzione congiunta, e un generatore di immagini non sa farlo. Le due si aggravano a vicenda. Il modo più diretto di catturare la dipendenza è lasciare che ogni porzione del video guardi tutte le altre, ed è ciò che fa l’attenzione, il meccanismo con cui un Transformer (l’architettura dei modelli linguistici, e del DiT) confronta ogni token di una sequenza con tutti gli altri. Con l’attenzione piena i confronti sono tanti quante le coppie di token, quindi crescono con il quadrato del loro numero; e poiché i token crescono in proporzione alla durata, raddoppiare la durata quadruplica il costo dell’attenzione.
Da ricordare
Un video è una fila di fotografie, i fotogrammi, e ogni fotografia è una griglia di puntini colorati. Cinque secondi a 24 fotogrammi al secondo sono centoventi fotografie, cioè centoventi volte i numeri di una sola: più di trecento milioni, in 1280×720.
A un video non basta che ogni fotogramma sia bello (le marginali giuste): i fotogrammi devono andare d’accordo fra loro (la congiunta giusta). Dodici fotografie perfette di cavalli diversi non raccontano una falcata, mentre le dodici lastre di Muybridge sì: la falcata sta nella fila.
Quanto la fila stia insieme si conta sommando, lastra per lastra, le domande sì o no che le lastre precedenti fanno risparmiare: per una fila pescata da un archivio la somma è zero.
Chi disegna ogni pagina di un quaderno senza guardare le altre ottiene pagine impeccabili e un quaderno che sfarfalla. Lo sfarfallio è quanto cambia in media ogni puntino fra una pagina e la successiva, e si misura sfogliando.
Il rimedio è far guardare a ogni pagina quelle vicine, come fa il tavolo luminoso, e vale anche per il copista che ridipinge le pagine dalle schede: da solo aggiunge il suo tremolio.
Un contatore di cambi si accontenta di un quaderno fermo: zero sfarfallio non vuol dire un bel film.
Da ricordare
Un video è un tensore \(\mathbf{V} \in \mathbb{R}^{F \times H \times W \times 3}\) di \(3FHW\) valori, lineare nella durata: 331.776.000 per cinque secondi a 24 fps in 1280×720, 1,24 GiB in float32.
Generare un video vuol dire campionare la congiunta \(p(\mathbf{V}_{1:F}) = \prod_m p(\mathbf{V}_m \mid \mathbf{V}_{<m})\), non il prodotto delle marginali: lo scarto fra le due è la multi-informazione, \(\sum_m I(\mathbf{V}_m; \mathbf{V}_{<m})\), e vale zero per un generatore di immagini chiamato \(F\) volte.
Lo sfarfallio \(D\), la differenza media assoluta fra fotogrammi adiacenti, dipende dalle congiunte delle coppie adiacenti: per un picco che si sposta su una riga di 64 pixel vale 0,2004 con posizioni indipendenti, 0,0311 con una traiettoria e 0 con un picco fermo, a parità di marginali.
Il difetto ha due sorgenti, il generatore e l’autoencoder [BRL+23]; il rimedio di Video LDM è addestrare strati temporali su un modello di immagini congelato e affinare il decoder.
\(D\) non misura la qualità: un video fermo dà \(D = 0\), su una scena in moto \(D\) contiene anche il moto, e VBench lo calcola su scene statiche e lo affianca a un grado di dinamica [HHY+24].
Il conto dei valori, più di trecento milioni per cinque secondi, indica da dove si comincia. I generatori di video recenti lavorano su una versione compressa di quei numeri, e la compressione deve ridurli senza perdere il tempo lungo la strada. Come ci riesce lo racconta la sezione sul comprimere il tempo.