


Comprimere il tempo: l’autoencoder video#
Un generatore di video come Wan produce di solito 81 fotogrammi a 1280×720 pixel. A 16 fotogrammi al secondo, la frequenza dei clip su cui Wan è addestrato (più bassa dei 24 del cinema), sono circa cinque secondi [WanTeamWA+25]. Lavorare sui pixel sarebbe proibitivo per la ragione che valeva già per le immagini, moltiplicata per il numero di fotogrammi. La soluzione è quella di Stable Diffusion. La diffusione, che genera togliendo il rumore un passo alla volta, non lavora sui pixel ma su un latente, una versione compressa dell’immagine molto più piccola; a portare i pixel nel latente e a riportarli indietro provvede un autoencoder variazionale (VAE), con un encoder che comprime e un decoder che ricostruisce [RBL+22]. Qui il tensore da comprimere ha un asse in più, il tempo, e il VAE deve comprimere anche quello.
Rispetto al VAE di Stable Diffusion cambiano due cose. Il latente ha un asse temporale, ed è anch’esso una sequenza di fotogrammi, i fotogrammi latenti, più corta di quella in pixel; ogni fotogramma latente riassume un gruppo di fotogrammi consecutivi. E nei VAE di Wan, HunyuanVideo, CogVideoX e LTX-Video la compressione nel tempo è causale, cioè un fotogramma latente non dipende da nessun fotogramma che venga dopo il suo gruppo.
Quanti numeri restano: dal clip ai token#
Prendiamo come esempio Wan. Il suo VAE riduce di 4 il numero dei fotogrammi e di 8 ciascun lato dell’immagine, e in ogni posizione del latente scrive 16 numeri, i canali, al posto dei 3 colori di un pixel [WanTeamWA+25]. Gli 81 fotogrammi diventano così 21 fotogrammi latenti (il primo fotogramma si comprime da solo, gli altri a gruppi di quattro), ciascuno una griglia di 90×160 posizioni. Poi il patchify del Diffusion Transformer raggruppa le posizioni in quadrati di 2×2 e fa di ciascun quadrato un token, uno dei vettori che il Transformer legge in fila come le parole di una frase.
In simboli, il clip ha \(F\) fotogrammi di \(H \times W\) pixel. Il VAE lo comprime di un fattore \(c_t\) nel tempo e di un fattore \(c_s\) in ciascuna dimensione spaziale, e lo scrive con \(C\) canali. Per Wan \(c_t = 4\), \(c_s = 8\) e \(C = 16\). Il risultato è una sequenza di \(F'\) fotogrammi latenti, ognuno di \((H/c_s) \times (W/c_s)\) posizioni. La patch ha lati \(p_t\), \(p_h\) e \(p_w\) nel tempo, in altezza e in larghezza, e in Wan vale \(1 \times 2 \times 2\); con \(p_t = 1\) ogni fotogramma latente dà \(S\) token, e la sequenza che il Transformer elabora ne ha \(N = F'S\). Lo stesso calcolo si ripete su altri due generatori, HunyuanVideo e Movie Gen.
import math

def conta(F, H, W, ct, cs, C, ph=2, pw=2, primo_a_parte=True):
    """Valori nei pixel, nel latente e token dopo la patch (pt = 1)."""
    if primo_a_parte:
        Fl = 1 + (F - 1) // ct          # primo fotogramma da solo
    else:
        Fl = math.ceil(F / ct)          # gruppi tutti uguali
    pixel = F * H * W * 3
    latente = Fl * (H // cs) * (W // cs) * C
    S = (H // (cs * ph)) * (W // (cs * pw))   # token per fotogramma latente
    return pixel, latente, Fl, S, Fl * S

# Wan: 81 fotogrammi a 1280x720, VAE 4x8x8 con 16 canali, patch 1x2x2
pixel, lat, Fl, S, N = conta(81, 720, 1280, 4, 8, 16)
immagine = 1 * 720 * 1280 * 3
print("immagine 1280x720:", immagine, "valori")
print("clip di 81 fotogrammi:", pixel, "valori")
print("rapporto clip/immagine:", round(pixel / immagine, 1))
print("latente:", Fl, "fotogrammi latenti,", lat, "valori")
print("compressione:", round(pixel / lat, 1), "(senza il +1 sarebbe 48)")
print("token per fotogramma latente S =", S, " token totali N =", N)

# HunyuanVideo: 129 fotogrammi 720x1280, stessi fattori
p, l, Fl, S, N = conta(129, 720, 1280, 4, 8, 16)
print("Hunyuan: F' =", Fl, " S =", S, " N =", N)

# Movie Gen: 256 fotogrammi 768x768, 8x8x8, 16 canali, primo non a parte
p, l, Fl, S, N = conta(256, 768, 768, 8, 8, 16, primo_a_parte=False)
print("Movie Gen: F' =", Fl, " S =", S, " N =", N)
immagine 1280x720: 2764800 valori
clip di 81 fotogrammi: 223948800 valori
rapporto clip/immagine: 81.0
latente: 21 fotogrammi latenti, 4838400 valori
compressione: 46.3 (senza il +1 sarebbe 48)
token per fotogramma latente S = 3600  token totali N = 75600
Hunyuan: F' = 33  S = 3600  N = 118800
Movie Gen: F' = 32  S = 2304  N = 73728
Un clip di 81 fotogrammi ha 81 volte i valori di un’immagine, quasi 224 milioni, e il latente ne ha 4.838.400, circa 46 volte meno. Da dove venga il fattore si vede guardando una sola posizione del latente, che riassume \(c_t \cdot c_s \cdot c_s = 4 \cdot 8 \cdot 8 = 256\) pixel, cioè \(256 \cdot 3 = 768\) valori di colore, con \(C = 16\) numeri, e \(768/16 = 48\). Sul clip il fattore scende a 46,3 perché i fotogrammi latenti sono \(F' = 1 + (F-1)/c_t = 21\) e non \(F/c_t = 20{,}25\), e il «+1» è il primo fotogramma, che il VAE codifica da solo.
Per la diffusione, però, il numero che conta è l’ultimo, \(N = 75\,600\) token, cioè 3.600 per ciascuno dei 21 fotogrammi latenti, ventuno volte la sequenza di una singola immagine alla stessa risoluzione. HunyuanVideo, con clip di 129 fotogrammi, arriva a 118.800 token; Movie Gen, che genera clip ancora più lunghi ma comprime il tempo di 8, a 73.728.
All’archivista di Stable Diffusion, quello che per ogni quadro scrive una scheda molto più piccola dell’originale, arriva un film di 81 fotogrammi. Il lavoro è quello di sempre, scrivere schede così compatte, e così precise, che il copista, leggendo soltanto quelle, sappia ridipingere tutto. Il film pesa quasi 224 milioni di numeri, ottantuno volte una fotografia, e le schede ne devono contenere meno di cinque milioni.
Ogni scheda è una griglia di caselle, e ogni casella riassume con pochi numeri un quadratino di 8 pixel per lato. La torre, il Transformer che poi toglierà il rumore lavorando sulle schede, le legge a tessere di due caselle per lato, e il film le arriverà come 75.600 tessere invece che come milioni di pixel.
La via più semplice è far scrivere all’archivista una scheda per fotogramma, come ha sempre fatto, cioè ottantuno schede, ciascuna scritta guardando una sola immagine. Ogni scheda, presa da sola, è ottima. Il guaio sta fra una scheda e l’altra. Il copista ridipinge ogni fotogramma dalla sua scheda, e il dettaglio che nella scheda 12 è annotato in un modo, nella 13 è annotato in un altro, per esempio la grana di un muro o il bordo di una foglia. Nessuno dei due ha mai visto due fotogrammi vicini insieme, quindi nessuno dei due sa che dovrebbero andare d’accordo. Proiettato, il muro formicola, ed è lo sfarfallio.
Una prima riparazione manda a scuola il solo copista, a studiare film invece di fotografie, perché impari a ridipingere fotogrammi vicini in modo che vadano d’accordo. Funziona, ma le schede restano ottantuno. La riparazione completa cambia il mestiere dell’archivista, che invece di una scheda per fotogramma ne scrive una per ogni gruppo di quattro fotogrammi consecutivi, annotando sia che cosa c’è sia come cambia da un fotogramma all’altro del gruppo. Ogni casella copre ora lo stesso quadratino per quattro fotogrammi di fila, cioè 256 pixel e 768 numeri di colore (rosso, verde e blu per ciascun pixel), e l’archivista li stringe in 16, quarantotto volte meno.
Le schede scendono a ventuno, una per il primo fotogramma, preso da solo, e una per ciascuno dei venti gruppi che lo seguono. Il tempo è già compresso quando la torre comincia a lavorare, e il copista, che legge le schede in ordine, ridipinge un gruppo alla volta tenendo sott’occhio quelli già dipinti, così la grana del muro resta la stessa da un fotogramma all’altro.
Indichiamo con \(\mathbf{V} \in \mathbb{R}^{F \times H \times W \times 3}\) il clip, con \(\mathbf{V}_m \in \mathbb{R}^{H \times W \times 3}\) il suo fotogramma \(m\) e con \(\mathbf{x}^{i}\), per \(i = 1, \dots, F'\), il fotogramma latente \(i\). L’encoder del VAE è la mappa \(\mathcal{E}: \mathbb{R}^{F \times H \times W \times 3} \to \mathbb{R}^{F' \times (H/c_s) \times (W/c_s) \times C}\), che porta \(\mathbf{V}\) nella sequenza \((\mathbf{x}^{1}, \dots, \mathbf{x}^{F'})\), e il decoder \(\mathcal{D}\) ne è un’inversa approssimata. Il fattore di compressione, a meno del primo fotogramma, è \(c_t c_s^2 \cdot 3 / C\), cioè \(4 \cdot 64 \cdot 3 / 16 = 48\) per Wan. Il valore calcolato sul clip, 46,3, è più basso perché i fotogrammi latenti sono \(F' = 1 + (F-1)/c_t\), e infatti i 4.838.400 valori del latente sono \(21 \cdot 90 \cdot 160 \cdot 16\). Per la diffusione, però, il numero rilevante è \(N = F'S\) con \(S = \frac{H}{c_s p_h} \cdot \frac{W}{c_s p_w}\), perché l’attenzione piena costa \(O(N^2)\), e a 75.600 token pesa già più del resto dello strato (il conto è nella sezione sull’attenzione nello spazio e nel tempo).
I parametri degli altri due generatori vengono dai rispettivi report. HunyuanVideo ha gli stessi fattori di Wan e arriva a 129 fotogrammi a 1280×720 [KTZ+24]; la sua patch, \(1 \times 2 \times 2\), la riporta la tabella di confronto di LTX-Video [HCB+24]. Movie Gen comprime di 8 su ogni asse, genera fino a 256 fotogrammi a 768×768 con la stessa patch e non tratta a parte il primo fotogramma, quindi ha \(\lceil F/8 \rceil = 32\) fotogrammi latenti e 73.728 token, il «circa 73K» del suo report [PZB+24].
Un VAE di immagini applicato un fotogramma alla volta non basta. Il suo encoder e il suo decoder, addestrati su immagini singole, non hanno nessun termine che leghi la ricostruzione di due fotogrammi vicini: ogni ricostruzione \(\mathcal{D}(\mathcal{E}(\mathbf{V}_m))\) è ragionevole da sola, e gli scarti, invisibili sul singolo fotogramma, in sequenza diventano sfarfallio. Blattmann e colleghi lo osservano per l’autoencoder di un modello di diffusione latente addestrato su sole immagini, e lo riparano nel solo decoder, con strati temporali affinati su video contro un discriminatore 3D, lasciando l’encoder com’è [BRL+23].
I generatori successivi rendono tridimensionale tutto l’autoencoder, encoder compreso. HunyuanVideo lo addestra da zero, con la perdita \(\mathcal{L}_1 + 0{,}1\, \mathcal{L}_{\text{LPIPS}} + 0{,}05\,\mathcal{L}_{\text{adv}} + 10^{-6}\, \mathcal{L}_{\text{KL}}\), che somma l’errore assoluto di ricostruzione, la distanza percettiva LPIPS, un termine avversario e la regolarizzazione KL del VAE; per ricostruire meglio i movimenti rapidi, campiona i fotogrammi dei clip di addestramento a un intervallo scelto a caso fra 1 e 8 [KTZ+24]. Wan parte da un VAE 2D su immagini, lo estende a 3D causale e lo affina con un discriminatore 3D [WanTeamWA+25]. Anche l’ablazione di CogVideoX confronta un VAE 2D e uno 3D con una misura di sfarfallio, la differenza \(L_1\) fra fotogrammi adiacenti, e la scelta cade sul secondo [YTZ+25].
La convoluzione causale e il primo fotogramma#
Due scelte rendono adatto a immagini e video il VAE 3D, cioè quello che comprime spazio e tempo insieme. La prima è la convoluzione causale nel tempo. Una convoluzione temporale fa scorrere lungo l’asse dei fotogrammi un filtro che, a ogni posizione, combina con pesi appresi il fotogramma corrente e alcuni vicini, come fanno nello spazio le reti convoluzionali; è causale quando i vicini sono soltanto quelli che vengono prima.
MAGVIT-v2 usa la convoluzione causale per codificare con lo stesso modello immagini e video [YLG+24], e CogVideoX, HunyuanVideo, Wan e LTX-Video la adottano con piccole varianti [HCB+24, KTZ+24, YTZ+25, WanTeamWA+25]. Con essa un fotogramma latente dipende soltanto dai fotogrammi del proprio gruppo e da quelli che lo precedono. La seconda scelta ne è la conseguenza. Il primo fotogramma si codifica da solo, e i successivi a gruppi di \(c_t\), con \(F' = 1 + (F-1)/c_t\).
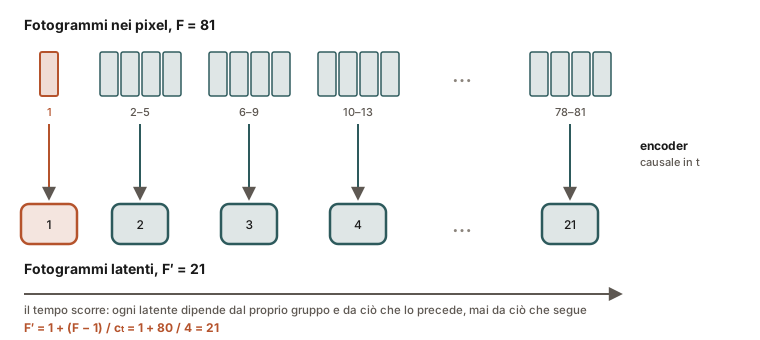
Fig. 33.2 Gli 81 fotogrammi di un clip di Wan. Il primo, da solo, dà il primo fotogramma latente; ciascuno dei venti gruppi successivi, di quattro fotogrammi, dà uno dei venti seguenti, per un totale di 21. Il tempo scorre da sinistra a destra.#
La Fig. 33.2 mostra il conto di Wan, con 81 fotogrammi in ingresso e 21 fotogrammi latenti in uscita.
L’archivista lavora in una sala di proiezione, e il regolamento gli impone di scrivere ogni scheda con quello che è già passato sullo schermo, mai con quello che deve ancora arrivare. Una scheda copre quattro fotogrammi, e l’archivista la scrive appena il quarto è sparito dallo schermo, senza aspettare il quinto. Ne segue che una scheda già scritta non cambia, qualunque cosa succeda nel film dopo di lei.
Resta il problema dell’inizio. Prima del primo fotogramma c’è solo buio, e la prima scheda, che come le altre guarda all’indietro, trova un solo fotogramma vero e, prima di lui, il nero. In pratica è la scheda del primo fotogramma da solo, e i gruppi di quattro cominciano dal secondo. Con 81 fotogrammi i conti tornano. C’è un fotogramma, poi venti gruppi, cioè ventuno schede. Un film lungo uno più un multiplo di quattro dà sempre una scheda in più dei suoi gruppi, ed è per questo che da 81 fotogrammi escono 21 schede, e non le 20,25 di una divisione per quattro.
Una fotografia è un film di un fotogramma, e l’archivista le scrive la sua prima scheda, uguale a quella con cui comincerebbe un film. Così lo stesso archivista e lo stesso copista servono fotografie e film, e le loro schede stanno nello stesso archivio.
Il regolamento ha due prezzi. Il primo è che i conti tornano solo per film lunghi uno più un multiplo di quattro. A un film di otto fotogrammi avanzerebbero in fondo tre fotogrammi, senza un gruppo e senza una scheda, e per questo nell’archivio i film entrano già tagliati a quella misura. Il secondo è che la prima scheda è di un’altra natura. Racconta una fotografia, mentre tutte le altre raccontano quattro fotogrammi di movimento. Finché la torre lavora sul film intero, con la prima scheda sempre sott’occhio, la differenza non pesa. Pesa quando la torre genera il film una scheda dopo l’altra guardando soltanto le ultime, e va avanti così a lungo che la prima esce dal suo sguardo. Lì il film sfarfalla, ed è il tema della generazione in tempo reale.
Definizione. Una convoluzione temporale è causale quando l’uscita in ogni istante dipende soltanto dall’ingresso in quell’istante e in quelli precedenti. Con un kernel di lunghezza \(k_t\) la si ottiene aggiungendo \(k_t - 1\) fotogrammi nulli prima dell’ingresso e nessuno dopo [YLG+24]. Nel modello più semplice, una sola convoluzione con kernel e passo uguali a \(c_t\), il fotogramma latente \(i\), per \(i = 1, \dots, F'\), è
dove \(\mathbf{W}_j\) sono i pesi del kernel, matrici sui canali (la parte spaziale è omessa). Per \(i = 1\) la somma pesca un solo fotogramma vero, \(\mathbf{V}_1\), e \(c_t - 1\) zeri; per \(i \ge 2\) pesca i fotogrammi da \((i-2)c_t + 2\) a \((i-1)c_t + 1\). Quindi \(\mathbf{x}^{i}\) non dipende da nessun \(\mathbf{V}_m\) con \(m > (i-1)c_t + 1\). La proprietà si conserva componendo strati causali, e i VAE reali ne impilano molti. In Wan sono convoluzioni causali con kernel 3 e passo 1, e il sottocampionamento temporale ha passo 2 [WanTeamWA+25].
Il numero di uscite è \(F' = \lfloor (F-1)/c_t \rfloor + 1\), e ogni fotogramma entra in qualche gruppo soltanto se \(F \equiv 1 \pmod{c_t}\); altrimenti gli ultimi \((F-1) \bmod c_t\) fotogrammi restano fuori. Quando \(F \equiv 1 \pmod{c_t}\) si ha \(F' = 1 + (F-1)/c_t\), la regola di MAGVIT-v2, per cui un sottocampionamento temporale di passo \(c_t\) porta \(1 + c_t\) fotogrammi in 2, \(1 + 2c_t\) in 3, e così via [YLG+24]. Con \(F = 81\) e \(c_t = 4\) si ha \(F' = 21\). Anche i report di Wan e di HunyuanVideo danno il latente come \(1 + (F-1)/c_t\) fotogrammi, cioè presuppongono \(F - 1\) multiplo di \(c_t\) [KTZ+24, WanTeamWA+25].
Il primo fotogramma, codificato senza guardare nessun altro, passa dallo stesso encoder di un’immagine, che è un video con \(F = 1\) e \(F' = 1\). È la ragione per cui immagini e video condividono il latente [YLG+24]. In Wan il primo fotogramma è compresso solo nello spazio [WanTeamWA+25]; in LTX-Video è un fotogramma latente a parte [HCB+24].
Il prezzo è che il primo fotogramma latente ha statistiche diverse dagli altri, perché codifica una sola immagine senza compressione temporale. Huang e colleghi osservano che nella generazione in streaming, quando il primo fotogramma esce dalla finestra della KV cache, questa differenza produce un forte sfarfallio [HLH+25]; i rimedi sono nella sezione sulla generazione in tempo reale.
Non tutti i VAE video sono causali. Quello di Movie Gen usa convoluzioni temporali con padding simmetrico e comprime di 8 anche il primo fotogramma, quindi ottiene \(\lceil F/8 \rceil\) fotogrammi latenti, e il decoder scarta gli \(8 \lceil F/8 \rceil - F\) fotogrammi in eccesso. Anche lì un’immagine è un video di un fotogramma [PZB+24].
Per vedere la causalità all’opera basta una prova su 9 fotogrammi con \(c_t = 4\). Il filtro della convoluzione temporale guarda 4 fotogrammi alla volta e avanza di 4 (kernel e passo uguali a 4), e il padding, cioè i fotogrammi nulli aggiunti al bordo, sta solo davanti, con tre fotogrammi nulli prima del primo. Per ogni latente si guarda da quali fotogrammi dipende, alterandoli uno alla volta.
import numpy as np

rng = np.random.default_rng(0)

def conv_causale(x, k, s):
    """Convoluzione temporale causale con kernel k e passo s.
    x ha forma (F, ...): si aggiungono k-1 fotogrammi nulli solo prima."""
    pad = np.zeros((k - 1,) + x.shape[1:])
    xp = np.concatenate([pad, x])
    w = np.arange(1, k + 1, dtype=float)       # pesi fissi, solo per la prova
    n_out = (len(xp) - k) // s + 1
    return np.stack([sum(w[j] * xp[i * s + j] for j in range(k))
                     for i in range(n_out)])

ct = 4
F = 9
x = rng.normal(size=(F, 3))                    # 9 fotogrammi, 3 numeri ciascuno
z = conv_causale(x, k=ct, s=ct)
print("fotogrammi:", F, "-> latenti:", len(z),
      " (1 + 8/4 =", 1 + (F - 1) // ct, ")")

# da quali fotogrammi dipende ogni latente? Si altera un fotogramma alla volta
# (nella stampa i fotogrammi e i latenti sono numerati da 1).
for i in range(len(z)):
    dip = []
    for f in range(F):
        z_alt = conv_causale(x + np.eye(F)[f][:, None], ct, ct)
        if not np.allclose(z_alt[i], z[i]):
            dip.append(f)
    print("latente", i + 1, "dipende dai fotogrammi", [f + 1 for f in dip])

# prova diretta: alterando i fotogrammi dal sesto in poi
# i primi due latenti non cambiano
y = x.copy()
y[5:] += 10.0
zy = conv_causale(y, ct, ct)
print("primi due latenti invariati:", np.array_equal(z[:2], zy[:2]),
      "| terzo cambiato:", not np.array_equal(z[2], zy[2]))

# un'immagine e' un video di un fotogramma
print("F = 1 ->", len(conv_causale(x[:1], ct, ct)), "latente")

# lunghezze che non sono 1 piu' un multiplo di 4: l'ultimo fotogramma coperto
for F2 in (9, 8, 10):
    n = len(conv_causale(rng.normal(size=(F2, 1)), ct, ct))
    print("F =", F2, "-> latenti:", n, " ultimo fotogramma coperto:",
          (n - 1) * ct + 1, "su", F2)
fotogrammi: 9 -> latenti: 3  (1 + 8/4 = 3 )
latente 1 dipende dai fotogrammi [1]
latente 2 dipende dai fotogrammi [2, 3, 4, 5]
latente 3 dipende dai fotogrammi [6, 7, 8, 9]
primi due latenti invariati: True | terzo cambiato: True
F = 1 -> 1 latente
F = 9 -> latenti: 3  ultimo fotogramma coperto: 9 su 9
F = 8 -> latenti: 2  ultimo fotogramma coperto: 5 su 8
F = 10 -> latenti: 3  ultimo fotogramma coperto: 9 su 10
I 9 fotogrammi danno \(1 + 8/4 = 3\) latenti. Il primo dipende dal solo fotogramma 1, il secondo dai fotogrammi da 2 a 5 e il terzo da quelli da 6 a 9, e infatti alterare tutto ciò che viene dopo il quinto fotogramma lascia identici i primi due latenti e cambia il terzo. Una singola immagine dà un latente. Nella convoluzione della prova, le lunghezze che non sono uno più un multiplo di quattro lasciano fuori l’ultimo tratto. Con 8 fotogrammi l’ultimo coperto è il quinto, e i fotogrammi 6, 7 e 8 non entrano in nessun latente.
Video lunghi: la cache delle feature#
La causalità ha un secondo vantaggio, che il report di Wan sfrutta per i video lunghi. Il VAE elabora il clip a blocchi, uno dopo l’altro, e da un blocco al successivo passa soltanto la storia che le convoluzioni causali richiedono, cioè i valori intermedi (le feature) degli ultimi fotogrammi del blocco precedente, che formano la cache delle feature [WanTeamWA+25]. Se ogni strato è causale e i blocchi sono tagliati come i gruppi del latente, il primo di un fotogramma e gli altri di quattro, il risultato a blocchi coincide con quello sul clip intero, e la memoria occupata dalla cache non cresce con la durata. Gli autori ne concludono che l’inferenza resta stabile per video di lunghezza arbitraria.
Lo scopo è quello della KV cache dei modelli di linguaggio, non ricalcolare ciò che il passato ha già determinato. La KV cache, però, conserva per ogni token già generato i calcoli dell’attenzione che lo riguardano (le sue chiavi e i suoi valori), e cresce con la sequenza; la cache delle feature tiene soltanto gli ultimi fotogrammi che ogni kernel vede.
Il film è troppo lungo per stare tutto sul tavolo, e arriva in bobine. Qui conta un dettaglio del mestiere dell’archivista, che non scrive le schede di getto. Prima prende un appunto per ogni fotogramma, guardando quel fotogramma e i due che lo precedono, e poi compone le schede dagli appunti.
Elabora le bobine una alla volta, con una regola. Prima di cominciare una bobina nuova, ricopia su un foglietto di riporto gli ultimi due fotogrammi di quella precedente, che servono ai primi appunti della bobina nuova. Con il foglietto, ogni appunto, e quindi ogni scheda, esce identico a quello che avrebbe scritto se il film non fosse mai stato tagliato.
La prima bobina non ha nessuna bobina prima. Il suo foglietto di riporto è fatto di due fotogrammi neri, il buio che sta davanti al film quando comincia. Le bobine, poi, sono tagliate come le schede, in modo che ognuna ne dia esattamente una. La prima contiene un solo fotogramma, ciascuna delle altre ne contiene quattro. Una bobina tagliata a metà di un gruppo spezzerebbe una scheda fra due bobine, e il foglietto non basterebbe a ricucirla.
Tagliare il film in bobine non cambia nessuna scheda, e sul tavolo non stanno mai più di una bobina e due fotogrammi di riporto, per quanto il film sia lungo. Funziona perché l’archivista non sbircia avanti. Se potesse guardare anche i fotogrammi della bobina dopo, il foglietto non basterebbe, perché per scrivere l’ultima scheda di una bobina servirebbe già la bobina successiva, e il taglio cambierebbe le schede. Per la stessa ragione non può regolare la mano sul film intero, per esempio calcando di più la penna se il film nel complesso è scuro. Anche quella sarebbe un’occhiata al finale.
Un archivista che guarda avanti, come quello di Movie Gen, deve rimediare in un altro modo. Divide il film in bobine di trentadue fotogrammi e scrive le schede di ciascuna senza guardare le altre; è il copista, poi, a ridipingere le bobine accavallate di sedici fotogrammi, sfumando l’una nell’altra la parte in comune perché i tagli non si vedano.
Wan divide il clip di \(F\) fotogrammi in \(F' = 1 + (F-1)/4\) blocchi, tanti quanti i fotogrammi latenti, il primo di un solo fotogramma e gli altri di quattro al massimo [WanTeamWA+25]. Una convoluzione causale con kernel 3 e passo 1 richiede, per ogni uscita, il fotogramma corrente e i due precedenti, e fra un blocco e il successivo si conservano le feature degli ultimi due fotogrammi del blocco già elaborato. Per il primo blocco, al posto della cache, ci sono due fotogrammi fittizi a zero, cioè lo stesso padding della versione su clip intero. Nel sottocampionamento temporale a passo 2 la cache è di un fotogramma.
In generale, uno strato causale con kernel \(k_t\) e passo 1 ha bisogno, per ogni uscita, dei \(k_t - 1\) fotogrammi che precedono quello corrente. Con una cache di quella lunghezza l’uscita a blocchi coincide con quella sul clip intero, e la prova con kernel 3 su nove fotogrammi lo verifica in un caso. Con una cache di lunghezza fissa, gli strati di sottocampionamento aggiungono la condizione che i confini dei blocchi cadano sulla griglia del loro passo, così che ogni blocco produca un numero intero di uscite, nelle stesse posizioni del calcolo sul clip intero. I blocchi di Wan la rispettano per costruzione, dato che ciascuno produce esattamente un fotogramma latente. La memoria della cache dipende dai kernel degli strati e non dalla durata del clip.
Resta una condizione sugli strati di normalizzazione, che non devono mescolare i fotogrammi. Wan sostituisce tutte le GroupNorm con RMSNorm proprio per conservare la causalità temporale, ed è questa modifica a rendere possibile la cache [WanTeamWA+25]. La ragione sta nella definizione della GroupNorm. Applicata a un tensore video, calcola media e varianza di ogni gruppo di canali su tutte le posizioni, fotogrammi compresi, quindi l’uscita su un fotogramma dipenderebbe anche dai successivi, e a blocchi le statistiche cambierebbero da un blocco all’altro.
Un VAE che non è causale non ha questa garanzia, e diviso in blocchi dà un risultato diverso vicino ai confini. Movie Gen elabora i video lunghi a segmenti di 32 fotogrammi (4 fotogrammi latenti), che nell’encoder accosta senza sovrapposizione e nel decoder sovrappone di 16 fotogrammi, fondendo linearmente quelli in comune per togliere gli artefatti ai bordi dei segmenti [PZB+24].
Una prova sul caso più semplice, un kernel di lunghezza 3 su 9 fotogrammi divisi in blocchi di 1, 4 e 4, confronta l’uscita a blocchi con quella sul clip intero.
import numpy as np

rng = np.random.default_rng(1)
w = [0.5, 0.3, 0.2]                       # kernel temporale di lunghezza 3

def passo(finestra):
    """Un valore di uscita da tre fotogrammi, in un ordine fissato."""
    return w[0] * finestra[0] + w[1] * finestra[1] + w[2] * finestra[2]

def tutto_insieme(x):
    xp = [0.0, 0.0] + list(x)             # due fotogrammi nulli solo prima
    return [passo(xp[i:i + 3]) for i in range(len(x))]

def a_blocchi(x, dimensioni):
    cache = [0.0, 0.0]                    # primo blocco: due fotogrammi nulli
    uscita, inizio = [], 0
    for d in dimensioni:                  # un blocco, un fotogramma latente
        blocco = list(x[inizio:inizio + d])
        xp = cache + blocco
        uscita += [passo(xp[i:i + 3]) for i in range(len(blocco))]
        cache = xp[-2:]                   # si conservano gli ultimi due
        inizio += d
    return uscita, cache

F = 9
x = rng.normal(size=F)
dimensioni = [1] + [4] * ((F - 1) // 4)   # 1 + 8/4 = 3 blocchi: 1, 4, 4
print("blocchi:", dimensioni)
a = tutto_insieme(x)
b, cache = a_blocchi(x, dimensioni)
print("uscite identiche:", a == b)
print("fotogrammi tenuti dalla cache:", len(cache), "(contro", F, "del clip)")
blocchi: [1, 4, 4]
uscite identiche: True
fotogrammi tenuti dalla cache: 2 (contro 9 del clip)
Le due uscite coincidono, e fra un blocco e il successivo passano soltanto 2 fotogrammi, mentre il clip intero ne ha 9.
Quanto comprimere: il compromesso fra token e dettagli#
Il fattore di compressione totale, il rapporto fra i valori nei pixel e quelli nel latente, è \(c_t c_s^2 \cdot 3 / C\). La tabella raccoglie i fattori dichiarati da CogVideoX [YTZ+25], HunyuanVideo [KTZ+24], Wan [WanTeamWA+25], Movie Gen [PZB+24] e LTX-Video [HCB+24].
VAE |
\(c_t \times c_s \times c_s\) |
\(C\) |
compressione totale |
|---|---|---|---|
CogVideoX |
\(4 \times 8 \times 8\) |
16 |
48 |
HunyuanVideo |
\(4 \times 8 \times 8\) |
16 |
48 |
Wan 2.1 |
\(4 \times 8 \times 8\) |
16 |
48 |
Movie Gen |
\(8 \times 8 \times 8\) |
16 |
96 |
LTX-Video |
\(8 \times 32 \times 32\) |
128 |
192 |
LTX-Video comprime quattro volte più di Wan, e lo fa spostando il patchify dentro il VAE. Dove gli altri hanno un VAE con \(c_s = 8\) e un patchify di lato 2 nel Transformer, cioè 16 pixel per lato di un token, LTX-Video mette 32 pixel per lato nel VAE e nessun patchify.
La prova calcola, per ogni modello, il fattore di compressione e i pixel che un token riassume, \(c_t c_s^2\, p_t p_h p_w\), e poi passa gli stessi 121 fotogrammi a 768×512 da LTX-Video e dal VAE di Wan.
# (nome, ct, cs, canali, patch p_t, p_h, p_w)
vae = [
    ("HunyuanVideo", 4,  8,  16, 1, 2, 2),
    ("Wan 2.1",     4,  8,  16, 1, 2, 2),
    ("Movie Gen",   8,  8,  16, 1, 2, 2),
    ("LTX-Video",   8, 32, 128, 1, 1, 1),
]
print("modello       fattore  pixel per token")
for nome, ct, cs, C, pt, ph, pw in vae:
    fattore = ct * cs * cs * 3 / C            # valori pixel / valori latente
    pixel_per_token = ct * cs * cs * pt * ph * pw
    print(f"{nome:13s} {fattore:6.0f}  {pixel_per_token:8d}")

# lo stesso clip, 768x512 con 121 fotogrammi: LTX contro il VAE di Wan
F, H, W = 121, 512, 768
Fl_ltx = 1 + (F - 1) // 8
S_ltx = (H // 32) * (W // 32)
Fl_wan = 1 + (F - 1) // 4
S_wan = (H // 16) * (W // 16)                  # VAE 8x8 e patch 2x2
N_ltx, N_wan = Fl_ltx * S_ltx, Fl_wan * S_wan
print("LTX-Video:", Fl_ltx, "latenti x", S_ltx, "=", N_ltx, "token")
print("VAE di Wan:", Fl_wan, "latenti x", S_wan, "=", N_wan, "token")
print("rapporto fra i token:", round(N_wan / N_ltx, 2))
# costo relativo dell'attenzione piena: cresce come N^2
print("rapporto fra i costi di attenzione:", round((N_wan / N_ltx) ** 2))
modello       fattore  pixel per token
HunyuanVideo      48      1024
Wan 2.1           48      1024
Movie Gen         96      2048
LTX-Video        192      8192
LTX-Video: 16 latenti x 384 = 6144 token
VAE di Wan: 31 latenti x 1536 = 47616 token
rapporto fra i token: 7.75
rapporto fra i costi di attenzione: 60
Dopo il film in bobine, l’archivista prova un altro modo di stringere. Finora ogni scheda copriva quattro fotogrammi, e ogni casella della scheda un quadratino di 8 pixel di lato; la torre di Transformer tagliava poi la scheda in tessere da due caselle per lato, cioè da 16 pixel. Nella versione compressa ogni casella è già una tessera, perché copre 32 pixel di lato e otto fotogrammi, e invece di 16 numeri ne porta 128. Con l’esercizio l’archivista impara a non sprecarli, cioè a non scrivere la stessa cosa in due numeri diversi. Tagliare la scheda in tessere dopo, come faceva la torre, non toglie invece nessuna ripetizione, perché una tessera di due caselle per lato porta gli stessi 64 numeri che le sue quattro caselle avevano già, soltanto messi in fila, e se due di loro dicevano la stessa cosa continuano a dirla.
Un film di 121 fotogrammi a 768×512 diventa così sedici schede da 384 caselle, cioè 6.144 tessere. Con le schede di prima sarebbero 47.616, quasi otto volte di più, e poiché ogni tessera si confronta con tutte le altre, i confronti scendono di circa sessanta volte, più o meno otto per otto.
C’è un prezzo, e lo paga il copista. Una scheda così compatta non ha posto per la grana del muro o per il bordo di una foglia. Quei dettagli minuti non stanno più sulla scheda, e qualcuno deve inventarli. LTX-Video affida l’invenzione al copista, che impara a ricevere la scheda con ancora un velo di disturbo e a ridipingere il quadro pulendola un’ultima volta, cioè ad aggiungere lui i dettagli. Un dettaglio inventato così è verosimile, ma, poiché sulla scheda non c’era, non è detto che sia quello dell’originale.
E c’è un limite oltre il quale il lavoro smette di riuscire, e dove stia lo si scopre solo provando. In una prova con schede da 16 pixel di lato per otto fotogrammi, archivista e copista hanno faticato a imparare anche con 128 numeri per casella. LTX-Video stringe ancora di più, e ci riesce cambiando il modo in cui li addestra e lasciando al copista l’ultima pulizia.
Il numero di pixel che un token riassume è \(c_t c_s^2\, p_t p_h p_w\), cioè 1024 per HunyuanVideo e per Wan, 2048 per Movie Gen e 8192 per LTX-Video, che ci arriva senza patchify. Gli autori di LTX-Video ottengono la compressione \(8 \times 32 \times 32\) con 128 canali spostando il patchify dall’ingresso del Transformer a quello del VAE e introducendo funzioni di perdita nuove [HCB+24]. La ridondanza fra i canali, che misurano con una PCA, scende durante l’addestramento, mentre il patchify ingenuo dei latenti, osservano, non contribuisce a ridurla. Non potrebbe, perché riordina valori già calcolati senza ricalcolarli, e una patch \(2 \times 2\) di un latente a 16 canali è un vettore con gli stessi 64 valori che il latente conteneva già.
Sullo stesso clip di 121 fotogrammi a 768×512 LTX-Video produce \(1 + 120/8 = 16\) fotogrammi latenti da 384 token, 6.144 in tutto, e il VAE di Wan con patch \(1 \times 2 \times 2\) ne produce 31 da 1.536, cioè 47.616, 7,75 volte di più. Poiché l’attenzione piena costa \(O(N^2)\), il suo termine scende di circa 60 volte.
Il prezzo della compressione sta nei dettagli. A questo livello i dettagli fini non stanno più nel latente e vanno generati. Il decoder di LTX-Video è addestrato a portare latenti ancora rumorosi direttamente in un video \(\hat{\mathbf{V}}\) di pixel puliti, \(\hat{\mathbf{V}} = \mathcal{D}(\mathbf{x}_t, t)\), dove \(\mathbf{x}_t = (1-t)\,\mathbf{x}_0 + t\,\boldsymbol{\epsilon}\) è il latente rumoroso e \(t\) sta fra 0 e 0,2 (LTX-Video usa \(t = 1\) per il rumore puro) [HCB+24]. Il decoder esegue così l’ultimo passo di denoising, ed è l’alternativa a un modello di upsampling separato, come quello da 7 miliardi di parametri di Movie Gen [PZB+24].
Dove stia il limite si scopre provando. L’ablazione di CogVideoX confronta VAE da \(4 \times 8 \times 8\) con 8, 16 e 32 canali, uno da \(8 \times 8 \times 8\) con 32 e uno da \(8 \times 16 \times 16\) con 128, osserva che con la compressione più spinta la convergenza del modello diventa estremamente difficile anche aumentando i canali, e sceglie \(4 \times 8 \times 8\) con 16 canali [YTZ+25]. LTX-Video comprime il doppio di quella variante in ciascuna dimensione spaziale, con lo stesso numero di canali, e ci arriva con il patchify spostato nel VAE, le funzioni di perdita nuove e il decoder che genera i dettagli.
Le versioni successive di due di queste famiglie, Wan 2.2 nella variante TI2V-5B e HunyuanVideo 1.5, vanno nella stessa direzione, con un VAE che comprime di 16 in ciascuna dimensione spaziale, il doppio di Wan 2.1 [WZL+25, WanTeam25].
Da ricordare
Per far lavorare la torre su un film bisogna prima schiacciarlo: invece di una scheda per fotogramma, l’archivista ne scrive una ogni gruppo di quattro fotogrammi, e 81 fotogrammi diventano ventuno schede, poi 75.600 tessere. Una scheda per fotogramma, invece, fa sfarfallare la grana del muro, perché nessuno ha mai visto due fotogrammi vicini insieme.
L’archivista scrive ogni scheda con quello che è già passato sullo schermo, mai con quello che arriva dopo. Poiché la prima scheda racconta il primo fotogramma da solo, una fotografia è un film di un fotogramma, e i conti tornano per film lunghi uno più un multiplo di quattro. La prima scheda, però, racconta una fotografia e non un movimento, e quando la torre genera il film a pezzi e la perde di vista, il film sfarfalla.
Con un foglietto di riporto di due fotogrammi, un film lungo si elabora a bobine senza che nessuna scheda cambi, e sul tavolo non sta mai più di una bobina. Vale perché l’archivista non guarda avanti e le bobine sono tagliate come le schede.
Stringere ancora di più, fino a schede da 32 pixel per otto fotogrammi, riduce le tessere di quasi otto volte e i confronti fra tessere di circa sessanta, ma lascia al copista il compito di inventare i dettagli minuti. Oltre un certo punto, imparare diventa troppo difficile.
Da ricordare
Un VAE 3D porta il clip \(F \times H \times W \times 3\) in un latente di \(F'\) fotogrammi di forma \((H/c_s) \times (W/c_s) \times C\); per Wan 81 fotogrammi a 1280×720 diventano 21 fotogrammi latenti e, con patch \(1 \times 2 \times 2\), \(N = 75\,600\) token [WanTeamWA+25]. Un VAE di immagini applicato un fotogramma alla volta sfarfalla, perché nessun termine lega fotogrammi vicini [BRL+23].
La convoluzione temporale causale, con \(k_t - 1\) fotogrammi nulli solo davanti, fa dipendere il latente \(i\) solo da fotogrammi fino a \((i-1)c_t + 1\); il primo fotogramma si codifica da solo e \(F' = 1 + (F-1)/c_t\) con \(F \equiv 1 \pmod{c_t}\) [YLG+24]. Immagini e video condividono il latente, e il primo fotogramma latente ha statistiche diverse dagli altri [HLH+25]. Il VAE di Movie Gen, che non è causale, usa un padding simmetrico e \(\lceil F/8 \rceil\) fotogrammi latenti [PZB+24].
Grazie alla causalità il VAE elabora il clip a blocchi, con una cache per strato dei fotogrammi che il kernel vede (i \(k_t - 1\) precedenti, in uno strato di passo 1) e un risultato identico a quello sul clip intero, purché i confini dei blocchi cadano sulla griglia del passo degli strati di sottocampionamento e le normalizzazioni non mescolino il tempo (RMSNorm al posto della GroupNorm in Wan) [WanTeamWA+25].
Il fattore di compressione totale è \(c_t c_s^2 \cdot 3 / C\) (48 per Wan, 96 per Movie Gen, 192 per LTX-Video); LTX-Video sposta il patchify nel VAE, arriva a 8192 pixel per token e fa eseguire al decoder l’ultimo passo di denoising [HCB+24]. La compressione spinta si paga nei dettagli e, oltre un certo punto, nella convergenza.
Il clip da 81 fotogrammi è diventato una sequenza di 75.600 token, e ciascuno porta l’informazione dei fotogrammi del proprio gruppo e di quelli prima, mai di quelli dopo. Che cosa questi token si dicono fra loro, e quanto costa farglielo fare quando sono decine di migliaia, è il tema dell’attenzione nello spazio e nel tempo.